Kursus
Web Scraping dengan Python
4 jam
94.2K
Jika Anda ingin gambaran umum tentang web scraping di Python, ikuti kursus Web Scraping with Python dari DataCamp.
Dalam tutorial ini, Anda akan mempelajari cara menggunakan Scrapy, sebuah kerangka kerja Python yang memungkinkan Anda menangani data dalam jumlah besar! Anda akan belajar Scrapy dengan membangun web scraper untuk AliExpress.com yang merupakan situs e-niaga. Ayo mulai scraping!
Pengetahuan dasar HTML dan CSS akan membantu Anda memahami tutorial ini dengan lebih mudah dan cepat. Baca artikel ini untuk penyegaran tentang HTML dan CSS.
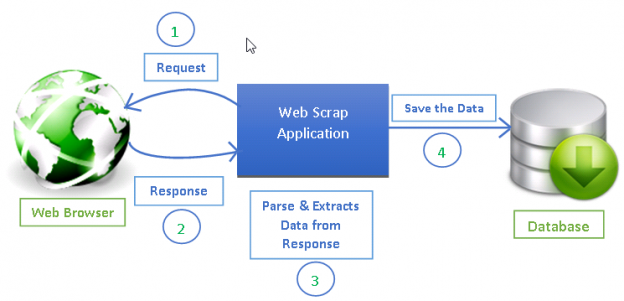
Web scraping telah menjadi cara efektif untuk mengekstrak informasi dari web untuk pengambilan keputusan dan analisis. Ini telah menjadi bagian penting dari perangkat data science. Data scientist harus tahu cara mengumpulkan data dari halaman web dan menyimpan data tersebut dalam berbagai format untuk analisis lebih lanjut.
Halaman web apa pun yang Anda lihat di internet dapat dirayapi untuk informasi dan apa pun yang terlihat di halaman web dapat diekstraksi [2]. Setiap halaman web memiliki struktur dan elemen webnya sendiri sehingga Anda perlu menulis web crawler/spider sesuai dengan halaman web yang diekstraksi.
Scrapy menyediakan kerangka kerja yang kuat untuk mengekstrak data, memprosesnya, lalu menyimpannya.
Scrapy menggunakan spiders, yaitu crawler mandiri yang diberi seperangkat instruksi [1]. Di Scrapy, lebih mudah membangun dan menskalakan proyek crawling besar dengan memungkinkan pengembang untuk memakai ulang kode mereka.
Di bagian ini, Anda akan mendapat gambaran tentang salah satu alat web scraping yang paling populer bernama BeautifulSoup dan perbandingannya dengan Scrapy.
Scrapy adalah kerangka kerja Python untuk web scraping yang menyediakan paket lengkap untuk pengembang tanpa perlu khawatir memelihara kode.
Beautiful Soup juga banyak digunakan untuk web scraping. Ini adalah paket Python untuk mengurai dokumen HTML dan XML serta mengekstrak data darinya. Tersedia untuk Python 2.6+ dan Python 3.
Berikut beberapa perbedaan di antara keduanya secara singkat:
| Scrapy | BeautifulSoup |
|---|---|
| Fungsionalitas | --- |
| Scrapy adalah paket lengkap untuk mengunduh halaman web, memprosesnya, dan menyimpannya ke file serta basis data | BeautifulSoup pada dasarnya adalah parser HTML dan XML dan memerlukan pustaka tambahan seperti requests, urlib2 untuk membuka URL dan menyimpan hasilnya [6] |
| Kurva Pembelajaran | --- |
| Scrapy adalah tenaga penggerak untuk web scraping dan menawarkan banyak cara untuk men-scrape halaman web. Membutuhkan lebih banyak waktu untuk mempelajari dan memahami cara kerja Scrapy, tetapi setelah dikuasai, proses membuat web crawler dan menjalankannya hanya dari satu baris perintah menjadi mudah. Menjadi ahli Scrapy mungkin butuh latihan dan waktu untuk mempelajari semua fungsinya. | BeautifulSoup relatif mudah dipahami bagi pemula pemrograman dan dapat menyelesaikan tugas-tugas kecil dengan cepat |
| Kecepatan dan Beban | --- |
Scrapy dapat menyelesaikan pekerjaan besar dengan sangat mudah. Ia dapat merayapi sekelompok URL dalam waktu tidak lebih dari satu menit bergantung pada ukurannya dan melakukannya dengan sangat mulus karena menggunakan Twister yang bekerja secara asinkron (non-blocking) untuk konkurensi. |
BeautifulSoup digunakan untuk pekerjaan scraping sederhana secara efisien. Lebih lambat daripada Scrapy jika Anda tidak menggunakan multiprocessing. |
| Memperluas Fungsionalitas | --- |
| Scrapy menyediakan Item pipelines yang memungkinkan Anda menulis fungsi dalam spider untuk memproses data seperti memvalidasi, menghapus, dan menyimpan data ke basis data. Ia menyediakan spider Contracts untuk menguji spider Anda dan memungkinkan Anda membuat crawler umum dan mendalam. Ia memungkinkan Anda mengelola banyak variabel seperti percobaan ulang, pengalihan, dan seterusnya. | Jika proyek tidak memerlukan banyak logika, BeautifulSoup sudah memadai. Namun jika Anda membutuhkan banyak kustomisasi seperti proxy, pengelolaan cookie, dan pipeline data, Scrapy adalah opsi terbaik. |
Informasi: Sinkron berarti Anda harus menunggu suatu pekerjaan selesai untuk memulai pekerjaan baru, sedangkan Asinkron berarti Anda dapat beralih ke pekerjaan lain sebelum pekerjaan sebelumnya selesai
Berikut tutorial BeautifulSoup dari DataCamp yang menarik untuk dipelajari.

Dengan Python 3.0 (dan seterusnya) terpasang, jika Anda menggunakan anaconda, Anda dapat menggunakan conda untuk memasang scrapy. Tulis perintah berikut di anaconda prompt:
conda install -c conda-forge scrapy
Untuk memasang anaconda, lihat tutorial DataCamp untuk Mac dan Windows.
Atau, Anda dapat menggunakan Penginstal Paket Python pip. Ini berfungsi untuk Linux, Mac, dan Windows:
pip install scrapy
Scrapy juga menyediakan shell perayapan web yang disebut Scrapy Shell, yang dapat digunakan pengembang untuk menguji asumsi tentang perilaku suatu situs. Mari ambil halaman web untuk tablet di situs e-niaga AliExpress. Anda dapat menggunakan Scrapy shell untuk melihat komponen apa yang dikembalikan halaman web dan bagaimana Anda dapat memanfaatkannya sesuai kebutuhan.
Buka command line Anda dan tulis perintah berikut:
scrapy shell
Jika Anda menggunakan anaconda, Anda juga dapat menulis perintah di atas di anaconda prompt. Keluaran Anda di command line atau anaconda prompt akan seperti ini:

Anda harus menjalankan crawler pada halaman web menggunakan perintah fetch di Scrapy shell. Crawler atau spider menelusuri halaman web dengan mengunduh teks dan metadata-nya.
fetch(https://pt.aliexpress.com/category/201005406/special-store.html)
Catatan: Selalu tempatkan URL dalam tanda kutip, baik tanda kutip tunggal maupun ganda berfungsi

Crawler mengembalikan response yang dapat dilihat dengan menggunakan perintah view(response) di shell:
view(response)
Dan halaman web akan dibuka di peramban default.

Anda dapat melihat skrip HTML mentah dengan menggunakan perintah berikut di Scrapy shell:
print(response.text)

Anda akan melihat skrip yang menghasilkan halaman web. Ini adalah konten yang sama ketika Anda mengeklik kanan area kosong di halaman web dan mengeklik view source atau view page source. Karena Anda hanya membutuhkan informasi yang relevan dari seluruh skrip, gunakan alat pengembang peramban untuk memeriksa elemen yang diperlukan. Mari ambil elemen berikut:
Klik kanan pada elemen yang Anda inginkan dan klik inspect seperti di bawah:

Alat pengembang pada peramban akan sangat membantu Anda untuk web scraping. Anda dapat melihat bahwa ini adalah tag <a> dengan class product dan teksnya berisi nama produk:

Anda dapat mengekstraknya menggunakan atribut elemen atau css selector seperti kelas. Tulis hal berikut di Scrapy shell untuk mengekstrak nama produk:
response.css(".product::text").extract_first()
Keluarannya akan berupa:

extract_first() mengekstrak elemen pertama yang memenuhi css selector. Jika Anda ingin mengekstrak semua nama produk gunakan extract():
response.css(".product::text").extract()

Kode berikut akan mengekstrak rentang harga produk:
response.css(".value::text").extract()

Demikian pula, Anda dapat mencoba dengan jumlah pesanan dan nama toko.
XPath adalah bahasa kueri untuk memilih node dalam dokumen XML [7]. Anda dapat menavigasi melalui dokumen XML menggunakan XPath. Di balik layar, Scrapy menggunakan Xpath untuk menavigasi ke item dokumen HTML. CSS selector yang Anda gunakan di atas juga dikonversi ke XPath, tetapi dalam banyak kasus, CSS sangat mudah digunakan. Namun Anda tetap harus tahu cara kerja XPath di Scrapy.
Buka Scrapy Shell Anda dan tulis fetch(https://pt.aliexpress.com/category/201005406/special-store.html/) dengan cara yang sama seperti sebelumnya. Cobalah potongan kode berikut [3]:
response.xpath('/html').extract()
Ini akan menampilkan semua kode di bawah tag <html>. / berarti anak langsung dari node. Jika Anda ingin mendapatkan tag <div> di bawah tag html Anda akan menulis [3]:
response.xpath('/html//div').extract()
Untuk XPath, Anda harus memahami penggunaan / dan // untuk mengetahui cara menavigasi melalui node anak dan keturunan. Berikut tutorial yang bermanfaat untuk XPath Nodes dan beberapa contoh untuk dicoba.
Jika Anda ingin mendapatkan semua tag <div>, Anda dapat melakukannya dengan menelusurinya tanpa menggunakan /html [3]:
response.xpath("//div").extract()
Anda dapat memfilter lebih lanjut node awal Anda dan mencapai node yang diinginkan dengan menggunakan atribut dan nilainya. Di bawah ini adalah sintaks untuk menggunakan kelas dan nilainya.
response.xpath("//div[@class='quote']/span[@class='text']").extract()
response.xpath("//div[@class='quote']/span[@class='text']/text()").extract()
Gunakan text() untuk mengekstrak semua teks di dalam node
Pertimbangkan kode HTML berikut:

Anda ingin mendapatkan teks di dalam tag <a>, yang merupakan node anak dari <div> dengan kelas site-notice-container container Anda dapat melakukannya sebagai berikut:
response.xpath('//div[@class="site-notice-container container"]/a[@class="notice-close"]/text()').extract()

Web scraping dapat digunakan untuk membuat agregator yang dapat Anda gunakan untuk membandingkan data. Misalnya, Anda ingin membeli tablet, dan Anda ingin membandingkan produk serta harga secara bersamaan—Anda dapat merayapi halaman yang diinginkan dan menyimpannya dalam file Excel. Di sini Anda akan melakukan scraping aliexpress.com untuk informasi tablet.
Sekarang, Anda akan membuat spider kustom untuk halaman yang sama. Pertama, Anda perlu membuat proyek Scrapy tempat kode dan hasil Anda akan disimpan. Tulis perintah berikut di command line atau anaconda prompt.
scrapy startproject aliexpress

Ini akan membuat folder tersembunyi di instalasi python atau anaconda default Anda. aliexpress akan menjadi nama foldernya. Anda bisa memberi nama apa pun. Anda dapat melihat isi folder langsung melalui explorer. Berikut adalah struktur foldernya:

| file/folder | Tujuan |
|---|---|
| scrapy.cfg | file konfigurasi deploy |
| aliexpress/ | Modul Python proyek, Anda akan mengimpor kode Anda dari sini |
__init.py__ |
File inisialisasi |
| items.py | file item proyek |
| pipelines.py | file pipeline proyek |
| settings.py | file pengaturan proyek |
| spiders/ | direktori tempat Anda akan menaruh spider |
__init.py__ |
File inisialisasi |
Setelah membuat proyek, Anda akan berpindah ke direktori yang baru dibuat dan menulis perintah berikut:
[scrapy genspider aliexpress_tablets](https://pt.aliexpress.com/category/201005406/special-store.html)

Ini membuat file templat bernama aliexpress_tablets.py di direktori spiders seperti dibahas di atas. Kode dalam file tersebut seperti di bawah ini:
import scrapy

class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    def parse(self, response):
         pass
Pada kode di atas Anda dapat melihat name, allowed_domains, sstart_urls dan fungsi parse.
scrapy crawl name_of_spider digunakan.response (yang digunakan di Scrapy shell) yang dikembalikan sebagai hasil perayapan diteruskan dalam fungsi ini, dan Anda menulis kode ekstraksi di dalamnya!Informasi: Anda dapat menggunakan BeautifulSoup di dalam fungsi parse() spider Scrapy untuk mem-parsing dokumen html.
Catatan: Anda dapat mengekstrak data melalui css selector menggunakan response.css() seperti dibahas di bagian scrapy shell, tetapi juga menggunakan XPath (XML) yang memungkinkan Anda mengakses elemen anak. Anda akan melihat contoh response.xpath() dalam kode yang diedit di fungsi pass().
Anda akan membuat perubahan pada file aliexpress_tablet.py. Saya menambahkan URL lain di start_urls. Anda dapat menambahkan logika ekstraksi ke fungsi pass() seperti di bawah ini:
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']


    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info
Informasi: zip() menerima n buah iterable dan mengembalikan daftar tuple. Elemen ke-i dari tuple dibuat menggunakan elemen ke-i dari masing-masing iterable. [8]
Kata kunci yield digunakan ketika Anda mendefinisikan fungsi generator. Fungsi generator mirip dengan fungsi biasa kecuali menggunakan kata kunci yield alih-alih return. Kata kunci yield digunakan kapan pun fungsi pemanggil membutuhkan nilai dan fungsi yang berisi yield akan mempertahankan status lokalnya serta melanjutkan eksekusi dari titik terakhir setelah memberikan nilai ke fungsi pemanggil. Di sini yield memberikan kamus yang dihasilkan ke Scrapy yang akan memproses dan menyimpannya!
Sekarang Anda dapat menjalankan spider:
scrapy crawl aliexpress_tablets
Anda akan melihat keluaran panjang di command line seperti di bawah ini:


Anda akan memerlukan data disajikan sebagai CSV atau JSON agar dapat digunakan lebih lanjut untuk analisis. Bagian tutorial ini akan memandu Anda cara menyimpan file CSV dan JSON untuk data ini.
Untuk menyimpan file CSV, buka settings.py dari direktori proyek dan tambahkan baris berikut:
FEED_FORMAT="csv"
FEED_URI="aliexpress.csv"
Setelah menyimpan settings.py, jalankan ulang scrapy crawl aliexpress_tablets di direktori proyek Anda.

File CSV akan terlihat seperti:

Catatan: Setiap kali Anda menjalankan spider, file akan ditambahkan (append).
     + JSON
     + CSV
     + JSON Lines
     + XML
Feed Export milik Scrapy juga dapat menambahkan stempel waktu dan nama spider ke nama file Anda, atau Anda dapat menggunakannya untuk mengidentifikasi direktori tempat Anda ingin menyimpan.
%(time)s: akan diganti dengan stempel waktu saat feed dibuat [5]%(name)s: akan diganti dengan nama spider [5]Contoh:
ftp://user:password@ftp.example.com/scraping/feeds/%(name)s/%(time)s.json
Perubahan Feed yang Anda buat di settings.py akan berlaku untuk semua spider di proyek. Anda juga dapat menetapkan pengaturan khusus untuk spider tertentu yang akan menimpa pengaturan di file settings.py.
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']

    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.json",
                       'FEED_FORMAT': 'json'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to Scrapy
            yield scraped_info
response.url mengembalikan URL halaman dari mana response dihasilkan. Setelah menjalankan crawler menggunakan scrapy crawl aliexpress_tablets Anda dapat melihat file json:

Anda pasti memperhatikan, ada dua tautan di start_urls. Tautan kedua adalah halaman 2 dari hasil pencarian tablet yang sama. Akan menjadi tidak praktis untuk menambahkan semua tautan. Crawler harus dapat merayapi sendiri semua halaman, dan hanya titik awal yang perlu disebutkan di start_urls.
Jika suatu halaman memiliki halaman-halaman berikutnya, Anda akan melihat navigator di akhir halaman yang memungkinkan berpindah maju mundur antar halaman. Dalam kasus yang Anda terapkan di tutorial ini, Anda akan melihatnya seperti ini:

Berikut adalah kode yang akan Anda lihat:

Seperti yang Anda lihat, ada tag <span> dengan kelas .ui-pagination-active yang merupakan halaman saat ini, dan di bawahnya ada semua tag <a> dengan tautan ke halaman berikutnya. Setiap kali Anda harus mengambil tag <a> setelah tag <span> ini. Di sinilah sedikit CSS berperan! Dalam hal ini, Anda harus mengambil node saudara dan bukan node anak, jadi Anda harus membuat css selector yang memberi tahu crawler untuk mencari tag <a> yang berada setelah tag <span> dengan kelas .ui-pagination-active.
Ingat! Setiap halaman web memiliki strukturnya sendiri. Anda harus mempelajari strukturnya sedikit untuk mengetahui cara mendapatkan elemen yang diinginkan. Selalu coba response.css(SELECTOR) di Scrapy Shell sebelum menulisnya dalam kode.
Ubah aliexpress_tablets.py Anda seperti di bawah ini:
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.csv",
                       'FEED_FORMAT': 'csv'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info


            NEXT_PAGE_SELECTOR = '.ui-pagination-active + a::attr(href)'
            next_page = response.css(NEXT_PAGE_SELECTOR).extract_first()
            if next_page:
                yield scrapy.Request(
                response.urljoin(next_page),
                callback=self.parse)
Pada kode di atas:
pertama Anda mengekstrak tautan halaman berikutnya menggunakan next_page = response.css(NEXT_PAGE_SELECTOR).extract_first() lalu jika variabel next_page mendapatkan tautan dan tidak kosong, maka akan masuk ke badan if.
response.urljoin(next_page): Metode parse() akan menggunakan metode ini untuk menyusun url baru dan menyediakan permintaan baru, yang nantinya akan dikirim ke callback. [9]
Setelah menerima URL baru, ia akan melakukan scraping pada tautan tersebut dengan mengeksekusi badan for dan kembali mencari halaman berikutnya. Ini akan berlanjut sampai tidak mendapatkan tautan halaman berikutnya.
Di sini Anda mungkin ingin duduk santai dan menikmati spider Anda yang merayapi semua halaman. Spider di atas akan mengekstrak dari semua halaman berikutnya. Itu akan menjadi banyak scraping! Namun spider Anda akan melakukannya! Di bawah ini Anda dapat melihat ukuran filenya telah mencapai 1,1 MB.

Dalam tutorial ini, Anda telah mempelajari tentang Scrapy, bagaimana perbandingannya dengan BeautifulSoup, Scrapy Shell, dan cara menulis spider Anda sendiri di Scrapy. Scrapy menangani seluruh beban berat pengkodean untuk Anda, dari membuat file dan folder proyek hingga menangani URL duplikat—membantu Anda mendapatkan web scraping bertenaga tinggi dalam hitungan menit dan menyediakan dukungan untuk semua format data umum yang dapat Anda masukkan lebih lanjut ke program lain. Tutorial ini pasti membantu Anda memahami Scrapy dan kerangkanya serta apa yang dapat Anda lakukan dengannya. Untuk menjadi ahli Scrapy, Anda perlu menelusuri semua fungsionalitas hebat yang disediakannya, tetapi tutorial ini telah membuat Anda mampu melakukan scraping sekelompok halaman web secara efisien.
Untuk bacaan lebih lanjut, Anda dapat merujuk ke Dokumentasi Resmi Scrapy.
Juga, jangan lupa untuk melihat kursus Web Scraping with Python dari DataCamp.
Kursus terkait Python
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



