Corso
Web Scraping in Python
4 ore
94.2K
Se vuoi una panoramica sul web scraping in Python, segui il corso di DataCamp Web Scraping with Python.
In questo tutorial imparerai a usare Scrapy, un framework Python con cui puoi gestire grandi quantità di dati! Imparerai Scrapy costruendo uno scraper per AliExpress.com, un sito di e-commerce. Mettiamoci a scrapare!
Avere conoscenze di base di HTML e CSS ti aiuterà a seguire questo tutorial con più facilità e velocità. Leggi questo articolo per un ripasso su HTML e CSS.
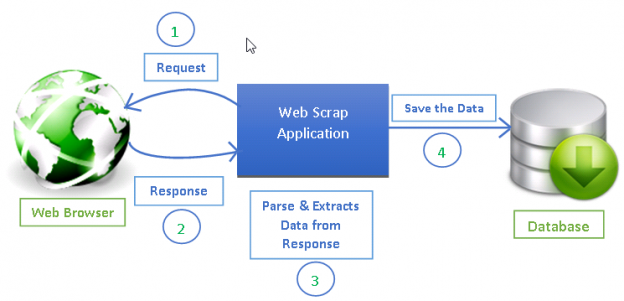
Il web scraping è diventato un modo efficace per estrarre informazioni dal web a supporto delle decisioni e dell’analisi. È ormai una parte essenziale della cassetta degli attrezzi del data scientist. I data scientist dovrebbero saper raccogliere dati da pagine web e salvarli in formati diversi per analisi successive.
Qualsiasi pagina web che vedi in internet può essere analizzata per informazioni e tutto ciò che è visibile su una pagina può essere estratto [2]. Ogni pagina ha una sua struttura e i relativi elementi: per questo devi scrivere i tuoi crawler/spider in base alla pagina che stai estraendo.
Scrapy fornisce un potente framework per estrarre i dati, elaborarli e poi salvarli.
Scrapy usa gli spider, crawler indipendenti a cui viene fornito un insieme di istruzioni [1]. Con Scrapy è più semplice creare e scalare progetti di crawling di grandi dimensioni, permettendo agli sviluppatori di riutilizzare il proprio codice.
In questa sezione avrai una panoramica di uno degli strumenti di web scraping più usati, BeautifulSoup, e un confronto con Scrapy.
Scrapy è un framework Python per il web scraping che offre un pacchetto completo per gli sviluppatori, senza doversi preoccupare della manutenzione del codice.
Beautiful Soup è anch’esso ampiamente usato per il web scraping. È un pacchetto Python per il parsing di documenti HTML e XML e per l’estrazione dei dati. È disponibile per Python 2.6+ e Python 3.
Ecco, in breve, alcune differenze tra i due:
| Scrapy | BeautifulSoup |
|---|---|
| Funzionalità | --- |
| Scrapy è il pacchetto completo per scaricare pagine web, elaborarle e salvarle in file e database | BeautifulSoup è fondamentalmente un parser HTML e XML e richiede librerie aggiuntive come requests, urlib2 per aprire URL e salvare il risultato [6] |
| Curva di apprendimento | --- |
| Scrapy è un vero e proprio motore per il web scraping e offre molti modi per analizzare una pagina. Richiede più tempo per essere imparato e capito a fondo, ma una volta imparato semplifica la creazione dei crawler e l’esecuzione con una sola riga di comando. Diventare esperti in Scrapy può richiedere pratica e tempo per apprenderne tutte le funzionalità. | BeautifulSoup è relativamente facile da capire per chi è alle prime armi con la programmazione e permette di portare a termine compiti piccoli in poco tempo |
| Velocità e carico | --- |
Scrapy gestisce con facilità lavori grandi. Può effettuare il crawling di un gruppo di URL in meno di un minuto a seconda delle dimensioni del gruppo e lo fa in modo molto fluido perché usa Twister che lavora in modo asincrono (non bloccante) per la concorrenza. |
BeautifulSoup è usato con efficienza per lavori di scraping semplici. È più lento di Scrapy se non usi multiprocessing. |
| Estendibilità | --- |
| Scrapy offre le Item pipelines che ti permettono di scrivere funzioni nello spider per elaborare i dati, ad esempio validarli, rimuoverli e salvarli in un database. Fornisce i Contratti degli spider per testare i tuoi spider e consente di creare crawler generici e anche profondi. Ti consente di gestire molte variabili come retry, redirect e così via. | Se il progetto non richiede molta logica, BeautifulSoup va benissimo; ma se ti serve molta personalizzazione come proxy, gestione dei cookie e pipeline dei dati, Scrapy è l’opzione migliore. |
Informazione: Sincrono significa che devi aspettare che un lavoro finisca prima di iniziarne un altro, mentre asincrono significa che puoi passare a un altro lavoro prima che quello precedente sia terminato
Ecco un interessante tutorial su BeautifulSoup di DataCamp da cui imparare.

Con Python 3.0 (e successivi) installato, se usi anaconda puoi usare conda per installare scrapy. Scrivi il seguente comando nel prompt di anaconda:
conda install -c conda-forge scrapy
Per installare anaconda, dai un’occhiata a questi tutorial di DataCamp per Mac e Windows.
In alternativa, puoi usare il gestore pacchetti Python pip. Funziona su Linux, Mac e Windows:
pip install scrapy
Scrapy fornisce anche una shell per il crawling, chiamata Scrapy Shell, che gli sviluppatori possono usare per testare le proprie ipotesi sul comportamento di un sito. Prendiamo una pagina di tablet sul sito e-commerce AliExpress. Puoi usare la Scrapy shell per vedere quali componenti restituisce la pagina e come usarli in base alle tue esigenze.
Apri la riga di comando e scrivi il seguente comando:
scrapy shell
Se usi anaconda, puoi scrivere il comando anche nel prompt di anaconda. L’output sulla riga di comando o sul prompt di anaconda sarà simile a questo:

Devi eseguire un crawler sulla pagina usando il comando fetch nella Scrapy shell. Un crawler o spider scorre una pagina web scaricandone testo e metadati.
fetch(https://pt.aliexpress.com/category/201005406/special-store.html)
Nota: racchiudi sempre gli URL tra virgolette; funzionano sia quelle singole che doppie

Il crawler restituisce una response che può essere visualizzata usando il comando view(response) nella shell:
view(response)
La pagina si aprirà nel browser predefinito.

Puoi visualizzare l’HTML grezzo con il seguente comando nella Scrapy shell:
print(response.text)

Vedrai lo script che genera la pagina web. È lo stesso contenuto che vedi quando fai clic con il tasto destro in un’area vuota della pagina e scegli visualizza sorgente o visualizza sorgente pagina. Poiché hai bisogno solo delle informazioni rilevanti da tutto lo script, usando gli strumenti di sviluppo del browser ispezionerai l’elemento richiesto. Consideriamo i seguenti elementi:
Fai clic con il tasto destro sull’elemento che ti interessa e clicca su inspect come sotto:

Gli strumenti di sviluppo del browser sono di grande aiuto per il web scraping. Puoi vedere che è un tag <a> con una class product e il testo contiene il nome del prodotto:

Puoi estrarre questo elemento usando gli attributi dell’elemento o il selettore CSS come le classi. Scrivi quanto segue nella Scrapy shell per estrarre il nome del prodotto:
response.css(".product::text").extract_first()
L’output sarà:

extract_first() estrae il primo elemento che soddisfa il selettore CSS. Se vuoi estrarre tutti i nomi dei prodotti usa extract():
response.css(".product::text").extract()

Il codice seguente estrarrà la fascia di prezzo dei prodotti:
response.css(".value::text").extract()

Allo stesso modo, puoi provare con il numero di ordini e il nome del negozio.
XPath è un linguaggio di query per selezionare i nodi in un documento XML [7]. Puoi navigare un documento XML usando XPath. Dietro le quinte, Scrapy usa XPath per navigare tra gli elementi di un documento HTML. Anche i selettori CSS usati sopra vengono convertiti in XPath, ma in molti casi i CSS sono più semplici da usare. Tuttavia dovresti sapere come funziona XPath in Scrapy.
Vai nella tua Scrapy Shell e scrivi fetch(https://pt.aliexpress.com/category/201005406/special-store.html/) come prima. Prova i seguenti frammenti di codice [3]:
response.xpath('/html').extract()
Questo mostrerà tutto il codice sotto il tag <html>. / indica il figlio diretto del nodo. Se vuoi ottenere i tag <div> sotto il tag html scriverai [3]:
response.xpath('/html//div').extract()
Con XPath devi imparare a comprendere l’uso di / e // per sapere come navigare tra nodi figli e discendenti. Ecco un tutorial utile sui nodi XPath e alcuni esempi da provare.
Se vuoi ottenere tutti i tag <div>, puoi farlo scendendo di livello senza usare /html [3]:
response.xpath("//div").extract()
Puoi filtrare ulteriormente i nodi di partenza e raggiungere quelli desiderati usando attributi e relativi valori. Di seguito la sintassi per usare le classi e i loro valori.
response.xpath("//div[@class='quote']/span[@class='text']").extract()
response.xpath("//div[@class='quote']/span[@class='text']/text()").extract()
Usa text() per estrarre tutto il testo all’interno dei nodi
Considera il seguente codice HTML:

Vuoi ottenere il testo all’interno del tag <a>, che è figlio del <div> con le classi site-notice-container container; puoi farlo così:
response.xpath('//div[@class="site-notice-container container"]/a[@class="notice-close"]/text()').extract()

Il web scraping può essere usato per creare un aggregatore con cui confrontare i dati. Ad esempio, se vuoi comprare un tablet e confrontare prodotti e prezzi, puoi effettuare il crawling delle pagine desiderate e salvarle in un file Excel. Qui effettuerai lo scraping di aliexpress.com per informazioni sui tablet.
Ora creerai uno spider personalizzato per la stessa pagina. Per prima cosa devi creare un progetto Scrapy in cui verranno salvati il tuo codice e i risultati. Scrivi il seguente comando nella riga di comando o nel prompt di anaconda.
scrapy startproject aliexpress

Questo creerà una cartella nascosta nella tua installazione predefinita di Python o anaconda. aliexpress sarà il nome della cartella. Puoi dare qualsiasi nome. Puoi visualizzare il contenuto della cartella direttamente tramite Esplora risorse. Di seguito la struttura della cartella:

| file/folder | Scopo |
|---|---|
| scrapy.cfg | file di configurazione del deploy |
| aliexpress/ | Modulo Python del progetto, da qui importerai il tuo codice |
__init.py__ |
File di inizializzazione |
| items.py | file items del progetto |
| pipelines.py | file pipelines del progetto |
| settings.py | file di impostazioni del progetto |
| spiders/ | directory in cui inserirai i tuoi spider |
__init.py__ |
File di inizializzazione |
Una volta creato il progetto, passa alla directory appena creata e scrivi il seguente comando:
[scrapy genspider aliexpress_tablets](https://pt.aliexpress.com/category/201005406/special-store.html)

Questo crea un file template chiamato aliexpress_tablets.py nella directory spiders come descritto sopra. Il codice in quel file è il seguente:
import scrapy

class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    def parse(self, response):
         pass
Nel codice sopra puoi vedere name, allowed_domains, sstart_urls e una funzione parse.
scrapy crawl name_of_spider.response (usata nella Scrapy shell) restituita dal crawling viene passata a questa funzione, e qui scrivi il codice di estrazione!Informazione: puoi usare BeautifulSoup all’interno della funzione parse() dello spider Scrapy per fare il parsing del documento HTML.
Nota: puoi estrarre i dati tramite i selettori CSS usando response.css() come visto nella sezione su Scrapy shell, ma anche usando XPath (XML) che ti permette di accedere agli elementi figli. Vedrai un esempio di response.xpath() nel codice modificato nella funzione pass().
Apporterai modifiche al file aliexpress_tablet.py. Ho aggiunto un altro URL in start_urls. Puoi aggiungere la logica di estrazione nella funzione pass() come segue:
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']


    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info
Informazione: zip() prende n iterabili e restituisce una lista di tuple. L’i-esimo elemento della tupla è creato usando l’i-esimo elemento di ciascun iterabile. [8]
La keyword yield si usa quando definisci una funzione generatrice. Una funzione generatrice è come una funzione normale, ma usa la keyword yield al posto di return. La keyword yield viene usata quando la funzione chiamante ha bisogno di un valore e la funzione che contiene yield manterrà il proprio stato locale e continuerà l’esecuzione da dove si era fermata dopo aver restituito il valore alla funzione chiamante. Qui yield fornisce il dizionario generato a Scrapy, che lo elaborerà e lo salverà!
Ora puoi eseguire lo spider:
scrapy crawl aliexpress_tablets
Vedrai un lungo output sulla riga di comando come questo:


Avrai bisogno che i dati siano presentati come CSV o JSON, così da poterli usare per l’analisi. Questa sezione del tutorial ti mostra come salvare un file CSV e JSON per questi dati.
Per salvare un file CSV, apri settings.py dalla directory del progetto e aggiungi le seguenti righe:
FEED_FORMAT="csv"
FEED_URI="aliexpress.csv"
Dopo aver salvato settings.py, riesegui scrapy crawl aliexpress_tablets nella directory del progetto.

Il file CSV sarà simile a questo:

Nota: ogni volta che esegui lo spider il file verrà accodato.
     + JSON
     + CSV
     + JSON Lines
     + XML
Il Feed Export di Scrapy può anche aggiungere un timestamp e il nome dello spider al nome del file, oppure puoi usarli per identificare una directory in cui salvare.
%(time)s: viene sostituito da un timestamp quando il feed viene creato [5]%(name)s: viene sostituito dal nome dello spider [5]Per esempio:
ftp://user:password@ftp.example.com/scraping/feeds/%(name)s/%(time)s.json
Le modifiche al Feed che fai in settings.py si applicheranno a tutti gli spider del progetto. Puoi anche impostare configurazioni personalizzate per un particolare spider che sovrascriveranno le impostazioni nel file settings.py.
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']

    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.json",
                       'FEED_FORMAT': 'json'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to Scrapy
            yield scraped_info
response.url restituisce l’URL della pagina da cui è stata generata la response. Dopo aver eseguito il crawler con scrapy crawl aliexpress_tablets puoi visualizzare il file json:

Avrai notato che ci sono due link in start_urls. Il secondo link è la pagina 2 degli stessi risultati di ricerca per i tablet. Diventa poco pratico aggiungere tutti i link. Un crawler dovrebbe essere in grado di proseguire da solo tra tutte le pagine, e solo il punto di partenza dovrebbe essere indicato in start_urls.
Se una pagina ha pagine successive, vedrai un navigatore a fine pagina che consente di andare avanti e indietro. Nel caso implementato in questo tutorial, lo vedrai così:

Ecco il codice che vedrai:

Come puoi vedere, c’è un tag <span> con la classe .ui-pagination-active che rappresenta la pagina corrente, e sotto di esso ci sono tutti i tag <a> con i link alla pagina successiva. Ogni volta dovrai ottenere i tag <a> successivi a questo tag <span>. Qui entra in gioco un po’ di CSS! In questo caso devi prendere un nodo fratello e non un nodo figlio, quindi devi creare un selettore CSS che dica al crawler di trovare i tag <a> che seguono il tag <span> con la classe .ui-pagination-active.
Ricorda! Ogni pagina web ha una sua struttura. Dovrai studiarla un po’ per capire come ottenere l’elemento desiderato. Prova sempre response.css(SELECTOR) nella Scrapy Shell prima di scriverlo nel codice.
Modifica il tuo aliexpress_tablets.py come sotto:
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.csv",
                       'FEED_FORMAT': 'csv'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info


            NEXT_PAGE_SELECTOR = '.ui-pagination-active + a::attr(href)'
            next_page = response.css(NEXT_PAGE_SELECTOR).extract_first()
            if next_page:
                yield scrapy.Request(
                response.urljoin(next_page),
                callback=self.parse)
Nel codice sopra:
per prima cosa hai estratto il link della pagina successiva usando next_page = response.css(NEXT_PAGE_SELECTOR).extract_first() e poi, se la variabile next_page ottiene un link e non è vuota, entrerà nel corpo dell’if.
response.urljoin(next_page): il metodo parse() userà questo metodo per costruire un nuovo URL e fornire una nuova richiesta, che verrà poi inviata al callback. [9]
Dopo aver ricevuto il nuovo URL, lo scraperà eseguendo il corpo del for e cercherà di nuovo la pagina successiva. Questo continuerà finché non troverà più il link alla pagina successiva.
A questo punto puoi anche sederti e goderti il tuo spider che analizza tutte le pagine. Lo spider qui sopra estrarrà dati da tutte le pagine successive. Sarà un bel po’ di scraping! Ma il tuo spider lo farà! Sotto puoi vedere che la dimensione del file è arrivata a 1,1 MB.

In questo tutorial hai imparato a conoscere Scrapy, come si confronta con BeautifulSoup, Scrapy Shell e come scrivere i tuoi spider in Scrapy. Scrapy si occupa di gran parte del lavoro pesante per te: dalla creazione di file e cartelle del progetto fino alla gestione degli URL duplicati, ti consente di ottenere uno scraping potente in pochi minuti e offre supporto per tutti i formati di dati comuni che puoi poi usare in altri programmi. Questo tutorial ti aiuterà a capire Scrapy e il suo framework e ciò che puoi farci. Per diventare un maestro di Scrapy, dovrai esplorare tutte le fantastiche funzionalità che offre, ma questo tutorial ti ha messo in grado di analizzare gruppi di pagine web in modo efficiente.
Per approfondire, consulta la documentazione ufficiale di Scrapy.
Inoltre, non dimenticare di dare un’occhiata al corso di DataCamp Web Scraping with Python.
Corsi correlati a Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



