Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
Saya telah mencoba OpenAI yang baru alat distilasi model—memerlukan pengodean minimal dan memungkinkan kita mengelola seluruh proses distilasi dalam satu platform, mulai dari pembuatan dataset hingga penyelarasan halus model dan evaluasi kinerjanya.
Dalam tutorial ini, saya akan membantu Anda memulai dengan alat distilasi model OpenAI. Pertama, kita akan membahas dasar-dasar distilasi model, lalu kita akan melakukan proyek demo distilasi menggunakan API OpenAI.
Bayangkan seorang guru yang terampil dan berpendidikan baik mengajarkan proses berpikir serta pengetahuannya kepada seorang murid. Inilah dasar cara kerja distilasi model.
Dalam teknik ini, sang guru adalah model besar yang telah dipra-latih, dan sang murid adalah model yang lebih kecil yang belajar meniru keluaran guru. Hal ini memungkinkan murid melakukan tugas tertentu pada tingkat yang sebanding dengan guru, namun dengan sumber daya yang lebih sedikit.
Distilasi model hadir dalam banyak bentuk, masing-masing dengan metode dan tujuannya sendiri. Dalam satu kasus, kita perlu agar murid hanya meniru keluaran model yang lebih besar. Dalam kasus lain, kita ingin menanamkan pendekatan pemecahan masalah guru ke dalam model yang lebih kecil. Pada akhirnya, tujuannya adalah memanfaatkan kemampuan model besar dengan menggunakan model yang efisien.
Salah satu metode umum untuk mentransfer pengetahuan dari model "guru" ke model "murid" adalah menyelaraskan halus murid pada dataset yang terdiri dari masukan dan keluaran terkait yang dihasilkan oleh guru.
Selama proses pembelajaran terawasi ini, model murid belajar mereplikasi respons guru ketika diberikan masukan yang serupa.
Proses distilasi hadir dengan banyak keuntungan:
Untuk mempelajari lebih lanjut tentang distilasi, Anda dapat membaca artikel ini: Penjelasan Distilasi LLM.
Di bagian ini, kita akan mengeksplorasi contoh distilasi model dengan memanfaatkan platform OpenAI. Fokus utama kita adalah menghasilkan perintah Git untuk permintaan pengguna.
Pertama, kita akan membuat dataset dari GPT-4o mini (murid) yang kecil dari OpenAI dan mengevaluasi keluarannya.
Berikutnya, kita menggunakan GPT-4o (guru) untuk menerjemahkan kalimat yang sama dan menyelaraskan halus model murid pada dataset yang dihasilkan oleh guru.
Terakhir, kita perlu mengevaluasi model murid dan menilai peningkatannya.
Singkatnya, berikut langkah-langkah yang akan kita lakukan:
Langkah pertama distilasi model adalah memilih guru dan murid, yang ditentukan oleh tugas yang dimaksud dan anggaran komputasi Anda.
Saat bekerja dengan model open source, ada beragam LLM dengan kemampuan dan ukuran berbeda. Dengan platform OpenAI, opsinya lebih terbatas.
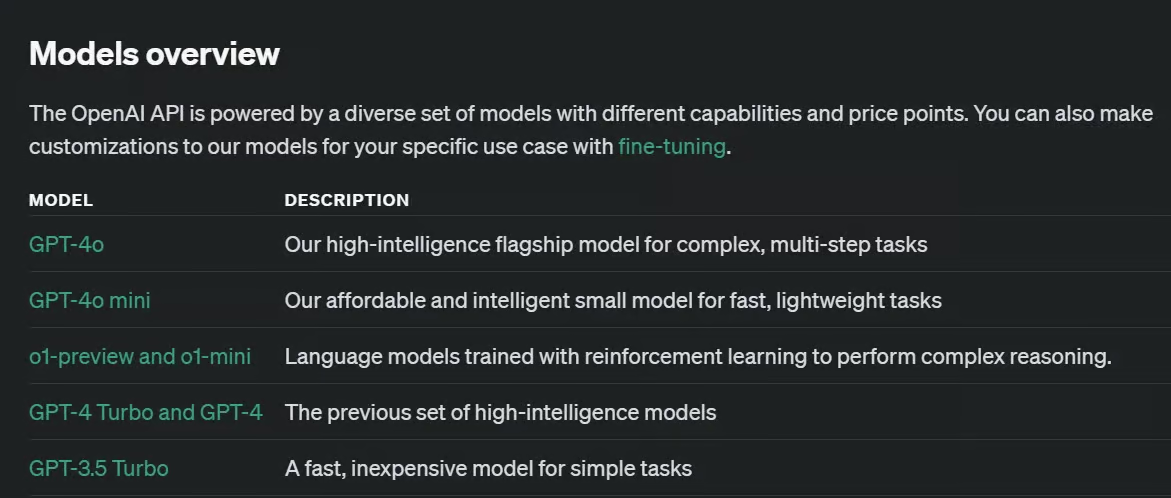
Untuk keperluan contoh kita, kita akan memilih GPT-4o mini sebagai model murid yang lebih kecil dan GPT-4o sebagai model guru.
GPT-4o-mini adalah model yang relatif kecil dan kandidat yang baik untuk peran murid. GPT-4o relatif lebih besar namun jauh lebih mumpuni dan dapat menjadi guru yang efektif bagi murid.
Opsi lain ada, dan mengganti model akan memerlukan upaya minimal dalam proyek distilasi model kita.
Dataset Anda untuk tugas ini harus cukup menantang bagi model murid tetapi tidak terlalu menantang bagi guru. Kualitas dataset yang baik, seperti keberagaman, keterwakilan, atau ketepatan, tetap relevan dalam distilasi model.
Memiliki dataset yang cukup besar untuk memengaruhi model murid sangatlah penting. Tidak ada jawaban pasti untuk “Seberapa besar seharusnya dataset distilasi?” karena hal ini bergantung pada kompleksitas tugas target Anda dan model yang Anda pilih sebagai guru dan murid.
Menurut dokumentasi OpenAI, meskipun beberapa ratus sampel bisa cukup, kelompok yang lebih beragam dengan ribuan sampel terkadang dapat menghasilkan hasil yang lebih baik.
Dataset kita dalam artikel ini terdiri dari 386 permintaan pengguna yang disimpan dalam berkas JSON (Anda juga bisa menyimpannya dalam bentuk list Python).
{
    "requests": [
      "Initialize a new Git repository in the current directory.",
      "Clone the repository from GitHub to my local machine.",
      "Create a new branch called 'feature-login'.",
			...
      "Show the differences between the working directory and the staging area.",
      "Stage all modified and deleted files for commit.",
      ]
}Dataset kita saat ini hanya terdiri dari masukan, dan kita perlu menghasilkan keluaran juga. Keluaran dari murid tidak wajib untuk distilasi, tetapi kita membutuhkannya untuk mendapatkan tolok ukur awal akurasi model murid (langkah 4).
Kita menggunakan kode di bawah ini untuk melakukan iterasi atas dataset masukan dan menghasilkan keluaran untuk masing-masing:
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
Perhatikan bahwa kita menggunakan store=True saat memanggil model OpenAI. Argumen ini akan menyimpan pasangan input/output di dasbor OpenAI kita, sehingga kita tidak perlu menyimpan keluaran menggunakan kode.
Untuk kemudian mengidentifikasi dan memfilter chat completion ini, jangan lupa menyertakan metadata saat memanggil fungsi client.chat.completions.create. Argumen untuk metadata ini bersifat arbitrer.
Keluaran yang dihasilkan dapat ditemukan pada bagian Chat Completions di dasbor OpenAI kita.
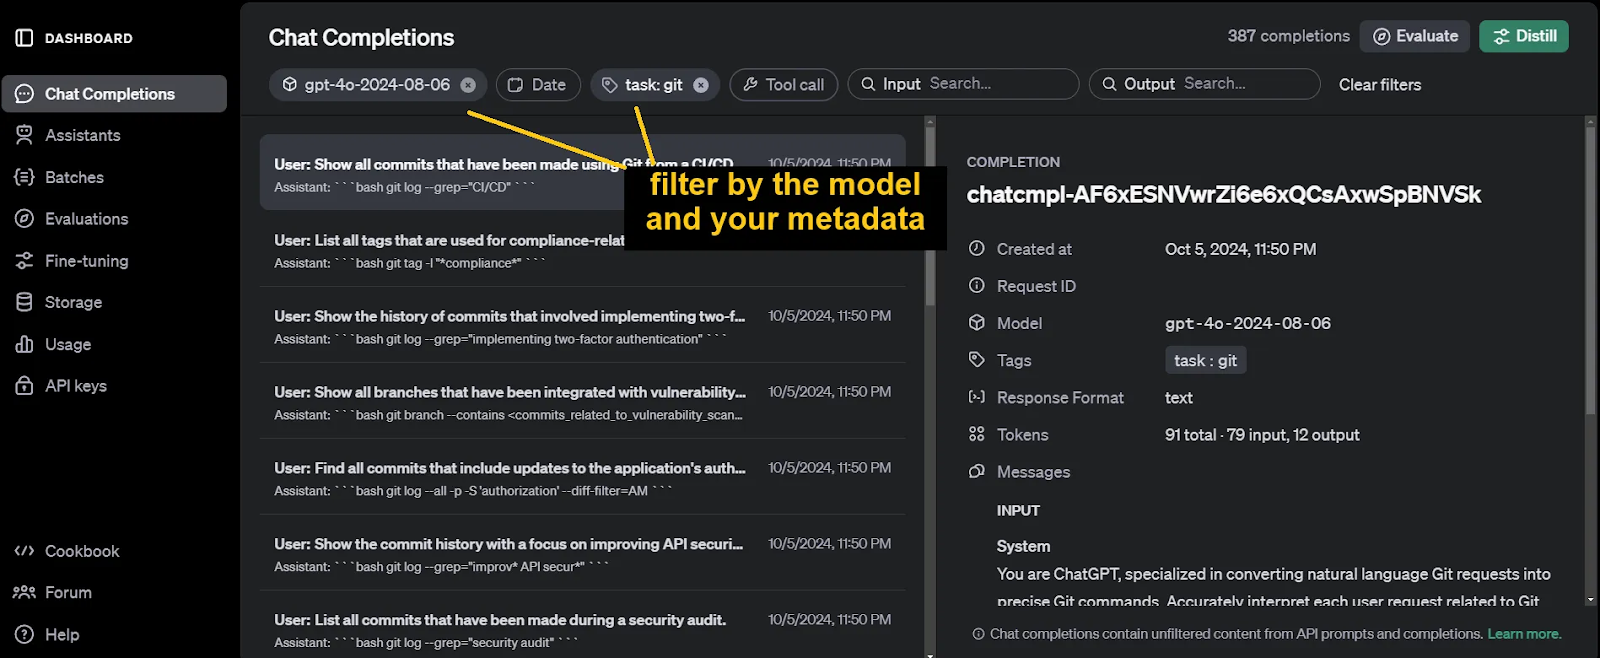
Alat lain dari OpenAI yang berguna untuk distilasi model adalah Evaluations. Kita menggunakan alat ini untuk menilai kinerja model murid sebelum pelatihan sebagai metrik dasar. Kita juga akan menggunakannya nanti saat mengevaluasi model murid yang telah diselaraskan halus.
Setelah memfilter chat completion pada langkah sebelumnya, klik tombol Evaluate. Sekarang kita perlu menambahkan kriteria pengujian.
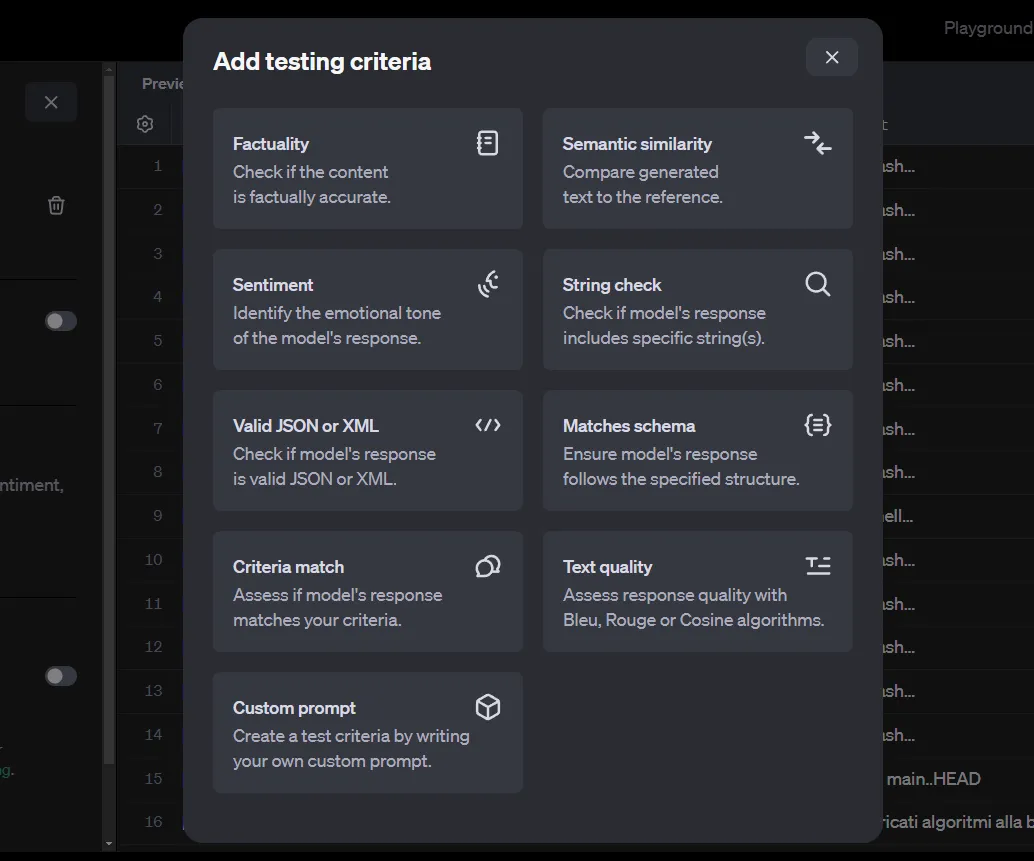
Ada beragam metode untuk mengevaluasi pasangan input/output. Perhatikan bahwa dataset kita saat ini dihasilkan secara otomatis oleh chat completions OpenAI dan hanya berisi masukan dan keluaran. Namun, sebagian kriteria ini juga memerlukan sebuah referensi untuk dibandingkan.
Referensi ini bisa berupa keluaran yang dihasilkan oleh model yang lebih canggih, seperti GPT-4o atau o1-preview. Karena penyimpanan chat secara otomatis ke OpenAI tidak memungkinkan kita menyediakan referensi semacam itu, kita terbatas pada penggunaan metode Criteria match atau Custom prompt, yang hanya memerlukan masukan dan keluaran.
Jika Anda perlu menggunakan metode lain, Anda tidak dapat menggunakan chat completions OpenAI dan harus membuat berkas JSON Anda sendiri dengan kode. Ini tidak rumit, tetapi tidak akan kita bahas dalam artikel ini.
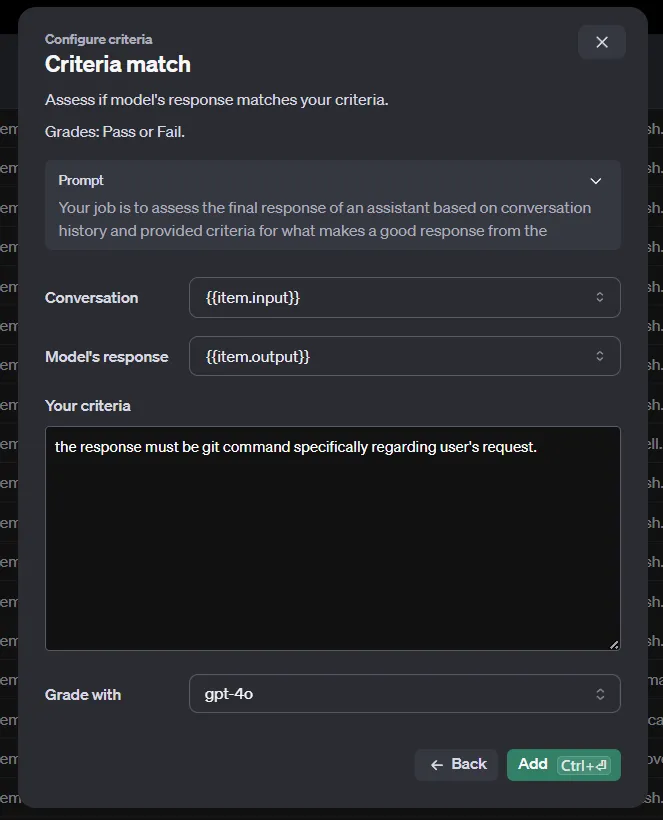
Setelah Anda menjalankan evaluasi, Anda akan segera menerima hasilnya.
Untuk menyelaraskan halus model murid, kita memerlukan dataset berkualitas tinggi yang dihasilkan oleh guru. Langkah ini hampir sama dengan langkah 3—Anda hanya perlu mengubah argumen model dari gpt-4o-mini menjadi gpt-4o.
Sekali lagi, di Chat Completions, lakukan filter berdasarkan model guru dan metadata. Selanjutnya, pilih tombol Distill. Distill OpenAI pada dasarnya adalah alat penyelarasan halus.
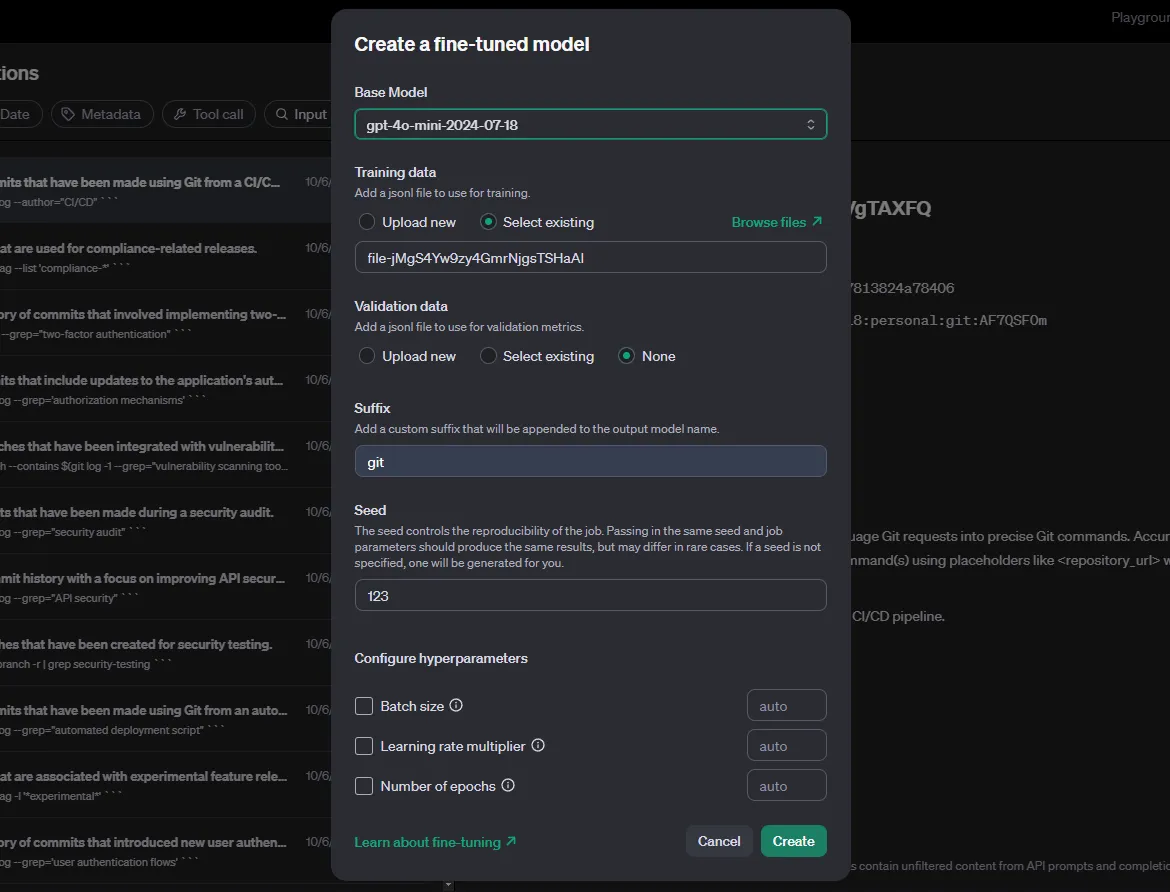
Untuk model dasar, kita pilih murid. Hiperparameter perlu dieksperimenkan dan diuji untuk mencapai hasil terbaik—atur ke otomatis. Terakhir, pilih Create dan tunggu hingga proses penyelarasan halus selesai.
Setelah selesai, kita akan menggunakan kembali kode dari langkah 3, kali ini menggunakan model hasil penyelarasan halus sebagai argumen model. Nama model hasil penyelarasan halus ditampilkan sebagai “Output model” pada halaman fine-tuning Anda.
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="ft:gpt-4o-mini-2024-07-18:personal:git:AF7QSF0m",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
Setelah selesai menghasilkan keluaran, gunakan evaluations untuk menilai kemampuan model baru Anda pada masukan tersebut.
Resep distilasi OpenAI sederhana namun lugas. Ini sangat membantu karena Anda tidak perlu repot menyelaraskan halus model sendiri atau menggunakan kode untuk mengevaluasi hasil.
Model-model OpenAI, bahkan yang lebih kecil sekalipun, sudah cukup canggih. Pastikan bereksperimen dengan hiperparameter sebelum melakukan fine-tuning pada model, siapkan prompt yang memadai dan menantang untuk guru dan murid, serta bandingkan evaluasi hasil penyelarasan halus dengan evaluasi dasar.
Sebelum langsung mempraktikkan distilasi model Anda sendiri, saya sarankan membaca dua sumber daya OpenAI ini: Distilasi Model OpenAI di API dan Dokumen Distilasi Model.
Pelajari membangun aplikasi AI!
Program
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



