Programma
Sviluppare applicazioni AI
21 ore
Ho provato il nuovo OpenAI strumento di distillazione dei modelli: richiede un codice minimo e ci permette di gestire l’intero processo di distillazione in un’unica piattaforma, dalla generazione dei dataset al fine-tuning dei modelli e alla valutazione delle prestazioni.
In questo tutorial ti aiuterò a iniziare con lo strumento di distillazione dei modelli di OpenAI. Prima vedremo le basi della distillazione dei modelli, poi faremo un progetto dimostrativo di distillazione usando l’API di OpenAI.
Immagina un’insegnante esperta e preparata che trasmette il proprio modo di ragionare e le proprie conoscenze a uno studente. Questa è l’idea di base del funzionamento della distillazione dei modelli.
In questa tecnica, l’insegnante è un grande modello pre-addestrato, mentre lo studente è un modello più piccolo che impara a replicare l’output dell’insegnante. In questo modo lo studente può svolgere compiti specifici a un livello paragonabile a quello dell’insegnante, ma con meno risorse.
La distillazione dei modelli può assumere molte forme, ognuna con metodi e obiettivi propri. In un caso, vogliamo che lo studente si limiti a imitare gli output di un modello più grande. In un altro, vogliamo trasmettere al modello più piccolo l’approccio alla risoluzione dei problemi dell’insegnante. In definitiva, l’obiettivo è beneficiare delle capacità di un grande modello usando un modello più efficiente.
Un metodo comune per trasferire conoscenza da un modello “insegnante” a un modello “studente” è il fine-tuning dello studente su un dataset composto da input e relativi output generati dall’insegnante.
Durante questo processo di apprendimento supervisionato, il modello studente impara a replicare le risposte dell’insegnante quando è presentato con input simili.
Il processo di distillazione offre molti vantaggi:
Per approfondire la distillazione, puoi leggere questo articolo: Distillazione degli LLM spiegata.
In questa sezione esploreremo un esempio di distillazione dei modelli utilizzando la piattaforma OpenAI. Il nostro obiettivo principale sarà generare comandi Git in base alla richiesta di un utente.
Prima creeremo un dataset con GPT-4o mini di OpenAI (studente) e valuteremo gli output.
Successivamente useremo GPT-4o (insegnante) per tradurre le stesse frasi e fare il fine-tuning del modello studente sul dataset prodotto dall’insegnante.
Infine, dobbiamo valutare il modello studente e misurare il miglioramento.
In sintesi, ecco i passaggi che seguiremo:
Il primo passaggio della distillazione dei modelli è scegliere l’insegnante e lo studente, in base al compito previsto e al budget computazionale.
Con i modelli open source, esistono vari LLM con diverse capacità e dimensioni. Con la piattaforma di OpenAI, le opzioni sono più limitate.
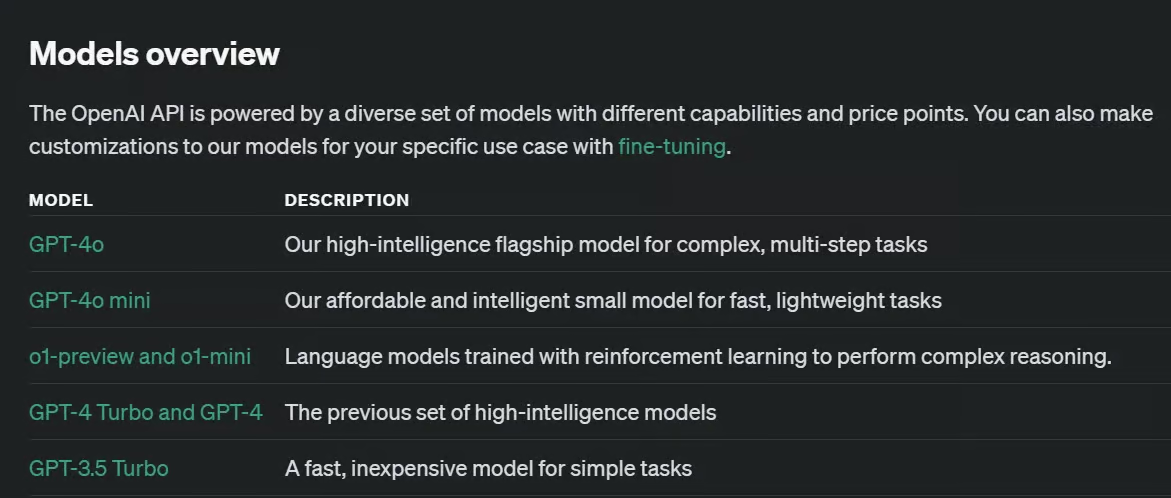
Per il nostro esempio, selezioneremo GPT-4o mini come modello studente più piccolo e GPT-4o come modello insegnante.
GPT-4o-mini è un modello relativamente piccolo e un buon candidato per il ruolo di studente. GPT-4o è relativamente più grande ma molto più capace e può fungere da insegnante efficiente per lo studente.
Esistono altre opzioni e cambiare modelli richiederebbe uno sforzo minimo nel nostro progetto di distillazione.
Il dataset per questo compito deve essere sufficientemente impegnativo per il modello studente, ma non altrettanto per l’insegnante. Le qualità di un buon dataset, come diversità, rappresentatività e accuratezza, restano importanti anche nella distillazione.
Avere un dataset abbastanza grande da influenzare il modello studente è fondamentale. Non c’è una risposta univoca a «Quanto deve essere grande il dataset di distillazione?», poiché dipende dalla complessità del tuo compito e dai modelli scelti come insegnante e studente.
Secondo la documentazione di OpenAI, sebbene possano bastare alcune centinaia di campioni, a volte un gruppo più vario di migliaia di campioni può portare a risultati migliori.
Il nostro dataset in questo articolo è composto da 386 richieste utente salvate in un file JSON (potresti anche salvarle come lista Python).
{
    "requests": [
      "Initialize a new Git repository in the current directory.",
      "Clone the repository from GitHub to my local machine.",
      "Create a new branch called 'feature-login'.",
			...
      "Show the differences between the working directory and the staging area.",
      "Stage all modified and deleted files for commit.",
      ]
}Al momento il nostro dataset contiene solo gli input, quindi dobbiamo generare anche gli output. Gli output dello studente non sono necessari per la distillazione, ma ci servono per ottenere una baseline dell’accuratezza del modello studente (passaggio 4).
Usiamo il codice seguente per iterare sugli input e generare un output per ciascuno:
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
Nota che usiamo store=True quando richiamiamo il modello OpenAI. Questo argomento salverà le coppie input/output nella nostra dashboard OpenAI, quindi non dovremo salvare gli output via codice.
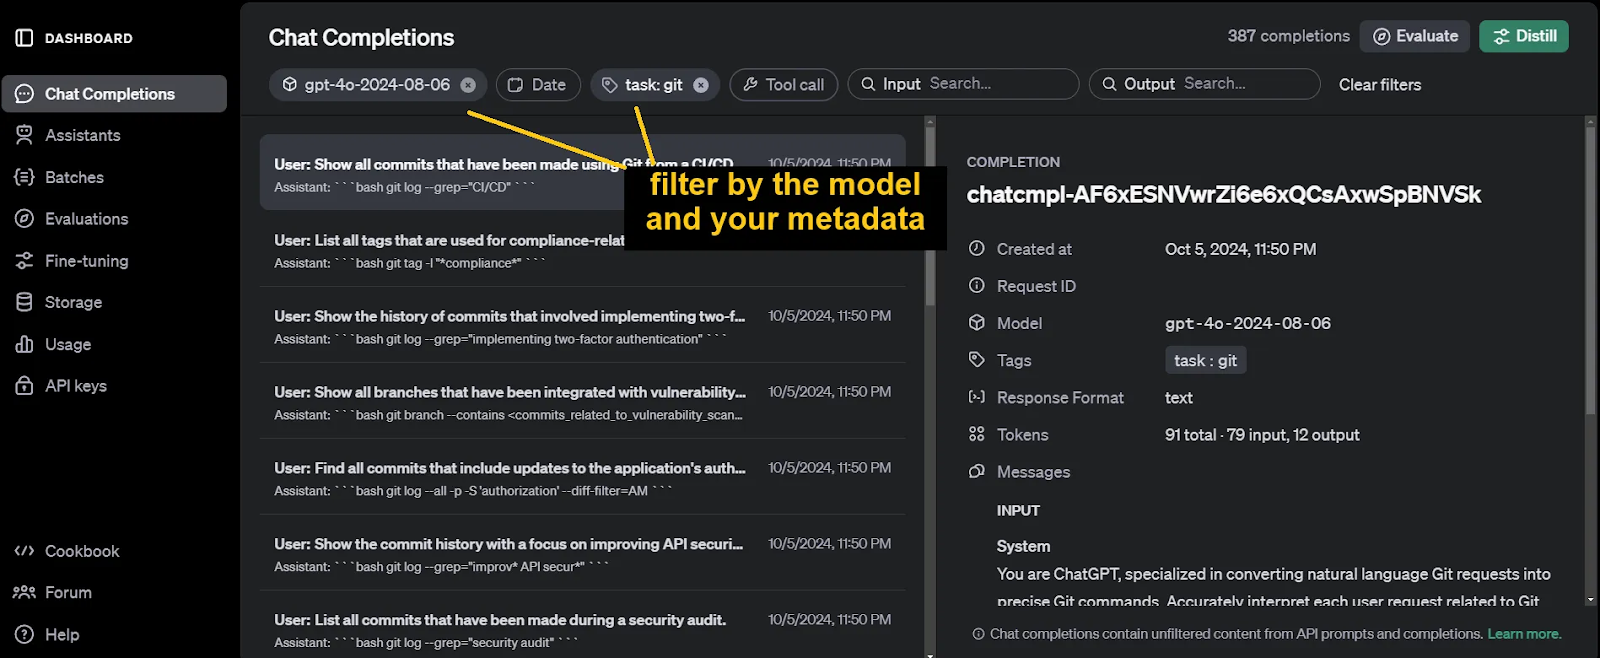
Per identificare e filtrare in seguito queste chat completion, ricorda di includere la metadata quando chiami la funzione client.chat.completions.create. Gli argomenti di questa metadata sono arbitrari.
Gli output generati si trovano nella sezione Chat Completions della nostra dashboard OpenAI.
Un altro strumento di OpenAI utile per la distillazione è Evaluations. Lo usiamo per valutare le prestazioni del modello studente prima dell’addestramento come metrica di base. Lo useremo anche più avanti per valutare il modello studente con fine-tuning.
Dopo aver filtrato le chat completions del passaggio precedente, fai clic sul pulsante Evaluate. Ora dobbiamo aggiungere i criteri di test.
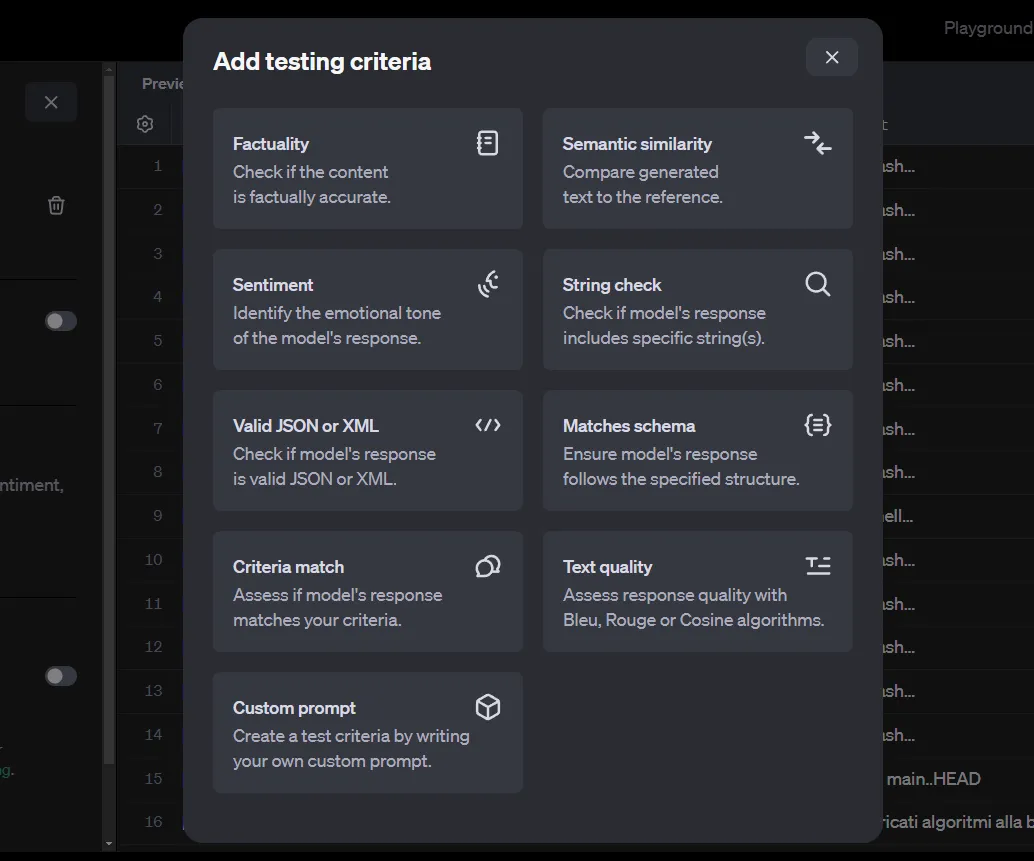
Esistono diversi metodi per valutare le coppie input/output. Nota che il nostro dataset attuale è generato automaticamente dalle chat completions di OpenAI e contiene solo input e output. Tuttavia, alcuni di questi criteri richiedono anche un riferimento con cui confrontare.
Questo riferimento potrebbe essere l’output generato da un modello più sofisticato, come GPT-4o o o1-preview. Poiché il salvataggio automatico delle chat su OpenAI non ci consente di fornire tale riferimento, siamo limitati a usare i metodi Criteria match o Custom prompt, che richiedono solo un input e un output.
Se hai bisogno di usare altri metodi, non puoi usare le chat completions di OpenAI e devi creare il tuo file JSON via codice. Non è complicato, ma non lo tratteremo in questo articolo.
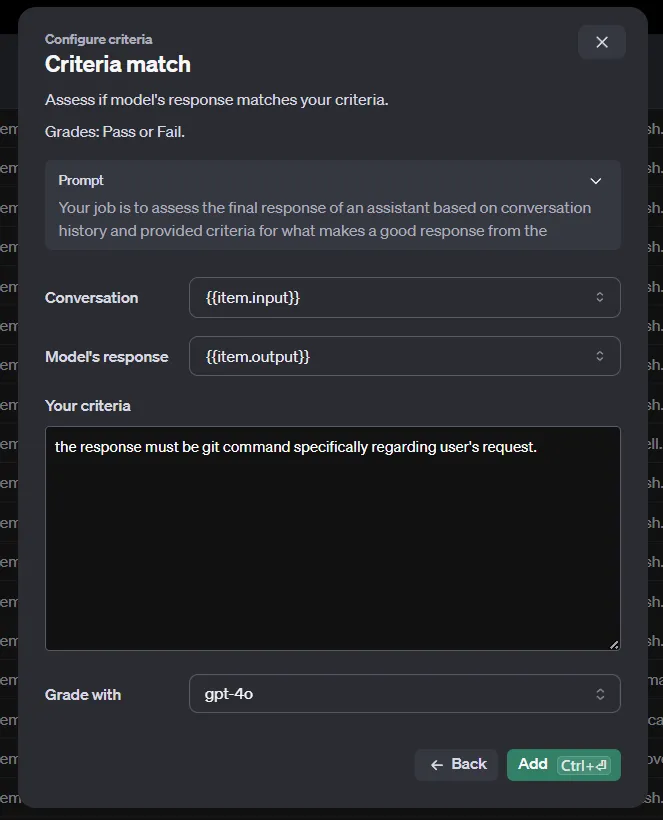
Una volta eseguite le valutazioni, riceverai i risultati a breve.
Per fare il fine-tuning del modello studente, ci serve un dataset di alta qualità generato dall’insegnante. Questo passaggio è quasi identico al passaggio 3: devi solo cambiare l’argomento model da gpt-4o-mini a gpt-4o.
Di nuovo, in Chat Completions filtra per modello insegnante e metadata. Poi seleziona il pulsante Distill. La distillazione di OpenAI è, di fatto, lo strumento di fine-tuning.
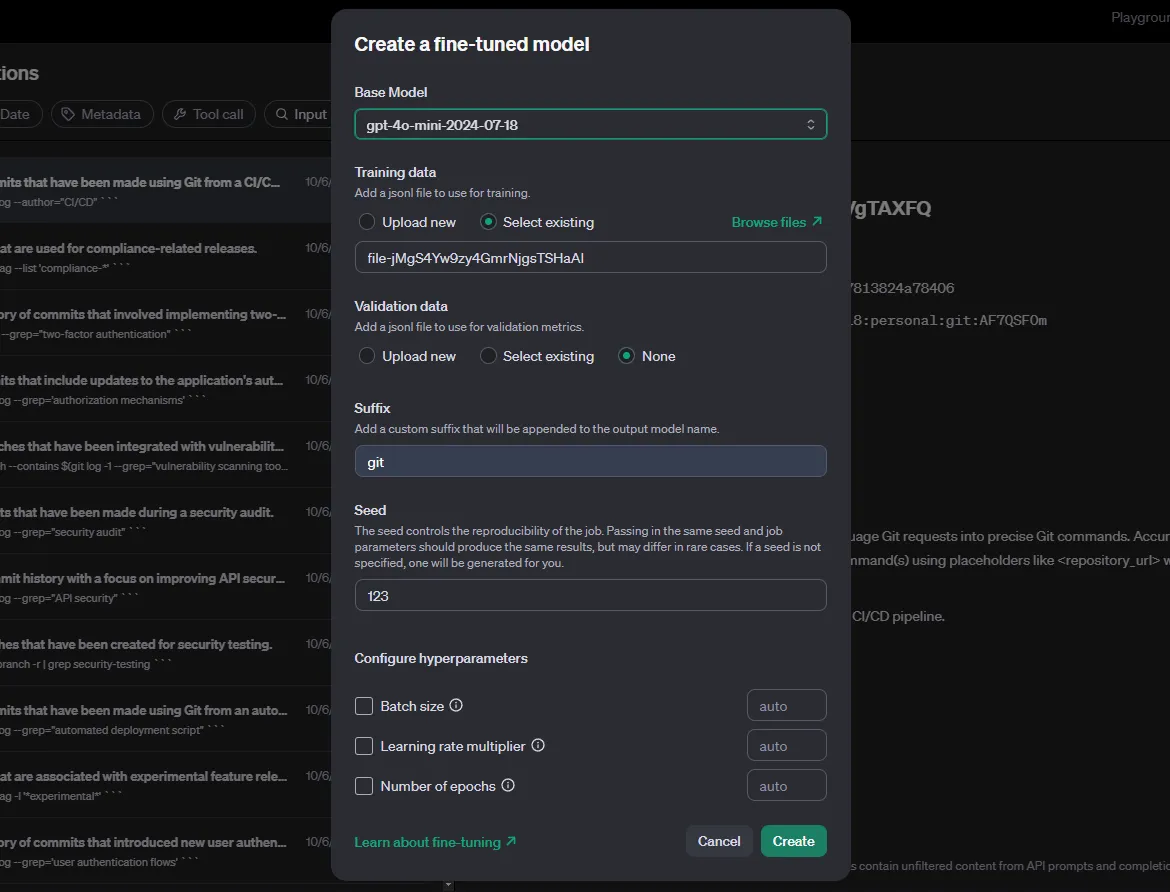
Per il modello di base selezioniamo lo studente. Gli iperparametri vanno sperimentati e testati per ottenere i risultati migliori: imposta su auto. Infine seleziona Create e attendi il completamento del fine-tuning.
Una volta terminato, useremo di nuovo il codice del passaggio 3, questa volta indicando il modello con fine-tuning come argomento model. Il nome del modello con fine-tuning è mostrato come “Output model” nella tua pagina di fine-tuning.
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="ft:gpt-4o-mini-2024-07-18:personal:git:AF7QSF0m",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
Dopo aver generato gli output, usa le valutazioni per misurare le capacità del nuovo modello sugli input.
La ricetta di OpenAI per la distillazione è semplice e lineare. È particolarmente utile perché non devi preoccuparti di eseguire tu stesso il fine-tuning dei modelli o di usare codice per valutare i risultati.
I modelli di OpenAI, anche quelli più piccoli, sono già piuttosto sofisticati. Assicurati di sperimentare con gli iperparametri prima del fine-tuning, prepara prompt adeguati e stimolanti sia per l’insegnante sia per lo studente e confronta la valutazione del modello con fine-tuning con la baseline iniziale.
Prima di metterti all’opera con la tua distillazione, ti consiglio di leggere queste due risorse di OpenAI: Model Distillation nell’API di OpenAI e Documento sulla distillazione dei modelli.
Impara a creare applicazioni di AI!
Programma
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



