Last chance! 50% off DataCamp Premium
Sale ends in
मैंने OpenAI का नया मॉडल डिस्टिलेशन टूल आज़माया है—यह बहुत कम कोडिंग मांगता है और हमें एक ही प्लेटफ़ॉर्म पर संपूर्ण डिस्टिलेशन प्रक्रिया प्रबंधित करने देता है, डेटासेट बनाने से लेकर मॉडलों का फाइन-ट्यूनिंग और उनके प्रदर्शन का मूल्यांकन तक।
इस ट्यूटोरियल में, मैं आपको OpenAI के मॉडल डिस्टिलेशन टूल से शुरुआत करने में मदद करूंगा। पहले हम मॉडल डिस्टिलेशन की बुनियादी बातें कवर करेंगे, और फिर OpenAI के API का उपयोग करते हुए एक डेमो डिस्टिलेशन प्रोजेक्ट करेंगे।
कल्पना कीजिए कि एक निपुण, सुशिक्षित शिक्षक अपना सोचने का तरीका और ज्ञान एक छात्र को सिखाता है। यही मॉडल डिस्टिलेशन के काम करने का मूल सिद्धांत है।
इस तकनीक में, शिक्षक एक बड़ा प्री-ट्रेंड मॉडल होता है, और छात्र एक छोटा मॉडल होता है जो शिक्षक के आउटपुट की नकल करना सीखता है। इससे छात्र कम संसाधनों में शिक्षक के तुलनीय स्तर पर विशेष कार्य कर सकता है।
मॉडल डिस्टिलेशन कई रूपों में आता है, जिनकी अपनी विधियां और लक्ष्य होते हैं। एक स्थिति में, हमें छात्र से केवल बड़े मॉडल के आउटपुट की नकल करानी होती है। दूसरी में, हम छोटे मॉडल में शिक्षक का समस्या-समाधान दृष्टिकोण संचारित करना चाहते हैं। अंततः लक्ष्य है बड़े मॉडल की क्षमताओं का लाभ, एक कुशल मॉडल के जरिए लेना।
"शिक्षक" मॉडल से "छात्र" मॉडल में ज्ञान स्थानांतरित करने की एक सामान्य विधि है छात्र को उस डेटासेट पर फाइन-ट्यून करना जिसमें इनपुट और शिक्षक द्वारा जनरेट किए गए उनके संबंधित आउटपुट होते हैं।
इस सुपरवाइज्ड लर्निंग प्रक्रिया के दौरान, छात्र मॉडल समान इनपुट मिलने पर शिक्षक की प्रतिक्रियाओं को दोहराना सीखता है।
डिस्टिलेशन प्रक्रिया के कई फायदे हैं:
डिस्टिलेशन के बारे में और जानने के लिए, आप यह लेख पढ़ सकते हैं: LLM Distillation Explained.
इस खंड में, हम OpenAI प्लेटफ़ॉर्म का उपयोग करके मॉडल डिस्टिलेशन का एक उदाहरण देखेंगे। हमारा मुख्य फोकस होगा उपयोगकर्ता के अनुरोध के लिए Git कमांड जनरेट करना।
हम पहले OpenAI के छोटे GPT-4o mini (छात्र) का डेटासेट बनाएंगे और आउटपुट का आकलन करेंगे।
इसके बाद, हम GPT-4o (शिक्षक) से वही वाक्य अनुवादित कराएंगे और शिक्षक द्वारा तैयार किए गए डेटासेट पर छात्र मॉडल को फाइन-ट्यून करेंगे।
अंत में, हमें छात्र मॉडल का मूल्यांकन करना होगा और सुधार का आकलन करना होगा।
सारांश में, हम ये कदम उठाने वाले हैं:
मॉडल डिस्टिलेशन का पहला कदम है शिक्षक और छात्र का चयन करना, जो लक्षित कार्य और आपके कंप्यूटिंग बजट से निर्धारित होता है।
ओपन सोर्स मॉडलों के साथ काम करते समय, विभिन्न क्षमताओं और आकारों के कई LLM उपलब्ध होते हैं। OpenAI के प्लेटफ़ॉर्म पर विकल्प सीमित हैं।
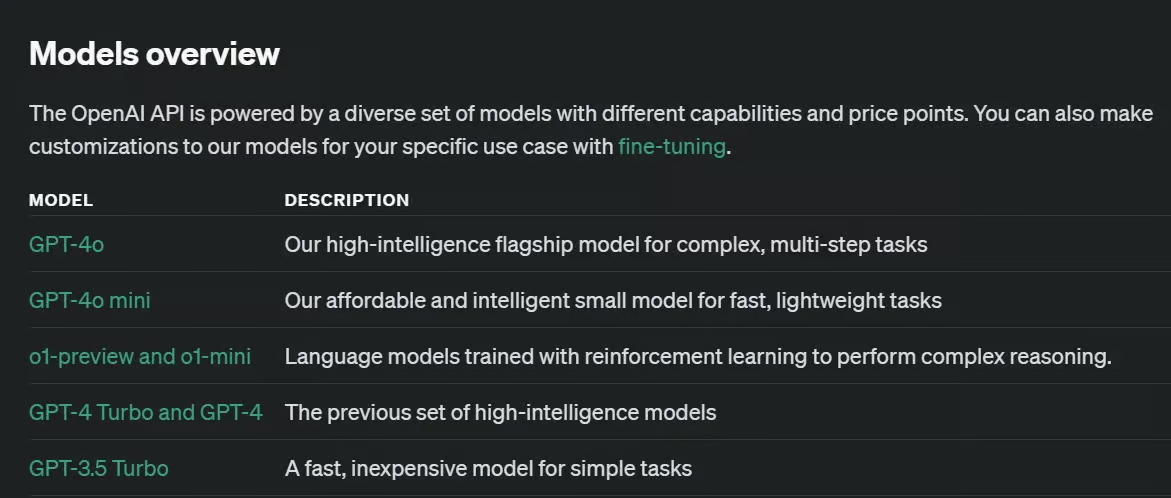
हमारे उदाहरण के लिए, हम GPT-4o mini को छोटे छात्र मॉडल के रूप में और GPT-4o को शिक्षक मॉडल के रूप में चुनेंगे।
GPT-4o-mini अपेक्षाकृत छोटा मॉडल है और छात्र की भूमिका के लिए अच्छा उम्मीदवार है। GPT-4o अपेक्षाकृत बड़ा लेकिन कहीं अधिक सक्षम है और छात्र के लिए एक प्रभावी शिक्षक की तरह काम कर सकता है।
अन्य विकल्प भी मौजूद हैं, और मॉडलों को बदलने में हमारे डिस्टिलेशन प्रोजेक्ट में न्यूनतम प्रयास लगेगा।
इस कार्य के लिए आपका डेटासेट छात्र मॉडल के लिए पर्याप्त चुनौतीपूर्ण होना चाहिए, लेकिन शिक्षक के लिए उतना चुनौतीपूर्ण नहीं। एक अच्छे डेटासेट के गुण—जैसे विविधता, प्रतिनिधित्वशीलता, या सटीकता—मॉडल डिस्टिलेशन में भी उतने ही प्रासंगिक हैं।
छात्र मॉडल पर प्रभाव डालने के लिए पर्याप्त बड़ा डेटासेट होना बहुत महत्वपूर्ण है। “डिस्टिलेशन डेटासेट कितना बड़ा होना चाहिए?” का कोई एक सीधा जवाब नहीं है, क्योंकि यह आपके लक्षित कार्य की जटिलता और शिक्षक व छात्र के रूप में चुने गए मॉडलों पर निर्भर करता है।
OpenAI के प्रलेखन के अनुसार, कुछ सैकड़ों नमूने पर्याप्त हो सकते हैं, जबकि अधिक विविधता वाले हज़ारों नमूने कभी-कभी बेहतर परिणाम देते हैं।
इस लेख में हमारा डेटासेट 386 उपयोगकर्ता अनुरोधों से बना है जो एक JSON फ़ाइल में संग्रहीत हैं (आप इन्हें Python सूची के रूप में भी रख सकते हैं)।
{
    "requests": [
      "Initialize a new Git repository in the current directory.",
      "Clone the repository from GitHub to my local machine.",
      "Create a new branch called 'feature-login'.",
			...
      "Show the differences between the working directory and the staging area.",
      "Stage all modified and deleted files for commit.",
      ]
}हमारा डेटासेट अभी केवल इनपुट से बना है, और हमें आउटपुट भी जनरेट करने चाहिए। छात्र के आउटपुट डिस्टिलेशन के लिए आवश्यक नहीं हैं, लेकिन छात्र मॉडल की सटीकता का बेसलाइन पाने के लिए (कदम 4) इनकी ज़रूरत है।
हम नीचे दिए गए कोड का उपयोग इनपुट डेटासेट पर इटरेट करने और प्रत्येक के लिए आउटपुट जनरेट करने हेतु करते हैं:
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
ध्यान दें कि हम OpenAI मॉडल कॉल करते समय store=True का उपयोग करते हैं। यह आर्ग्यूमेंट हमारे OpenAI डैशबोर्ड में इनपुट/आउटपुट जोड़ियों को सेव कर देगा, इसलिए हमें आउटपुट कोड से स्टोर करने की ज़रूरत नहीं पड़ेगी।
बाद में इन चैट completions को पहचानने और फ़िल्टर करने के लिए, client.chat.completions.create फ़ंक्शन कॉल करते समय मेटाडेटा जोड़ना न भूलें। इस मेटाडेटा के आर्ग्यूमेंट मनमाने हो सकते हैं।
जनरेट किए गए आउटपुट हमारे OpenAI डैशबोर्ड के Chat Completions सेक्शन में मिलेंगे।
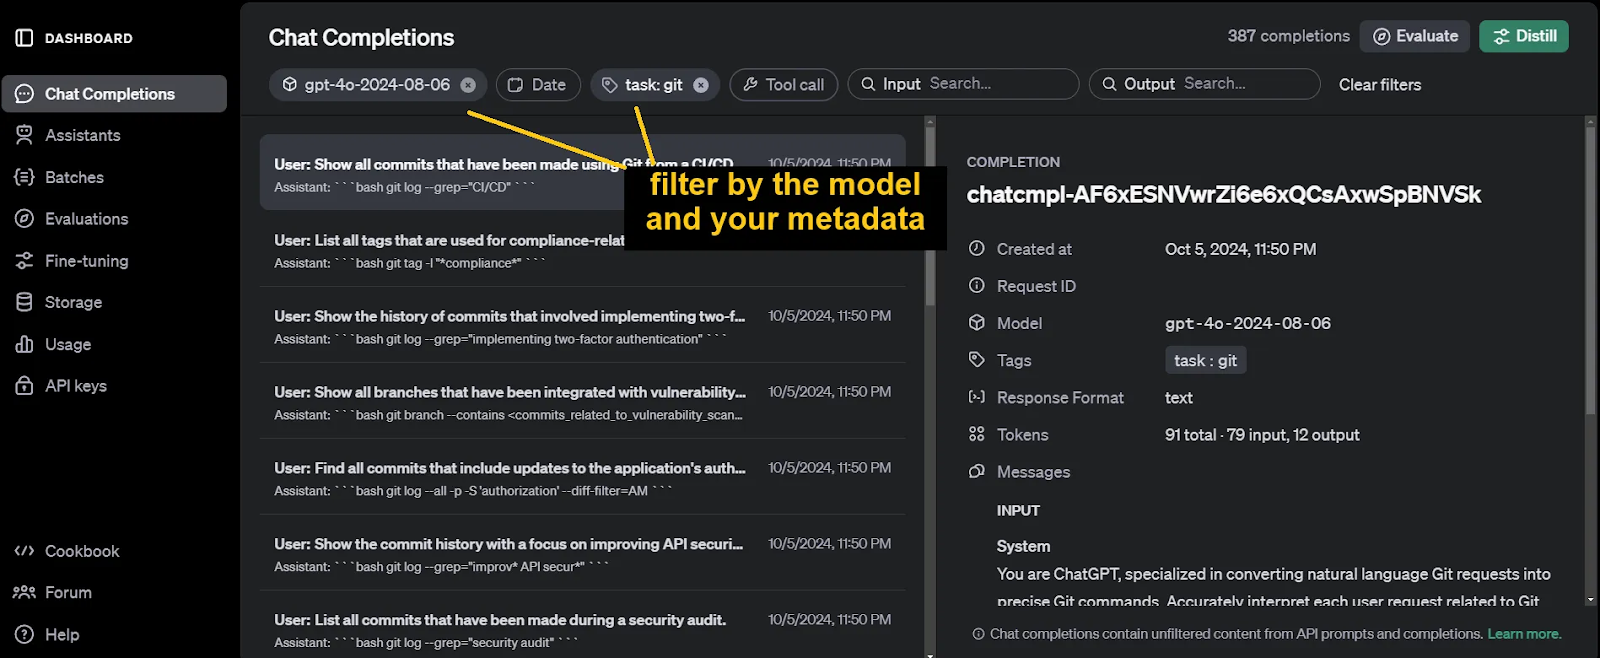
मॉडल डिस्टिलेशन के लिए OpenAI का एक और उपयोगी टूल है उनका Evaluations टूल। हम इस टूल का उपयोग प्रशिक्षण से पहले छात्र मॉडल के प्रदर्शन का बेसलाइन मीट्रिक के रूप में आकलन करने के लिए करते हैं। फाइन-ट्यून किए गए छात्र मॉडल का मूल्यांकन करते समय हम इसे दोबारा भी उपयोग करेंगे।
पिछले कदम के चैट completions को फ़िल्टर करने के बाद, Evaluate बटन पर क्लिक करें। अब हमें परीक्षण मानदंड जोड़ने हैं।
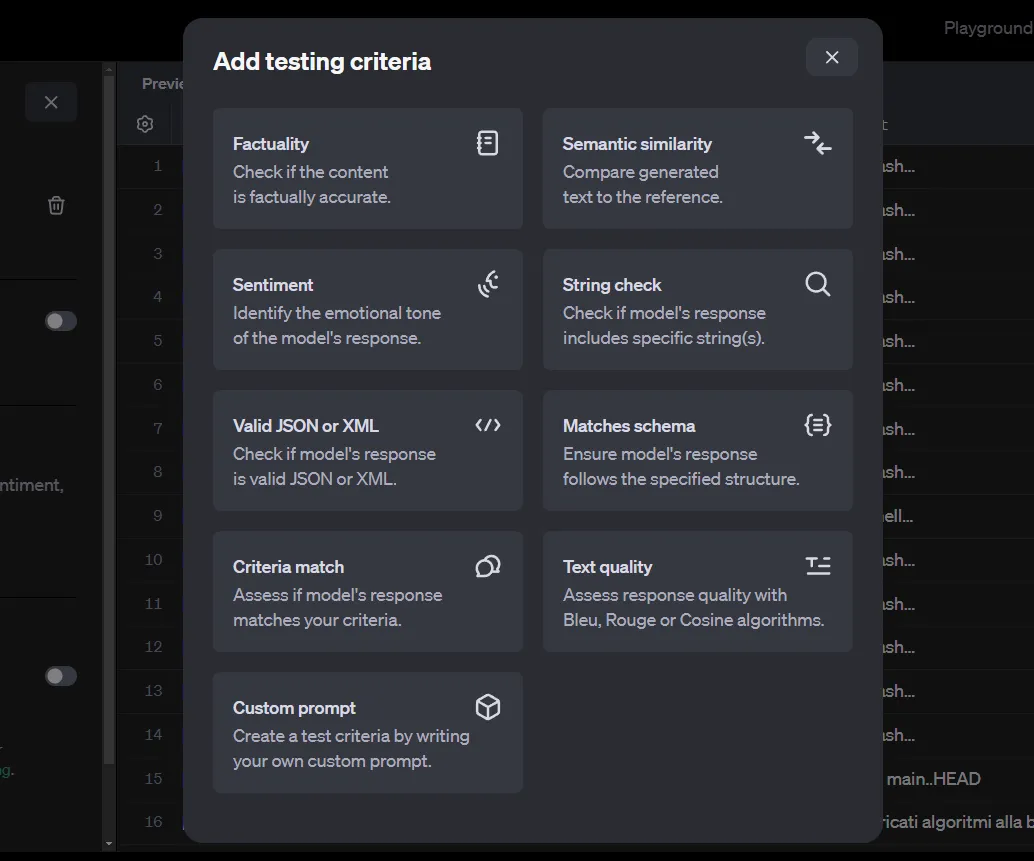
इनपुट/आउटपुट जोड़ियों का मूल्यांकन करने के कई तरीके हैं। ध्यान दें कि हमारा वर्तमान डेटासेट OpenAI के चैट completions द्वारा स्वचालित रूप से जनरेट किया गया है और केवल इनपुट और आउटपुट ही शामिल करता है। हालांकि, इन मानदंडों में से कुछ के लिए तुलना हेतु एक संदर्भ भी आवश्यक होता है।
यह संदर्भ किसी अधिक परिष्कृत मॉडल, जैसे GPT-4o या o1-preview, द्वारा जनरेट किए गए आउटपुट हो सकते हैं। चूँकि चैट्स को स्वचालित रूप से OpenAI में स्टोर करने पर हम ऐसा संदर्भ प्रदान नहीं कर पाते, इसलिए हम Criteria match या Custom prompt तरीकों तक सीमित हैं, जिन्हें केवल इनपुट और आउटपुट चाहिए।
यदि आपको अन्य तरीकों का उपयोग करना है, तो आप OpenAI के चैट completions का उपयोग नहीं कर सकते और आपको अपना JSON फ़ाइल कोड से बनानी होगी। यह जटिल नहीं है, लेकिन इस लेख में हम इसमें नहीं जाएंगे।
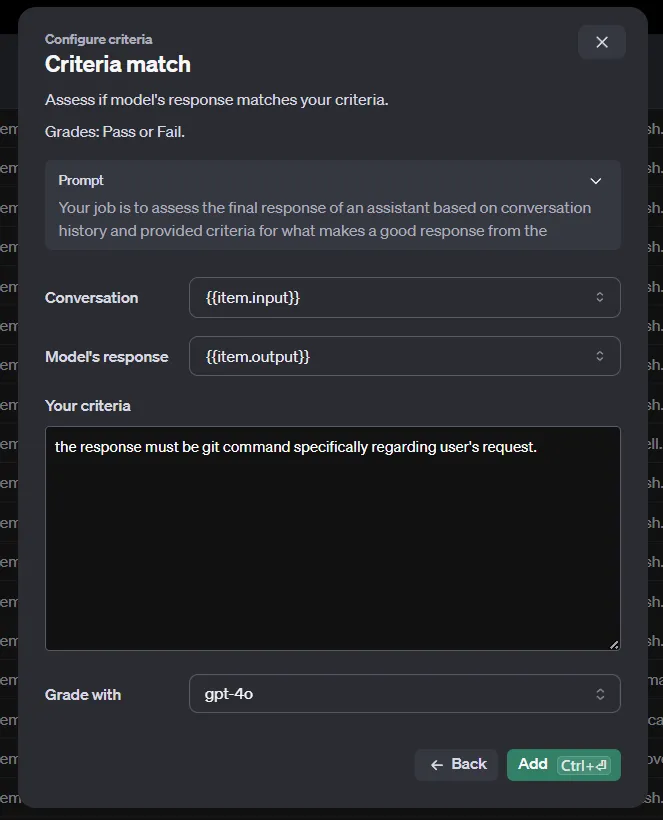
एक बार जब आप मूल्यांकन चलाते हैं, तो आपको शीघ्र ही परिणाम मिल जाएंगे।
छात्र मॉडल को फाइन-ट्यून करने के लिए, हमें शिक्षक द्वारा जनरेट किया गया उच्च-गुणवत्ता वाला डेटासेट चाहिए। यह कदम लगभग कदम 3 जैसा ही है—आपको केवल model आर्ग्यूमेंट को gpt-4o-mini से बदलकर gpt-4o करना है।
फिर से, Chat Completions में, शिक्षक मॉडल और मेटाडेटा से फ़िल्टर करें। अगला, Distill बटन चुनें। OpenAI का distill मूलतः फाइन-ट्यूनिंग टूल ही है।
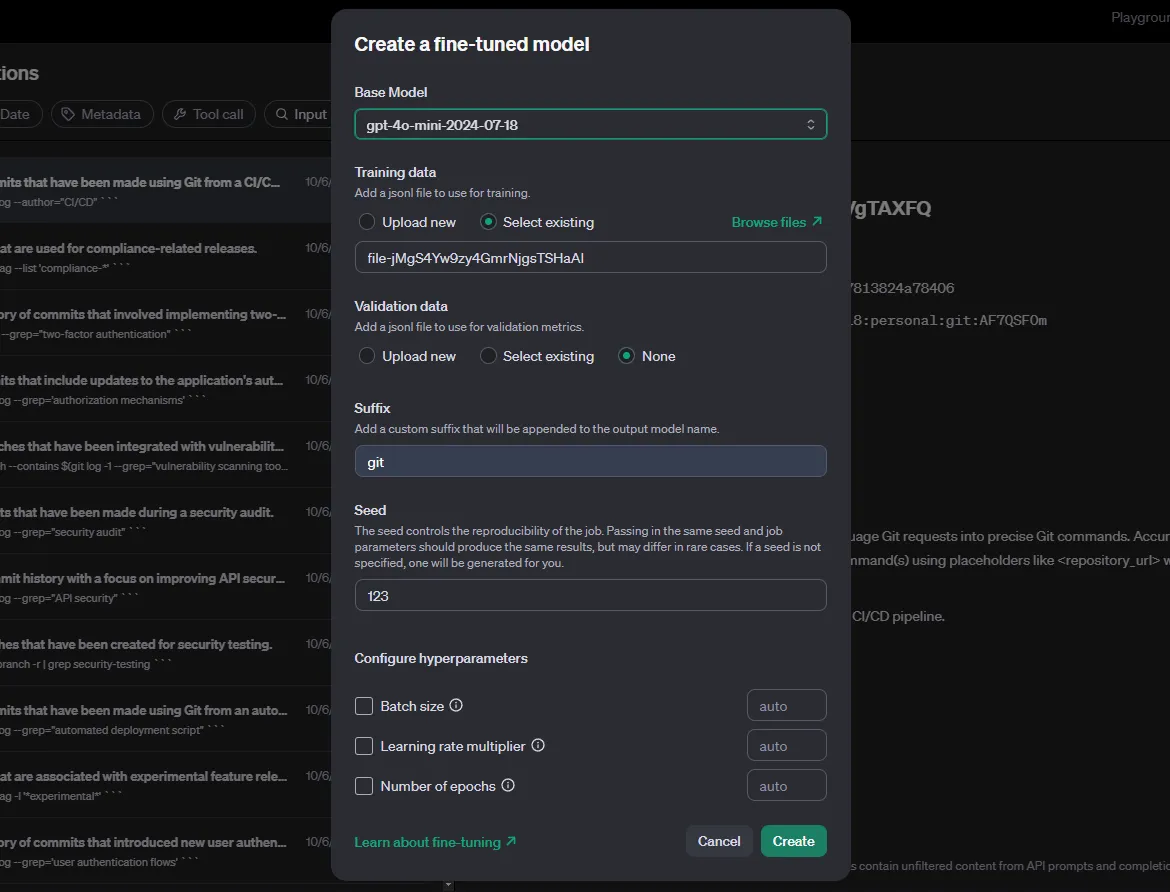
बेस मॉडल के लिए, हम छात्र को चुनते हैं। सर्वोत्तम परिणाम पाने के लिए हाइपरपैरामीटर्स पर प्रयोग और परीक्षण करना पड़ता है—इन्हें auto पर सेट करें। अंत में, Create चुनें और फाइन-ट्यूनिंग के पूरा होने का इंतज़ार करें।
पूरा होने पर, हम फिर से कदम 3 का कोड उपयोग करेंगे, इस बार model आर्ग्यूमेंट में फाइन-ट्यून किए गए मॉडल का उपयोग करेंगे। फाइन-ट्यून किए गए मॉडल का नाम आपकी फाइन-ट्यूनिंग पेज पर “Output model” के रूप में दिखता है।
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="ft:gpt-4o-mini-2024-07-18:personal:git:AF7QSF0m",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
आउटपुट जनरेट करने का काम पूरा होने के बाद, इनपुट पर अपने नए मॉडल की क्षमता का आकलन करने के लिए evaluations का उपयोग करें।
OpenAI का डिस्टिलेशन नुस्ख़ा सरल और सीधा है। यह विशेष रूप से सहायक है क्योंकि आपको मॉडलों को स्वयं फाइन-ट्यून करने या परिणामों का मूल्यांकन करने के लिए कोड लिखने की चिंता नहीं करनी पड़ेगी।
OpenAI के मॉडल, छोटे वाले भी, काफी परिष्कृत हैं। मॉडल को फाइन-ट्यून करने से पहले हाइपरपैरामीटर्स के साथ प्रयोग ज़रूर करें, शिक्षक और छात्र दोनों के लिए पर्याप्त और चुनौतीपूर्ण प्रॉम्प्ट तैयार करें, और फाइन-ट्यून किए गए मूल्यांकन की तुलना बेसलाइन मूल्यांकन से करें।
अपने स्वयं के मॉडल डिस्टिलेशन पर हाथ आज़माने से पहले, मैं आपको OpenAI के ये दो संसाधन पढ़ने की सलाह देता हूं: OpenAI Model Distillation in the API और Model Distillation Document।
AI अनुप्रयोग बनाना सीखें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}