Leerpad
AI-toepassingen ontwikkelen
21 uur
Ik heb OpenAI's nieuwe modeldistillatietool geprobeerd—er is maar weinig code voor nodig en je kunt het hele distillatieproces binnen één platform beheren, van het genereren van datasets tot het finetunen van modellen en het evalueren van de prestaties.
In deze tutorial help ik je op weg met OpenAI's modeldistillatietool. Eerst behandelen we de basis van modeldistillatie en daarna doen we een demo-distillatieproject met OpenAI's API.
Stel je een kundige, goed opgeleide docent voor die zijn denkproces en kennis overdraagt aan een leerling. Dat is in de basis hoe modeldistillatie werkt.
Bij deze techniek is de docent een groot, voorgetraind model en de leerling een kleiner model dat leert het outputgedrag van de docent te reproduceren. Zo kan de leerling specifieke taken uitvoeren op een niveau dat vergelijkbaar is met de docent, maar met minder benodigde resources.
Modeldistillatie kent vele vormen, elk met eigen methoden en doelen. In het ene geval hoeft de leerling alleen de outputs van een groter model na te bootsen. In een ander geval willen we de probleemaanpak van de docent overbrengen op het kleinere model. Uiteindelijk is het doel te profiteren van de capaciteiten van een groot model met een efficiënter model.
Een veelgebruikte methode om kennis over te dragen van een "docent"- naar een "leerling"-model is het finetunen van de leerling op een dataset met invoer en de bijbehorende outputs die door de docent zijn gegenereerd.
Tijdens dit supervised learning-proces leert het leerlingmodel de reacties van de docent te reproduceren bij vergelijkbare input.
Het distillatieproces heeft veel voordelen:
Wil je meer weten over distillatie? Lees dan dit artikel: LLM Distillation Explained.
In dit deel bekijken we een voorbeeld van modeldistillatie met het OpenAI-platform. We focussen vooral op het genereren van Git-commando's op basis van een gebruikersverzoek.
We maken eerst een dataset van OpenAI’s kleine GPT-4o mini (leerling) en evalueren de outputs.
Vervolgens gebruiken we GPT-4o (docent) om dezelfde zinnen te vertalen en finetunen we het leerlingmodel op de dataset die door de docent is geproduceerd.
Tot slot evalueren we het leerlingmodel en beoordelen we de verbetering.
Samengevat zijn dit de stappen die we gaan nemen:
De eerste stap van modeldistillatie is het kiezen van de docent en de leerling, bepaald door de beoogde taak en je rekenbudget.
Met opensourcemodellen is er een breed scala aan LLM’s met verschillende capaciteiten en groottes. Op OpenAI’s platform zijn de opties beperkter.
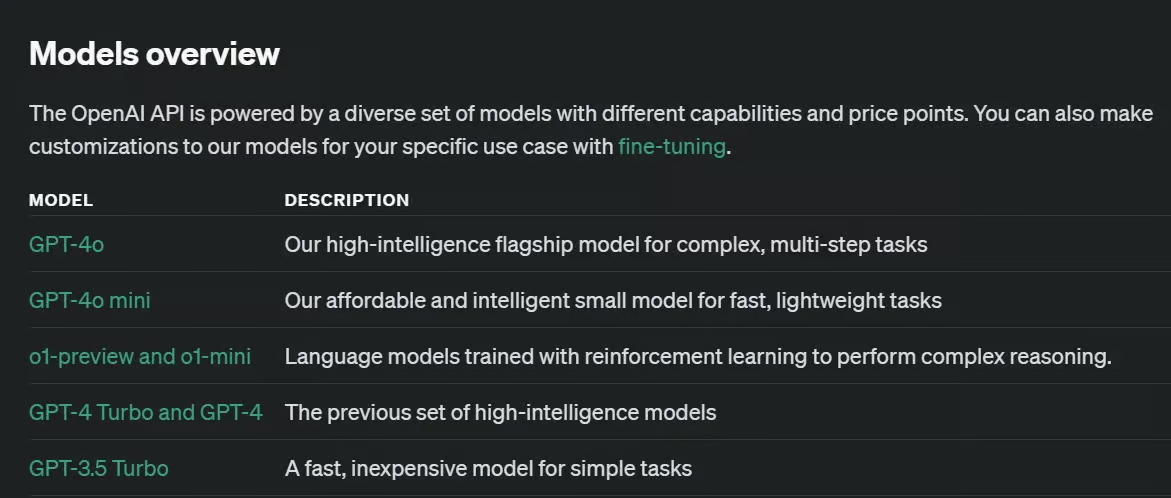
Voor ons voorbeeld kiezen we GPT-4o mini als het kleinere leerlingmodel en GPT-4o als docentmodel.
GPT-4o-mini is relatief klein en een goede kandidaat als leerling. GPT-4o is relatief groter maar veel capabeler en kan een effectieve docent zijn voor de leerling.
Er zijn ook andere opties, en het veranderen van de modellen vergt minimale aanpassing in ons modeldistillatieproject.
Je dataset voor deze taak moet uitdagend genoeg zijn voor het leerlingmodel, maar niet zo uitdagend voor de docent. De kwaliteiten van een goede dataset, zoals diversiteit, representativiteit en nauwkeurigheid, blijven ook bij modeldistillatie van belang.
Een dataset die groot genoeg is om impact te hebben op het leerlingmodel is erg belangrijk. Er is geen eenduidig antwoord op de vraag “Hoe groot moet de distillatiedataset zijn?” omdat dit afhangt van de complexiteit van je doeltaak en de modellen die je als docent en leerling hebt gekozen.
Volgens OpenAI's documentatie kunnen enkele honderden voorbeelden voldoende zijn, maar een meer diverse set van duizenden voorbeelden kan soms tot betere resultaten leiden.
Onze dataset in dit artikel bestaat uit 386 gebruikersverzoeken die zijn opgeslagen in een JSON-bestand (je zou ze net zo goed als een Python-lijst kunnen opslaan).
{
    "requests": [
      "Initialize a new Git repository in the current directory.",
      "Clone the repository from GitHub to my local machine.",
      "Create a new branch called 'feature-login'.",
			...
      "Show the differences between the working directory and the staging area.",
      "Stage all modified and deleted files for commit.",
      ]
}Onze dataset bevat op dit moment alleen input; we moeten ook outputs genereren. De outputs van de leerling zijn niet noodzakelijk voor de distillatie, maar we hebben ze nodig om een nulmeting te krijgen voor de nauwkeurigheid van het leerlingmodel (stap 4).
We gebruiken onderstaande code om over de inputdataset te itereren en voor elke invoer een output te genereren:
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
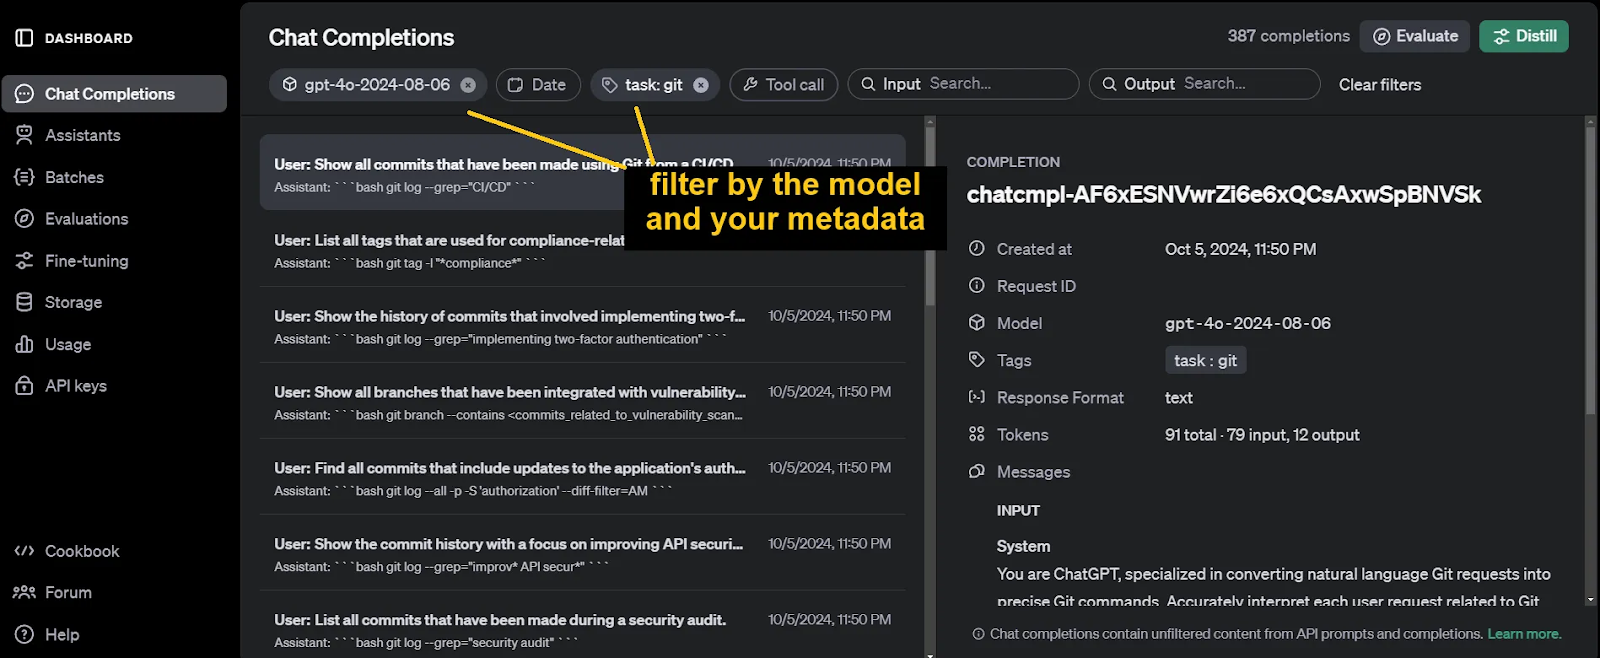
Let op dat we store=True gebruiken bij het aanroepen van het OpenAI-model. Dit argument slaat de input/output-paren op in ons OpenAI-dashboard, zodat we de outputs niet met code hoeven op te slaan.
Om deze chatcompletions later te kunnen identificeren en filteren, vergeet niet metadata mee te geven bij het aanroepen van de functie client.chat.completions.create. De argumenten voor deze metadata zijn vrij te kiezen.
De gegenereerde outputs vind je in de Chat Completions-sectie van ons OpenAI-dashboard.
Een andere handige tool van OpenAI voor modeldistillatie is hun Evaluations-tool. We gebruiken deze tool om de prestaties van het leerlingmodel vóór het trainen te meten als nulmeting. We gebruiken hem later ook bij het evalueren van het gefinetunede leerlingmodel.
Nadat je de chatcompletions uit de vorige stap hebt gefilterd, klik je op de knop Evaluate. We moeten nu testcriteria toevoegen.
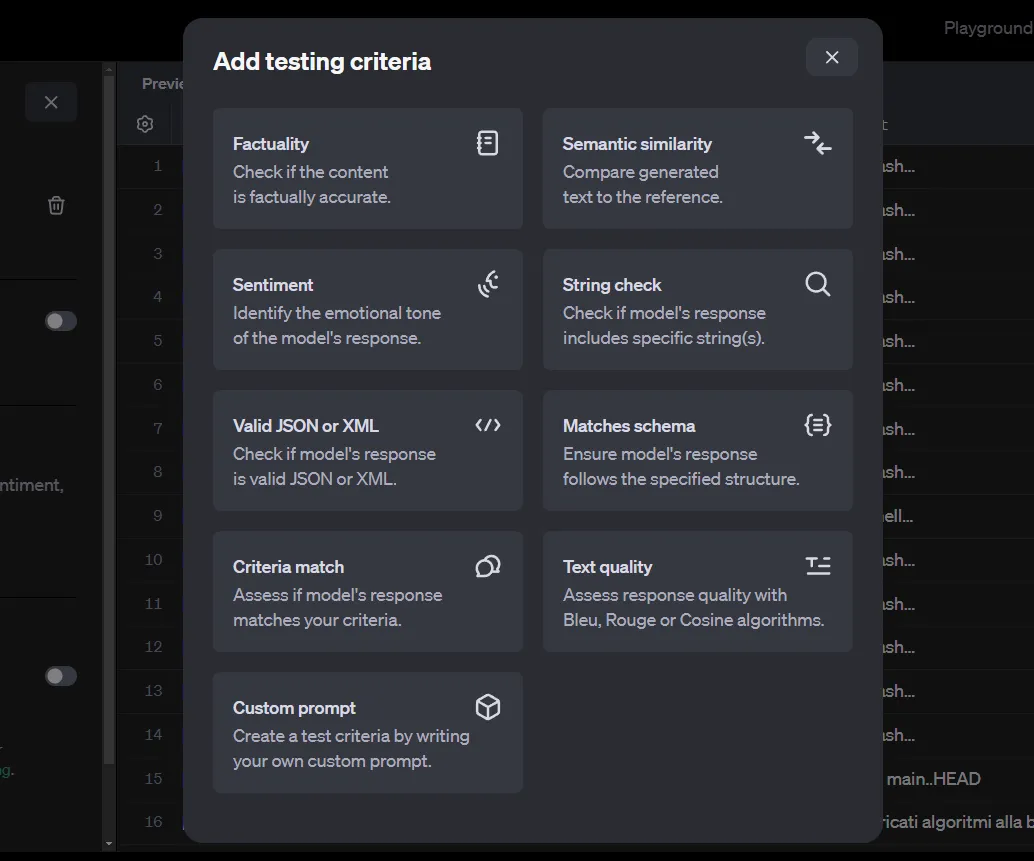
Er zijn verschillende methoden om de input/output-paren te evalueren. Let op dat onze huidige dataset automatisch is gegenereerd door OpenAI’s chatcompletions en alleen de input en outputs bevat. Sommige criteria vereisen echter ook een referentie om mee te vergelijken.
Die referentie kan bestaan uit outputs die zijn gegenereerd door een geavanceerder model, zoals GPT-4o of o1-preview. Omdat het automatisch opslaan van chats bij OpenAI het niet mogelijk maakt zo’n referentie mee te geven, zijn we beperkt tot de methoden Criteria match of Custom prompt, die alleen input en output nodig hebben.
Als je andere methoden wilt gebruiken, kun je niet werken met OpenAI’s chatcompletions en moet je zelf je JSON-bestand met code aanmaken. Dat is niet ingewikkeld, maar daar gaan we in dit artikel niet op in.
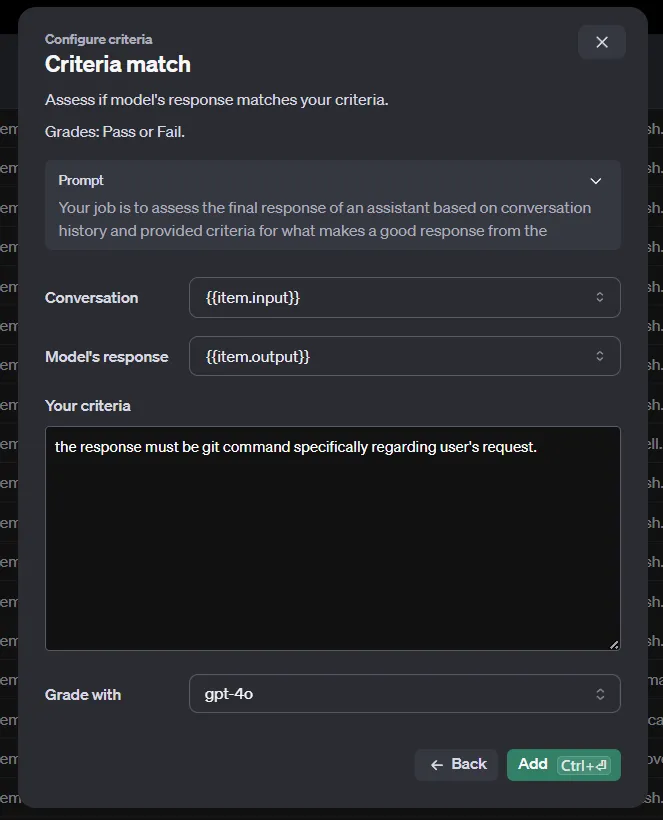
Zodra je de evaluaties draait, ontvang je snel de resultaten.
Om het leerlingmodel te finetunen, hebben we een hoogwaardige dataset nodig die door de docent is gegenereerd. Deze stap is bijna hetzelfde als stap 3—je hoeft alleen het model-argument te wijzigen van gpt-4o-mini naar gpt-4o.
Filter in de Chat Completions opnieuw op het docentmodel en de metadata. Selecteer vervolgens de knop Distill. OpenAI’s distill is in feite de finetuningtool.
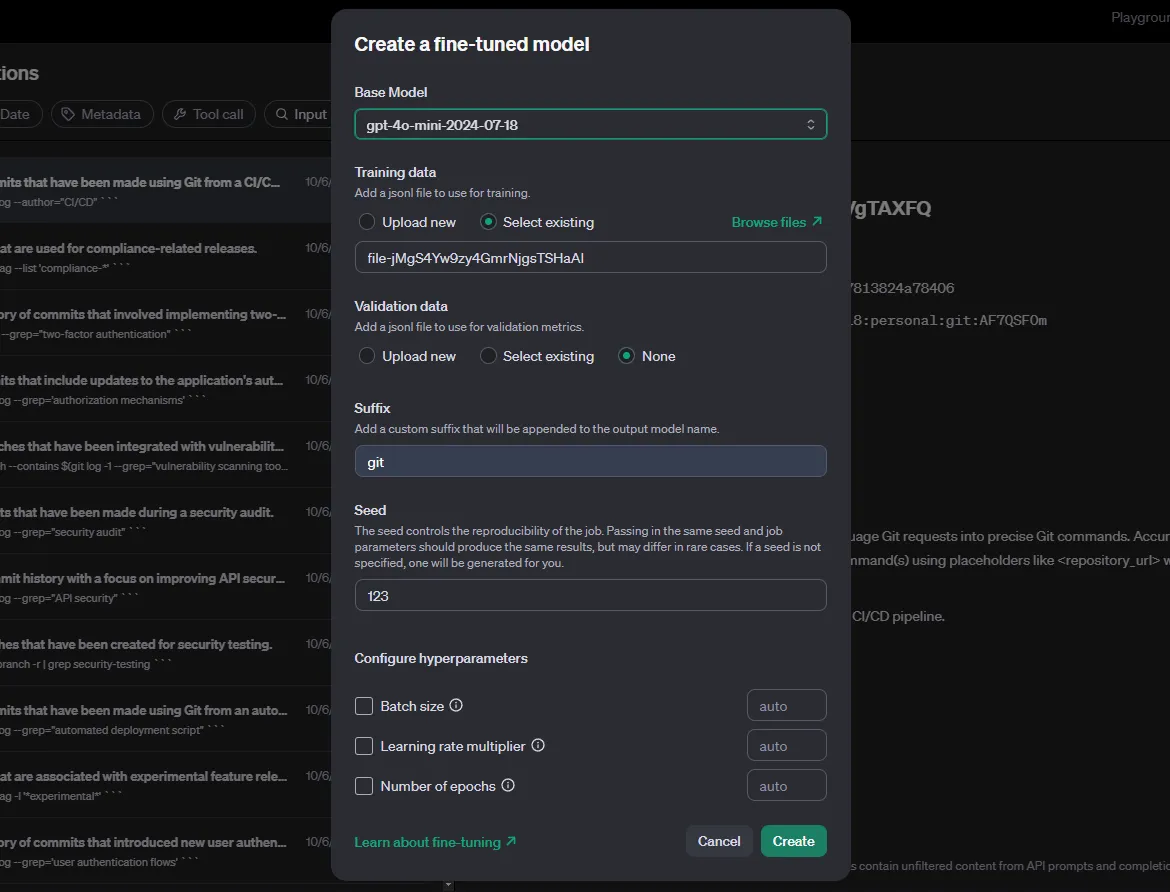
Als basismodel selecteren we de leerling. Met de hyperparameters moet je experimenteren en testen om de beste resultaten te behalen—zet ze op auto. Klik tot slot op Create en wacht tot het finetunen is voltooid.
Wanneer dit klaar is, gebruiken we de code uit stap 3 opnieuw, ditmaal met het gefinetunede model als het model-argument. De naam van het gefinetunede model staat als “Output model” op je finetuningpagina.
def generate_responses():
    with open(JSON_PATH, 'r') as file:
        user_messages = json.load(file)

    for sentence in user_messages['requests']:
        # Call the OpenAI model gpt-4o-mini and store the response
        response = client.chat.completions.create(
            model="ft:gpt-4o-mini-2024-07-18:personal:git:AF7QSF0m",
            messages=[
                {"role": "system", "content": system_prompt},
                {
                    "role": "user",
                    "content": sentence
                },
            ],
            store=True,
            metadata={
                "task": "git"
            }
        )

generate_responses()
Na het genereren van de outputs gebruik je de evaluaties om de capaciteiten van je nieuwe model op de inputs te beoordelen.
OpenAI’s recept voor distillatie is eenvoudig maar doeltreffend. Het is vooral handig omdat je je geen zorgen hoeft te maken over het zelf finetunen van de modellen of het gebruiken van code om de resultaten te evalueren.
De modellen van OpenAI, zelfs de kleinere, zijn al behoorlijk geavanceerd. Experimenteer met de hyperparameters voordat je het model finetunet, bereid passende en uitdagende prompts voor zowel docent als leerling, en vergelijk de evaluatie van het gefinetunede model met de nulmeting.
Voordat je zelf met modeldistillatie aan de slag gaat, raad ik je aan deze twee OpenAI-bronnen te lezen: OpenAI Model Distillation in the API en Model Distillation Document.
Leer AI-toepassingen bouwen!
Leerpad
Cursus
Leerpad
blog
Adel Nehme
15 min

