Lewati ke konten utama

Tutorial Oracle AI Vector Search: Menyimpan dan Mengueri Embeddings dengan Python

Tutorial ini memperkenalkan Oracle AI Vector Search, menjelaskan fitur intinya, dan memandu proyek lokal praktis. Juga membahas kebutuhan penyiapan, pencarian semantik, pengindeksan vektor, dan langkah pemecahan masalah umum.
Diperbarui 28 Sep 2026  · 15 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Dalam tutorial ini, kita akan membangun demo pencarian semantik lokal dengan Oracle AI Vector Search, Python, dan Oracle Database Free 26ai. 

Kita akan mulai dengan vektor tiga dimensi buatan tangan agar perhitungan jarak terlihat, lalu menghasilkan embedding teks dan menguerinya dari Oracle Database dengan SQL. 

Tutorial ini ditujukan untuk pengembang Python dan SQL yang baru mengenal pencarian vektor dan terbiasa dengan Docker, variabel lingkungan, paket Python, serta penyiapan basis data lokal.

Aplikasi berbasis AI memerlukan pencarian yang memahami makna, bukan hanya kata yang persis sama. Aplikasi dukungan, portal dokumentasi, atau alat pengetahuan internal seharusnya dapat menemukan “penyimpanan basis data untuk pencarian AI” meskipun dokumen yang paling cocok menyatakan “menyimpan vektor embedding di kolom native”.

Vector embeddings memungkinkan hal tersebut dengan merepresentasikan teks sebagai vektor numerik. Oracle AI Vector Search memungkinkan kita menyimpan vektor tersebut langsung di Oracle Database, menguerinya dengan SQL, dan menyimpan embedding berdampingan dengan data aplikasi relasional. 

Untuk alur kerja lokal ini, kita tidak memerlukan basis data vektor terpisah.

Kita akan menjalankan Oracle Database Free 26ai secara lokal, terhubung dari Python dengan mode Thin oracledb, menyimpan vektor manual terlebih dahulu, lalu menyimpan embedding OpenAI, menjalankan pencarian semantik, membandingkan pengambilan semantik dengan predikat frasa persis, dan membuat indeks vektor yang divalidasi melalui USER_INDEXES.

Pada akhir sesi, kita akan memiliki alur kerja pencarian semantik bertenaga Python yang menyimpan embedding di Oracle Database dan mengambil documents yang paling mirip secara lokal.

Apa Itu Oracle AI Vector Search?

Oracle AI Vector Search adalah sekumpulan kapabilitas Oracle Database untuk menyimpan, mengindeks, dan mengueri embedding vektor. Embedding vektor adalah daftar bilangan berukuran tetap yang merepresentasikan makna teks, gambar, atau data lain dalam bentuk yang dapat dibandingkan secara matematis oleh basis data.

Model embedding yang membuat vektor numerik. Model menerima masukan seperti kalimat, paragraf, deskripsi gambar, atau potongan kode dan mengembalikan vektor dengan jumlah dimensi tetap.

Masukan yang serupa seharusnya menghasilkan vektor yang berdekatan, sementara masukan yang tidak berhubungan seharusnya berada lebih jauh. Karena itu, kita harus menggunakan model embedding yang sama untuk documents yang disimpan dan kueri yang masuk karena jarak hanya bermakna jika vektor berbagi sistem koordinat yang sama.

Dalam tutorial ini, vektor manual sengaja dibuat kecil agar kita dapat memeriksa matematikanya. Embedding teks yang sebenarnya jauh lebih besar karena model membutuhkan cukup banyak dimensi untuk menyandikan hubungan yang lebih halus antar kata, frasa, dan topik.

Pencarian vektor memberi peringkat baris berdasarkan jarak antar vektor. Untuk kueri jarak Euclidean dan kosinus, nilai jarak yang lebih kecil berarti kecocokan yang lebih dekat. Dalam tutorial ini, kita akan mulai dengan kolom kecil VECTOR(3, FLOAT32) agar kita dapat melihat perilaku jarak secara langsung, lalu beralih ke embedding VECTOR(1536, FLOAT32) yang dihasilkan dari teks.
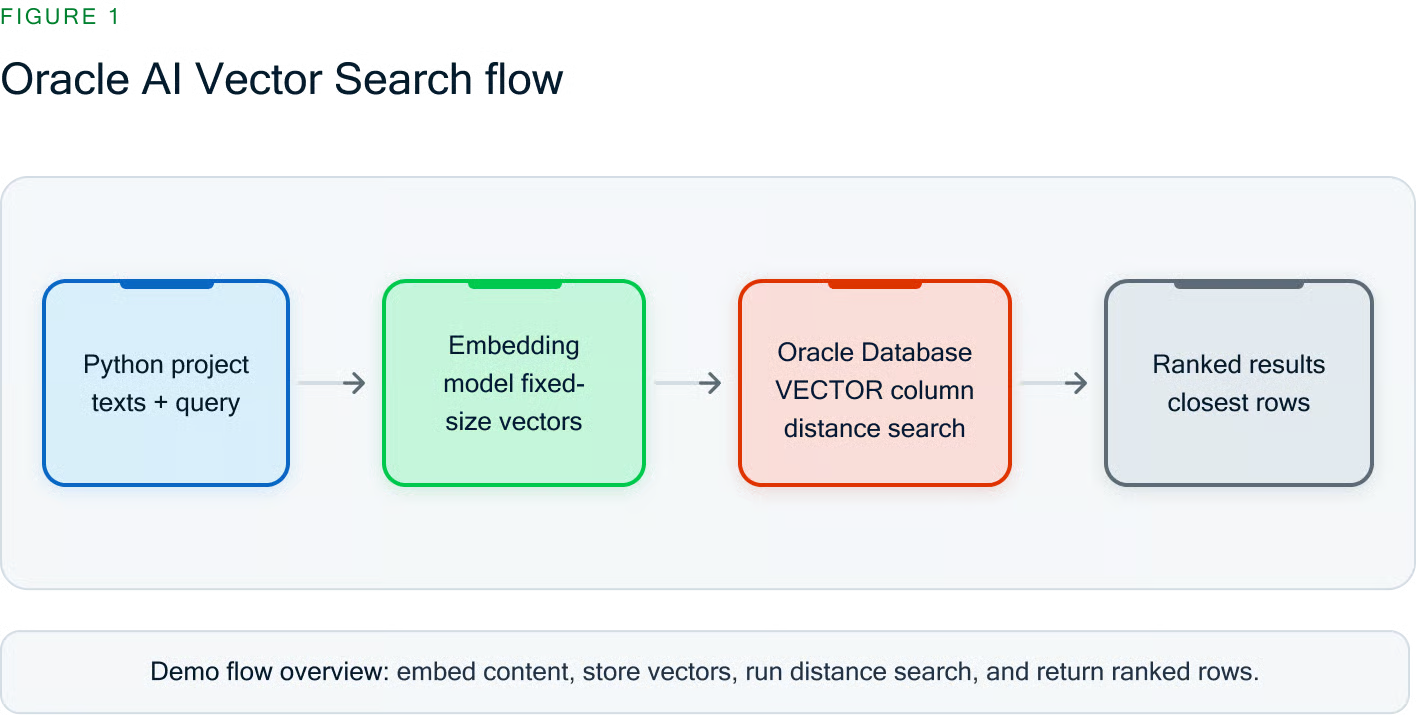
Alur Oracle AI Vector Search

Gambar 1. Alur Oracle AI Vector Search

Oracle AI Vector Search menyimpan embedding di kolom VECTOR native dan memberi peringkat hasil berdasarkan jarak vektor.

Oracle Database bermanfaat saat embedding perlu berdampingan dengan data aplikasi relasional seperti ID dokumen, judul, konten, pengguna, produk, tiket, atau metadata. 

Beberapa aplikasi menggunakan basis data vektor atau mesin pencari terpisah untuk beban kerja pengambilan khusus, tetapi untuk alur kerja pencarian semantik lokal pada tutorial ini, Oracle Database menyediakan fitur penyimpanan dan pencarian vektor yang kita perlukan.

Fitur Utama Oracle AI Vector Search

Kita akan menggunakan empat fitur Oracle AI Vector Search dalam demo: penyimpanan vektor native, fungsi jarak, indeks vektor, dan integrasi relasional.

Tipe data vektor native

Oracle Database mendukung kolom VECTOR native dengan dimensi dan format elemen eksplisit. Dalam demo, kita akan menggunakan VECTOR(3, FLOAT32) untuk vektor manual dan VECTOR(1536, FLOAT32) untuk model embedding default text-embedding-3-small.

Fungsi dan operator jarak

Contoh yang dapat dijalankan menggunakan VECTOR_DISTANCE() karena metrik jarak tetap eksplisit di SQL. 

Kita akan menggunakan jarak Euclidean untuk contoh vektor manual dan jarak kosinus untuk embedding teks. 

Oracle Database juga menyertakan operator jarak vektor singkat dan perilaku jarak terkait dot product, tetapi tutorial ini mempertahankan SQL yang dapat dijalankan pada jalur eksplisit VECTOR_DISTANCE().

Metrik jarak yang berbeda menjawab pertanyaan yang sedikit berbeda tentang “kedekatan.” 

Untuk tutorial kecil, jarak kosinus adalah default yang baik untuk embedding teks karena berfokus pada arah, yang sering kali sesuai dengan kemiripan semantik. 

Jarak Euclidean lebih mudah divisualisasikan dengan vektor buatan tangan, dan perbandingan gaya dot product berguna dalam beberapa sistem pengambilan saat magnitudo vektor atau vektor ternormalisasi menjadi bagian dari rancangan model.

Metrik

Apa yang Dibandingkan

Kecocokan yang Baik

Perhatikan

Kosinus

Arah vektor

Embedding teks dan kemiripan semantik

Hasil bergantung pada penggunaan model embedding yang sama dan prapemrosesan yang konsisten

Euclidean

Jarak garis lurus

Contoh kecil, intuisi geometri, beberapa vektor fitur numerik

Magnitudo memengaruhi jarak, sehingga penskalaan bisa berpengaruh

Dot product

Arah dan magnitudo sekaligus

Alur kerja yang dirancang untuk vektor ternormalisasi atau penilaian inner product

Arah skor dan aturan normalisasi perlu dipahami sebelum membandingkan hasil

Indeks vektor

Pencarian vektor eksak berguna untuk kebenaran dan dataset kecil. Seiring dataset tumbuh, indeks vektor mendukung alur kerja pencarian tetangga terdekat perkiraan.

Oracle AI Vector Search menyertakan indeks graf tetangga dalam memori, sering dikaitkan dengan pencarian gaya HNSW, dan indeks partisi tetangga, sering dikaitkan dengan partisi gaya IVF. 

Dalam demo lokal ini, kita menggunakan ORGANIZATION NEIGHBOR PARTITIONS dan memvalidasi indeks dengan USER_INDEXES.

Indeks perkiraan menukar sedikit kepastian pencarian menyeluruh dengan pengambilan yang lebih cepat pada skala besar. 

Keluarga indeks yang tepat bergantung pada beban kerja, volume data, pola pembaruan, dan target recall.

Tutorial ini menggunakan indeks partisi tetangga gaya IVF karena menjaga penyiapan lokal tetap sederhana dan menyediakan langkah pembuatan indeks yang konkret tanpa mengubah tutorial menjadi panduan penalaan indeks.

Keluarga Indeks

Gagasan Dasar

Kekuatan

Konsekuensi

Kapan Kita Menggunakannya

IVF / partisi tetangga

Mempartisi ruang vektor, lalu mencari partisi yang mungkin

Model mental sederhana, praktis untuk banyak dataset yang dimuat batch

Recall dan kecepatan bergantung pada pengaturan partisi dan pencarian

Kita menginginkan jalur pencarian perkiraan yang lugas untuk dataset yang tumbuh

HNSW / graf tetangga

Membangun graf yang menautkan vektor berdekatan untuk traversing cepat

Profil recall dan latensi yang kuat untuk banyak beban kerja tetangga terdekat

Lebih berorientasi memori, dan konfigurasi bisa lebih berpengaruh

Kita membutuhkan pencarian berlatensi rendah dan dapat mengalokasikan memori serta upaya penalaan

Integrasi dengan kueri relasional

Kolom vektor dapat berada di samping kolom relasional biasa. Tabel documents kita akan menyimpan judul, konten, dan embedding bersama, sehingga SQL dapat mengembalikan baik skor kemiripan maupun teks dokumen asli.

Cara Memulai dengan Oracle AI Vector Search

Kita akan menggunakan satu jalur penyiapan lokal: Oracle Database Free 26ai di Docker, layanan FREEPDB1, dan pengguna aplikasi khusus vector_demo. 

Konsep pencarian vektor mudah didekati, tetapi penyiapannya berada pada tingkat menengah karena kita menggunakan Docker, skema basis data, paket Python, variabel lingkungan, dan kunci API embedding.

Prasyarat

Kita memerlukan:

  • Docker Desktop atau Docker Engine.
  • Akses ke Oracle Container Registry.
  • Port lokal 1521 dan 5500 tersedia.
  • Python 3.10 atau yang lebih baru.
  • Pengetahuan dasar Python dan SQL.
  • Pemahaman dasar Docker dan variabel lingkungan.
  • Kunci API OpenAI untuk langkah embedding.

Demo ini memerlukan versi atau lingkungan Oracle Database yang menyertakan fitur vektor yang digunakan di sini, termasuk kolom VECTOR native, VECTOR_DISTANCE(), dan CREATE VECTOR INDEX. 

Jalur lokal menggunakan Oracle Database Free 26ai dengan tag image yang ditampilkan di bawah, dan DSN menggunakan layanan pluggable database FREEPDB1.

Langkah vektor manual tidak memerlukan kunci API OpenAI. Langkah semantik mengirimkan teks dokumen contoh dan teks kueri ke penyedia embedding yang dikonfigurasi, jadi kita hanya akan menggunakan teks contoh atau non-sensitif.

Tutorial ini menggunakan oracledb, driver Python terkini untuk Oracle Database. python-oracledb berjalan dalam mode Thin secara default, sehingga demo lokal ini tidak memerlukan pustaka Oracle Client. Mode Thick berguna pada penerapan Oracle Database lainnya, tetapi kita tidak akan memanggil oracledb.init_oracle_client() di sini.

Menjalankan Oracle Database Free 26ai secara lokal

Buat direktori proyek untuk skrip yang akan kita bangun.

mkdir oracle-ai-vector-search-python
 cd oracle-ai-vector-search-python

Jalankan Oracle Database Free 26ai dengan image container lokal.

docker run --name oracle-free-26ai-vector \
   --detach \
   --publish 1521:1521 \
   --publish 5500:5500 \
   --shm-size=1g \
   --env ORACLE_PWD="replace-with-a-strong-password" \
   container-registry.oracle.com/database/free:23.26.1.0-lite-amd64

Periksa log container dan tunggu hingga basis data melaporkan bahwa startup telah selesai.

docker logs oracle-free-26ai-vector

FREEPDB1 adalah layanan pluggable database yang digunakan oleh jalur container Oracle Database Free lokal ini. DSN Python kita akan localhost:1521/FREEPDB1.

Buat skema vector_demo di FREEPDB1

Gunakan SYS hanya untuk langkah penyiapan skema. Kata sandi pada perintah sqlplus adalah nilai ORACLE_PWD dari perintah docker run; kata sandi pada CREATE USER adalah kata sandi aplikasi yang akan kita ekspor sebagai DB_PASSWORD.

Jalankan penyiapan di dalam container basis data.

# Create the application user and grant the privileges needed for the demo.
 docker exec -i oracle-free-26ai-vector \
   sqlplus -s 'sys/"replace-with-oracle-pwd"@FREEPDB1 as sysdba' <<'SQL'
 WHENEVER SQLERROR EXIT SQL.SQLCODE

 CREATE USER vector_demo IDENTIFIED BY "replace-with-vector-demo-password";

 GRANT CREATE SESSION, CREATE TABLE, CREATE SEQUENCE, UNLIMITED TABLESPACE TO vector_demo;

 EXIT
 SQL

Ini adalah jalan pintas pengembangan lokal untuk container demo. CREATE SEQUENCE diperlukan karena tabel menggunakan kolom identitas. 

Untuk produksi, kita akan meninjau hak istimewa bersama administrator basis data dan menerapkan least privilege sesuai beban kerja aplikasi yang tepat.

Instal dependensi Python

Buat dan aktifkan virtual environment.

python -m venv .venv
 source .venv/bin/activate
 python -m pip install --upgrade pip

Instal paket Python yang digunakan oleh demo.

python -m pip install oracledb openai

Set variabel lingkungan

Simpan kredensial basis data dan pengaturan embedding dalam variabel lingkungan alih-alih menanamkannya di berkas Python.

export DB_USER="vector_demo"
 export DB_PASSWORD="replace-with-vector-demo-password"
 export DB_DSN="localhost:1521/FREEPDB1"
 export OPENAI_API_KEY="replace-with-your-api-key"
 export EMBEDDING_MODEL="text-embedding-3-small"
 export EMBEDDING_DIM="1536"

OPENAI_API_KEY hanya diperlukan untuk langkah embedding dan pencarian semantik. EMBEDDING_DIM harus sesuai dengan jumlah dimensi yang dikembalikan oleh model embedding yang dipilih.

Proyek Demo Oracle AI Vector Search

Kita akan membangun demo dalam delapan checkpoint. Setiap skrip menambahkan satu konsep dan menghasilkan keluaran yang dapat kita verifikasi sebelum lanjut.

Checkpoint khusus basis data selesai setelah Langkah 1–3. Pada titik itu, kita telah terhubung ke Oracle Database, menyimpan vektor manual, menguerinya berdasarkan jarak, dan membuat tabel semantik. Kunci API OpenAI mulai diperlukan pada Langkah 4.

Langkah 1: Terhubung ke basis data lokal

Pertama, kita akan memastikan Python dapat terhubung ke Oracle Database sebagai pengguna aplikasi vector_demo. Skrip ini membaca DB_USER, DB_PASSWORD, dan DB_DSN dari lingkungan dan mencetak mode driver serta versi basis data.

Buat skrip

Simpan kode berikut sebagai 01_check_connection.py.

import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	# Load required database settings from environment variables.
 	user = required_env("DB_USER")
     password = required_env("DB_PASSWORD")
 	dsn = required_env("DB_DSN")

 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Open a Thin-mode connection with the application user.
 	with oracledb.connect(user=user, password=password, dsn=dsn) as connection:
         mode = "thin" if oracledb.is_thin_mode() else "thick"
         print("Connected to Oracle Database.")
         print(f"Driver mode: {mode}")
         print(f"Database version: {connection.version}")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan pemeriksaan koneksi.

python 01_check_connection.py

Keluaran yang diharapkan

Keluaran harus memastikan bahwa koneksi berhasil dan driver berada dalam mode Thin.

Connected to Oracle Database.
 Driver mode: thin
 Database version: 23.26.1.0.0

Sekarang kita tahu bahwa basis data lokal, nama layanan, kredensial, dan driver Python berfungsi sebelum kita membuat tabel vektor apa pun.

Langkah 2: Bangun intuisi dengan vektor manual

Sebelum kita memperkenalkan model embedding, mari kita simpan tiga vektor kecil yang bisa kita pahami. Panggilan array.array("f", values) membuat array floating-point 32-bit yang dapat diikat oleh python-oracledb ke kolom VECTOR(..., FLOAT32).
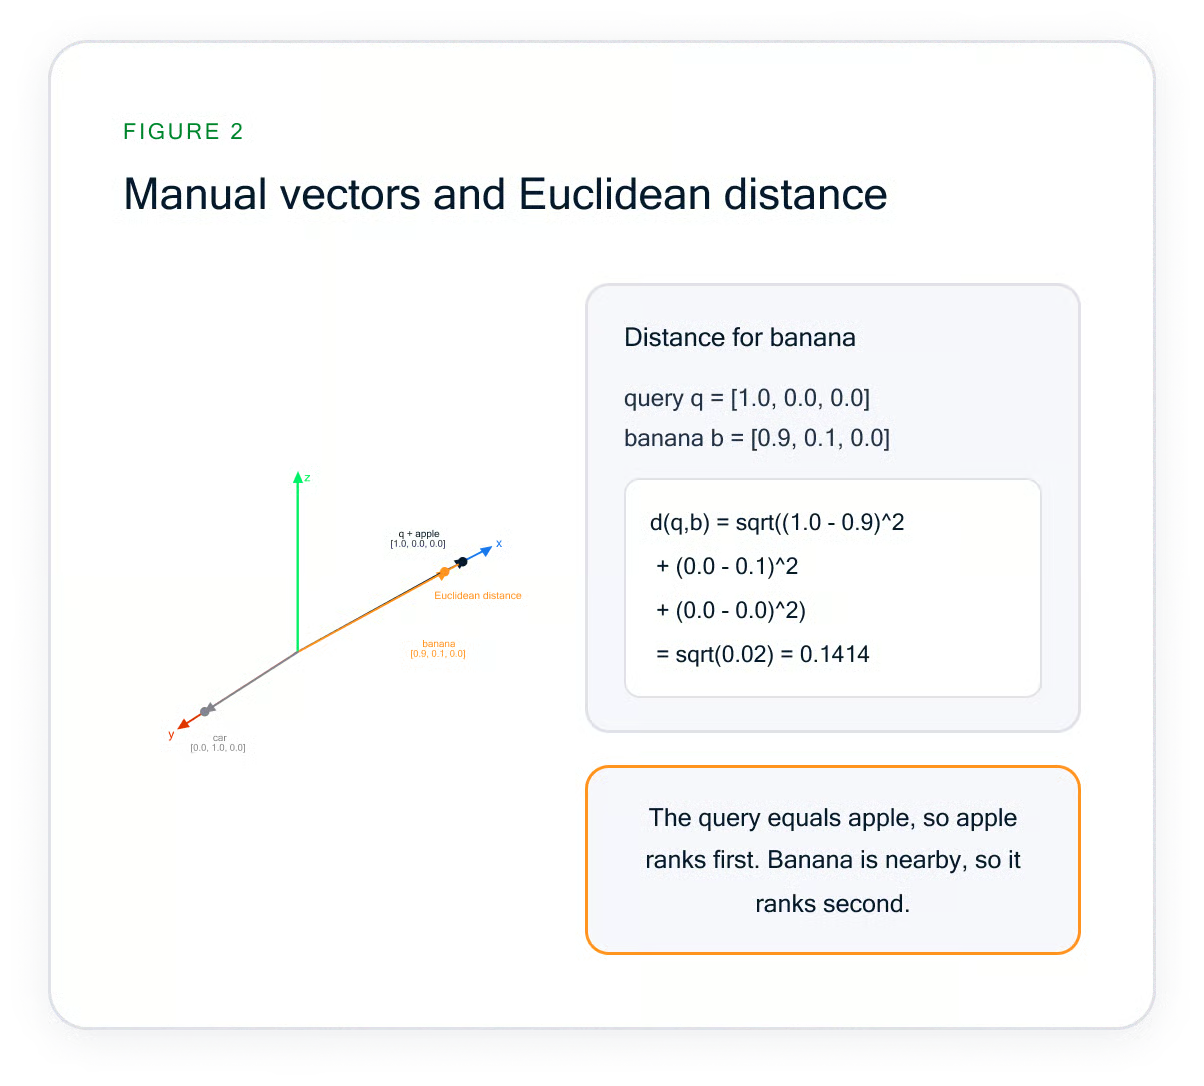
Vektor tiga dimensi apple, banana, dan car menampilkan jarak Euclidean dari vektor kueri apple.

Gambar 2. Vektor manual dan jarak Euclidean.

Contoh manual menggunakan jarak Euclidean. Vektor apple memiliki jarak 0,0000 karena cocok dengan vektor kueri. Vektor banana berada di peringkat kedua karena sqrt((1.0 - 0.9)^2 + (0.0 - 0.1)^2 + (0.0 - 0.0)^2) = 0.1414.

Buat skrip

Simpan kode berikut sebagai 02_manual_vectors.py.

import array
 import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Define three small vectors so the distance calculation is easy to inspect.
 	rows = [
         ("apple", array.array("f", [1.0, 0.0, 0.0])),
         ("banana", array.array("f", [0.9, 0.1, 0.0])),
         ("car", array.array("f", [0.0, 1.0, 0.0])),
 	]

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Recreate the table so the script can be run repeatedly.
             cursor.execute(
                 """
                 BEGIN
                 	EXECUTE IMMEDIATE 'DROP TABLE manual_vectors PURGE';
                 EXCEPTION
                 	WHEN OTHERS THEN
                     	IF SQLCODE <> -942 THEN
                         	RAISE;
                     	END IF;
                 END;
                 """
             )
             cursor.execute(
                 """
                 CREATE TABLE manual_vectors (
                 	id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
                 	label VARCHAR2(100),
                 	embedding VECTOR(3, FLOAT32)
                 )
                 """
             )
             # Bind each vector as a 32-bit floating-point array.
             cursor.executemany(
                 """
                 INSERT INTO manual_vectors (label, embedding)
                 VALUES (:1, :2)
                 """,
                 rows,
             )
             connection.commit()

             # Rank rows by Euclidean distance from the query vector.
             cursor.execute(
                 """
                 SELECT label,
                    	VECTOR_DISTANCE(
                        	embedding,
                        	:query_vector,
                        	EUCLIDEAN
                    	) AS distance
                 FROM manual_vectors
                 ORDER BY distance
                 FETCH EXACT FIRST 2 ROWS ONLY
                 """,
                 query_vector=array.array("f", [1.0, 0.0, 0.0]),
             )

             print("Created manual_vectors.")
             print("Inserted 3 manual vectors.")
             print("\nNearest manual vectors:")
             for rank, (label, distance) in enumerate(cursor, start=1):
                 print(f"{rank}. {label:<6} distance={float(distance):.4f}")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan skrip vektor manual.

python 02_manual_vectors.py

Keluaran yang diharapkan

Vektor yang identik muncul pertama dengan jarak 0,0000, dan vektor banana yang berdekatan muncul kedua.

Created manual_vectors.
 Inserted 3 manual vectors.

 Nearest manual vectors:
 1. apple  distance=0.0000
 2. banana distance=0.1414

Inilah ide inti dari pencarian vektor: baris diberi peringkat berdasarkan kedekatan matematis ke vektor kueri. Model embedding akan menghasilkan vektor yang lebih besar, tetapi perilaku basis data tetap sama.

Langkah 3: Buat tabel dokumen semantik

Sekarang setelah kita tahu vektor berfungsi, kita akan membuat tabel bergaya aplikasi yang nyata. Detail pentingnya adalah bahwa dimensi kolom vektor harus sesuai dengan dimensi keluaran model embedding.

Dimensi adalah bagian dari kontrak tabel. Jika sebuah model embedding mengembalikan 1.536 angka, kolom harus dideklarasikan sebagai VECTOR(1536, FLOAT32). 

Jika nanti kita beralih ke model dengan panjang keluaran berbeda, kita perlu membuat ulang atau memigrasikan kolom vektor agar insert dan kueri tetap menggunakan vektor yang kompatibel.

Karena DDL tidak dapat mengikat dimensi vektor sebagai bind variable SQL biasa, skrip mengonversi EMBEDDING_DIM menjadi integer sebelum menggunakannya dalam pernyataan CREATE TABLE.

Buat skrip

Simpan kode berikut sebagai 03_create_documents_table.py.

import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         dimension = int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc

 	if dimension <= 0:
         raise SystemExit("EMBEDDING_DIM must be a positive integer.")

 	return dimension


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Validate the configured model name and vector dimension.
     model_name = required_env("EMBEDDING_MODEL")
     dimension = configured_dimension()

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Recreate the documents table so the script is repeatable.
             cursor.execute(
                 """
                 BEGIN
                 	EXECUTE IMMEDIATE 'DROP TABLE documents PURGE';
                 EXCEPTION
                 	WHEN OTHERS THEN
                     	IF SQLCODE <> -942 THEN
                         	RAISE;
                     	END IF;
                 END;
                 """
             )
             cursor.execute(
                 f"""
                 CREATE TABLE documents (
                 	id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
                 	title VARCHAR2(200) NOT NULL,
                 	content VARCHAR2(1000) NOT NULL,
                 	embedding VECTOR({dimension}, FLOAT32)
                 )
                 """
             )

     print(f"Embedding model: {model_name}")
     print(f"Embedding dimension: {dimension}")
     print("Recreated documents table.")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan skrip pembuatan tabel.

python 03_create_documents_table.py

Keluaran yang diharapkan

Keluaran harus menampilkan model embedding dan dimensi vektor yang dikonfigurasi.

Embedding model: text-embedding-3-small
 Embedding dimension: 1536
 Recreated documents table.

Kita telah menyelesaikan bagian khusus basis data. Oracle Database dapat menyimpan dan membandingkan vektor secara lokal; selanjutnya, kita akan mengganti vektor buatan tangan dengan embedding yang dihasilkan dari teks.

Langkah 4: Verifikasi dimensi model embedding

Sebelum kita menyisipkan embedding, kita akan meminta satu vektor dari model embedding dan memverifikasi panjangnya. Ini mencegah kesalahan tabel vektor yang paling umum: menyisipkan vektor yang panjangnya tidak sesuai dengan dimensi kolom VECTOR.

Model embedding bukan sekadar konverter teks-ke-angka; model mendefinisikan ruang makna untuk aplikasi. Semua embedding dokumen dan kueri dalam demo ini harus berasal dari model yang sama.

Menggunakan satu model memastikan bahwa jarak kecil merepresentasikan kemiripan makna, bukan dua vektor tak terkait yang kebetulan memiliki bentuk mirip. Model juga menentukan panjang vektor, itulah sebabnya kita memeriksa dimensi yang dikembalikan sebelum memuat data.

Buat skrip

Simpan kode berikut sebagai 04_check_embedding_dimension.py.

import os

 from openai import OpenAI


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         return int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc


 def main():
     required_env("OPENAI_API_KEY")

     model_name = required_env("EMBEDDING_MODEL")
     expected_dimension = configured_dimension()

 	# Request one embedding to confirm the model output dimension.
 	client = OpenAI()
     response = client.embeddings.create(
         model=model_name,
         input="Oracle AI Vector Search dimension check",
 	)

     returned_dimension = len(response.data[0].embedding)

     print(f"Embedding model: {model_name}")
     print(f"Returned embedding length: {returned_dimension}")
     print(f"Configured EMBEDDING_DIM: {expected_dimension}")

 	# Stop before loading data if the table dimension is incompatible.
 	if returned_dimension != expected_dimension:
         raise SystemExit(
             "Dimension check failed. Update EMBEDDING_DIM, rerun "
             "03_create_documents_table.py, and try again."
     	)

     print("Dimension check passed.")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan pemeriksaan dimensi.

python 04_check_embedding_dimension.py

Keluaran yang diharapkan

Untuk model dan dimensi default, keluaran harus terlihat seperti ini.

Embedding model: text-embedding-3-small
 Returned embedding length: 1536
 Configured EMBEDDING_DIM: 1536
 Dimension check passed.

Jika nanti kita memilih model embedding yang berbeda, kita harus memperbarui EMBEDDING_MODEL, mengatur EMBEDDING_DIM ke panjang vektor yang dikembalikan, dan membuat ulang tabel documents.

Langkah 5: Hasilkan dan sisipkan embedding dokumen

Sekarang kita akan menghasilkan embedding untuk dataset kecil yang berdiri sendiri dan menyisipkannya ke Oracle Database. 

Setiap embedding dikonversi ke array.array("f", embedding) sebelum di-bind agar sesuai dengan kolom vektor FLOAT32.

Buat skrip

Simpan kode berikut sebagai 05_insert_embeddings.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 DOCUMENTS = [
 	(
         "Oracle AI Vector Search",
         "Oracle Database can store vector embeddings in native VECTOR "
         "columns and query them with SQL similarity search.",
 	),
 	(
         "Semantic Search for Applications",
         "Semantic search ranks results by meaning, helping applications "
         "find related content even when exact words differ.",
 	),
 	(
         "Vector Index Workflow",
         "Vector indexes help approximate nearest-neighbor search scale "
         "when datasets grow beyond small examples.",
 	),
 	(
         "Local Docker Development",
         "Docker containers make it practical to run a local database for "
         "development and repeatable tutorials.",
 	),
 	(
         "Python Database Code",
         "Python applications can connect to Oracle Database with the "
         "oracledb driver and use environment variables for credentials.",
 	),
 	(
         "Acoustic Guitar Practice",
         "Daily guitar practice improves timing, chord transitions, and "
         "confidence when learning new songs.",
 	),
 	(
         "Weeknight Vegetable Soup",
         "A simple soup can combine onions, carrots, beans, herbs, and "
         "broth for an easy weeknight meal.",
 	),
 ]

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         return int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")
     model_name = required_env("EMBEDDING_MODEL")
     expected_dimension = configured_dimension()

 	# Generate embeddings for all sample documents in one API request.
 	client = OpenAI()
     response = client.embeddings.create(
         model=model_name,
         input=[content for _, content in DOCUMENTS],
 	)

 	# Restore the response order using each item's index.
     embeddings = [
         item.embedding
     	for item in sorted(
             response.data,
             key=lambda item: item.index,
     	)
 	]

 	if any(len(embedding) != expected_dimension for embedding in embeddings):
         raise SystemExit(
             "An embedding length did not match EMBEDDING_DIM. "
             "Rerun 04_check_embedding_dimension.py."
     	)

 	# Bind each embedding as a 32-bit floating-point array.
 	rows = [
         (title, content, array.array("f", embedding))
     	for (title, content), embedding in zip(DOCUMENTS, embeddings)
 	]

 	# Replace the sample rows and commit the transaction.
 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             cursor.execute("DELETE FROM documents")
             cursor.executemany(
                 """
                 INSERT INTO documents (title, content, embedding)
                 VALUES (:1, :2, :3)
                 """,
                 rows,
             )
             cursor.execute("SELECT COUNT(*) FROM documents")
             row_count = cursor.fetchone()[0]
             connection.commit()

     print(f"Embedding model: {model_name}")
     print(f"Generated embeddings for {len(DOCUMENTS)} documents.")
     print(f"Inserted {len(DOCUMENTS)} documents.")
     print(f"documents row count: {row_count}")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan skrip insert.

python 05_insert_embeddings.py

Keluaran yang diharapkan

Jumlah baris harus sesuai dengan tujuh documents inline.

Embedding model: text-embedding-3-small
 Generated embeddings for 7 documents.
 Inserted 7 documents.
 documents row count: 7

Sekarang kita memiliki teks dan embedding yang disimpan bersama di Oracle Database. documents yang tidak terkait tentang gitar dan sup disertakan, sehingga hasil pencarian memiliki kecocokan yang jelas dekat dan jauh.

Langkah 6: Jalankan kueri pencarian semantik

Selanjutnya, kita akan melakukan embedding kueri bahasa alami dan membandingkannya dengan embedding dokumen yang disimpan. Skrip ini menggunakan jarak kosinus, yang umum digunakan untuk embedding teks karena berfokus pada arah vektor, bukan magnitudo mentah.

Untuk pencarian semantik, kueri melalui model embedding yang sama seperti documents. Kita tidak meminta SQL untuk memahami kalimat bahasa Inggris secara langsung. 

Kita meminta model embedding untuk mengubah kalimat menjadi vektor, lalu meminta Oracle Database memberi peringkat vektor yang disimpan berdasarkan jaraknya dari vektor kueri tersebut.

Buat skrip

Simpan kode berikut sebagai 06_semantic_search.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 QUERY_TEXT = "Where should an AI app keep meaning-based search data?"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate an embedding for the natural-language query.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=QUERY_TEXT,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Rank stored documents by cosine distance from the query vector.
             cursor.execute(
                 """
                 SELECT title,
                    	content,
                    	VECTOR_DISTANCE(
                        	embedding,
                        	:query_vector,
                        	COSINE
                    	) AS distance
                 FROM documents
                 ORDER BY distance
                 FETCH EXACT FIRST 5 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             rows = cursor.fetchall()

 	if not rows:
         raise SystemExit("No documents found. Run 05_insert_embeddings.py first.")

     print(f"Query: {QUERY_TEXT}")
     print("\nTop 5 results:")

 	for rank, (title, content, distance) in enumerate(rows, start=1):
         print(f"{rank}. {title}")
         print(f"   distance: {float(distance):.6f}")
         print(f"   {content[:90]}...")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan skrip pencarian semantik.

python 06_semantic_search.py

Keluaran yang diharapkan

Peringkat dan jarak yang persis dapat bervariasi ketika model embedding berubah. Namun, documents tentang Oracle AI Vector Search, pencarian semantik, kode basis data Python, dan pengindeksan vektor seharusnya berada di peringkat teratas.

Query: Where should an AI app keep meaning-based search data?

 Top 5 results:
 1. Oracle AI Vector Search
    distance: <cosine distance from your run>
    Oracle Database can store vector embeddings in native VECTOR columns and query them with SQL...

 2. Semantic Search for Applications
    distance: <cosine distance from your run>
    Semantic search ranks results by meaning, helping applications find related content even when...

 3. Python Database Code
    distance: <cosine distance from your run>
    Python applications can connect to Oracle Database with the oracledb driver and use environment...

 4. Vector Index Workflow
    distance: <cosine distance from your run>
    Vector indexes help approximate nearest-neighbor search scale when datasets grow beyond small...

 5. Local Docker Development
    distance: <cosine distance from your run>
    Docker containers make it practical to run a local database for development and repeatable...

Untuk kueri jarak Euclidean dan kosinus dalam tutorial ini, nilai yang lebih kecil menunjukkan kecocokan yang lebih dekat. 

Dot product adalah pendekatan perbandingan vektor lain yang berguna dalam banyak alur kerja pencarian vektor, terutama saat magnitudo atau vektor ternormalisasi penting, tetapi arah skor dan normalisasi perlu ditangani dengan hati-hati. 

Kita akan mempertahankan kode yang dapat dijalankan pada jarak Euclidean dan kosinus agar interpretasi hasil tetap sederhana.

Jika kita menormalisasi embedding sendiri dalam aplikasi mendatang, kita perlu menormalisasi embedding dokumen yang disimpan dan embedding kueri secara konsisten; jika tidak, jarak dan peringkat dapat berubah.

Langkah 7: Bandingkan pencarian semantik dengan pencocokan frasa

Pencarian semantik berguna karena tidak mengharuskan frasa yang persis sama muncul di dokumen.

Mari bandingkan kueri semantik dengan predikat frasa persis yang sederhana.

Ini bukan demo mesin pencari full-text; ini adalah perbandingan SQL kecil yang membuat perbedaan antara pencocokan literal dan peringkat berbasis makna menjadi terlihat.

Buat skrip

Simpan kode berikut sebagai 07_semantic_vs_keyword.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 SEMANTIC_QUERY = "Where should an AI app keep meaning-based search data?"
 KEYWORD_PHRASE = "meaning-based search data"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate an embedding for the semantic query.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=SEMANTIC_QUERY,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Rank documents by semantic similarity.
             cursor.execute(
                 """
                 SELECT title,
                        VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FROM documents
                 ORDER BY VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FETCH EXACT FIRST 3 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             semantic_rows = cursor.fetchall()

             # Compare semantic results with an exact phrase predicate.
             cursor.execute(
                 """
                 SELECT title
                 FROM documents
                 WHERE LOWER(title || ' ' || content)
                   	LIKE '%' || :phrase || '%'
                 ORDER BY title
                 FETCH FIRST 3 ROWS ONLY
                 """,
                 phrase=KEYWORD_PHRASE.lower(),
             )
             keyword_rows = cursor.fetchall()

     print(f"Semantic query: {SEMANTIC_QUERY}")
     print(f"Keyword phrase: {KEYWORD_PHRASE}")

     print("\nSemantic results:")
 	for rank, (title, distance) in enumerate(semantic_rows, start=1):
         print(f"{rank}. {title}")
         print(f"   distance: {float(distance):.6f}")

     print("\nKeyword results:")
 	if keyword_rows:
     	for rank, (title,) in enumerate(keyword_rows, start=1):
             print(f"{rank}. {title}")
 	else:
         print("0 exact phrase matches")


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan skrip perbandingan.

python 07_semantic_vs_keyword.py

Keluaran yang diharapkan

Pencarian semantik seharusnya mengembalikan documents yang relevan meskipun frasa kata kunci yang persis tidak ada.

Semantic query: Where should an AI app keep meaning-based search data?
 Keyword phrase: meaning-based search data

 Semantic results:
 1. Oracle AI Vector Search
    distance: <cosine distance from your run>
 2. Semantic Search for Applications
    distance: <cosine distance from your run>
 3. Python Database Code
    distance: <cosine distance from your run>

 Keyword results:
 0 exact phrase matches

Predikat SQL tradisional tetap penting untuk filter, join, perizinan, dan pencocokan eksak. Pencarian vektor menambahkan sinyal peringkat berbasis makna yang dapat kita gabungkan dengan data relasional saat aplikasi memerlukan pengambilan semantik.

Langkah 8: Tambahkan dan validasi indeks vektor

Terakhir, kita akan membuat indeks vektor dan memvalidasi bahwa Oracle Database melaporkannya sebagai indeks valid yang dimiliki oleh skema demo. 

Langkah ini mendemonstrasikan alur pembuatan indeks; dataset kecil kita tidak cukup besar untuk menghasilkan kesimpulan performa yang bermakna.

Tanpa indeks, Oracle Database dapat membandingkan vektor kueri dengan setiap vektor yang disimpan secara eksak. Pendekatan itu cocok untuk dataset kecil dan berguna saat belajar.

Dengan dataset yang lebih besar, indeks vektor perkiraan mengurangi ruang pencarian sehingga kueri dapat kembali dengan cepat sambil tetap menemukan tetangga yang dekat. 

Pilih keluarga indeks setelah mempertimbangkan ukuran data, target latensi, kebutuhan recall, anggaran memori, dan seberapa sering vektor berubah.

Kueri pada akhir langkah menegaskan bahwa pencarian semantik masih mengembalikan hasil setelah pembuatan indeks. 

Kita tidak akan menggunakan EXPLAIN PLAN atau DBMS_XPLAN di sini karena tutorial ini memvalidasi pembuatan indeks dengan metadata skema, bukan perilaku rencana kueri.

Buat skrip

Simpan kode berikut sebagai 08_create_vector_index.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 INDEX_NAME = "DOCUMENT_EMBEDDING_IDX"
 QUERY_TEXT = "Where should an AI app keep meaning-based search data?"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate the query vector used for the validation search.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=QUERY_TEXT,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Remove a prior index so the script can be rerun safely.
             try:
                 cursor.execute(f"DROP INDEX {INDEX_NAME}")
             except oracledb.DatabaseError as exc:
                 error = exc.args[0]
                 if error.code != 1418:
                 	raise

             # Create an approximate neighbor-partitions vector index.
             cursor.execute(
                 """
                 CREATE VECTOR INDEX document_embedding_idx
                 ON documents (embedding)
                 ORGANIZATION NEIGHBOR PARTITIONS
                 DISTANCE COSINE
                 WITH TARGET ACCURACY 95
                 """
             )

             # Confirm that Oracle reports the vector index as valid.
             cursor.execute(
                 """
                 SELECT index_name, index_type, status
                 FROM user_indexes
                 WHERE index_name = :index_name
                 """,
                 index_name=INDEX_NAME,
             )
             index_row = cursor.fetchone()

             # Confirm that semantic search still returns rows after index creation.
             cursor.execute(
                 """
                 SELECT title
                 FROM documents
                 ORDER BY VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FETCH EXACT FIRST 3 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             rows = cursor.fetchall()

 	if not index_row:
         raise SystemExit("Vector index was not found in USER_INDEXES.")

     print("Created vector index DOCUMENT_EMBEDDING_IDX.")
     print("\nIndex validation:")
     print(f"Index name: {index_row[0]}")
     print(f"Index type: {index_row[1]}")
     print(f"Status: {index_row[2]}")
     result_count = len(rows)

 	print(
         "\nSemantic search still returns "
         f"{result_count} results after index creation."
 	)


 if __name__ == "__main__":
 	main()

Jalankan skrip

Jalankan skrip indeks.

python 08_create_vector_index.py

Keluaran yang diharapkan

Keluaran harus menyertakan satu baris untuk DOCUMENT_EMBEDDING_IDX, dengan INDEX_TYPE disetel ke VECTOR dan STATUS disetel ke VALID.

Created vector index DOCUMENT_EMBEDDING_IDX.

 Index validation:
 Index name: DOCUMENT_EMBEDDING_IDX
 Index type: VECTOR
 Status: VALID

 Semantic search still returns 3 results after index creation.

USER_INDEXES menegaskan bahwa indeks ada dan valid. Ini tidak membuktikan bahwa kueri tertentu menggunakan indeks tersebut, dan tutorial ini tidak menggunakan keluaran rencana eksekusi sebagai metode validasi. 

Untuk beban kerja produksi, kita akan menguji dengan volume data yang realistis, pola kueri, dan target performa.

Tips dan Pemecahan Masalah Oracle AI Vector Search

Container basis data masih melakukan startup

Tunggu hingga startup selesai, lalu jalankan docker logs oracle-free-26ai-vector lagi. Basis data harus siap sebelum Python dapat terhubung ke localhost:1521/FREEPDB1.

Port 1521 sudah digunakan

Hentikan layanan lokal yang berbenturan atau ubah pemetaan port Docker. Perbarui DB_DSN jika port host berubah.

Koneksi basis data gagal

Verifikasi DB_USER, DB_PASSWORD, dan DB_DSN. Gunakan FREEPDB1 dalam DSN, dan jalankan skrip aplikasi sebagai vector_demo, bukan SYS, SYSTEM, atau PDBADMIN.

Kunci API embedding tidak ada

Langkah 1–3 hanya untuk basis data. Langkah 4–8 memerlukan OPENAI_API_KEY dan dapat menimbulkan biaya API.

Dimensi vektor tidak cocok

Jalankan 04_check_embedding_dimension.py, perbarui EMBEDDING_DIM, jalankan ulang 03_create_documents_table.py, dan muat ulang embedding dengan 05_insert_embeddings.py.

Bind vektor gagal

Pastikan setiap bind vektor FLOAT32 menggunakan array.array("f", values). Tutorial menggunakan format ini untuk vektor manual, embedding dokumen yang disimpan, dan embedding kueri.

Peringkat semantik berbeda dari contoh

Ini diharapkan. Penyedia embedding dapat memperbarui model, dan jarak floating-point dapat bervariasi antar-run.

Pembuatan indeks vektor gagal

Pastikan tabel documents ada, skema vector_demo memilikinya, dan DOCUMENT_EMBEDDING_IDX tidak tersisa dari run yang sebelumnya belum selesai.

Mempersiapkan produksi

Gunakan oracledb.create_pool() untuk pooling koneksi, lakukan benchmark dengan volume data realistis, tinjau keamanan dan pengelolaan rahasia, serta lakukan penalaan indeks terhadap pola kueri nyata.

Hentikan dan hapus container

Setelah tutorial selesai, hentikan dan hapus container lokal.

docker stop oracle-free-26ai-vector
docker rm oracle-free-26ai-vector

Kesimpulan

Kita membangun alur kerja pencarian semantik lokal dengan Oracle AI Vector Search, Oracle Database Free 26ai, dan Python. 

Kita mulai dengan nilai VECTOR(3, FLOAT32) buatan tangan, menyisipkan embedding yang dihasilkan model dengan array.array("f", values), mengueri documents serupa dengan VECTOR_DISTANCE(), membandingkan pengambilan semantik dengan predikat frasa persis sederhana, dan memvalidasi indeks vektor melalui USER_INDEXES.

Pendekatan ini cocok ketika embedding perlu berada di samping data relasional dan kita menginginkan penyimpanan serta pencarian yang terlihat oleh SQL tanpa menambahkan basis data vektor terpisah untuk alur kerja lokal. 

Demo ini sengaja kecil: ia mengajarkan primitifnya, bukan skala produksi. Aplikasi yang lebih besar seharusnya melakukan benchmark dengan data realistis, meninjau keamanan dan hak istimewa, menggunakan pooling koneksi, dan memvalidasi pilihan pengindeksan di bawah pola kueri nyata.

Selanjutnya, kita dapat memperdalam implementasi dengan sumber daya ini:

FAQs

Apa itu Oracle AI Vector Search?

Oracle AI Vector Search adalah sekumpulan kapabilitas Oracle Database untuk menyimpan, mengindeks, dan mengueri embedding vektor berdampingan dengan data relasional.

Apakah saya memerlukan kunci API OpenAI untuk menyelesaikan tutorial?

Langkah vektor manual dan penyiapan basis data tidak memerlukan kunci API. Langkah 4–8 memerlukan penyedia embedding dan OPENAI_API_KEY yang dikonfigurasi.

Mengapa EMBEDDING_DIM harus cocok dengan model embedding?

Dimensi kolom VECTOR harus sama dengan jumlah nilai yang dikembalikan oleh model embedding. Ketidaksesuaian menyebabkan penyisipan vektor gagal.

Metrik jarak apa yang digunakan tutorial?

Contoh vektor manual menggunakan jarak Euclidean. Contoh pencarian semantik menggunakan jarak kosinus.

Apakah indeks vektor yang valid membuktikan bahwa kueri menggunakan indeks tersebut?

Tidak. USER_INDEXES menegaskan bahwa indeks ada dan berstatus valid, tetapi tidak menegaskan bahwa kueri tertentu menggunakannya.


Mark Nelson's photo
Author
Mark Nelson
LinkedIn

Mark Nelson adalah arsitek dan developer evangelist di Oracle. Ia bekerja pada persinggungan AI, microservices, dan teknologi basis data. Ia adalah blogger aktif, penulis yang telah menerbitkan karya, peninjau teknis di Manning Publications, Section Leader di Stanford Code in Place, dan mentor di DeepLearning.ai. Ia secara rutin menjadi pembicara di Java dan Oracle User Group, komunitas AI, dan konferensi besar. Ia memiliki passion untuk belajar dan mengajar. Ia memiliki pengalaman industri lebih dari tiga puluh tahun, di IBM dan Oracle.

Topik
Kecerdasan Buatan
Python

Kursus Teratas DataCamp

Kursus

Pengantar Oracle SQL

4 jam
18.5K
Asah keterampilan Anda dalam Oracle SQL, termasuk dasar-dasar SQL, pengelompokan data, penggabungan data, dan penyesuaian data.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

Lihat SelengkapnyaLihat Selengkapnya
