Last chance! 50% off DataCamp Premium
Sale ends in
इस ट्यूटोरियल में, हम Oracle AI Vector Search, Python, और Oracle Database Free 26ai के साथ एक लोकल सेमांटिक सर्च डेमो बनाएंगे।
हम हस्तलिखित त्रि-आयामी वेक्टर से शुरू करेंगे ताकि दूरी की गणना दिखाई दे, फिर टेक्स्ट एम्बेडिंग जनरेट करेंगे और उन्हें Oracle Database से SQL के माध्यम से क्वेरी करेंगे।
यह ट्यूटोरियल उन Python और SQL डेवलपर्स के लिए है जो वेक्टर सर्च में नए हैं और Docker, environment variables, Python पैकेजों, तथा लोकल डेटाबेस सेटअप के साथ सहज हैं।
AI-संचालित एप्लिकेशंस को ऐसे सर्च की जरूरत होती है जो सिर्फ सटीक शब्दों को नहीं, बल्कि अर्थ को समझे। एक सपोर्ट ऐप, डॉक्युमेंटेशन पोर्टल, या आंतरिक नॉलेज टूल को “AI सर्च के लिए डेटाबेस स्टोरेज” तब भी ढूंढ पाना चाहिए जब सर्वोत्तम मेल खाने वाले दस्तावेज़ में “native कॉलम में वेक्टर एम्बेडिंग स्टोर करें” लिखा हो।
Vector embeddings यह संभव बनाते हैं, क्योंकि वे टेक्स्ट को न्यूमेरिक वेक्टर के रूप में दर्शाते हैं। Oracle AI Vector Search हमें उन वेक्टरों को सीधे Oracle Database में स्टोर करने, SQL से क्वेरी करने, और एम्बेडिंग को रिलेशनल एप्लिकेशन डेटा के साथ रखने देता है।
इस लोकल वर्कफ़्लो के लिए हमें अलग वेक्टर डेटाबेस की आवश्यकता नहीं है।
हम Oracle Database Free 26ai को लोकल चलाएँगे, Python से oracledb Thin मोड में कनेक्ट करेंगे, पहले मैनुअल वेक्टर स्टोर करेंगे, फिर OpenAI एम्बेडिंग स्टोर करेंगे, सेमांटिक सर्च चलाएँगे, सेमांटिक रिट्रीवल की तुलना साधारण exact phrase प्रेडिकेट से करेंगे, और USER_INDEXES के माध्यम से वैलिडेट किया गया वेक्टर इंडेक्स बनाएँगे।
अंत तक, हमारे पास एक कार्यशील Python-संचालित सेमांटिक सर्च वर्कफ़्लो होगा जो Oracle Database में एम्बेडिंग स्टोर करता है और लोकल रूप से सबसे मिलते-जुलते documents प्राप्त करता है।
Oracle AI Vector Search, Oracle Database की ऐसी क्षमताओं का सेट है, जो वेक्टर एम्बेडिंग को स्टोर, इंडेक्स और क्वेरी करने के लिए हैं। एक वेक्टर एम्बेडिंग संख्याओं की एक स्थिर-आकार सूची होती है जो टेक्स्ट, इमेज या अन्य डेटा के अर्थ को उस रूप में दर्शाती है जिसे कोई डेटाबेस गणितीय रूप से तुलना कर सकता है।
एम्बेडिंग मॉडल ये न्यूमेरिक वेक्टर बनाता है। यह इनपुट के रूप में वाक्य, अनुच्छेद, इमेज का वर्णन, या कोड स्निपेट लेता है और एक निश्चित आयाम वाले वेक्टर को लौटाता है।
मिलते-जुलते इनपुट्स को ऐसे वेक्टर पैदा करने चाहिए जो एक-दूसरे के करीब हों, जबकि असंबंधित इनपुट्स अधिक दूर हों। इसलिए हमें स्टोर किए गए documents और आने वाली क्वेरी के लिए एक ही एम्बेडिंग मॉडल का उपयोग करना चाहिए, क्योंकि दूरी केवल तब मायने रखती है जब वेक्टर एक ही कोऑर्डिनेट सिस्टम साझा करते हैं।
इस ट्यूटोरियल में, मैनुअल वेक्टर जानबूझकर छोटे हैं ताकि हम गणित का निरीक्षण कर सकें। असल टेक्स्ट एम्बेडिंग बहुत बड़े होते हैं क्योंकि मॉडल को शब्दों, वाक्यांशों और विषयों के बीच सूक्ष्म संबंधों को एन्कोड करने के लिए पर्याप्त आयामों की आवश्यकता होती है।
वेक्टर सर्च वेक्टरों के बीच दूरी के आधार पर पंक्तियों को रैंक करता है। Euclidean और cosine दूरी क्वेरी में छोटी दूरी का मान करीब मेल का संकेत देता है। इस ट्यूटोरियल में, हम एक छोटे VECTOR(3, FLOAT32) कॉलम से शुरू करेंगे ताकि हम सीधे दूरी का व्यवहार देख सकें, फिर टेक्स्ट से जनरेट किए गए VECTOR(1536, FLOAT32) एम्बेडिंग पर जाएँगे।
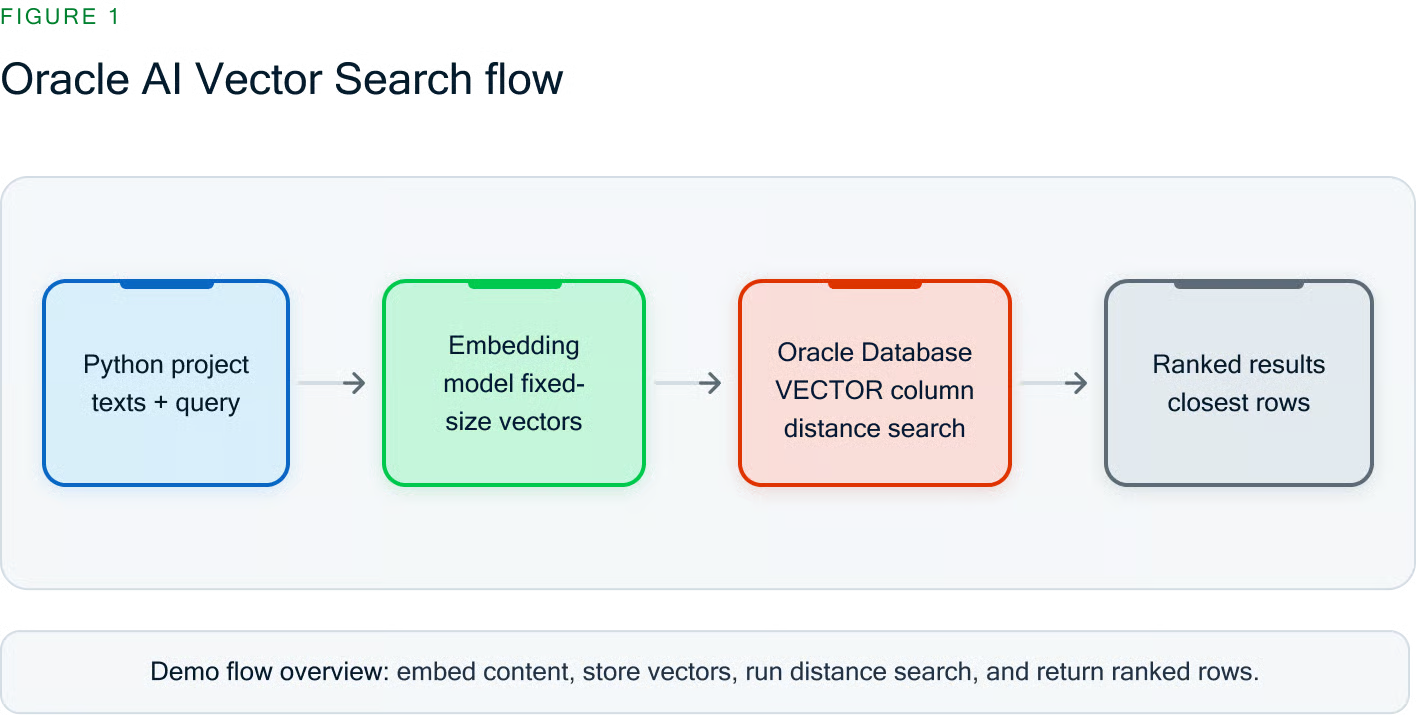
चित्र 1. Oracle AI Vector Search फ्लो
Oracle AI Vector Search एम्बेडिंग को एक native VECTOR कॉलम में स्टोर करता है और परिणामों को वेक्टर दूरी के आधार पर रैंक करता है।
Oracle Database तब उपयोगी होता है जब एम्बेडिंग रिलेशनल एप्लिकेशन डेटा—जैसे डॉक्युमेंट ID, शीर्षक, सामग्री, उपयोगकर्ता, प्रोडक्ट्स, टिकट, या मेटाडेटा—के साथ रहने चाहिए।
कुछ एप्लिकेशन विशेष रिट्रीवल वर्कलोड्स के लिए अलग वेक्टर डेटाबेस या सर्च इंजन का उपयोग करते हैं, लेकिन इस ट्यूटोरियल के लोकल सेमांटिक सर्च वर्कफ़्लो के लिए, Oracle Database वेक्टर स्टोरेज और सर्च फीचर्स प्रदान करता है जिनकी हमें आवश्यकता है।
हम डेमो में Oracle AI Vector Search की चार विशेषताओं का उपयोग करेंगे: native वेक्टर स्टोरेज, दूरी फंक्शंस, वेक्टर इंडेक्स, और रिलेशनल इंटीग्रेशन।
Oracle Database native VECTOR कॉलम सपोर्ट करता है जिनके आयाम और एलिमेंट फॉर्मैट स्पष्ट रूप से परिभाषित होते हैं। डेमो में, हम मैनुअल वेक्टर के लिए VECTOR(3, FLOAT32) और डिफ़ॉल्ट text-embedding-3-small एम्बेडिंग मॉडल के लिए VECTOR(1536, FLOAT32) का उपयोग करेंगे।
रन किए जा सकने वाले उदाहरणों में हम VECTOR_DISTANCE() का उपयोग करते हैं क्योंकि यह SQL में दूरी मैट्रिक को स्पष्ट रखता है।
हम मैनुअल वेक्टर उदाहरण के लिए Euclidean दूरी और टेक्स्ट एम्बेडिंग के लिए cosine दूरी का उपयोग करेंगे।
Oracle Database में शॉर्टहैंड वेक्टर दूरी ऑपरेटर्स और dot-product संबंधित दूरी व्यवहार भी शामिल हैं, लेकिन यह ट्यूटोरियल रन करने योग्य SQL को स्पष्ट VECTOR_DISTANCE() पथ पर रखता है।
अलग-अलग दूरी मैट्रिक्स “कितना नज़दीक” है, इस बारे में कुछ भिन्न प्रश्नों का उत्तर देते हैं।
छोटे ट्यूटोरियल के लिए, cosine दूरी टेक्स्ट एम्बेडिंग के लिए अच्छा डिफ़ॉल्ट है क्योंकि यह दिशा पर ध्यान देता है, जो अक्सर सेमांटिक समानता से अच्छी तरह मेल खाती है।
Euclidean दूरी मैनुअल वेक्टर के साथ विज़ुअलाइज़ करना आसान है, और कुछ रिट्रीवल सिस्टम में dot-product शैली की तुलना तब उपयोगी होती है जब वेक्टर मैग्निट्यूड या normalized वेक्टर मॉडल डिज़ाइन का हिस्सा हों।
|
मैट्रिक |
यह क्या तुलना करता है |
उपयुक्त उपयोग |
ध्यान रखने योग्य बातें |
|
Cosine |
वेक्टर की दिशा |
टेक्स्ट एम्बेडिंग और सेमांटिक समानता |
परिणाम एक ही एम्बेडिंग मॉडल और सुसंगत प्रीप्रोसेसिंग पर निर्भर करते हैं |
|
Euclidean |
सीधी रेखा की दूरी |
छोटे उदाहरण, ज्यामिति अंतर्दृष्टि, कुछ न्यूमेरिक फीचर वेक्टर |
मैग्निट्यूड दूरी को प्रभावित करता है, इसलिए स्केलिंग मायने रख सकती है |
|
Dot product |
दिशा और मैग्निट्यूड साथ में |
normalized वेक्टर या inner-product स्कोरिंग पर आधारित वर्कफ़्लोज़ |
स्कोर दिशा और normalization नियम समझने के बाद ही परिणामों की तुलना करें |
सटीक वेक्टर सर्च शुद्धता और छोटे डेटासेट के लिए उपयोगी है। जैसे-जैसे डेटासेट बढ़ते हैं, वेक्टर इंडेक्स approximate nearest-neighbor सर्च वर्कफ़्लो को सपोर्ट करते हैं।
Oracle AI Vector Search में इन-मेमोरी neighbor graph इंडेक्स (अक्सर HNSW-शैली सर्च से जुड़े) और neighbor-partitions इंडेक्स (अक्सर IVF-शैली पार्टिशनिंग से जुड़े) शामिल हैं।
इस लोकल डेमो में, हम ORGANIZATION NEIGHBOR PARTITIONS का उपयोग करते हैं और USER_INDEXES से इंडेक्स को वैलिडेट करते हैं।
Approximate इंडेक्स exhaustive-search की थोड़ी सी निश्चितता को स्केल पर तेज रिट्रीवल के लिए ट्रेड करते हैं।
सही इंडेक्स फैमिली वर्कलोड, डेटा वॉल्यूम, अपडेट पैटर्न, और रिकॉल लक्ष्य पर निर्भर करती है।
यह ट्यूटोरियल IVF-शैली neighbor-partitions इंडेक्स का उपयोग करता है क्योंकि यह लोकल सेटअप को सरल रखता है और इंडेक्स-ट्यूनिंग गाइड बनाए बिना एक ठोस इंडेक्स-क्रिएशन स्टेप प्रदान करता है।
|
इंडेक्स फैमिली |
मूल विचार |
ताकत |
ट्रेडऑफ |
कब उपयोग करें |
|
IVF / neighbor partitions |
वेक्टर स्पेस को पार्टिशन करें, फिर संभावित पार्टिशन खोजें |
सिंपल मेंटल मॉडल, कई बैच-लोडेड डेटासेट के लिए व्यावहारिक |
रिकॉल और स्पीड पार्टिशनिंग और सर्च सेटिंग्स पर निर्भर |
हम बढ़ते डेटासेट के लिए एक सीधा approximate-search पथ चाहते हैं |
|
HNSW / neighbor graph |
तेज़ traversal के लिए पास-पास वेक्टरों को लिंक करने वाला ग्राफ बनाएँ |
कई nearest-neighbor वर्कलोड्स के लिए मजबूत रिकॉल और लेटेंसी प्रोफ़ाइल |
अधिक मेमोरी-ओरिएंटेड, और कॉन्फ़िगरेशन अधिक मायने रख सकता है |
हमें कम-लेटेंसी सर्च चाहिए और हम मेमोरी व ट्यूनिंग प्रयास का बजट कर सकते हैं |
एक वेक्टर कॉलम साधारण रिलेशनल कॉलम के साथ रह सकता है। हमारी documents टेबल शीर्षक, सामग्री, और एम्बेडिंग को साथ में स्टोर करेगी, ताकि SQL समानता स्कोर और मूल दस्तावेज़ टेक्स्ट—दोनों लौटा सके।
हम एक लोकल सेटअप पथ का उपयोग करेंगे: Docker में Oracle Database Free 26ai, FREEPDB1 सर्विस, और एक समर्पित vector_demo एप्लिकेशन यूज़र।
वेक्टर-सर्च की अवधारणाएँ सुलभ हैं, लेकिन सेटअप मध्यम-स्तरीय है क्योंकि हम Docker, डेटाबेस स्कीमा, Python पैकेज, environment variables, और एक एम्बेडिंग API कुंजी का उपयोग करते हैं।
हमें आवश्यकता होगी:
इस डेमो के लिए ऐसे Oracle Database संस्करण या वातावरण की जरूरत है जिसमें यहाँ उपयोग की गई वेक्टर विशेषताएँ शामिल हों, जैसे native VECTOR कॉलम, VECTOR_DISTANCE(), और CREATE VECTOR INDEX।
लोकल पथ Oracle Database Free 26ai का उपयोग करता है, नीचे दिखाए गए इमेज टैग के साथ, और DSN FREEPDB1 pluggable डेटाबेस सर्विस का उपयोग करता है।
मैनुअल वेक्टर स्टेप्स के लिए OpenAI API कुंजी की आवश्यकता नहीं है। सेमांटिक स्टेप्स सैंपल दस्तावेज़ टेक्स्ट और क्वेरी टेक्स्ट को कॉन्फ़िगर किए गए एम्बेडिंग प्रोवाइडर को भेजते हैं, इसलिए हम केवल सैंपल या गैर-संवेदनशील टेक्स्ट का उपयोग करेंगे।
यह ट्यूटोरियल oracledb का उपयोग करता है, जो Oracle Database के लिए वर्तमान Python ड्राइवर है। python-oracledb डिफ़ॉल्ट रूप से Thin मोड में चलता है, इसलिए इस लोकल डेमो के लिए Oracle Client लाइब्रेरीज़ की आवश्यकता नहीं है। Thick मोड अन्य Oracle Database डिप्लॉयमेंट्स में उपयोगी है, लेकिन हम यहाँ oracledb.init_oracle_client() कॉल नहीं करेंगे।
उन स्क्रिप्ट्स के लिए एक प्रोजेक्ट डायरेक्टरी बनाएँ जिन्हें हम तैयार करेंगे।
लोकल कंटेनर इमेज के साथ Oracle Database Free 26ai शुरू करें।
कंटेनर लॉग्स जाँचें और तब तक प्रतीक्षा करें जब तक डेटाबेस स्टार्टअप पूरा होने की रिपोर्ट न दे।
FREEPDB1 इस लोकल Oracle Database Free कंटेनर पथ द्वारा उपयोग की जाने वाली pluggable डेटाबेस सर्विस है। हमारा Python DSN localhost:1521/FREEPDB1 होगा।
स्कीमा सेटअप स्टेप के लिए केवल SYS का उपयोग करें। sqlplus कमांड में पासवर्ड docker run कमांड के ORACLE_PWD मान के बराबर है; CREATE USER में पासवर्ड वह एप्लिकेशन पासवर्ड है जिसे हम DB_PASSWORD के रूप में export करेंगे।
सेटअप को डेटाबेस कंटेनर के अंदर चलाएँ।
यह डेमो कंटेनर के लिए लोकल डेवलपमेंट शॉर्टकट है। CREATE SEQUENCE की आवश्यकता इसलिए है क्योंकि टेबल्स identity कॉलम का उपयोग करती हैं।
प्रोडक्शन के लिए, हम किसी डेटाबेस एडमिनिस्ट्रेटर के साथ प्रिविलेज की समीक्षा करेंगे और सटीक एप्लिकेशन वर्कलोड के लिए न्यूनतम आवश्यक विशेषाधिकार लागू करेंगे।
एक वर्चुअल एनवायरनमेंट बनाएँ और सक्रिय करें।
डेमो में उपयोग होने वाले Python पैकेज इंस्टॉल करें।
डेटाबेस क्रेडेंशियल्स और एम्बेडिंग सेटिंग्स को Python फाइलों में हार्ड-कोड करने के बजाय environment variables में स्टोर करें।
OPENAI_API_KEY केवल एम्बेडिंग और सेमांटिक सर्च स्टेप्स के लिए आवश्यक है। EMBEDDING_DIM का मान चयनित एम्बेडिंग मॉडल द्वारा लौटाए गए आयामों की संख्या से मेल खाना चाहिए।
हम डेमो को आठ चेकपॉइंट्स में बनाएँगे। प्रत्येक स्क्रिप्ट एक कॉन्सेप्ट जोड़ती है और आगे बढ़ने से पहले सत्यापित करने योग्य आउटपुट देती है।
डेटाबेस-ओनली चेकपॉइंट स्टेप 1–3 के बाद पूरा होता है। उस समय तक, हम Oracle Database से कनेक्ट हो चुके होंगे, मैनुअल वेक्टर स्टोर कर चुके होंगे, उन्हें दूरी के आधार पर क्वेरी कर चुके होंगे, और सेमांटिक टेबल बना चुके होंगे। OpenAI API कुंजी स्टेप 4 में आवश्यक हो जाती है।
पहले, हम सत्यापित करेंगे कि Python vector_demo एप्लिकेशन यूज़र के रूप में Oracle Database से कनेक्ट कर सकता है। यह स्क्रिप्ट environment से DB_USER, DB_PASSWORD, और DB_DSN पढ़ती है और ड्राइवर मोड तथा डेटाबेस संस्करण प्रिंट करती है।
निम्नलिखित कोड को 01_check_connection.py नाम से सेव करें।
कनेक्शन चेक चलाएँ।
आउटपुट यह पुष्टि करना चाहिए कि कनेक्शन काम कर रहा है और ड्राइवर Thin मोड में है।
अब हमें पता है कि लोकल डेटाबेस, सर्विस नाम, क्रेडेंशियल्स, और Python ड्राइवर वेक्टर टेबल बनाने से पहले ही काम कर रहे हैं।
एम्बेडिंग मॉडल्स से पहले, चलिए तीन छोटे वेक्टर स्टोर करते हैं जिन पर हम तर्क कर सकें। array.array("f", values) कॉल एक 32-बिट फ्लोटिंग-पॉइंट एरे बनाता है जिसे python-oracledb VECTOR(..., FLOAT32) कॉलम में बाइंड कर सकता है।
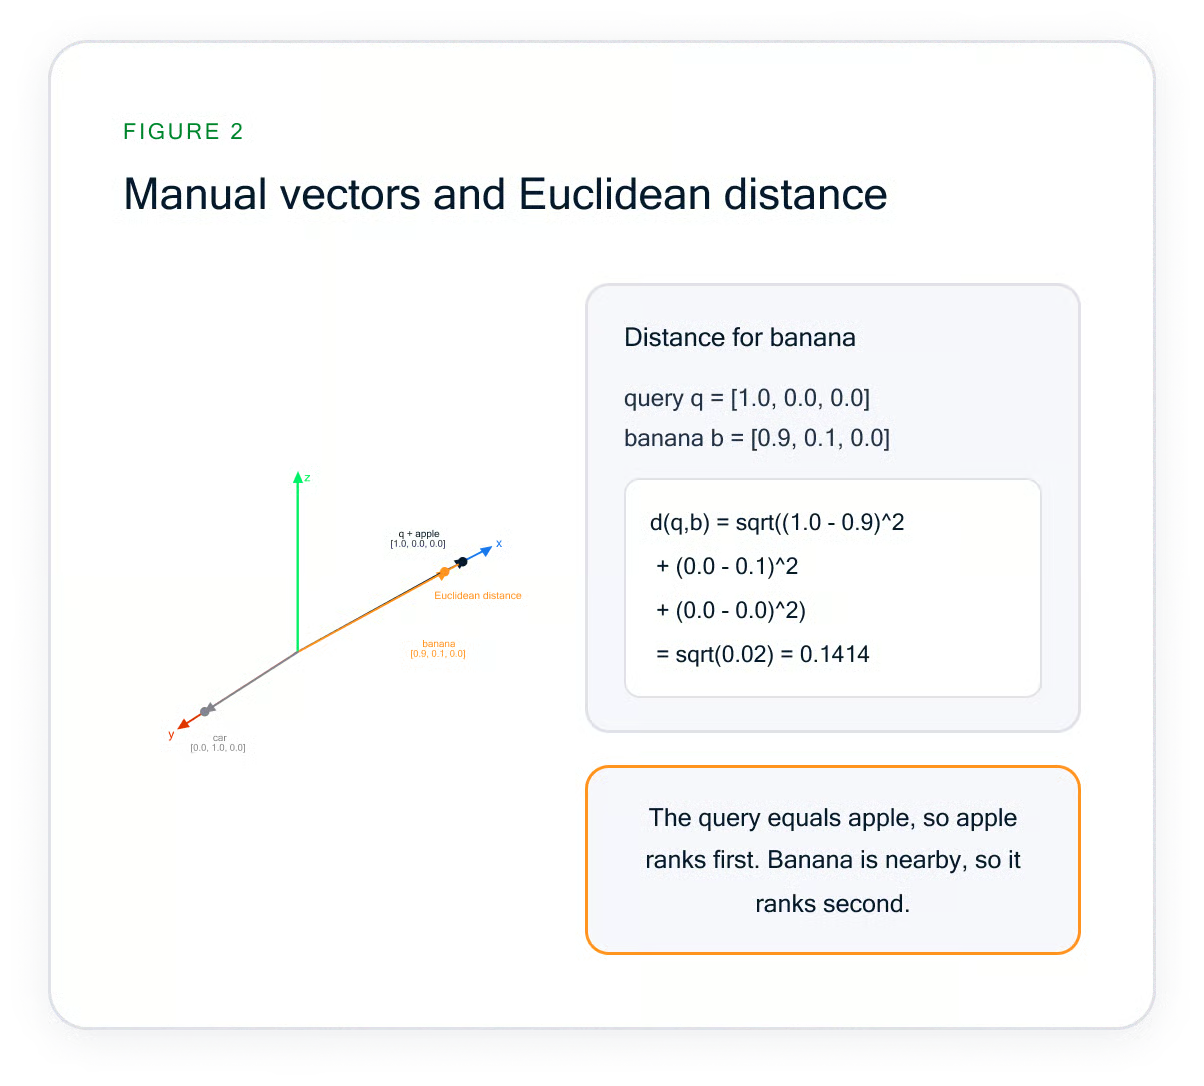
चित्र 2. मैनुअल वेक्टर और Euclidean दूरी।
मैनुअल उदाहरण Euclidean दूरी का उपयोग करता है। apple वेक्टर की दूरी 0.0000 है क्योंकि यह क्वेरी वेक्टर से मेल खाता है। banana वेक्टर दूसरे स्थान पर आता है क्योंकि sqrt((1.0 - 0.9)^2 + (0.0 - 0.1)^2 + (0.0 - 0.0)^2) = 0.1414।
निम्नलिखित कोड को 02_manual_vectors.py नाम से सेव करें।
मैनुअल वेक्टर स्क्रिप्ट चलाएँ।
समान वेक्टर 0.0000 दूरी के साथ पहले दिखाई देगा, और पास का banana वेक्टर दूसरे स्थान पर।
यह वेक्टर सर्च के पीछे का मूल विचार है: पंक्तियों को क्वेरी वेक्टर से गणितीय निकटता के आधार पर रैंक किया जाता है। एम्बेडिंग मॉडल बड़े वेक्टर जनरेट करेंगे, लेकिन डेटाबेस का व्यवहार वही रहेगा।
अब जब हमें पता है कि वेक्टर काम करते हैं, हम एक वास्तविक एप्लिकेशन-शैली की टेबल बनाएँगे। महत्वपूर्ण बात यह है कि वेक्टर कॉलम का आयाम एम्बेडिंग मॉडल के आउटपुट आयाम से मेल खाना चाहिए।
आयाम टेबल कॉन्ट्रैक्ट का हिस्सा है। यदि कोई एम्बेडिंग मॉडल 1,536 संख्याएँ लौटाता है, तो कॉलम को VECTOR(1536, FLOAT32) के रूप में घोषित होना चाहिए।
यदि हम बाद में किसी ऐसे मॉडल पर स्विच करते हैं जिसका आउटपुट लंबाई अलग है, तो हमें वेक्टर कॉलम को फिर से बनाना या माइग्रेट करना होगा ताकि इन्सर्ट और क्वेरियाँ अनुकूल वेक्टरों का उपयोग जारी रखें।
क्योंकि DDL वेक्टर आयाम को एक नियमित SQL बाइंड वेरियेबल के रूप में बाइंड नहीं कर सकता, स्क्रिप्ट CREATE TABLE स्टेटमेंट में उपयोग करने से पहले EMBEDDING_DIM को पूर्णांक में बदलती है।
निम्नलिखित कोड को 03_create_documents_table.py नाम से सेव करें।
टेबल बनाने की स्क्रिप्ट चलाएँ।
आउटपुट में कॉन्फ़िगर किया गया एम्बेडिंग मॉडल और वेक्टर आयाम दिखना चाहिए।
हमने डेटाबेस-ओनली हिस्सा पूरा कर लिया है। Oracle Database लोकल रूप से वेक्टर स्टोर और तुलना कर सकता है; अब, हम हस्तलिखित वेक्टरों को टेक्स्ट से जनरेट की गई एम्बेडिंग से बदलेंगे।
एम्बेडिंग इन्सर्ट करने से पहले, हम एम्बेडिंग मॉडल से एक वेक्टर माँगेंगे और उसकी लंबाई सत्यापित करेंगे। यह वेक्टर-टेबल की सबसे सामान्य त्रुटि को रोकता है: ऐसा वेक्टर इन्सर्ट करना जिसकी लंबाई VECTOR कॉलम आयाम से मेल नहीं खाती।
एम्बेडिंग मॉडल सिर्फ टेक्स्ट-टू-नंबर कन्वर्टर नहीं है; यह एप्लिकेशन के लिए अर्थ-स्थान (meaning space) परिभाषित करता है। इस डेमो में सभी दस्तावेज़ और क्वेरी एम्बेडिंग एक ही मॉडल से आने चाहिए।
एक ही मॉडल का उपयोग यह सुनिश्चित करता है कि छोटी दूरी समान अर्थ का प्रतिनिधित्व करती है, न कि दो असंबंधित वेक्टर जो संयोग से समान आकार रखते हों। मॉडल वेक्टर की लंबाई भी निर्धारित करता है, इसलिए हम डेटा लोड करने से पहले लौटाए गए आयाम की जाँच करते हैं।
निम्नलिखित कोड को 04_check_embedding_dimension.py नाम से सेव करें।
डायमेंशन चेक चलाएँ।
डिफ़ॉल्ट मॉडल और आयाम के लिए, आउटपुट इस तरह दिखना चाहिए।
यदि हम बाद में कोई अलग एम्बेडिंग मॉडल चुनते हैं, तो हमें EMBEDDING_MODEL अपडेट करना चाहिए, EMBEDDING_DIM को लौटाई गई वेक्टर लंबाई पर सेट करना चाहिए, और documents टेबल को फिर से बनाना चाहिए।
अब हम एक छोटे, स्व-निहित डेटासेट के लिए एम्बेडिंग जनरेट करेंगे और उन्हें Oracle Database में इन्सर्ट करेंगे।
प्रत्येक एम्बेडिंग को बाइंड करने से पहले array.array("f", embedding) में कन्वर्ट किया जाता है ताकि वह FLOAT32 वेक्टर कॉलम से मेल खाए।
निम्नलिखित कोड को 05_insert_embeddings.py नाम से सेव करें।
इन्सर्ट स्क्रिप्ट चलाएँ।
रो काउंट इनलाइन दिए गए सात documents से मेल खाना चाहिए।
अब हमारे पास Oracle Database में साथ-साथ स्टोर किया गया टेक्स्ट और एम्बेडिंग हैं। गिटार और सूप के असंबंधित documents शामिल किए गए हैं, ताकि सर्च परिणामों में स्पष्ट नज़दीकी और दूर के मेल दिखाई दें।
अगले चरण में, हम एक प्राकृतिक भाषा की क्वेरी को एम्बेड करेंगे और उसे स्टोर की गई दस्तावेज़ एम्बेडिंग से तुलना करेंगे। यह स्क्रिप्ट cosine दूरी का उपयोग करती है, जो टेक्स्ट एम्बेडिंग के लिए आम है, क्योंकि यह वेक्टर की दिशा पर ध्यान देती है न कि कच्चे मैग्निट्यूड पर।
सेमांटिक सर्च के लिए, क्वेरी उसी एम्बेडिंग मॉडल से गुजरती है जिससे documents गुजरे थे। हम SQL से सीधे अंग्रेज़ी वाक्य को समझने के लिए नहीं कह रहे हैं।
हम एम्बेडिंग मॉडल से वाक्य को एक वेक्टर में बदलने के लिए कह रहे हैं, फिर Oracle Database से उस क्वेरी वेक्टर से दूरी के आधार पर स्टोर किए गए वेक्टरों को रैंक करने के लिए कह रहे हैं।
निम्नलिखित कोड को 06_semantic_search.py नाम से सेव करें।
सेमांटिक सर्च स्क्रिप्ट चलाएँ।
जब एम्बेडिंग मॉडल बदलता है, तो सटीक रैंकिंग और दूरी भिन्न हो सकती हैं। फिर भी, Oracle AI Vector Search, सेमांटिक सर्च, Python डेटाबेस कोड, और वेक्टर इंडेक्सिंग से संबंधित documents शीर्ष पर रैंक होने चाहिए।
इस ट्यूटोरियल में Euclidean और cosine दूरी क्वेरी के लिए, छोटा मान अधिक निकट मेल का संकेत देता है।
Dot product कई वेक्टर-सर्च वर्कफ़्लो में एक अन्य उपयोगी तुलना दृष्टिकोण है, खासकर जब मैग्निट्यूड या normalized वेक्टर मायने रखते हों, लेकिन स्कोर दिशा और normalization का सावधानी से प्रबंधन करना पड़ता है।
हम रन करने योग्य कोड को Euclidean और cosine दूरी पर ही रखेंगे ताकि परिणामों की व्याख्या सरल रहे।
यदि हम भविष्य के किसी एप्लिकेशन में एम्बेडिंग को खुद normalize करते हैं, तो हमें स्टोर की गई दस्तावेज़ एम्बेडिंग और क्वेरी एम्बेडिंग—दोनों—को समान रूप से normalize करना होगा; अन्यथा, दूरी और रैंकिंग बदल सकती है।
सेमांटिक सर्च उपयोगी है क्योंकि इसे दस्तावेज़ में वही सटीक वाक्यांश होने की आवश्यकता नहीं है।
चलिए सेमांटिक क्वेरी की तुलना एक साधारण exact phrase प्रेडिकेट से करते हैं।
यह कोई पूर्ण-टेक्स्ट सर्च इंजन डेमो नहीं है; यह एक छोटा SQL तुलना है जो शाब्दिक मिलान और अर्थ-आधारित रैंकिंग के बीच का अंतर स्पष्ट करता है।
निम्नलिखित कोड को 07_semantic_vs_keyword.py नाम से सेव करें।
तुलना स्क्रिप्ट चलाएँ।
सेमांटिक सर्च प्रासंगिक documents लौटाएगा भले ही सटीक कीवर्ड वाक्यांश मौजूद न हो।
परंपरागत SQL प्रेडिकेट्स अभी भी फ़िल्टर, जॉइन, परमिशन, और exact मैचिंग के लिए महत्वपूर्ण हैं। जब किसी एप्लिकेशन को सेमांटिक रिट्रीवल की आवश्यकता होती है, तो वेक्टर सर्च एक अर्थ-आधारित रैंकिंग सिग्नल जोड़ता है जिसे हम रिलेशनल डेटा के साथ संयोजित कर सकते हैं।
अंत में, हम एक वेक्टर इंडेक्स बनाएँगे और वैलिडेट करेंगे कि Oracle Database इसे डेमो स्कीमा के स्वामित्व वाले एक वैध इंडेक्स के रूप में रिपोर्ट करता है।
यह स्टेप इंडेक्स क्रिएशन वर्कफ़्लो का प्रदर्शन करता है; हमारा छोटा डेटासेट अर्थपूर्ण परफ़ॉर्मेंस निष्कर्षों के लिए पर्याप्त बड़ा नहीं है।
बिना इंडेक्स के, Oracle Database क्वेरी वेक्टर की प्रत्येक स्टोर वेक्टर से सटीक तुलना कर सकता है। यह तरीका छोटे डेटासेट के लिए उपयुक्त और सीखते समय उपयोगी है।
बड़े डेटासेट के साथ, approximate वेक्टर इंडेक्स सर्च स्पेस को कम कर देते हैं ताकि क्वेरी जल्दी लौटें और फिर भी नज़दीकी नेबर्स मिलें।
डेटा आकार, लेटेंसी लक्ष्य, रिकॉल आवश्यकताएँ, मेमोरी बजट, और वेक्टर कितनी बार बदलते हैं—इन पर विचार करने के बाद इंडेक्स फैमिली चुनें।
अंत में दी गई क्वेरी पुष्टि करती है कि इंडेक्स क्रिएशन के बाद भी सेमांटिक सर्च परिणाम लौटाता है।
हम यहाँ EXPLAIN PLAN या DBMS_XPLAN का उपयोग नहीं करेंगे क्योंकि यह ट्यूटोरियल क्वेरी-प्लान व्यवहार के बजाय स्कीमा मेटाडेटा से इंडेक्स क्रिएशन को वैलिडेट करता है।
निम्नलिखित कोड को 08_create_vector_index.py नाम से सेव करें।
इंडेक्स स्क्रिप्ट चलाएँ।
आउटपुट में DOCUMENT_EMBEDDING_IDX के लिए एक रो शामिल होना चाहिए, जिसमें INDEX_TYPE VECTOR और STATUS VALID पर सेट हो।
USER_INDEXES पुष्टि करता है कि इंडेक्स मौजूद है और वैध है। यह साबित नहीं करता कि किसी विशेष क्वेरी ने इंडेक्स का उपयोग किया था, और यह ट्यूटोरियल वैलिडेशन मेथड के रूप में execution-plan आउटपुट का उपयोग नहीं करता।
प्रोडक्शन वर्कलोड्स के लिए, हम यथार्थवादी डेटा वॉल्यूम, क्वेरी पैटर्न, और परफ़ॉर्मेंस लक्ष्यों के साथ परीक्षण करेंगे।
स्टार्टअप पूरा होने तक प्रतीक्षा करें, फिर docker logs oracle-free-26ai-vector फिर से चलाएँ। Python के localhost:1521/FREEPDB1 से कनेक्ट करने से पहले डेटाबेस तैयार होना चाहिए।
विवादित लोकल सर्विस को रोकें या Docker पोर्ट मैपिंग बदलें। यदि होस्ट पोर्ट बदलता है तो DB_DSN अपडेट करें।
DB_USER, DB_PASSWORD, और DB_DSN सत्यापित करें। DSN में FREEPDB1 का उपयोग करें, और एप्लिकेशन स्क्रिप्ट्स को vector_demo के रूप में कनेक्ट करें, SYS, SYSTEM, या PDBADMIN के रूप में नहीं।
स्टेप 1-3 केवल डेटाबेस के लिए हैं। स्टेप 4-8 के लिए OPENAI_API_KEY आवश्यक है और API लागत आ सकती है।
04_check_embedding_dimension.py चलाएँ, EMBEDDING_DIM अपडेट करें, 03_create_documents_table.py फिर से चलाएँ, और 05_insert_embeddings.py. से एम्बेडिंग दोबारा लोड करें।
सुनिश्चित करें कि हर FLOAT32 वेक्टर बाइंड array.array("f", values) का उपयोग करता है। ट्यूटोरियल मैनुअल वेक्टर, स्टोर की गई दस्तावेज़ एम्बेडिंग, और क्वेरी एम्बेडिंग—तीनों के लिए इसी फॉर्मैट का उपयोग करता है।
यह अपेक्षित है। एम्बेडिंग प्रोवाइडर्स मॉडल्स को अपडेट कर सकते हैं, और फ्लोटिंग-पॉइंट दूरियाँ रन के बीच बदल सकती हैं।
पुष्टि करें कि documents टेबल मौजूद है, vector_demo स्कीमा उसका मालिक है, और DOCUMENT_EMBEDDING_IDX किसी आंशिक रूप से पूर्ण रन से शेष नहीं है।
oracledb.create_pool() का उपयोग कनेक्शन पूलिंग के लिए करें, यथार्थवादी डेटा वॉल्यूम के साथ बेंचमार्क करें, सुरक्षा और सीक्रेट मैनेजमेंट की समीक्षा करें, और वास्तविक क्वेरी पैटर्न्स के अनुसार इंडेक्स ट्यून करें।
जब ट्यूटोरियल पूरा हो जाए, लोकल कंटेनर को रोकें और हटा दें।
हमने Oracle AI Vector Search, Oracle Database Free 26ai, और Python के साथ एक लोकल सेमांटिक सर्च वर्कफ़्लो बनाया।
हमने हस्तलिखित VECTOR(3, FLOAT32) मानों से शुरुआत की, array.array("f", values) के साथ मॉडल-जनित एम्बेडिंग इन्सर्ट कीं, VECTOR_DISTANCE() से मिलते-जुलते documents क्वेरी किए, सेमांटिक रिट्रीवल की तुलना साधारण exact phrase प्रेडिकेट से की, और USER_INDEXES के माध्यम से एक वेक्टर इंडेक्स वैलिडेट किया।
यह तरीका तब उपयुक्त है जब एम्बेडिंग रिलेशनल डेटा के साथ रहने चाहिए और हम लोकल वर्कफ़्लो के लिए अलग वेक्टर डेटाबेस जोड़े बिना SQL-विज़िबल स्टोरेज और सर्च चाहते हैं।
डेमो जानबूझकर छोटा रखा गया है: यह प्राइमिटिव्स सिखाता है, प्रोडक्शन स्केल नहीं। बड़े एप्लिकेशंस को यथार्थवादी डेटा के साथ बेंचमार्क करना चाहिए, सुरक्षा और प्रिविलेज की समीक्षा करनी चाहिए, कनेक्शन पूलिंग का उपयोग करना चाहिए, और वास्तविक क्वेरी पैटर्न्स के तहत इंडेक्सिंग विकल्पों को वैलिडेट करना चाहिए।
आगे, हम इन संसाधनों के साथ इम्प्लीमेंटेशन को गहरा कर सकते हैं:
शीर्ष DataCamp कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}