Ir al contenido principal

Tutorial de Oracle AI Vector Search: guarda y consulta embeddings con Python

Este tutorial presenta Oracle AI Vector Search, explica sus funciones clave y guía un proyecto práctico en local. También cubre requisitos de configuración, búsqueda semántica, indexación vectorial y resolución de problemas frecuente.
Actualizado 23 sept 2026  · 15 min leer

Explora con IA

ChatGPTClaudePerplexity

En este tutorial, crearemos una demo de búsqueda semántica en local con Oracle AI Vector Search, Python y Oracle Database Free 26ai. 

Empezaremos con vectores tridimensionales escritos a mano para que el cálculo de distancias sea visible, y después generaremos embeddings de texto y los consultaremos desde Oracle Database con SQL. 

Este tutorial está dirigido a desarrolladores de Python y SQL que se inician en la búsqueda vectorial y que se sienten cómodos con Docker, variables de entorno, paquetes de Python y configuración de bases de datos en local.

Las aplicaciones con IA necesitan una búsqueda que entienda el significado, no solo palabras exactas. Una app de soporte, un portal de documentación o una herramienta interna de conocimiento deberían encontrar «almacenamiento de base de datos para búsquedas de IA» aunque el documento que mejor encaja diga «almacena embeddings vectoriales en columnas nativas».

Los embeddings vectoriales lo hacen posible al representar el texto como vectores numéricos. Oracle AI Vector Search permite almacenar esos vectores directamente en Oracle Database, consultarlos con SQL y mantener los embeddings junto a los datos relacionales de la aplicación. 

Para este flujo de trabajo en local, no necesitamos una base de datos vectorial separada.

Ejecutaremos Oracle Database Free 26ai en local, conectaremos desde Python en modo Thin con oracledb, guardaremos primero vectores manuales, después embeddings de OpenAI, ejecutaremos una búsqueda semántica, compararemos la recuperación semántica con un predicado de frase exacta sencillo y crearemos un índice vectorial validado a través de USER_INDEXES.

Al finalizar, tendremos un flujo de búsqueda semántica funcionando con Python que guarda embeddings en Oracle Database y recupera los documents más similares en local.

¿Qué es Oracle AI Vector Search?

Oracle AI Vector Search es un conjunto de capacidades de Oracle Database para almacenar, indexar y consultar embeddings vectoriales. Un embedding vectorial es una lista de números de tamaño fijo que representa el significado de texto, imágenes u otros datos en una forma que una base de datos puede comparar matemáticamente.

Un modelo de embeddings crea los vectores numéricos. Toma entradas como una frase, un párrafo, la descripción de una imagen o un fragmento de código y devuelve un vector con un número fijo de dimensiones.

Entradas similares deberían producir vectores cercanos entre sí, mientras que entradas no relacionadas deberían quedar más alejadas. Por eso debemos usar el mismo modelo de embeddings para los documents almacenados y para las consultas entrantes: las distancias solo tienen sentido cuando los vectores comparten el mismo sistema de coordenadas.

En este tutorial, los vectores manuales son deliberadamente pequeños para poder inspeccionar las matemáticas. Los embeddings reales de texto son mucho mayores porque el modelo necesita suficientes dimensiones para codificar relaciones más sutiles entre palabras, frases y temas.

La búsqueda vectorial ordena filas por la distancia entre vectores. En consultas de distancia euclídea y coseno, los valores más pequeños indican coincidencias más cercanas. En este tutorial, empezaremos con una columna VECTOR(3, FLOAT32) para ver el comportamiento de la distancia directamente y, después, pasaremos a embeddings VECTOR(1536, FLOAT32) generados a partir de texto.
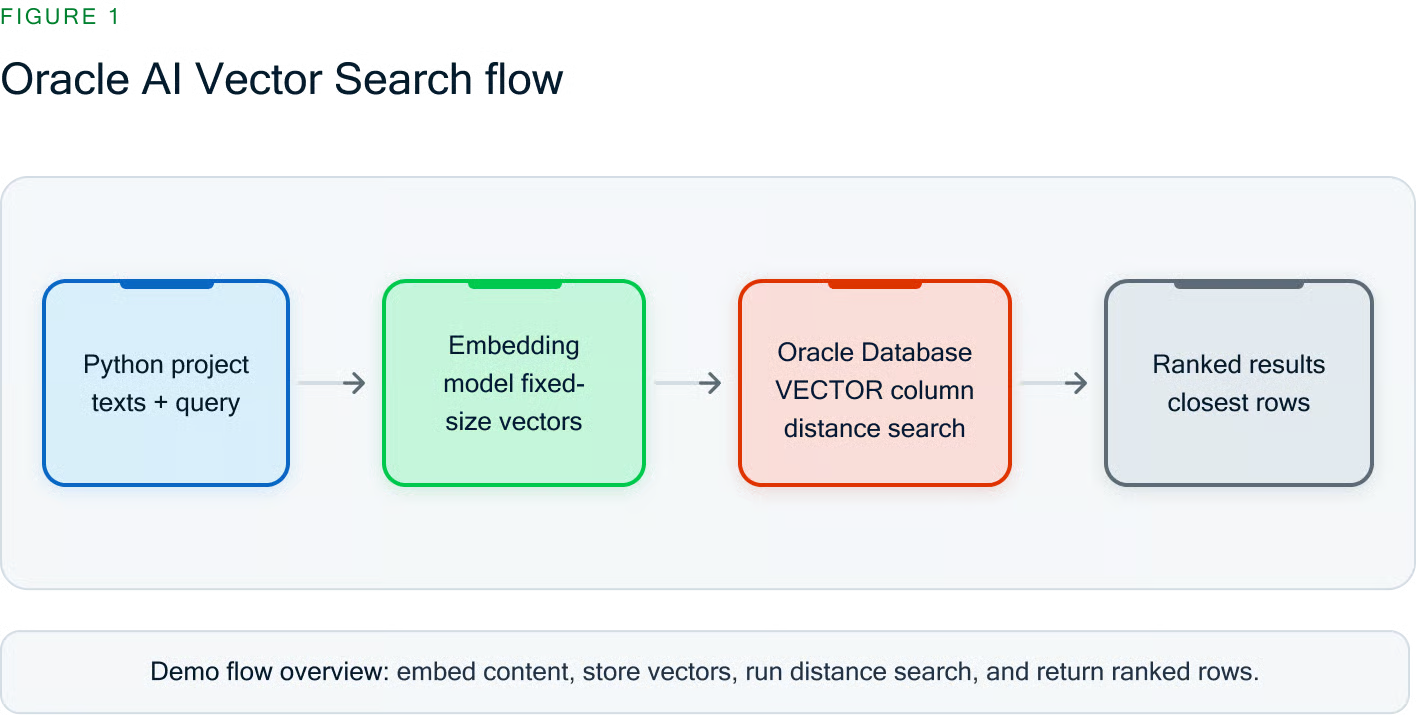
Flujo de Oracle AI Vector Search

Figura 1. Flujo de Oracle AI Vector Search

Oracle AI Vector Search guarda embeddings en una columna nativa VECTOR y clasifica resultados por distancia vectorial.

Oracle Database es útil cuando los embeddings deben convivir junto a datos relacionales de la aplicación como IDs de documentos, títulos, contenido, usuarios, productos, tickets o metadatos. 

Algunas aplicaciones usan una base de datos vectorial o motor de búsqueda aparte para cargas de trabajo especializadas de recuperación, pero para el flujo de búsqueda semántica en local de este tutorial, Oracle Database ofrece el almacenamiento y la búsqueda vectorial que necesitamos.

Funciones clave de Oracle AI Vector Search

Usaremos cuatro funciones de Oracle AI Vector Search en la demo: almacenamiento nativo de vectores, funciones de distancia, índices vectoriales e integración relacional.

Tipo de dato vectorial nativo

Oracle Database admite columnas nativas VECTOR con dimensiones explícitas y formatos de elemento. En la demo, usaremos VECTOR(3, FLOAT32) para los vectores manuales y VECTOR(1536, FLOAT32) para el modelo de embeddings por defecto text-embedding-3-small.

Funciones y operadores de distancia

Los ejemplos ejecutables usan VECTOR_DISTANCE() porque mantiene la métrica de distancia explícita en SQL. 

Usaremos la distancia euclídea para el ejemplo de vectores manuales y distancia coseno para embeddings de texto. 

Oracle Database también incluye operadores abreviados de distancia vectorial y comportamientos relacionados con el producto escalar, pero este tutorial mantiene el SQL ejecutable en la ruta explícita de VECTOR_DISTANCE().

Las distintas métricas de distancia responden a preguntas ligeramente diferentes sobre la «cercanía». 

Para un tutorial pequeño, la distancia coseno es una buena opción por defecto con embeddings de texto porque se centra en la dirección, que suele mapear bien la similitud semántica. 

La distancia euclídea es más fácil de visualizar con vectores escritos a mano, y las comparaciones de estilo producto escalar son útiles en algunos sistemas de recuperación cuando la magnitud del vector o la normalización forman parte del diseño del modelo.

Métrica

Qué compara

Buen encaje

Ten en cuenta

Coseno

Dirección del vector

Embeddings de texto y similitud semántica

Los resultados dependen de usar el mismo modelo de embeddings y un preprocesado consistente

Euclídea

Distancia en línea recta

Ejemplos pequeños, intuición geométrica, algunos vectores de características numéricas

La magnitud afecta a la distancia, así que el escalado puede importar

Producto escalar

Dirección y magnitud a la vez

Flujos diseñados con vectores normalizados o puntuación por producto interno

Hay que entender el signo de la puntuación y las reglas de normalización antes de comparar resultados

Índices vectoriales

La búsqueda vectorial exacta es útil para la corrección y para conjuntos pequeños. A medida que crece el volumen de datos, los índices vectoriales admiten flujos de trabajo de búsqueda aproximada de vecinos más próximos.

Oracle AI Vector Search incluye índices de grafo de vecinos en memoria (asociados a búsquedas tipo HNSW) e índices de particiones de vecinos (asociados a particionado tipo IVF). 

En esta demo local, usamos ORGANIZATION NEIGHBOR PARTITIONS y validamos el índice con USER_INDEXES.

Los índices aproximados intercambian una pequeña parte de certeza del exhaustivo por una recuperación más rápida a escala. 

La familia de índice adecuada depende de la carga de trabajo, el volumen de datos, el patrón de actualización y el objetivo de recall.

Este tutorial usa un índice de particiones de vecinos tipo IVF porque simplifica la configuración local y ofrece un paso concreto de creación de índice sin convertir el tutorial en una guía de tuning.

Familia de índice

Idea básica

Puntos fuertes

Contrapartidas

Cuándo usarlo

IVF / particiones de vecinos

Particionar el espacio vectorial y buscar en las particiones más probables

Modelo mental sencillo, práctico para muchos datasets cargados por lotes

El recall y la velocidad dependen del particionado y de la configuración de búsqueda

Queremos una ruta de búsqueda aproximada directa para un dataset en crecimiento

HNSW / grafo de vecinos

Construir un grafo que conecte vectores cercanos para un recorrido rápido

Buen perfil de recall y latencia para muchas cargas de vecinos más próximos

Más orientado a memoria y la configuración puede ser más determinante

Necesitamos baja latencia y podemos dedicar memoria y esfuerzo de ajuste

Integración con consultas relacionales

Una columna vectorial puede convivir junto a columnas relacionales normales. Nuestra tabla de documents guardará título, contenido y embedding juntos, de forma que SQL pueda devolver tanto la puntuación de similitud como el texto original del documento.

Cómo empezar con Oracle AI Vector Search

Usaremos una ruta de configuración local: Oracle Database Free 26ai en Docker, el servicio FREEPDB1 y un usuario de aplicación dedicado vector_demo. 

Los conceptos de búsqueda vectorial son asequibles, pero la configuración es intermedia porque usamos Docker, un esquema de base de datos, paquetes de Python, variables de entorno y una clave de API para embeddings.

Requisitos previos

Necesitaremos:

  • Docker Desktop o Docker Engine.
  • Acceso a Oracle Container Registry.
  • Puertos locales 1521 y 5500 disponibles.
  • Python 3.10 o superior.
  • Conocimientos básicos de Python y SQL.
  • Familiaridad básica con Docker y variables de entorno.
  • Una clave de API de OpenAI para los pasos de embeddings.

Esta demo requiere una versión o entorno de Oracle Database que incluya las funciones vectoriales usadas aquí, incluyendo columnas nativas VECTOR, VECTOR_DISTANCE() y CREATE VECTOR INDEX. 

La ruta local usa Oracle Database Free 26ai con la etiqueta de imagen mostrada abajo, y el DSN usa el servicio de base de datos enchufable FREEPDB1.

Los pasos de vectores manuales no requieren una clave de API de OpenAI. Los pasos semánticos envían el texto de documentos de ejemplo y el texto de consulta al proveedor de embeddings configurado, así que usaremos únicamente texto de muestra o no sensible.

Este tutorial usa oracledb, el controlador actual de Python para Oracle Database. python-oracledb se ejecuta en modo Thin por defecto, por lo que esta demo local no requiere las librerías de Oracle Client. El modo Thick es útil en otros despliegues de Oracle Database, pero aquí no llamaremos a oracledb.init_oracle_client().

Inicia Oracle Database Free 26ai en local

Crea un directorio de proyecto para los scripts que construiremos.

mkdir oracle-ai-vector-search-python
 cd oracle-ai-vector-search-python

Inicia Oracle Database Free 26ai con la imagen de contenedor local.

docker run --name oracle-free-26ai-vector \
   --detach \
   --publish 1521:1521 \
   --publish 5500:5500 \
   --shm-size=1g \
   --env ORACLE_PWD="replace-with-a-strong-password" \
   container-registry.oracle.com/database/free:23.26.1.0-lite-amd64

Consulta los logs del contenedor y espera hasta que la base de datos indique que el arranque ha finalizado.

docker logs oracle-free-26ai-vector

FREEPDB1 es el servicio de base de datos enchufable usado por esta ruta local con Oracle Database Free en contenedor. Nuestro DSN de Python será localhost:1521/FREEPDB1.

Crea el esquema vector_demo en FREEPDB1

Usa SYS solo para el paso de configuración del esquema. La contraseña en el comando sqlplus es el valor de ORACLE_PWD del comando docker run; la contraseña en CREATE USER es la contraseña de la aplicación que exportaremos como DB_PASSWORD.

Ejecuta la configuración dentro del contenedor de la base de datos.

# Crea el usuario de la aplicación y concédele los privilegios necesarios para la demo.
 docker exec -i oracle-free-26ai-vector \
   sqlplus -s 'sys/"replace-with-oracle-pwd"@FREEPDB1 as sysdba' <<'SQL'
 WHENEVER SQLERROR EXIT SQL.SQLCODE

 CREATE USER vector_demo IDENTIFIED BY "replace-with-vector-demo-password";

 GRANT CREATE SESSION, CREATE TABLE, CREATE SEQUENCE, UNLIMITED TABLESPACE TO vector_demo;

 EXIT
 SQL

Este es un atajo de desarrollo local para el contenedor de la demo. CREATE SEQUENCE es necesario porque las tablas usan columnas identidad. 

En producción, revisaríamos los privilegios con una persona administradora de base de datos y aplicaríamos mínimos privilegios según la carga real de la aplicación.

Instala las dependencias de Python

Crea y activa un entorno virtual.

python -m venv .venv
 source .venv/bin/activate
 python -m pip install --upgrade pip

Instala los paquetes de Python que usa la demo.

python -m pip install oracledb openai

Configura las variables de entorno

Guarda las credenciales de la base de datos y la configuración de embeddings en variables de entorno en lugar de fijarlas en los archivos Python.

export DB_USER="vector_demo"
 export DB_PASSWORD="replace-with-vector-demo-password"
 export DB_DSN="localhost:1521/FREEPDB1"
 export OPENAI_API_KEY="replace-with-your-api-key"
 export EMBEDDING_MODEL="text-embedding-3-small"
 export EMBEDDING_DIM="1536"

OPENAI_API_KEY solo es necesaria para los pasos de embeddings y búsqueda semántica. EMBEDDING_DIM debe coincidir con el número de dimensiones que devuelve el modelo de embeddings seleccionado.

Proyecto demo de Oracle AI Vector Search

Construiremos la demo en ocho checkpoints. Cada script añade un concepto y produce una salida que podemos verificar antes de avanzar.

La parte solo de base de datos se completa tras los pasos 1–3. En ese punto nos habremos conectado a Oracle Database, almacenado vectores manuales, consultado por distancia y creado la tabla semántica. La clave de API de OpenAI pasa a ser necesaria en el paso 4.

Paso 1: conecta con la base de datos local

Primero, verificaremos que Python puede conectarse a Oracle Database con el usuario de aplicación vector_demo. Este script lee DB_USER, DB_PASSWORD y DB_DSN del entorno e imprime el modo del driver y la versión de la base de datos.

Crea el script

Guarda el siguiente código como 01_check_connection.py.

import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	# Load required database settings from environment variables.
 	user = required_env("DB_USER")
     password = required_env("DB_PASSWORD")
 	dsn = required_env("DB_DSN")

 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Open a Thin-mode connection with the application user.
 	with oracledb.connect(user=user, password=password, dsn=dsn) as connection:
         mode = "thin" if oracledb.is_thin_mode() else "thick"
         print("Connected to Oracle Database.")
         print(f"Driver mode: {mode}")
         print(f"Database version: {connection.version}")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta la comprobación de conexión.

python 01_check_connection.py

Salida esperada

La salida debería confirmar que la conexión funciona y que el driver está en modo Thin.

Connected to Oracle Database.
 Driver mode: thin
 Database version: 23.26.1.0.0

Ahora sabemos que la base de datos local, el nombre del servicio, las credenciales y el driver de Python funcionan antes de crear tablas vectoriales.

Paso 2: desarrolla intuición con vectores manuales

Antes de introducir modelos de embeddings, guardemos tres vectores pequeños que podamos razonar. La llamada array.array("f", values) crea un array de punto flotante de 32 bits que python-oracledb puede enlazar en una columna VECTOR(..., FLOAT32).
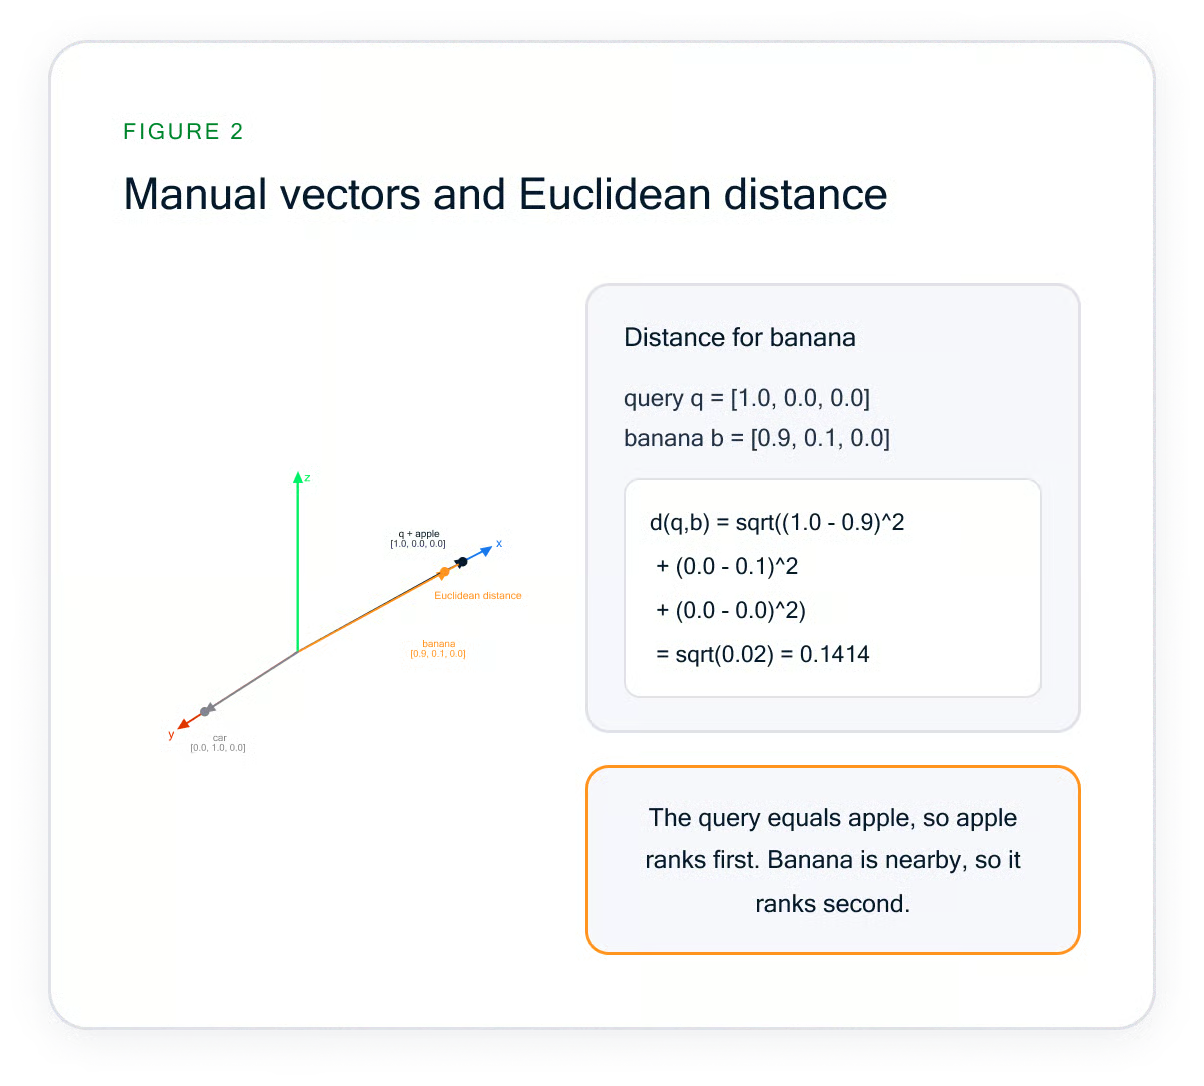
Vectores 3D de apple, banana y car mostrando la distancia euclídea desde el vector de consulta apple.

Figura 2. Vectores manuales y distancia euclídea.

El ejemplo manual usa distancia euclídea. El vector de apple tiene distancia 0,0000 porque coincide con el vector de consulta. El vector de banana queda segundo porque sqrt((1.0 - 0.9)^2 + (0.0 - 0.1)^2 + (0.0 - 0.0)^2) = 0,1414.

Crea el script

Guarda el siguiente código como 02_manual_vectors.py.

import array
 import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Define three small vectors so the distance calculation is easy to inspect.
 	rows = [
         ("apple", array.array("f", [1.0, 0.0, 0.0])),
         ("banana", array.array("f", [0.9, 0.1, 0.0])),
         ("car", array.array("f", [0.0, 1.0, 0.0])),
 	]

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Recreate the table so the script can be run repeatedly.
             cursor.execute(
                 """
                 BEGIN
                 	EXECUTE IMMEDIATE 'DROP TABLE manual_vectors PURGE';
                 EXCEPTION
                 	WHEN OTHERS THEN
                     	IF SQLCODE <> -942 THEN
                         	RAISE;
                     	END IF;
                 END;
                 """
             )
             cursor.execute(
                 """
                 CREATE TABLE manual_vectors (
                 	id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
                 	label VARCHAR2(100),
                 	embedding VECTOR(3, FLOAT32)
                 )
                 """
             )
             # Bind each vector as a 32-bit floating-point array.
             cursor.executemany(
                 """
                 INSERT INTO manual_vectors (label, embedding)
                 VALUES (:1, :2)
                 """,
                 rows,
             )
             connection.commit()

             # Rank rows by Euclidean distance from the query vector.
             cursor.execute(
                 """
                 SELECT label,
                    	VECTOR_DISTANCE(
                        	embedding,
                        	:query_vector,
                        	EUCLIDEAN
                    	) AS distance
                 FROM manual_vectors
                 ORDER BY distance
                 FETCH EXACT FIRST 2 ROWS ONLY
                 """,
                 query_vector=array.array("f", [1.0, 0.0, 0.0]),
             )

             print("Created manual_vectors.")
             print("Inserted 3 manual vectors.")
             print("\nNearest manual vectors:")
             for rank, (label, distance) in enumerate(cursor, start=1):
                 print(f"{rank}. {label:<6} distance={float(distance):.4f}")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta el script de vectores manuales.

python 02_manual_vectors.py

Salida esperada

El vector idéntico aparece primero con distancia 0,0000, y el vector de banana aparece segundo.

Created manual_vectors.
 Inserted 3 manual vectors.

 Nearest manual vectors:
 1. apple  distance=0.0000
 2. banana distance=0.1414

Esta es la idea central de la búsqueda vectorial: las filas se ordenan por cercanía matemática al vector de consulta. Los modelos de embeddings generarán vectores más grandes, pero el comportamiento en base de datos es el mismo.

Paso 3: crea la tabla de documentos semánticos

Ahora que sabemos que los vectores funcionan, crearemos una tabla con estilo de aplicación real. El detalle importante es que la dimensión de la columna vectorial debe coincidir con la dimensión de salida del modelo de embeddings.

La dimensión forma parte del contrato de la tabla. Si un modelo de embeddings devuelve 1.536 números, la columna debe declararse como VECTOR(1536, FLOAT32). 

Si más adelante cambiamos a un modelo con otra longitud de salida, tendremos que recrear o migrar la columna vectorial para que las inserciones y consultas sigan usando vectores compatibles.

Como el DDL no puede enlazar la dimensión del vector como un bind variable SQL normal, el script convierte EMBEDDING_DIM a entero antes de usarlo en la sentencia CREATE TABLE.

Crea el script

Guarda el siguiente código como 03_create_documents_table.py.

import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         dimension = int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc

 	if dimension <= 0:
         raise SystemExit("EMBEDDING_DIM must be a positive integer.")

 	return dimension


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Validate the configured model name and vector dimension.
     model_name = required_env("EMBEDDING_MODEL")
     dimension = configured_dimension()

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Recreate the documents table so the script is repeatable.
             cursor.execute(
                 """
                 BEGIN
                 	EXECUTE IMMEDIATE 'DROP TABLE documents PURGE';
                 EXCEPTION
                 	WHEN OTHERS THEN
                     	IF SQLCODE <> -942 THEN
                         	RAISE;
                     	END IF;
                 END;
                 """
             )
             cursor.execute(
                 f"""
                 CREATE TABLE documents (
                 	id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
                 	title VARCHAR2(200) NOT NULL,
                 	content VARCHAR2(1000) NOT NULL,
                 	embedding VECTOR({dimension}, FLOAT32)
                 )
                 """
             )

     print(f"Embedding model: {model_name}")
     print(f"Embedding dimension: {dimension}")
     print("Recreated documents table.")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta el script de creación de la tabla.

python 03_create_documents_table.py

Salida esperada

La salida debería mostrar el modelo de embeddings configurado y la dimensión del vector.

Embedding model: text-embedding-3-small
 Embedding dimension: 1536
 Recreated documents table.

Hemos completado la parte de solo base de datos. Oracle Database puede almacenar y comparar vectores en local; a continuación, sustituiremos los vectores escritos a mano por embeddings generados a partir de texto.

Paso 4: verifica la dimensión del modelo de embeddings

Antes de insertar embeddings, pediremos al modelo un vector y verificaremos su longitud. Esto evita el error más común con tablas vectoriales: insertar un vector cuya longitud no coincide con la dimensión de la columna VECTOR.

Un modelo de embeddings no es solo un conversor de texto a números; define el espacio de significado de la aplicación. Todos los embeddings de documentos y consultas en esta demo deben salir del mismo modelo.

Usar un único modelo garantiza que una distancia pequeña represente un significado similar, y no dos vectores no relacionados que casualmente tengan formas parecidas. El modelo también determina la longitud del vector, por eso comprobamos la dimensión devuelta antes de cargar datos.

Crea el script

Guarda el siguiente código como 04_check_embedding_dimension.py.

import os

 from openai import OpenAI


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         return int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc


 def main():
     required_env("OPENAI_API_KEY")

     model_name = required_env("EMBEDDING_MODEL")
     expected_dimension = configured_dimension()

 	# Request one embedding to confirm the model output dimension.
 	client = OpenAI()
     response = client.embeddings.create(
         model=model_name,
         input="Oracle AI Vector Search dimension check",
 	)

     returned_dimension = len(response.data[0].embedding)

     print(f"Embedding model: {model_name}")
     print(f"Returned embedding length: {returned_dimension}")
     print(f"Configured EMBEDDING_DIM: {expected_dimension}")

 	# Stop before loading data if the table dimension is incompatible.
 	if returned_dimension != expected_dimension:
         raise SystemExit(
             "Dimension check failed. Update EMBEDDING_DIM, rerun "
             "03_create_documents_table.py, and try again."
     	)

     print("Dimension check passed.")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta la comprobación de dimensión.

python 04_check_embedding_dimension.py

Salida esperada

Con el modelo y la dimensión por defecto, la salida debería parecerse a esto.

Embedding model: text-embedding-3-small
 Returned embedding length: 1536
 Configured EMBEDDING_DIM: 1536
 Dimension check passed.

Si más adelante elegimos otro modelo de embeddings, deberíamos actualizar EMBEDDING_MODEL, fijar EMBEDDING_DIM a la longitud de vector devuelta y recrear la tabla documents.

Paso 5: genera e inserta embeddings de documentos

Ahora generaremos embeddings para un conjunto pequeño y autocontenido de datos, e insertaremos los resultados en Oracle Database. 

Cada embedding se convierte a array.array("f", embedding) antes de enlazarlo para que coincida con la columna vectorial de tipo FLOAT32.

Crea el script

Guarda el siguiente código como 05_insert_embeddings.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 DOCUMENTS = [
 	(
         "Oracle AI Vector Search",
         "Oracle Database can store vector embeddings in native VECTOR "
         "columns and query them with SQL similarity search.",
 	),
 	(
         "Semantic Search for Applications",
         "Semantic search ranks results by meaning, helping applications "
         "find related content even when exact words differ.",
 	),
 	(
         "Vector Index Workflow",
         "Vector indexes help approximate nearest-neighbor search scale "
         "when datasets grow beyond small examples.",
 	),
 	(
         "Local Docker Development",
         "Docker containers make it practical to run a local database for "
         "development and repeatable tutorials.",
 	),
 	(
         "Python Database Code",
         "Python applications can connect to Oracle Database with the "
         "oracledb driver and use environment variables for credentials.",
 	),
 	(
         "Acoustic Guitar Practice",
         "Daily guitar practice improves timing, chord transitions, and "
         "confidence when learning new songs.",
 	),
 	(
         "Weeknight Vegetable Soup",
         "A simple soup can combine onions, carrots, beans, herbs, and "
         "broth for an easy weeknight meal.",
 	),
 ]

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         return int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")
     model_name = required_env("EMBEDDING_MODEL")
     expected_dimension = configured_dimension()

 	# Generate embeddings for all sample documents in one API request.
 	client = OpenAI()
     response = client.embeddings.create(
         model=model_name,
         input=[content for _, content in DOCUMENTS],
 	)

 	# Restore the response order using each item's index.
     embeddings = [
         item.embedding
     	for item in sorted(
             response.data,
             key=lambda item: item.index,
     	)
 	]

 	if any(len(embedding) != expected_dimension for embedding in embeddings):
         raise SystemExit(
             "An embedding length did not match EMBEDDING_DIM. "
             "Rerun 04_check_embedding_dimension.py."
     	)

 	# Bind each embedding as a 32-bit floating-point array.
 	rows = [
         (title, content, array.array("f", embedding))
     	for (title, content), embedding in zip(DOCUMENTS, embeddings)
 	]

 	# Replace the sample rows and commit the transaction.
 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             cursor.execute("DELETE FROM documents")
             cursor.executemany(
                 """
                 INSERT INTO documents (title, content, embedding)
                 VALUES (:1, :2, :3)
                 """,
                 rows,
             )
             cursor.execute("SELECT COUNT(*) FROM documents")
             row_count = cursor.fetchone()[0]
             connection.commit()

     print(f"Embedding model: {model_name}")
     print(f"Generated embeddings for {len(DOCUMENTS)} documents.")
     print(f"Inserted {len(DOCUMENTS)} documents.")
     print(f"documents row count: {row_count}")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta el script de inserción.

python 05_insert_embeddings.py

Salida esperada

El recuento de filas debería coincidir con los siete documents en línea.

Embedding model: text-embedding-3-small
 Generated embeddings for 7 documents.
 Inserted 7 documents.
 documents row count: 7

Ahora tenemos texto y embeddings almacenados juntos en Oracle Database. Hemos incluido documents no relacionados sobre guitarra y sopa para que los resultados de búsqueda tengan coincidencias cercanas y lejanas claras.

Paso 6: ejecuta una consulta de búsqueda semántica

A continuación, generaremos el embedding de una consulta en lenguaje natural y lo compararemos con los embeddings de documentos almacenados. Este script usa distancia coseno, común en embeddings de texto porque se centra en la dirección del vector más que en la magnitud bruta.

Para la búsqueda semántica, la consulta pasa por el mismo modelo de embeddings que los documents. No le pedimos a SQL que entienda directamente la frase en inglés. 

Le pedimos al modelo de embeddings que convierta la frase en un vector y a Oracle Database que ordene los vectores almacenados por su distancia a ese vector de consulta.

Crea el script

Guarda el siguiente código como 06_semantic_search.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 QUERY_TEXT = "Where should an AI app keep meaning-based search data?"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate an embedding for the natural-language query.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=QUERY_TEXT,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Rank stored documents by cosine distance from the query vector.
             cursor.execute(
                 """
                 SELECT title,
                    	content,
                    	VECTOR_DISTANCE(
                        	embedding,
                        	:query_vector,
                        	COSINE
                    	) AS distance
                 FROM documents
                 ORDER BY distance
                 FETCH EXACT FIRST 5 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             rows = cursor.fetchall()

 	if not rows:
         raise SystemExit("No documents found. Run 05_insert_embeddings.py first.")

     print(f"Query: {QUERY_TEXT}")
     print("\nTop 5 results:")

 	for rank, (title, content, distance) in enumerate(rows, start=1):
         print(f"{rank}. {title}")
         print(f"   distance: {float(distance):.6f}")
         print(f"   {content[:90]}...")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta el script de búsqueda semántica.

python 06_semantic_search.py

Salida esperada

Las clasificaciones y distancias exactas pueden variar si cambia el modelo de embeddings. No obstante, los documents sobre Oracle AI Vector Search, búsqueda semántica, código de base de datos en Python e indexación vectorial deberían quedar arriba.

Query: Where should an AI app keep meaning-based search data?

 Top 5 results:
 1. Oracle AI Vector Search
    distance: <cosine distance from your run>
    Oracle Database can store vector embeddings in native VECTOR columns and query them with SQL...

 2. Semantic Search for Applications
    distance: <cosine distance from your run>
    Semantic search ranks results by meaning, helping applications find related content even when...

 3. Python Database Code
    distance: <cosine distance from your run>
    Python applications can connect to Oracle Database with the oracledb driver and use environment...

 4. Vector Index Workflow
    distance: <cosine distance from your run>
    Vector indexes help approximate nearest-neighbor search scale when datasets grow beyond small...

 5. Local Docker Development
    distance: <cosine distance from your run>
    Docker containers make it practical to run a local database for development and repeatable...

En las consultas de distancia euclídea y coseno de este tutorial, valores más pequeños indican coincidencias más cercanas. 

El producto escalar es otro enfoque útil de comparación vectorial en muchos flujos de búsqueda vectorial, especialmente cuando la magnitud o la normalización importan, pero el signo de la puntuación y la normalización exigen un manejo cuidadoso. 

Mantendremos el código ejecutable con distancia euclídea y coseno para que la interpretación de resultados sea sencilla.

Si en una aplicación futura normalizamos nosotros mismos los embeddings, hay que normalizar de forma consistente tanto los embeddings almacenados de documentos como los de consulta; de lo contrario, pueden cambiar distancias y rankings.

Paso 7: compara la búsqueda semántica con una coincidencia por frase

La búsqueda semántica es útil porque no requiere que la frase exacta aparezca en el documento.

Comparemos la consulta semántica con un predicado simple de frase exacta.

Esto no es una demo de motor de búsqueda de texto completo; es una pequeña comparación en SQL que hace visible la diferencia entre coincidencia literal y ranking por significado.

Crea el script

Guarda el siguiente código como 07_semantic_vs_keyword.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 SEMANTIC_QUERY = "Where should an AI app keep meaning-based search data?"
 KEYWORD_PHRASE = "meaning-based search data"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate an embedding for the semantic query.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=SEMANTIC_QUERY,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Rank documents by semantic similarity.
             cursor.execute(
                 """
                 SELECT title,
                        VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FROM documents
                 ORDER BY VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FETCH EXACT FIRST 3 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             semantic_rows = cursor.fetchall()

             # Compare semantic results with an exact phrase predicate.
             cursor.execute(
                 """
                 SELECT title
                 FROM documents
                 WHERE LOWER(title || ' ' || content)
                   	LIKE '%' || :phrase || '%'
                 ORDER BY title
                 FETCH FIRST 3 ROWS ONLY
                 """,
                 phrase=KEYWORD_PHRASE.lower(),
             )
             keyword_rows = cursor.fetchall()

     print(f"Semantic query: {SEMANTIC_QUERY}")
     print(f"Keyword phrase: {KEYWORD_PHRASE}")

     print("\nSemantic results:")
 	for rank, (title, distance) in enumerate(semantic_rows, start=1):
         print(f"{rank}. {title}")
         print(f"   distance: {float(distance):.6f}")

     print("\nKeyword results:")
 	if keyword_rows:
     	for rank, (title,) in enumerate(keyword_rows, start=1):
             print(f"{rank}. {title}")
 	else:
         print("0 exact phrase matches")


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta el script de comparación.

python 07_semantic_vs_keyword.py

Salida esperada

La búsqueda semántica debería devolver documents relevantes aunque la frase exacta no esté presente.

Semantic query: Where should an AI app keep meaning-based search data?
 Keyword phrase: meaning-based search data

 Semantic results:
 1. Oracle AI Vector Search
    distance: <cosine distance from your run>
 2. Semantic Search for Applications
    distance: <cosine distance from your run>
 3. Python Database Code
    distance: <cosine distance from your run>

 Keyword results:
 0 exact phrase matches

Los predicados SQL tradicionales siguen siendo importantes para filtros, joins, permisos y coincidencias exactas. La búsqueda vectorial añade una señal de ranking basada en significado que podemos combinar con datos relacionales cuando una aplicación necesita recuperación semántica.

Paso 8: añade y valida un índice vectorial

Por último, crearemos un índice vectorial y validaremos que Oracle Database lo informa como un índice válido propiedad del esquema de la demo. 

Este paso demuestra el flujo de creación de índices; nuestro dataset diminuto no es suficiente para sacar conclusiones de rendimiento.

Sin índice, Oracle Database puede comparar exactamente el vector de consulta con cada vector almacenado. Ese enfoque es adecuado para datasets muy pequeños y útil mientras aprendemos.

Con datasets mayores, los índices vectoriales aproximados reducen el espacio de búsqueda para que las consultas devuelvan rápido y sigan encontrando vecinos cercanos. 

Elige la familia de índice tras considerar tamaño de datos, objetivos de latencia, requisitos de recall, presupuesto de memoria y frecuencia de cambios de vectores.

La consulta final confirma que la búsqueda semántica sigue devolviendo resultados tras crear el índice. 

No usaremos EXPLAIN PLAN ni DBMS_XPLAN aquí porque este tutorial valida la creación del índice con metadatos del esquema, no con el plan de ejecución.

Crea el script

Guarda el siguiente código como 08_create_vector_index.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 INDEX_NAME = "DOCUMENT_EMBEDDING_IDX"
 QUERY_TEXT = "Where should an AI app keep meaning-based search data?"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate the query vector used for the validation search.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=QUERY_TEXT,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Remove a prior index so the script can be rerun safely.
             try:
                 cursor.execute(f"DROP INDEX {INDEX_NAME}")
             except oracledb.DatabaseError as exc:
                 error = exc.args[0]
                 if error.code != 1418:
                 	raise

             # Create an approximate neighbor-partitions vector index.
             cursor.execute(
                 """
                 CREATE VECTOR INDEX document_embedding_idx
                 ON documents (embedding)
                 ORGANIZATION NEIGHBOR PARTITIONS
                 DISTANCE COSINE
                 WITH TARGET ACCURACY 95
                 """
             )

             # Confirm that Oracle reports the vector index as valid.
             cursor.execute(
                 """
                 SELECT index_name, index_type, status
                 FROM user_indexes
                 WHERE index_name = :index_name
                 """,
                 index_name=INDEX_NAME,
             )
             index_row = cursor.fetchone()

             # Confirm that semantic search still returns rows after index creation.
             cursor.execute(
                 """
                 SELECT title
                 FROM documents
                 ORDER BY VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FETCH EXACT FIRST 3 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             rows = cursor.fetchall()

 	if not index_row:
         raise SystemExit("Vector index was not found in USER_INDEXES.")

     print("Created vector index DOCUMENT_EMBEDDING_IDX.")
     print("\nIndex validation:")
     print(f"Index name: {index_row[0]}")
     print(f"Index type: {index_row[1]}")
     print(f"Status: {index_row[2]}")
     result_count = len(rows)

 	print(
         "\nSemantic search still returns "
         f"{result_count} results after index creation."
 	)


 if __name__ == "__main__":
 	main()

Ejecuta el script

Ejecuta el script del índice.

python 08_create_vector_index.py

Salida esperada

La salida debería incluir una fila para DOCUMENT_EMBEDDING_IDX, con INDEX_TYPE con valor VECTOR y STATUS con valor VALID.

Created vector index DOCUMENT_EMBEDDING_IDX.

 Index validation:
 Index name: DOCUMENT_EMBEDDING_IDX
 Index type: VECTOR
 Status: VALID

 Semantic search still returns 3 results after index creation.

USER_INDEXES confirma que el índice existe y es válido. No prueba que una consulta concreta haya usado el índice, y este tutorial no usa planes de ejecución como método de validación. 

Para cargas de producción, probaríamos con volúmenes de datos realistas, patrones de consulta y objetivos de rendimiento.

Consejos y resolución de problemas con Oracle AI Vector Search

El contenedor de base de datos sigue arrancando

Espera a que termine el arranque y vuelve a ejecutar docker logs oracle-free-26ai-vector. La base de datos debe estar lista antes de que Python pueda conectar a localhost:1521/FREEPDB1.

El puerto 1521 ya está en uso

Detén el servicio local en conflicto o cambia el mapeo de puertos de Docker. Actualiza DB_DSN si cambias el puerto del host.

Falla la conexión a la base de datos

Verifica DB_USER, DB_PASSWORD y DB_DSN. Usa FREEPDB1 en el DSN y conecta los scripts de aplicación como vector_demo, no como SYS, SYSTEM o PDBADMIN.

Falta la clave de la API de embeddings

Los pasos 1-3 son solo de base de datos. Los pasos 4-8 requieren OPENAI_API_KEY y pueden generar costes de API.

No coincide una dimensión vectorial

Ejecuta 04_check_embedding_dimension.py, actualiza EMBEDDING_DIM, vuelve a ejecutar 03_create_documents_table.py y recarga los embeddings con 05_insert_embeddings.py.

Falla el bind de un vector

Asegúrate de que cada bind de vector FLOAT32 use array.array("f", values). El tutorial utiliza este formato para vectores manuales, embeddings almacenados de documentos y embeddings de consulta.

Los rankings semánticos difieren del ejemplo

Es lo esperado. Los proveedores de embeddings pueden actualizar modelos y las distancias en coma flotante pueden variar entre ejecuciones.

Falla la creación del índice vectorial

Confirma que la tabla documents existe, que el esquema vector_demo es su propietario y que DOCUMENT_EMBEDDING_IDX no quedó de una ejecución parcial anterior.

Preparación para producción

Usa oracledb.create_pool() para el pool de conexiones, haz pruebas con volúmenes de datos realistas, revisa seguridad y gestión de secretos y ajusta los índices según patrones de consulta reales.

Detén y elimina el contenedor

Cuando termines el tutorial, detén y elimina el contenedor local.

docker stop oracle-free-26ai-vector
docker rm oracle-free-26ai-vector

Conclusión

Hemos creado un flujo de trabajo de búsqueda semántica en local con Oracle AI Vector Search, Oracle Database Free 26ai y Python. 

Empezamos con valores VECTOR(3, FLOAT32) escritos a mano, insertamos embeddings generados por modelo con array.array("f", values), consultamos documents similares con VECTOR_DISTANCE(), comparamos la recuperación semántica con un predicado sencillo de frase exacta y validamos un índice vectorial a través de USER_INDEXES.

Este enfoque encaja bien cuando los embeddings deben vivir junto a datos relacionales y queremos almacenamiento y búsqueda visibles en SQL sin añadir una base de datos vectorial separada para el flujo local. 

La demo es intencionadamente pequeña: enseña los fundamentos, no el escalado en producción. Las aplicaciones mayores deberían probar con datos realistas, revisar seguridad y privilegios, usar pool de conexiones y validar las decisiones de indexación con patrones de consulta reales.

A continuación, puedes profundizar con estos recursos:

FAQs

¿Qué es Oracle AI Vector Search?

Oracle AI Vector Search es un conjunto de capacidades de Oracle Database para almacenar, indexar y consultar embeddings vectoriales junto a datos relacionales.

¿Necesito una clave de API de OpenAI para completar el tutorial?

Los pasos de vectores manuales y configuración de base de datos no requieren una clave de API. Los pasos 4-8 necesitan un proveedor de embeddings y la OPENAI_API_KEY configurada.

¿Por qué EMBEDDING_DIM debe coincidir con el modelo de embeddings?

La dimensión de la columna VECTOR debe ser igual al número de valores que devuelve el modelo de embeddings. Si no coincide, fallará la inserción del vector.

¿Qué métricas de distancia usa el tutorial?

El ejemplo de vectores manuales usa distancia euclídea. Los ejemplos de búsqueda semántica usan distancia coseno.

¿Un índice vectorial válido prueba que una consulta ha usado el índice?

No. USER_INDEXES confirma que el índice existe y tiene estado válido, pero no confirma que una consulta concreta lo haya utilizado.


Mark Nelson's photo
Author
Mark Nelson
LinkedIn

Mark Nelson es arquitecto y Developer Evangelist en Oracle. Trabaja en la confluencia de la IA, los microservicios y las tecnologías de bases de datos. Es bloguero activo, autor publicado, revisor técnico en Manning Publications, Section Leader en Stanford Code in Place y mentor en DeepLearning.ai. Suele dar charlas en Java y Oracle User Groups, en meetups de IA y en grandes conferencias. Le apasiona aprender y enseñar. Cuenta con más de treinta años de experiencia en el sector, en IBM y Oracle.

Temas
Inteligencia Artificial
Python

Principales cursos de DataCamp

Curso

Introducción a Oracle SQL

4 h
18.5K
Perfecciona tus habilidades en Oracle SQL, incluidos los conceptos básicos de SQL, la agregación, la combinación y la personalización de datos.
Ver detallesRight Arrow
Empezar Curso
Ver másRight Arrow
Relacionado

blog

¿Qué es vector embedding? Una explicación intuitiva

Vector embedding refiere a representaciones numéricas de palabras o frases que captan sus significados y relaciones, ayudando a los modelos de aprendizaje automático a comprender el texto con mayor eficacia.

blog

Las 7 mejores bases de datos vectoriales en 2026

Una guía completa sobre las mejores bases de datos vectoriales. Domina el almacenamiento de datos de alta dimensión, descifra información no estructurada y aprovecha las incrustaciones vectoriales para aplicaciones de IA.
Moez Ali's photo

Moez Ali

14 min

Tutorial

Tutorial de pgvector: Integrar la búsqueda vectorial en PostgreSQL

Descubre cómo mejorar PostgreSQL con capacidades de búsqueda vectorial utilizando pgvector. Este tutorial te guía a través de la instalación, las operaciones básicas y la integración con herramientas de IA.
Moez Ali's photo

Moez Ali

10 min

Tutorial

Tutorial de Generación de nubes de palabras en Python

Aprende a realizar Análisis exploratorios de datos para el Procesamiento del lenguaje natural utilizando WordCloud en Python.
Duong Vu's photo

Duong Vu

11 min

Tutorial

Tutorial sobre máquinas de vectores de soporte con Scikit-learn

En este tutorial, aprenderás sobre las máquinas de vectores de soporte, uno de los algoritmos de machine learning supervisado más populares y utilizados.
Avinash Navlani's photo

Avinash Navlani

15 min

Tutorial

Guía para principiantes de la API de OpenAI: Tutorial práctico y prácticas recomendadas

Este tutorial te presenta la API de OpenAI, sus casos de uso, un enfoque práctico para utilizar la API y todas las prácticas recomendadas que debes seguir.
Arunn Thevapalan's photo

Arunn Thevapalan

13 min

Ver MásVer Más