Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
Neste tutorial, vamos criar um demo local de busca semântica com Oracle AI Vector Search, Python e Oracle Database Free 26ai.
Começaremos com vetores tridimensionais escritos à mão para que o cálculo de distância fique visível; depois, vamos gerar embeddings de texto e consultá-los no Oracle Database com SQL.
Este tutorial é para desenvolvedores Python e SQL que estão começando com busca vetorial e têm familiaridade com Docker, variáveis de ambiente, pacotes Python e configuração de banco de dados local.
Aplicativos com IA precisam de busca que entenda significado, não só palavras exatas. Um app de suporte, portal de documentação ou ferramenta interna de conhecimento deve conseguir encontrar “armazenamento de banco de dados para busca em IA” mesmo quando o melhor documento diz “armazenar embeddings vetoriais em colunas nativas”.
Vector embeddings tornam isso possível ao representar texto como vetores numéricos. O Oracle AI Vector Search permite armazenar esses vetores diretamente no Oracle Database, consultá-los com SQL e manter embeddings ao lado dos dados relacionais do aplicativo.
Para este fluxo local, não precisamos de um banco vetorial separado.
Vamos executar o Oracle Database Free 26ai localmente, conectar a partir do Python no modo Thin do oracledb, armazenar primeiro vetores manuais, depois armazenar embeddings da OpenAI, rodar busca semântica, comparar a recuperação semântica com um predicado simples de frase exata e criar um índice vetorial validado por meio de USER_INDEXES.
Ao final, teremos um fluxo de busca semântica em Python que armazena embeddings no Oracle Database e recupera localmente os documents mais similares.
Oracle AI Vector Search é um conjunto de recursos do Oracle Database para armazenar, indexar e consultar embeddings vetoriais. Um embedding vetorial é uma lista de números de tamanho fixo que representa o significado de textos, imagens ou outros dados em uma forma que o banco consegue comparar matematicamente.
Um modelo de embedding cria os vetores numéricos. Ele recebe como entrada uma sentença, parágrafo, descrição de imagem ou trecho de código e retorna um vetor com um número fixo de dimensões.
Entradas similares devem produzir vetores próximos entre si, enquanto entradas não relacionadas devem ficar mais distantes. Por isso, precisamos usar o mesmo modelo de embedding para os documents armazenados e para as consultas, pois as distâncias só fazem sentido quando os vetores compartilham o mesmo sistema de coordenadas.
Neste tutorial, os vetores manuais são deliberadamente pequenos para inspecionarmos a matemática. Os embeddings reais de texto são bem maiores porque o modelo precisa de dimensões suficientes para codificar relações sutis entre palavras, frases e tópicos.
A busca vetorial ranqueia linhas pela distância entre vetores. Para consultas de distância euclidiana e de cosseno, valores menores significam correspondências mais próximas. Neste tutorial, começaremos com uma coluna VECTOR(3, FLOAT32) pequena para ver o comportamento da distância diretamente e depois passaremos para embeddings VECTOR(1536, FLOAT32) gerados a partir de texto.
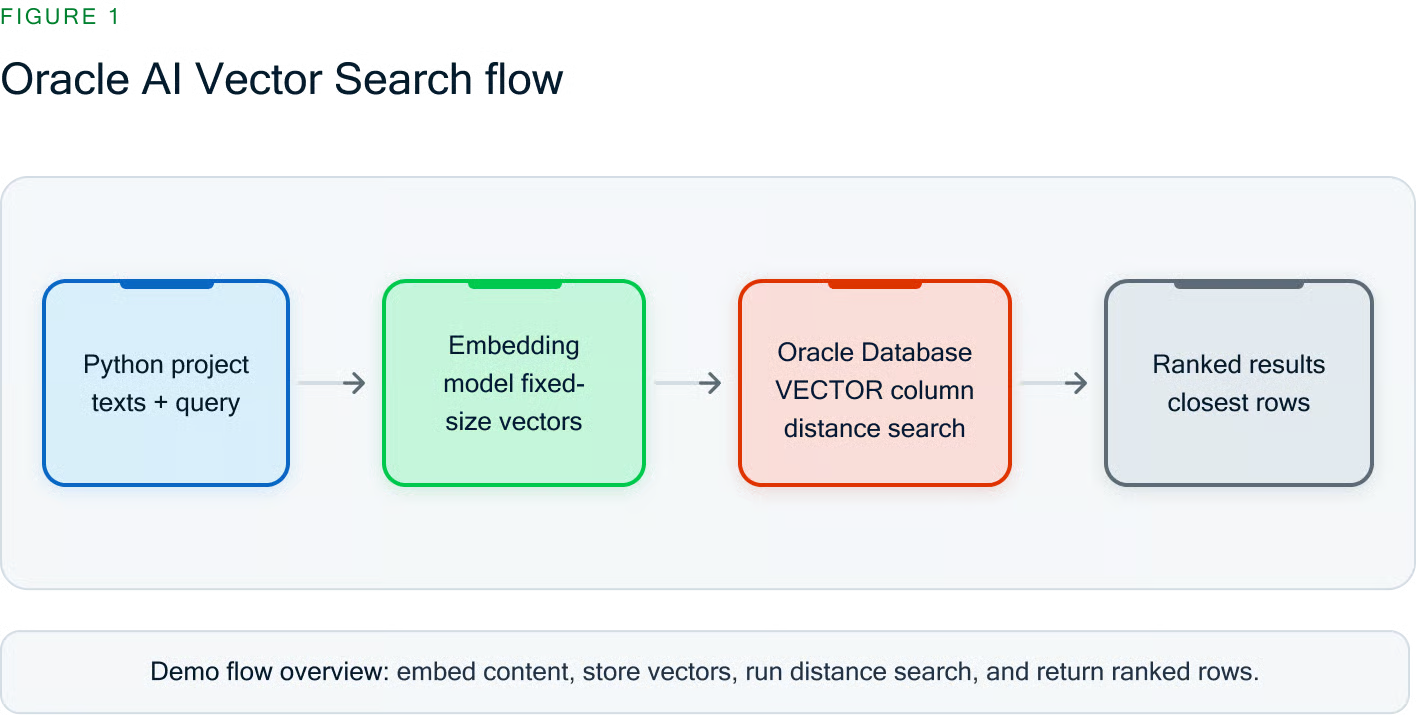
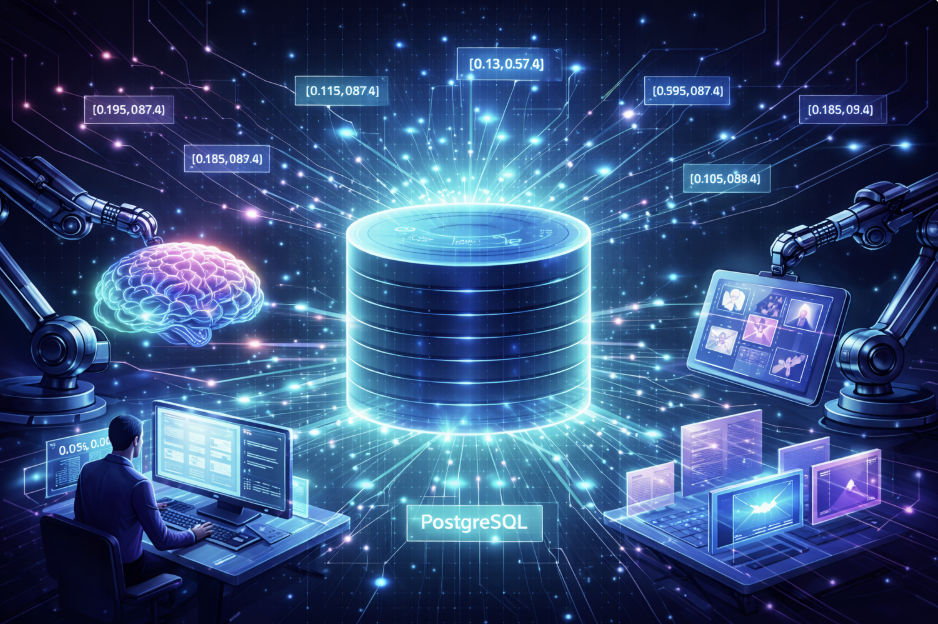
Figura 1. Fluxo do Oracle AI Vector Search
Oracle AI Vector Search armazena embeddings em uma coluna nativa VECTOR e ranqueia os resultados pela distância vetorial.
Oracle Database é útil quando embeddings precisam ficar ao lado de dados relacionais do app, como IDs de documentos, títulos, conteúdo, usuários, produtos, tickets ou metadados.
Alguns aplicativos usam um banco vetorial ou mecanismo de busca separado para cargas especializadas de recuperação; mas, para o fluxo local deste tutorial, o Oracle Database oferece os recursos de armazenamento e busca vetorial de que precisamos.
Usaremos quatro recursos do Oracle AI Vector Search no demo: armazenamento vetorial nativo, funções de distância, índices vetoriais e integração relacional.
Oracle Database suporta colunas nativas VECTOR com dimensões explícitas e formatos de elemento. No demo, usaremos VECTOR(3, FLOAT32) para vetores manuais e VECTOR(1536, FLOAT32) para o modelo de embedding padrão text-embedding-3-small.
Os exemplos executáveis usam VECTOR_DISTANCE() porque mantém a métrica de distância explícita no SQL.
Usaremos distância euclidiana para o exemplo manual e distância de cosseno para embeddings de texto.
Oracle Database também inclui operadores abreviados de distância vetorial e comportamento relacionado a produto interno, mas este tutorial mantém o SQL executável no caminho explícito com VECTOR_DISTANCE().
Métricas de distância diferentes respondem a perguntas ligeiramente diferentes sobre “proximidade”.
Para um tutorial curto, distância de cosseno é um bom padrão para embeddings de texto porque foca na direção, o que costuma mapear bem para similaridade semântica.
A distância euclidiana é mais fácil de visualizar com vetores escritos à mão, e comparações no estilo produto interno são úteis em alguns sistemas quando a magnitude do vetor ou a normalização fazem parte do desenho do modelo.
|
Métrica |
O que compara |
Bom para |
Fique atento a |
|
Cosseno |
Direção do vetor |
Embeddings de texto e similaridade semântica |
Os resultados dependem do mesmo modelo de embedding e de pré-processamento consistente |
|
Euclidiana |
Distância em linha reta |
Exemplos pequenos, intuição geométrica, alguns vetores de features numéricas |
A magnitude afeta a distância; o escalonamento pode importar |
|
Produto interno |
Direção e magnitude juntas |
Workflows baseados em vetores normalizados ou pontuação por produto interno |
É preciso entender direção do score e regras de normalização antes de comparar resultados |
A busca vetorial exata é útil para correção e datasets pequenos. À medida que os dados crescem, índices vetoriais dão suporte a buscas aproximadas de vizinhos mais próximos.
Oracle AI Vector Search inclui índices de grafo de vizinhos em memória, frequentemente associados a buscas no estilo HNSW, e índices de partições de vizinhos, associados à partição no estilo IVF.
Neste demo local, usamos ORGANIZATION NEIGHBOR PARTITIONS e validamos o índice com USER_INDEXES.
Índices aproximados trocam um pouco da exatidão da busca exaustiva por mais velocidade em escala.
A família de índice certa depende da carga, volume de dados, padrão de atualização e meta de recall.
Este tutorial usa um índice de partições de vizinhos no estilo IVF porque simplifica o setup local e oferece um passo concreto de criação de índice sem transformar o tutorial em um guia de tuning.
|
Família de índice |
Ideia básica |
Pontos fortes |
Trade-offs |
Quando usar |
|
IVF / partições de vizinhos |
Particionar o espaço vetorial e buscar nas partições prováveis |
Modelo mental simples, prático para muitos datasets carregados em lote |
Recall e velocidade dependem da partição e das configurações de busca |
Queremos um caminho direto de busca aproximada para um dataset em crescimento |
|
HNSW / grafo de vizinhos |
Construir um grafo que liga vetores próximos para travessia rápida |
Ótimo perfil de recall e latência para muitos workloads de vizinhos mais próximos |
Mais orientado a memória; a configuração pode importar mais |
Precisamos de baixa latência e podemos investir memória e esforço de tuning |
Uma coluna vetorial pode viver ao lado de colunas relacionais comuns. Nossa tabela de documents vai armazenar título, conteúdo e embedding juntos, para que o SQL retorne tanto o score de similaridade quanto o texto original.
Vamos usar um caminho local: Oracle Database Free 26ai no Docker, o serviço FREEPDB1 e um usuário de aplicação dedicado vector_demo.
Os conceitos de busca vetorial são acessíveis, mas a configuração é intermediária porque usamos Docker, um schema de banco, pacotes Python, variáveis de ambiente e uma chave de API de embedding.
Vamos precisar de:
Este demo requer uma versão/ambiente do Oracle Database que inclua os recursos vetoriais usados aqui, incluindo colunas nativas VECTOR, VECTOR_DISTANCE() e CREATE VECTOR INDEX.
O caminho local usa Oracle Database Free 26ai com a tag de imagem mostrada abaixo, e o DSN usa o serviço de banco plugável FREEPDB1.
As etapas com vetores manuais não exigem uma chave de API da OpenAI. As etapas semânticas enviam o texto de exemplo e a consulta para o provedor de embedding configurado, então usaremos apenas textos de amostra ou não sensíveis.
Este tutorial usa o oracledb, o driver Python atual para Oracle Database. O python-oracledb roda em modo Thin por padrão, então este demo local não requer bibliotecas do Oracle Client. O modo Thick é útil em outras implantações, mas aqui não chamaremos oracledb.init_oracle_client().
Crie um diretório de projeto para os scripts que vamos construir.
Inicie o Oracle Database Free 26ai com a imagem local do container.
Verifique os logs do container e aguarde até o banco indicar que a inicialização foi concluída.
FREEPDB1 é o serviço de database plugável usado por este caminho local do Oracle Database Free. Nosso DSN no Python será localhost:1521/FREEPDB1.
Use SYS apenas para a etapa de configuração do schema. A senha no comando sqlplus é o valor de ORACLE_PWD do comando docker run; a senha no CREATE USER é a senha da aplicação que vamos exportar como DB_PASSWORD.
Rode a configuração dentro do container do banco.
Este é um atalho local de desenvolvimento para o container de demo. CREATE SEQUENCE é necessário porque as tabelas usam colunas identity.
Em produção, revisaríamos privilégios com um DBA e aplicaríamos privilégio mínimo para a carga exata da aplicação.
Crie e ative um ambiente virtual.
Instale os pacotes Python usados no demo.
Guarde credenciais do banco e parâmetros de embedding em variáveis de ambiente em vez de fixá-los nos arquivos Python.
OPENAI_API_KEY é exigida apenas para as etapas de embedding e busca semântica. EMBEDDING_DIM deve corresponder ao número de dimensões retornado pelo modelo escolhido.
Vamos construir o demo em oito checkpoints. Cada script adiciona um conceito e gera uma saída que podemos verificar antes de avançar.
O checkpoint “apenas banco” termina após os Passos 1–3. Nesse ponto, teremos conectado ao Oracle Database, armazenado vetores manuais, consultado por distância e criado a tabela semântica. A chave de API da OpenAI passa a ser necessária no Passo 4.
Primeiro, vamos verificar se o Python consegue conectar ao Oracle Database como o usuário de aplicação vector_demo. Este script lê DB_USER, DB_PASSWORD e DB_DSN do ambiente e imprime o modo do driver e a versão do banco.
Salve o código a seguir como 01_check_connection.py.
Rode a verificação de conexão.
A saída deve confirmar que a conexão funciona e que o driver está em modo Thin.
Agora sabemos que o banco local, o nome do serviço, as credenciais e o driver Python estão funcionando antes de criar as tabelas vetoriais.
Antes de introduzirmos modelos de embedding, vamos armazenar três vetores pequenos que conseguimos entender. A chamada array.array("f", values) cria um array de ponto flutuante 32-bit que o python-oracledb consegue associar a uma coluna VECTOR(..., FLOAT32).
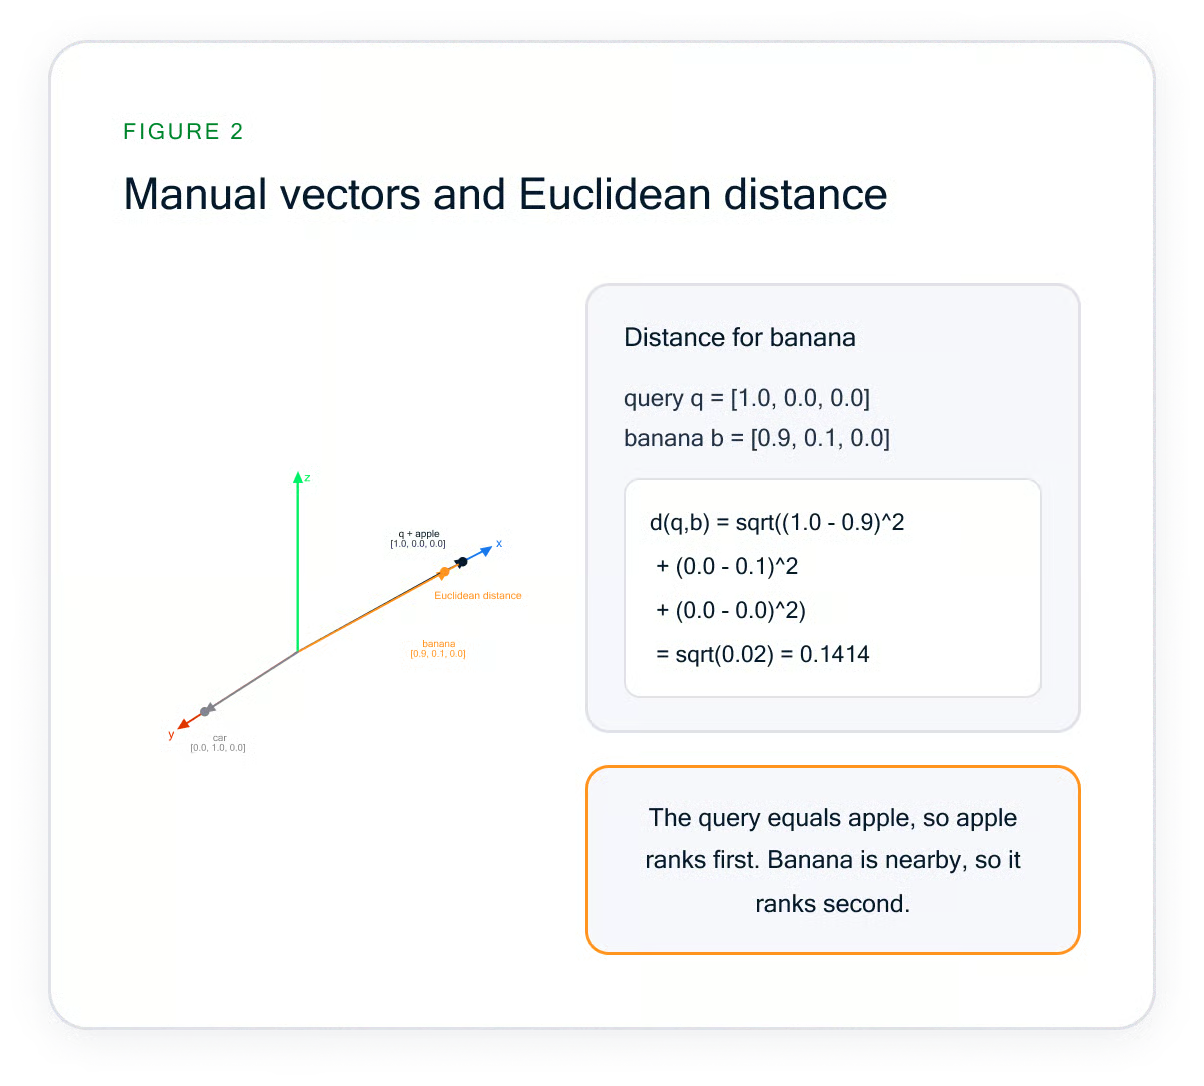
Figura 2. Vetores manuais e distância euclidiana.
O exemplo manual usa distância euclidiana. O vetor “apple” tem distância 0,0000 porque coincide com o vetor de consulta. O vetor “banana” fica em segundo porque sqrt((1.0 - 0.9)^2 + (0.0 - 0.1)^2 + (0.0 - 0.0)^2) = 0,1414.
Salve o código a seguir como 02_manual_vectors.py.
Rode o script de vetores manuais.
O vetor idêntico aparece primeiro com distância 0,0000 e o vetor “banana” aparece em segundo.
Esta é a ideia central da busca vetorial: as linhas são ranqueadas pela proximidade matemática a um vetor de consulta. Modelos de embedding geram vetores maiores, mas o comportamento no banco é o mesmo.
Agora que sabemos que vetores funcionam, vamos criar uma tabela no estilo de aplicação. O detalhe importante é que a dimensão da coluna vetorial deve corresponder à dimensão de saída do modelo de embedding.
A dimensão faz parte do contrato da tabela. Se um modelo retorna 1.536 números, a coluna deve ser declarada como VECTOR(1536, FLOAT32).
Se depois trocarmos para um modelo com comprimento diferente, precisamos recriar ou migrar a coluna vetorial para que inserts e consultas continuem compatíveis.
Como DDL não permite associar a dimensão vetorial como bind normal, o script converte EMBEDDING_DIM em inteiro antes de usar no CREATE TABLE.
Salve o código a seguir como 03_create_documents_table.py.
Rode o script de criação da tabela.
A saída deve mostrar o modelo de embedding configurado e a dimensão vetorial.
Concluímos a parte apenas de banco. O Oracle Database consegue armazenar e comparar vetores localmente; em seguida, vamos trocar vetores escritos à mão por embeddings gerados a partir de texto.
Antes de inserir embeddings, vamos pedir um vetor ao modelo e verificar seu comprimento. Isso evita o erro vetorial mais comum: inserir um vetor cujo comprimento não corresponde à dimensão da coluna VECTOR.
Um modelo de embedding não é apenas um conversor texto→número; ele define o espaço de significado da aplicação. Todos os embeddings de documentos e consultas neste demo devem vir do mesmo modelo.
Usar um único modelo garante que uma distância pequena represente significados similares, e não vetores não relacionados que por acaso tenham forma parecida. O modelo também determina o comprimento do vetor, por isso checamos a dimensão retornada antes de carregar dados.
Salve o código a seguir como 04_check_embedding_dimension.py.
Rode a checagem de dimensão.
Para o modelo e dimensão padrão, a saída deve parecer com isto.
Se escolhermos um modelo de embedding diferente mais tarde, devemos atualizar EMBEDDING_MODEL, definir EMBEDDING_DIM para o comprimento retornado e recriar a tabela documents.
Agora vamos gerar embeddings para um pequeno dataset autocontido e inseri-los no Oracle Database.
Cada embedding é convertido para array.array("f", embedding) antes de associar, para corresponder à coluna vetorial FLOAT32.
Salve o código a seguir como 05_insert_embeddings.py.
Rode o script de insert.
A contagem de linhas deve corresponder aos sete documents inline.
Agora temos texto e embeddings armazenados juntos no Oracle Database. Os documents não relacionados sobre violão e sopa foram incluídos para que os resultados tenham correspondências obviamente próximas e distantes.
Em seguida, vamos embutir uma consulta em linguagem natural e compará-la com os embeddings dos documentos armazenados. Este script usa distância de cosseno, comumente usada em embeddings de texto porque foca na direção do vetor, não na magnitude bruta.
Para busca semântica, a consulta passa pelo mesmo modelo de embedding que os documents. Não estamos pedindo ao SQL que entenda a frase em inglês diretamente.
Estamos pedindo ao modelo de embedding que transforme a frase em um vetor e, então, pedindo ao Oracle Database que ranqueie os vetores armazenados pela distância a esse vetor de consulta.
Salve o código a seguir como 06_semantic_search.py.
Rode o script de busca semântica.
Rankings e distâncias exatas podem variar quando o modelo muda. Porém, documents sobre Oracle AI Vector Search, busca semântica, código Python para banco e indexação vetorial devem ranquear no topo.
Para as consultas de distância euclidiana e de cosseno deste tutorial, valores menores indicam correspondências mais próximas.
Produto interno é outra abordagem útil em muitos workflows de busca vetorial, especialmente quando a magnitude ou a normalização dos vetores importam, mas a direção do score e a normalização exigem cuidado.
Vamos manter o código executável em distância euclidiana e de cosseno para simplificar a interpretação.
Se normalizarmos embeddings em um app futuro, precisamos normalizar tanto os embeddings de documentos armazenados quanto os de consulta de forma consistente; do contrário, distâncias e rankings podem mudar.
A busca semântica é útil porque não exige que a frase exata apareça no documento.
Vamos comparar a consulta semântica com um predicado simples de frase exata.
Isto não é um demo de mecanismo de busca full-text; é uma pequena comparação em SQL que torna visível a diferença entre correspondência literal e ranqueamento por significado.
Salve o código a seguir como 07_semantic_vs_keyword.py.
Rode o script de comparação.
A busca semântica deve retornar documents relevantes mesmo que a frase exata não esteja presente.
Predicados SQL tradicionais continuam importantes para filtros, junções, permissões e correspondência exata. A busca vetorial adiciona um sinal de ranqueamento por significado que podemos combinar com dados relacionais quando a aplicação precisa de recuperação semântica.
Por fim, vamos criar um índice vetorial e validar que o Oracle Database o reporta como um índice válido pertencente ao schema do demo.
Este passo demonstra o fluxo de criação do índice; nosso dataset minúsculo não é grande o suficiente para conclusões de performance.
Sem índice, o Oracle Database pode comparar o vetor de consulta com cada vetor armazenado exatamente. Essa abordagem é adequada para datasets minúsculos e útil durante o aprendizado.
Com datasets maiores, índices vetoriais aproximados reduzem o espaço de busca para que as consultas retornem rápido e ainda encontrem vizinhos próximos.
Escolha a família de índice considerando tamanho de dados, metas de latência, requisitos de recall, orçamento de memória e frequência de mudança dos vetores.
A consulta ao final confirma que a busca semântica ainda retorna resultados após a criação do índice.
Não usaremos EXPLAIN PLAN ou DBMS_XPLAN aqui porque este tutorial valida a criação do índice com metadados do schema, não com o plano de execução.
Salve o código a seguir como 08_create_vector_index.py.
Rode o script do índice.
A saída deve incluir uma linha para DOCUMENT_EMBEDDING_IDX, com INDEX_TYPE definido como VECTOR e STATUS como VALID.
USER_INDEXES confirma que o índice existe e é válido. Isso não prova que uma consulta específica usou o índice, e este tutorial não usa o plano de execução como método de validação.
Para workloads de produção, testaríamos com volume de dados, padrões de consulta e metas de performance realistas.
Espere a inicialização concluir e rode docker logs oracle-free-26ai-vector novamente. O banco precisa estar pronto antes de o Python conectar a localhost:1521/FREEPDB1.
Pare o serviço local em conflito ou altere o mapeamento de portas do Docker. Atualize o DB_DSN se a porta do host mudar.
Verifique DB_USER, DB_PASSWORD e DB_DSN. Use FREEPDB1 no DSN e conecte os scripts da aplicação como vector_demo, não como SYS, SYSTEM ou PDBADMIN.
Os passos 1–3 são apenas de banco. Os passos 4–8 exigem OPENAI_API_KEY e podem gerar custos de API.
Rode 04_check_embedding_dimension.py, atualize EMBEDDING_DIM, rode novamente 03_create_documents_table.py e recarregue os embeddings com 05_insert_embeddings.py.
Garanta que todo bind de vetor FLOAT32 use array.array("f", values). O tutorial usa este formato para vetores manuais, embeddings armazenados e embeddings de consulta.
Isso é esperado. Provedores de embedding podem atualizar modelos, e distâncias de ponto flutuante podem variar entre execuções.
Confirme que a tabela documents existe, que o schema vector_demo é o dono e que DOCUMENT_EMBEDDING_IDX não ficou de uma execução anterior incompleta.
Use oracledb.create_pool() para pool de conexões, faça benchmark com volumes realistas, revise segurança e gestão de segredos e ajuste índices conforme padrões reais de consulta.
Quando terminar o tutorial, pare e remova o container local.
Construímos um fluxo local de busca semântica com Oracle AI Vector Search, Oracle Database Free 26ai e Python.
Começamos com valores VECTOR(3, FLOAT32) escritos à mão, inserimos embeddings gerados por modelo com array.array("f", values), consultamos documents similares com VECTOR_DISTANCE(), comparamos a recuperação semântica com um predicado simples de frase exata e validamos um índice vetorial via USER_INDEXES.
Essa abordagem funciona bem quando embeddings devem ficar ao lado de dados relacionais e queremos armazenamento e busca visíveis em SQL sem adicionar um banco vetorial separado para o fluxo local.
O demo é pequeno de propósito: ensina os fundamentos, não escala de produção. Aplicativos maiores devem fazer benchmark com dados realistas, revisar segurança e privilégios, usar pool de conexões e validar escolhas de indexação sob padrões reais de consulta.
Depois, você pode aprofundar a implementação com estes recursos:
Principais cursos da DataCamp
Curso
Programa
Curso
blog
Moez Ali
14 min
blog
Tutorial
Moez Ali
10 min
Tutorial
Zoumana Keita
7 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Zoumana Keita
14 min