Kurs
Oracle SQL'ye Giriş
4 sa
18.5K
Bu eğitimde Oracle AI Vector Search, Python ve Oracle Database Free 26ai ile yerel bir anlamsal arama demosu oluşturacağız.
Önce mesafeyi gözle görebilmek için elle yazılmış üç boyutlu vektörlerle başlayacağız, ardından metin gömüleri üretecek ve bunları Oracle Database’ten SQL ile sorgulayacağız.
Bu eğitim, vektör aramasına yeni olan ve Docker, ortam değişkenleri, Python paketleri ve yerel veritabanı kurulumu konusunda rahat olan Python ve SQL geliştiricileri içindir.
Yapay zekâ destekli uygulamaların, yalnızca birebir kelimeleri değil, anlamı da anlayan bir aramaya ihtiyacı vardır. Bir destek uygulaması, dokümantasyon portalı veya iç bilgi aracı, en iyi eşleşen belge “yerel sütunlarda vektör gömülerini depolayın” dese bile “AI arama için veritabanı depolaması”nı bulabilmelidir.
Vektör gömüleri metni sayısal vektörler olarak temsil ederek bunu mümkün kılar. Oracle AI Vector Search bu vektörleri doğrudan Oracle Database içinde depolamamıza, SQL ile sorgulamamıza ve gömüleri ilişkisel uygulama verilerinin yanında tutmamıza olanak tanır.
Bu yerel iş akışı için ayrı bir vektör veritabanına ihtiyacımız yok.
Oracle Database Free 26ai’yi yerelde çalıştıracağız, Python’dan oracledb Thin modu ile bağlanacağız, önce manuel vektörleri, ardından OpenAI gömülerini depolayacağız, anlamsal arama çalıştıracağız, anlamsal getiriyi basit bir birebir ifade koşulu ile karşılaştıracağız ve USER_INDEXES üzerinden doğrulayacağımız bir vektör indeksi oluşturacağız.
Sonunda, gömüleri Oracle Database’te depolayan ve en benzer documents kayıtlarını yerelde getiren, Python ile çalışan bir anlamsal arama iş akışımız olacak.
Oracle AI Vector Search, vektör gömülerini depolamak, indekslemek ve sorgulamak için Oracle Database yeteneklerinden oluşur. Bir vektör gömüsü, metin, görseller veya diğer verilerin anlamını, bir veritabanının matematiksel olarak karşılaştırabileceği biçimde temsil eden sabit boyutlu sayı listeleridir.
Bir gömme modeli sayısal vektörleri üretir. Girdi olarak bir cümle, paragraf, görsel açıklaması veya kod parçası alır ve sabit boyutlu bir vektör döndürür.
Benzer girdiler birbirine yakın vektörler üretmeli, ilgisiz girdiler ise birbirinden daha uzak olmalıdır. Bu nedenle depolanan documents ve gelen sorgular için aynı gömme modelini kullanmalıyız; çünkü mesafeler yalnızca vektörler aynı koordinat sistemini paylaştığında anlamlıdır.
Bu eğitimde, matematiği inceleyebilmek için manuel vektörler bilerek küçük tutulmuştur. Gerçek metin gömüleri çok daha büyüktür; çünkü modelin, kelimeler, ifadeler ve konular arasındaki ince ilişkileri kodlayabilmek için yeterli boyuta ihtiyacı vardır.
Vektör araması satırları vektörler arası mesafeye göre sıralar. Öklidyen ve kosinüs mesafesi sorgularında daha küçük değerler daha yakın eşleşmeleri ifade eder. Bu eğitimde önce mesafe davranışını doğrudan görebilmek için küçük bir VECTOR(3, FLOAT32) sütunu kullanacağız, sonra metinden üretilmiş VECTOR(1536, FLOAT32) gömülerine geçeceğiz.
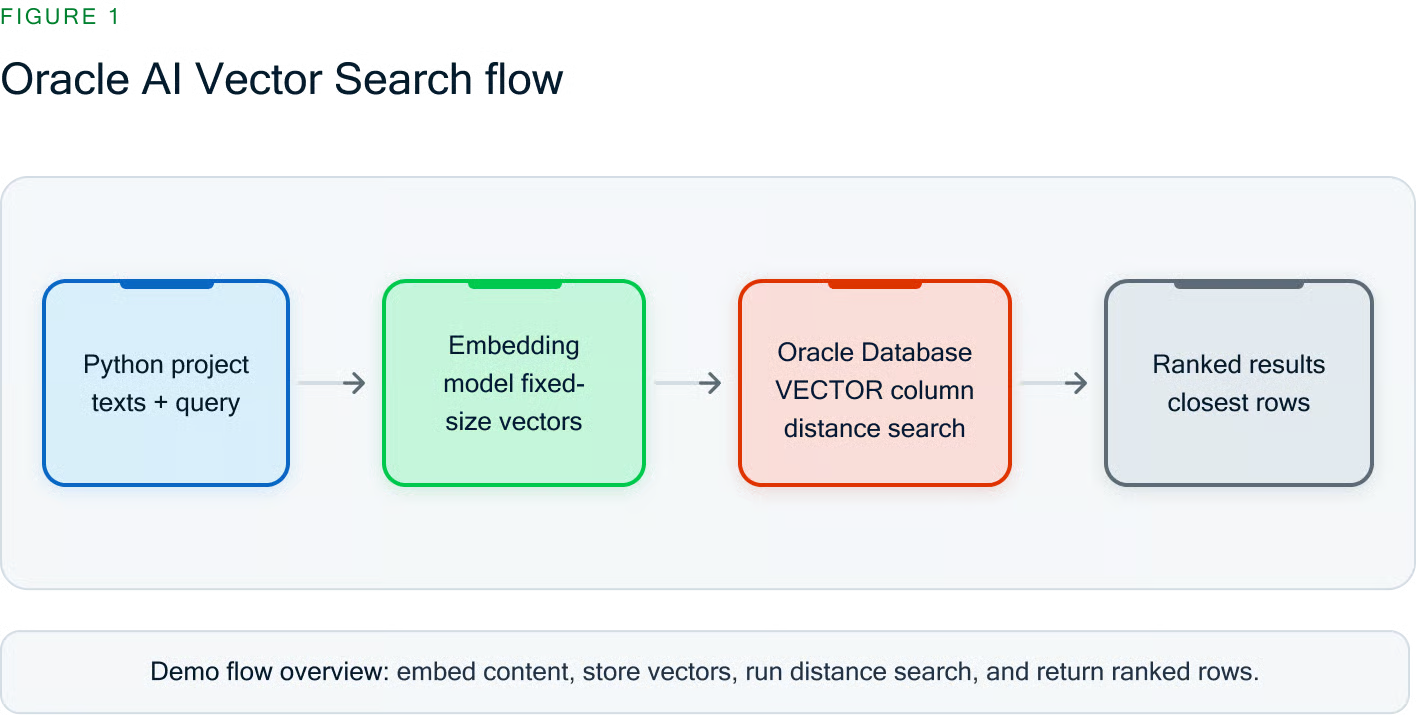
Şekil 1. Oracle AI Vector Search akışı
Oracle AI Vector Search gömüleri yerel bir VECTOR sütununda depolar ve sonuçları vektör mesafesine göre sıralar.
Gömülerin belge kimlikleri, başlıklar, içerikler, kullanıcılar, ürünler, talepler veya metaveri gibi ilişkisel uygulama verilerinin yanında yer alması gerektiğinde Oracle Database kullanışlıdır.
Bazı uygulamalar özel getirme iş yükleri için ayrı bir vektör veritabanı veya arama motoru kullanır, ancak bu eğitimin yerel anlamsal arama iş akışı için Oracle Database ihtiyaç duyduğumuz vektör depolama ve arama özelliklerini sağlar.
Demoda dört Oracle AI Vector Search özelliği kullanacağız: yerel vektör depolama, mesafe fonksiyonları, vektör indeksleri ve ilişkisel entegrasyon.
Oracle Database, açık boyutlar ve eleman biçimleriyle yerel VECTOR sütunlarını destekler. Demoda, manuel vektörler için VECTOR(3, FLOAT32) ve varsayılan text-embedding-3-small gömme modeli için VECTOR(1536, FLOAT32) kullanacağız.
Çalıştırılabilir örneklerde VECTOR_DISTANCE() kullanıyoruz; çünkü mesafe metriğini SQL içinde açık tutar.
Manuel vektör örneği için Öklidyen mesafe, metin gömüleri için ise kosinüs mesafesi kullanacağız.
Oracle Database kısaltılmış vektör mesafe operatörlerini ve nokta çarpımıyla ilgili mesafe davranışını da içerir, ancak bu eğitim çalıştırılabilir SQL’i açık VECTOR_DISTANCE() patikasında tutar.
Farklı mesafe metrikleri “yakınlık” hakkında biraz farklı sorulara yanıt verir.
Küçük bir eğitim için kosinüs mesafesi, yön odağı nedeniyle sıklıkla anlamsal benzerlikle iyi eşleştiğinden metin gömüleri için iyi bir varsayılandır.
Öklidyen mesafe, elle yazılmış vektörlerle görselleştirmesi daha kolaydır ve vektör büyüklüğü ya da normalize vektörlerin model tasarımının parçası olduğu bazı getirme sistemlerinde nokta-çarpımı tarzı karşılaştırmalar faydalıdır.
|
Metrek |
Karşılaştırdığı Şey |
Uygun Olduğu Durum |
Dikkat Edilecekler |
|
Kosinüs |
Vektör yönü |
Metin gömüleri ve anlamsal benzerlik |
Sonuçlar, aynı gömme modelinin ve tutarlı ön işlemenin kullanılmasına bağlıdır |
|
Öklidyen |
Doğrusal mesafe |
Küçük örnekler, geometri sezgisi, bazı sayısal özellik vektörleri |
Büyüklük mesafeyi etkiler, bu nedenle ölçekleme önemli olabilir |
|
Nokta çarpımı |
Yön ve büyüklük birlikte |
Normalize vektörler veya iç-çarpım puanlaması etrafında tasarlanmış iş akışları |
Puan yönü ve normalizasyon kuralları, sonuçları karşılaştırmadan önce anlaşılmalıdır |
Doğru sonuç ve küçük veri kümeleri için kesin vektör araması kullanışlıdır. Veri kümeleri büyüdükçe vektör indeksleri yaklaşık en yakın komşu arama iş akışlarını destekler.
Oracle AI Vector Search, sıklıkla HNSW tarzı arama ile ilişkilendirilen bellek içi komşu grafik indekslerini ve sıklıkla IVF tarzı bölümleme ile ilişkilendirilen komşu-bölümleri indekslerini içerir.
Bu yerel demoda ORGANIZATION NEIGHBOR PARTITIONS kullanıyor ve indeksi USER_INDEXES ile doğruluyoruz.
Yaklaşık indeksler, ölçekte daha hızlı getirme için tüm kapsamlı aramadan küçük bir miktar kesinliği takas eder.
Doğru indeks ailesi iş yüküne, veri hacmine, güncelleme desenine ve hatırlama hedeflerine bağlıdır.
Bu eğitim, yerel kurulumu basit tuttuğu ve eğitimi bir indeks ayarlama kılavuzuna dönüştürmeden somut bir indeks oluşturma adımı sunduğu için IVF tarzı komşu-bölümleri indeksini kullanır.
|
İndeks Ailesi |
Temel Fikir |
Güçlü Yanlar |
Takçlar |
Ne Zaman Kullanabiliriz |
|
IVF / komşu bölümleri |
Vektör uzayını böl, sonra olası bölümleri ara |
Basit zihinsel model, birçok toplu-yüklenen veri kümesi için pratik |
Hatırlama ve hız, bölümleme ve arama ayarlarına bağlıdır |
Büyüyen bir veri kümesi için doğrudan bir yaklaşık arama yolu istiyoruz |
|
HNSW / komşu grafiği |
Hızlı geçiş için yakın vektörleri bağlayan bir grafik oluştur |
Birçok en yakın komşu iş yükü için güçlü hatırlama ve gecikme profili |
Daha çok belleğe yöneliktir ve yapılandırma daha fazla önem taşıyabilir |
Düşük gecikmeli arama gerekir ve bellek ile ayar çabasına bütçe ayırabiliriz |
Bir vektör sütunu, sıradan ilişkisel sütunların yanında bulunabilir. documents tablomuz başlık, içerik ve gömüyü birlikte depolayacak; böylece SQL hem benzerlik puanını hem de özgün belge metnini döndürebilecek.
Tek bir yerel kurulum yolunu kullanacağız: Docker içinde Oracle Database Free 26ai, FREEPDB1 servisi ve özel bir vector_demo uygulama kullanıcısı.
Vektör araması kavramları erişilebilir olsa da, Docker, bir veritabanı şeması, Python paketleri, ortam değişkenleri ve bir gömme API anahtarı kullandığımız için kurulum orta düzeydedir.
Gerekenler:
Bu demo, yerel VECTOR sütunları, VECTOR_DISTANCE() ve CREATE VECTOR INDEX dahil burada kullanılan vektör özelliklerini içeren bir Oracle Database sürümü veya ortamı gerektirir.
Yerel yol, aşağıda gösterilen imaj etiketiyle Oracle Database Free 26ai kullanır ve DSN, FREEPDB1 takılabilir veritabanı servisini kullanır.
Manuel vektör adımları bir OpenAI API anahtarı gerektirmez. Anlamsal adımlar, örnek belge metnini ve sorgu metnini yapılandırılmış gömme sağlayıcısına gönderir; bu nedenle yalnızca örnek veya hassas olmayan metinler kullanacağız.
Bu eğitimde Oracle Database için güncel Python sürücüsü olan oracledb kullanılır. python-oracledb varsayılan olarak Thin modda çalışır, bu nedenle bu yerel demo Oracle İstemci kütüphanelerini gerektirmez. Thick mod, diğer Oracle Database dağıtımlarında faydalıdır; ancak burada oracledb.init_oracle_client() çağrısı yapmayacağız.
Oluşturacağımız betikler için bir proje dizini oluşturun.
Oracle Database Free 26ai’yi yerel konteyner imajıyla başlatın.
Konteyner günlüklerini kontrol edin ve veritabanı başlatmanın tamamlandığını bildirene kadar bekleyin.
FREEPDB1 bu yerel Oracle Database Free konteyner yolunda kullanılan takılabilir veritabanı servisidir. Python DSN’imiz localhost:1521/FREEPDB1 olacaktır.
SYS kullanıcısını yalnızca şema kurulum adımı için kullanın. sqlplus komutundaki parola, docker run komutundaki ORACLE_PWD değeridir; CREATE USER içindeki parola ise DB_PASSWORD olarak dışa aktaracağımız uygulama parolasıdır.
Kurulumu veritabanı konteynerinin içinde çalıştırın.
Bu, demo konteyneri için yerel geliştirme amaçlı bir kısayoldur. Tablolar kimlik sütunları kullandığı için CREATE SEQUENCE gereklidir.
Üretimde, ayrıcalıkları bir veritabanı yöneticisi ile gözden geçirir ve tam uygulama iş yüküsü için asgari ayrıcalığı uygularız.
Sanal bir ortam oluşturup etkinleştirin.
Demoda kullanılan Python paketlerini kurun.
Veritabanı kimlik bilgilerini ve gömme ayarlarını Python dosyalarına gömmek yerine ortam değişkenlerinde saklayın.
OPENAI_API_KEY yalnızca gömme ve anlamsal arama adımları için gereklidir. EMBEDDING_DIM, seçilen gömme modelinin döndürdüğü boyut sayısı ile eşleşmelidir.
Demoyu sekiz kontrol noktasında inşa edeceğiz. Her betik bir kavram ekler ve devam etmeden önce doğrulayabileceğimiz bir çıktı üretir.
Yalnızca veritabanı kontrol noktası 1–3. Adımlardan sonra tamamlanır. Bu noktada Oracle Database’e bağlanmış, manuel vektörleri depolamış, onları mesafeye göre sorgulamış ve anlamsal tabloyu oluşturmuş olacağız. OpenAI API anahtarı 4. adımda gerekli hale gelir.
Önce Python’un Oracle Database’e vector_demo uygulama kullanıcısı olarak bağlanabildiğini doğrulayacağız. Bu betik, ortamdan DB_USER, DB_PASSWORD ve DB_DSN değerlerini okur ve sürücü modunu ve veritabanı sürümünü yazdırır.
Aşağıdaki kodu 01_check_connection.py olarak kaydedin.
Bağlantı kontrolünü çalıştırın.
Çıktı, bağlantının çalıştığını ve sürücünün Thin modunda olduğunu doğrulamalıdır.
Artık yerel veritabanının, servis adının, kimlik bilgilerinin ve Python sürücüsünün, herhangi bir vektör tablosu oluşturmadan önce çalıştığını biliyoruz.
Gömme modellerini tanıtmadan önce, üzerinde düşünebileceğimiz üç küçük vektör depolayalım. array.array("f", values) çağrısı, python-oracledb tarafından bir VECTOR(..., FLOAT32) sütununa bağlanabilen 32 bit kayan noktalı bir dizi oluşturur.
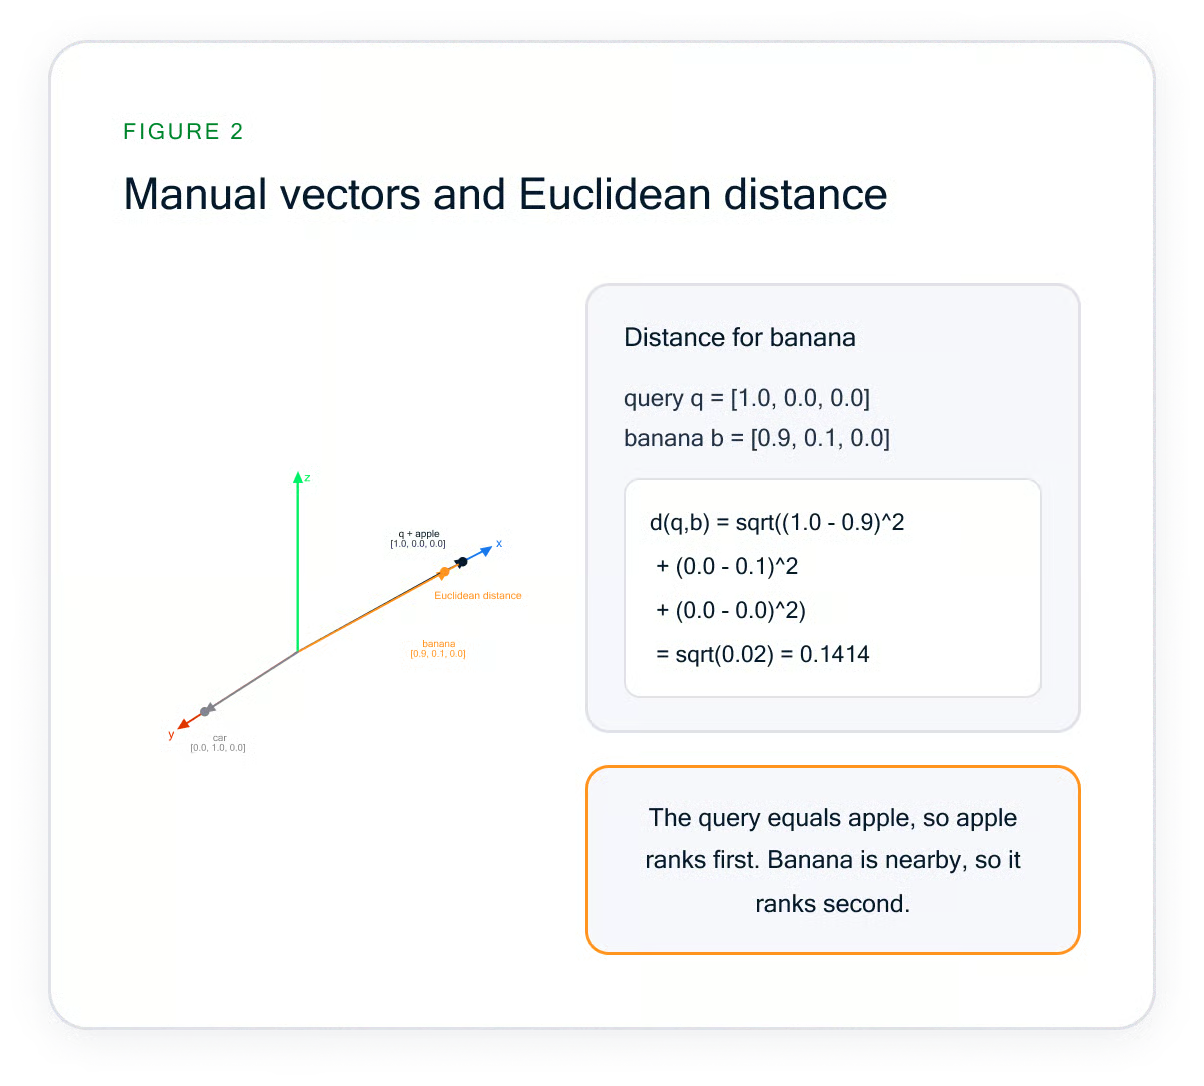
Şekil 2. Manuel vektörler ve Öklidyen mesafe.
Manuel örnek Öklidyen mesafeyi kullanır. Elma vektörü, sorgu vektörü ile eşleştiği için 0.0000 mesafesine sahiptir. Muz vektörü ikinci sırada yer alır; çünkü sqrt((1.0 - 0.9)^2 + (0.0 - 0.1)^2 + (0.0 - 0.0)^2) = 0.1414.
Aşağıdaki kodu 02_manual_vectors.py olarak kaydedin.
Manuel vektör betiğini çalıştırın.
Özdeş vektör, 0.0000 mesafesiyle ilk sırada görünür; yakın olan muz vektörü ikinci sırada yer alır.
Vektör aramasının temel fikri budur: satırlar, bir sorgu vektörüne olan matematiksel yakınlığa göre sıralanır. Gömme modelleri daha büyük vektörler üretecek, ancak veritabanı davranışı aynı kalacaktır.
Artık vektörlerin çalıştığını bildiğimize göre gerçek bir uygulama tarzı tablo oluşturacağız. Önemli ayrıntı, vektör sütunu boyutunun gömme modelinin çıktı boyutuyla eşleşmesi gerektiğidir.
Boyut, tablo sözleşmesinin bir parçasıdır. Bir gömme modeli 1.536 sayı döndürüyorsa, sütun VECTOR(1536, FLOAT32) olarak tanımlanmalıdır.
Daha sonra çıktı uzunluğu farklı olan bir modele geçersek, eklemelerin ve sorguların uyumlu vektörler kullanmaya devam etmesi için vektör sütununu yeniden oluşturmamız veya taşıma yapmamız gerekir.
DDL, vektör boyutunu normal bir SQL bağ değişkeni olarak bağlayamadığı için, betik EMBEDDING_DIM değerini CREATE TABLE ifadesinde kullanmadan önce tamsayıya çevirir.
Aşağıdaki kodu 03_create_documents_table.py olarak kaydedin.
Tablo oluşturma betiğini çalıştırın.
Çıktı, yapılandırılmış gömme modelini ve vektör boyutunu göstermelidir.
Veritabanı-yalnız bölümü tamamladık. Oracle Database yerelde vektörleri depolayıp karşılaştırabilir; şimdi el yazısı vektörleri metinden üretilmiş gömelerle değiştireceğiz.
Gömüleri eklemeden önce, gömme modelinden bir vektör isteyecek ve uzunluğunu doğrulayacağız. Bu, en yaygın vektör tablo hatasını önler: VECTOR sütunu boyutuyla eşleşmeyen bir vektör eklemek.
Bir gömme modeli yalnızca bir metin-sayılara dönüştürücü değildir; uygulamanın anlam uzayını tanımlar. Bu demodaki tüm belge ve sorgu gömüleri aynı modelden gelmelidir.
Tek bir model kullanmak, küçük bir mesafenin, şeklen benzer görünen ilgisiz iki vektörden ziyade benzer anlamı temsil etmesini sağlar. Model, vektör uzunluğunu da belirler; bu yüzden veri yüklemeden önce döndürülen boyutu kontrol ederiz.
Aşağıdaki kodu 04_check_embedding_dimension.py olarak kaydedin.
Boyut kontrolünü çalıştırın.
Varsayılan model ve boyut için çıktı şöyle görünmelidir.
Daha sonra farklı bir gömme modeli seçersek, EMBEDDING_MODEL değerini güncellemeli, EMBEDDING_DIM değerini dönen vektör uzunluğuna ayarlamalı ve documents tablosunu yeniden oluşturmalıyız.
Şimdi küçük, kendi içinde tutarlı bir veri kümesi için gömüler üretecek ve bunları Oracle Database’e ekleyeceğiz.
Her bir gömme, FLOAT32 vektör sütunuyla eşleşmesi için bağlamadan önce array.array("f", embedding) biçimine dönüştürülür.
Aşağıdaki kodu 05_insert_embeddings.py olarak kaydedin.
Ekleme betiğini çalıştırın.
Satır sayısı, satır içindeki yedi documents ile eşleşmelidir.
Artık Oracle Database’te metin ve gömüler birlikte depolanıyor. Alakasız gitar ve çorba ile ilgili documents girdileri dahil edildi; böylece arama sonuçlarında bariz yakın ve uzak eşleşmeler olacak.
Şimdi doğal dilli bir sorguyu gömecek ve depolanan belge gömeleriyle karşılaştıracağız. Bu betik, vektör büyüklüğünden ziyade yön odaklı olduğu için metin gömülerinde yaygın olan kosinüs mesafesini kullanır.
Anlamsal arama için, sorgu documents ile aynı gömme modelinden geçer. SQL’in İngilizce cümleyi doğrudan anlamasını istemiyoruz.
Cümlenin bir vektöre dönüştürülmesini gömme modelinden istiyoruz; ardından Oracle Database’ten depolanan vektörleri o sorgu vektörüne olan mesafelerine göre sıralamasını istiyoruz.
Aşağıdaki kodu 06_semantic_search.py olarak kaydedin.
Anlamsal arama betiğini çalıştırın.
Gömme modeli değiştiğinde tam sıralamalar ve mesafeler farklı olabilir. Ancak Oracle AI Vector Search, anlamsal arama, Python veritabanı kodu ve vektör indeksleme ile ilgili documents girdileri üst sıralarda yer almalıdır.
Bu eğitimdeki Öklidyen ve kosinüs mesafesi sorgularında daha küçük değerler daha yakın eşleşmeleri gösterir.
Nokta çarpımı, özellikle büyüklüğün veya normalize vektörlerin önemli olduğu birçok vektör arama iş akışında başka bir faydalı karşılaştırma yaklaşımıdır; ancak puan yönü ve normalizasyon dikkatli ele alınmalıdır.
Sonuç yorumunu basit tutmak için çalıştırılabilir kodu Öklidyen ve kosinüs mesafesi üzerinde tutacağız.
Gelecekteki bir uygulamada gömüleri kendimiz normalize edersek, depolanan belge gömelerini ve sorgu gömelerini tutarlı şekilde normalize etmemiz gerekir; aksi takdirde mesafeler ve sıralamalar değişebilir.
Anlamsal arama faydalıdır; çünkü belgenin aynı ifadeyi birebir içermesini gerektirmez.
Anlamsal sorguyu basit bir birebir ifade koşulu ile karşılaştıralım.
Bu bir tam metin arama motoru demosu değildir; bu, birebir eşleşme ile anlam temelli sıralama arasındaki farkı görünür kılan küçük bir SQL karşılaştırmasıdır.
Aşağıdaki kodu 07_semantic_vs_keyword.py olarak kaydedin.
Karşılaştırma betiğini çalıştırın.
Anlamsal arama, birebir anahtar ifade bulunmasa bile ilgili documents girdilerini döndürmelidir.
Geleneksel SQL koşulları hâlâ filtreler, birleştirmeler, izinler ve birebir eşleşmeler için önemlidir. Vektör arama, bir uygulamanın anlamsal getirmeye ihtiyaç duyduğunda ilişkisel verilerle birleştirebileceğimiz anlam temelli bir sıralama sinyali ekler.
Son olarak bir vektör indeksi oluşturacak ve Oracle Database’in onu demo şemasına ait geçerli bir indeks olarak raporladığını doğrulayacağız.
Bu adım indeks oluşturma iş akışını gösterir; küçücük veri kümemiz anlamlı performans sonuçları çıkarmak için yeterli değildir.
İndeks olmadan Oracle Database, sorgu vektörünü her depolanan vektörle birebir karşılaştırabilir. Bu yaklaşım küçük veri kümeleri için uygundur ve öğrenirken kullanışlıdır.
Daha büyük veri kümelerinde, yaklaşık vektör indeksleri arama alanını azaltarak sorguların hızlı dönmesini sağlarken yakın komşuları bulmaya devam eder.
İndeks ailesini, veri boyutu, gecikme hedefleri, hatırlama gereksinimleri, bellek bütçesi ve vektörlerin değişim sıklığını göz önüne alarak seçin.
Sondaki sorgu, indeks oluşturulduktan sonra da anlamsal aramanın sonuç döndürdüğünü doğrular.
Bu eğitimde, indeks oluşturmayı sorgu planı davranışıyla değil şema metaverisiyle doğruladığımız için burada EXPLAIN PLAN veya DBMS_XPLAN kullanmayacağız.
Aşağıdaki kodu 08_create_vector_index.py olarak kaydedin.
Indeks betiğini çalıştırın.
Çıktı DOCUMENT_EMBEDDING_IDX için bir satır içermeli, INDEX_TYPE VECTOR, STATUS ise VALID olmalıdır.
USER_INDEXES, indeksin var olduğunu ve geçerli olduğunu doğrular. Belirli bir sorgunun indeksi kullandığını kanıtlamaz ve bu eğitim doğrulama yöntemi olarak yürütme planı çıktısını kullanmaz.
Üretim iş yükülerinde, gerçekçi veri hacmi, sorgu desenleri ve performans hedefleriyle test yaparız.
Başlatma tamamlanana kadar bekleyin, ardından docker logs oracle-free-26ai-vector komutunu tekrar çalıştırın. Python’un localhost:1521/FREEPDB1 adresine bağlanabilmesi için veritabanının hazır olması gerekir.
Çakışan yerel servisi durdurun veya Docker port eşlemesini değiştirin. Ana makine portu değişirse DB_DSN değerini güncelleyin.
DB_USER, DB_PASSWORD ve DB_DSN değerlerini doğrulayın. DSN içinde FREEPDB1 kullanın ve uygulama betiklerini vector_demo olarak bağlayın; SYS, SYSTEM veya PDBADMIN olarak değil.
Adımlar 1-3 yalnızca veritabanıyla ilgilidir. Adımlar 4-8 OPENAI_API_KEY gerektirir ve API maliyetlerine yol açabilir.
04_check_embedding_dimension.py betiğini çalıştırın, EMBEDDING_DIM değerini güncelleyin, 03_create_documents_table.py betiğini yeniden çalıştırın ve gömüleri 05_insert_embeddings.py ile yeniden yükleyin.
Her FLOAT32 vektör bağlamanın array.array("f", values) kullandığından emin olun. Eğitim, bunu manuel vektörler, depolanan belge gömeleri ve sorgu gömeleri için kullanır.
Bu beklenir. Gömme sağlayıcıları modelleri güncelleyebilir ve kayan nokta mesafeleri çalıştırmalar arasında değişebilir.
documents tablosunun var olduğunu, vector_demo şemasının ona sahip olduğunu ve DOCUMENT_EMBEDDING_IDX öğesinin yarım kalmış bir çalıştırmadan kalmadığını doğrulayın.
Bağlantı havuzu için oracledb.create_pool() kullanın, gerçekçi veri hacimlerini kıyaslayın, güvenlik ve gizli yönetimini gözden geçirin ve indeksleri gerçek sorgu desenlerine göre ayarlayın.
Eğitim tamamlandığında yerel konteyneri durdurup kaldırın.
Oracle AI Vector Search, Oracle Database Free 26ai ve Python ile yerel bir anlamsal arama iş akışı oluşturduk.
El yazısı VECTOR(3, FLOAT32) değerleriyle başladık, array.array("f", values) ile model tarafından üretilen gömüleri ekledik, VECTOR_DISTANCE() ile benzer documents girdilerini sorguladık, anlamsal getiriyi basit bir birebir ifade koşuluyla karşılaştırdık ve bir vektör indeksini USER_INDEXES üzerinden doğruladık.
Bu yaklaşım, gömülerin ilişkisel verilerin yanında bulunması ve yerel iş akışı için ayrı bir vektör veritabanı eklemeden SQL’de görünür depolama ve arama istememiz durumunda iyi uyum sağlar.
Demo kasten küçük tutulmuştur: ilke yapıtaşlarını öğretir, üretim ölçeğini değil. Daha büyük uygulamalar gerçekçi verilerle kıyaslamalı, güvenlik ve ayrıcalıkları gözden geçirmeli, bağlantı havuzlaması kullanmalı ve indeksleme tercihlerini gerçek sorgu desenleri altında doğrulamalıdır.
Sonrasında uygulamayı şu kaynaklarla derinleştirebiliriz:
En İyi DataCamp Kursları
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




