Vai al contenuto principale

Tutorial Oracle AI Vector Search: archivia e interroga embedding con Python

Questo tutorial introduce Oracle AI Vector Search, ne spiega le funzionalità principali e guida un progetto pratico locale. Copre anche i requisiti di setup, la ricerca semantica, l’indicizzazione vettoriale e i passaggi di troubleshooting più comuni.
Aggiornato 29 set 2026  · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

In questo tutorial, costruiremo una demo locale di ricerca semantica con Oracle AI Vector Search, Python e Oracle Database Free 26ai. 

Partiremo con vettori tridimensionali scritti a mano per rendere visibile il calcolo della distanza, poi genereremo embedding testuali e li interrogheremo da Oracle Database con SQL. 

Questo tutorial è per sviluppatori Python e SQL nuovi alla vector search e a proprio agio con Docker, variabili d'ambiente, pacchetti Python e setup di database locali.

Le applicazioni basate sull'AI hanno bisogno di una ricerca che capisca il significato, non solo le parole esatte. Un'app di supporto, un portale di documentazione o uno strumento di knowledge interno dovrebbero saper trovare “archiviazione database per ricerca AI” anche quando il documento migliore dice “archivia embedding vettoriali in colonne native”.

I vettori embedding rendono tutto ciò possibile rappresentando il testo come vettori numerici. Oracle AI Vector Search ci permette di archiviare questi vettori direttamente in Oracle Database, interrogarli con SQL e tenere gli embedding accanto ai dati applicativi relazionali. 

Per questo flusso di lavoro locale, non serve un database vettoriale separato.

Eseguiremo Oracle Database Free 26ai in locale, ci connetteremo da Python con la modalità Thin di oracledb, archivieremo prima i vettori manuali, poi gli embedding OpenAI, eseguiremo la ricerca semantica, confronteremo il recupero semantico con un semplice predicato di frase esatta e creeremo un indice vettoriale validato tramite USER_INDEXES.

Alla fine, avremo un flusso di lavoro di ricerca semantica in Python funzionante che archivia gli embedding in Oracle Database e recupera i documents più simili in locale.

Che cos'è Oracle AI Vector Search?

Oracle AI Vector Search è un insieme di funzionalità di Oracle Database per archiviare, indicizzare e interrogare embedding vettoriali. Un embedding vettoriale è un elenco a dimensione fissa di numeri che rappresenta il significato di testo, immagini o altri dati in una forma che un database può confrontare matematicamente.

Un modello di embedding crea i vettori numerici. Prende in input, ad esempio, una frase, un paragrafo, la descrizione di un'immagine o uno snippet di codice e restituisce un vettore con un numero fisso di dimensioni.

Input simili dovrebbero produrre vettori vicini tra loro, mentre input non correlati dovrebbero risultare più distanti. Dobbiamo quindi usare lo stesso modello di embedding per i documents archiviati e per le query in arrivo, perché le distanze hanno senso solo quando i vettori condividono lo stesso sistema di coordinate.

In questo tutorial, i vettori manuali sono volutamente piccoli così possiamo ispezionarne la matematica. Gli embedding testuali reali sono molto più grandi perché il modello ha bisogno di abbastanza dimensioni per codificare relazioni più sottili tra parole, frasi e argomenti.

La vector search ordina le righe in base alla distanza tra vettori. Per le query a distanza euclidea e coseno, distanze più piccole significano corrispondenze più vicine. In questo tutorial, inizieremo con una piccola colonna VECTOR(3, FLOAT32) per vedere direttamente il comportamento della distanza, poi passeremo a embedding VECTOR(1536, FLOAT32) generati dal testo.
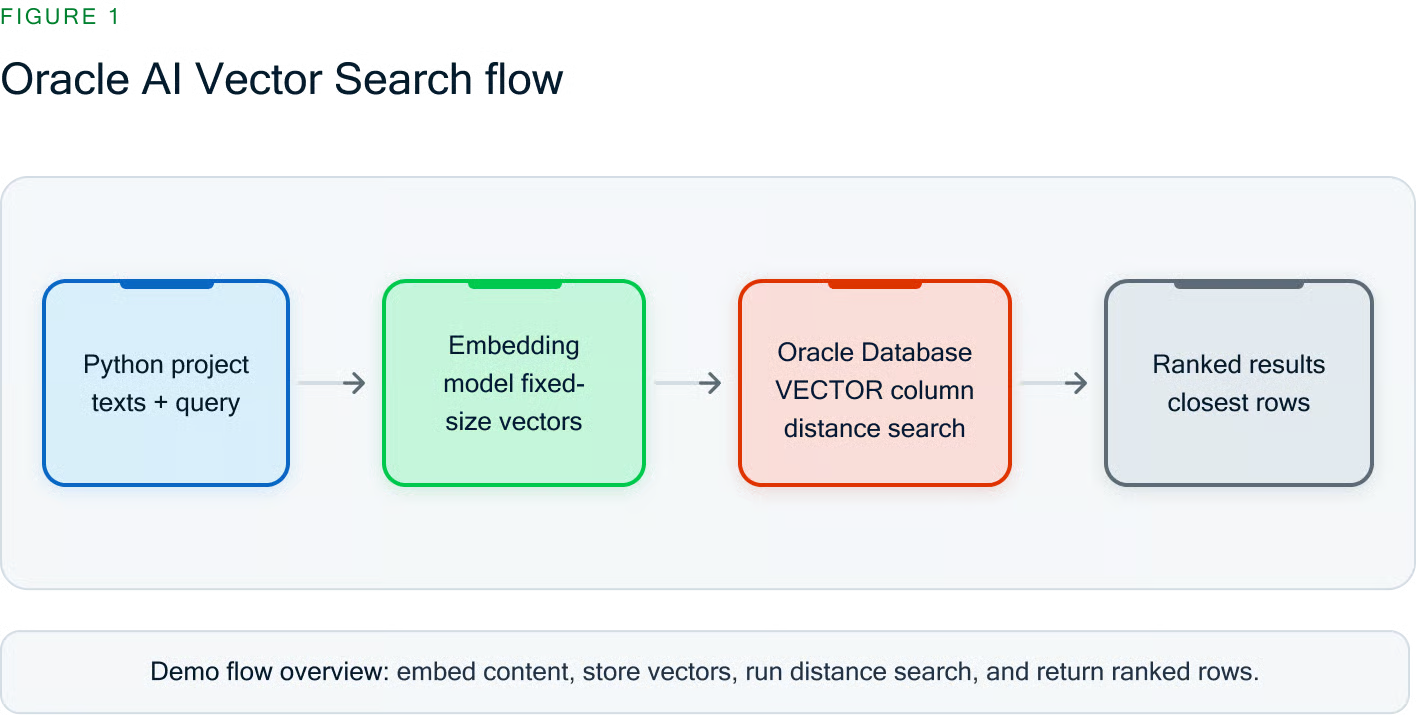
Flusso Oracle AI Vector Search

Figura 1. Flusso Oracle AI Vector Search

Oracle AI Vector Search archivia gli embedding in una colonna VECTOR nativa e classifica i risultati in base alla distanza vettoriale.

Oracle Database è utile quando gli embedding devono stare accanto a dati applicativi relazionali come ID documento, titoli, contenuti, utenti, prodotti, ticket o metadati. 

Alcune applicazioni usano un database vettoriale o un motore di ricerca separato per carichi di lavoro di retrieval specializzati, ma per il flusso di lavoro locale di ricerca semantica di questo tutorial, Oracle Database fornisce le funzionalità di archiviazione e ricerca vettoriale di cui abbiamo bisogno.

Funzionalità chiave di Oracle AI Vector Search

Useremo quattro funzionalità di Oracle AI Vector Search nella demo: archiviazione vettoriale nativa, funzioni di distanza, indici vettoriali e integrazione relazionale.

Tipo di dato vettoriale nativo

Oracle Database supporta colonne VECTOR native con dimensioni esplicite e formati degli elementi. Nella demo useremo VECTOR(3, FLOAT32) per i vettori manuali e VECTOR(1536, FLOAT32) per il modello di embedding predefinito text-embedding-3-small.

Funzioni e operatori di distanza

Gli esempi eseguibili usano VECTOR_DISTANCE() perché mantiene esplicita la metrica di distanza in SQL. 

Useremo la distanza euclidea per l'esempio con vettori manuali e la distanza coseno per gli embedding testuali. 

Oracle Database include anche operatori abbreviati di distanza vettoriale e comportamenti legati al prodotto scalare, ma questo tutorial mantiene l'SQL eseguibile sul percorso esplicito VECTOR_DISTANCE().

Metriche di distanza diverse rispondono a domande leggermente diverse sulla “vicinanza”. 

Per un piccolo tutorial, la distanza coseno è una buona scelta predefinita per gli embedding testuali perché si concentra sulla direzione, che spesso si mappa bene sulla similarità semantica. 

La distanza euclidea è più facile da visualizzare con vettori scritti a mano, e confronti in stile prodotto scalare sono utili in alcuni sistemi di retrieval quando la magnitudine o la normalizzazione dei vettori fanno parte del design del modello.

Metrica

Cosa confronta

Buon utilizzo

Attenzione a

Coseno

Direzione del vettore

Embedding testuali e similarità semantica

I risultati dipendono dall'uso dello stesso modello di embedding e da un preprocessing coerente

Euclidea

Distanza in linea retta

Piccoli esempi, intuizione geometrica, alcuni vettori di feature numeriche

La magnitudine influisce sulla distanza, quindi lo scaling può contare

Prodotto scalare

Direzione e magnitudine insieme

Workflow basati su vettori normalizzati o scoring a prodotto interno

Direzione del punteggio e regole di normalizzazione vanno comprese prima di confrontare i risultati

Indici vettoriali

La ricerca vettoriale esatta è utile per correttezza e piccoli dataset. Con la crescita dei dataset, gli indici vettoriali supportano workflow di approximate nearest neighbor.

Oracle AI Vector Search include indici in-memory a grafo di vicinato, spesso associati alla ricerca in stile HNSW, e indici a partizioni di vicinato, spesso associati al partizionamento in stile IVF. 

In questa demo locale usiamo ORGANIZATION NEIGHBOR PARTITIONS e validiamo l'indice con USER_INDEXES.

Gli indici approssimati scambiano una piccola parte della certezza della ricerca esaustiva per un recupero più veloce su larga scala. 

La famiglia di indici giusta dipende dal carico di lavoro, volume di dati, pattern di aggiornamento e obiettivo di recall.

Questo tutorial usa un indice a partizioni di vicinato in stile IVF perché mantiene il setup locale semplice e fornisce un passaggio concreto di creazione dell'indice senza trasformare il tutorial in una guida al tuning degli indici.

Famiglia di indici

Idea di base

Punti di forza

Trade-off

Quando potremmo usarla

IVF / neighbor partitions

Partizionare lo spazio vettoriale, poi cercare nelle partizioni probabili

Modello mentale semplice, pratico per molti dataset caricati in batch

Recall e velocità dipendono da partizionamento e impostazioni di ricerca

Vogliamo un percorso semplice di ricerca approssimata per un dataset in crescita

HNSW / grafo di vicinato

Costruire un grafo che collega vettori vicini per una traversata rapida

Ottimo profilo di recall e latenza per molti workload di nearest neighbor

Più orientato alla memoria, e la configurazione può contare di più

Serve ricerca a bassa latenza e possiamo dedicare memoria e sforzi di tuning

Integrazione con query relazionali

Una colonna vettoriale può convivere accanto a colonne relazionali ordinarie. La nostra tabella documents memorizzerà insieme titolo, contenuto ed embedding, così SQL può restituire sia lo score di similarità sia il testo originale del documento.

Come iniziare con Oracle AI Vector Search

Useremo un unico percorso di setup locale: Oracle Database Free 26ai in Docker, il servizio FREEPDB1 e un utente applicativo dedicato vector_demo. 

I concetti di vector search sono accessibili, ma il setup è intermedio perché usiamo Docker, uno schema database, pacchetti Python, variabili d'ambiente e una chiave API per gli embedding.

Prerequisiti

Ci serviranno:

  • Docker Desktop o Docker Engine.
  • Accesso a Oracle Container Registry.
  • Porte locali 1521 e 5500 disponibili.
  • Python 3.10 o successivo.
  • Conoscenze di base di Python e SQL.
  • Familiarità di base con Docker e variabili d'ambiente.
  • Una chiave API OpenAI per i passaggi con gli embedding.

Questa demo richiede una versione o un ambiente Oracle Database che includa le funzionalità vettoriali usate qui, incluse le colonne VECTOR native, VECTOR_DISTANCE() e CREATE VECTOR INDEX. 

Il percorso locale usa Oracle Database Free 26ai con il tag dell'immagine mostrato sotto, e il DSN usa il servizio del database pluggable FREEPDB1.

I passaggi con i vettori manuali non richiedono una chiave API OpenAI. I passaggi semantici inviano il testo campione del documento e il testo della query al provider di embedding configurato, quindi useremo solo testo campione o non sensibile.

Questo tutorial usa oracledb, l'attuale driver Python per Oracle Database. python-oracledb gira in modalità Thin per impostazione predefinita, quindi questa demo locale non richiede le librerie Oracle Client. La modalità Thick è utile in altri deployment Oracle Database, ma qui non chiameremo oracledb.init_oracle_client().

Avvia Oracle Database Free 26ai in locale

Crea una directory di progetto per gli script che costruiremo.

mkdir oracle-ai-vector-search-python
 cd oracle-ai-vector-search-python

Avvia Oracle Database Free 26ai con l'immagine del container locale.

docker run --name oracle-free-26ai-vector \
   --detach \
   --publish 1521:1521 \
   --publish 5500:5500 \
   --shm-size=1g \
   --env ORACLE_PWD="replace-with-a-strong-password" \
   container-registry.oracle.com/database/free:23.26.1.0-lite-amd64

Controlla i log del container e attendi finché il database non segnala che l'avvio è completo.

docker logs oracle-free-26ai-vector

FREEPDB1 è il servizio del database pluggable usato da questo percorso con Oracle Database Free in container locale. Il nostro DSN Python sarà localhost:1521/FREEPDB1.

Crea lo schema vector_demo in FREEPDB1

Usa SYS solo per il passaggio di setup dello schema. La password nel comando sqlplus è il valore ORACLE_PWD del comando docker run; la password in CREATE USER è la password dell'applicazione che esporteremo come DB_PASSWORD.

Esegui il setup all'interno del container del database.

# Create the application user and grant the privileges needed for the demo.
 docker exec -i oracle-free-26ai-vector \
   sqlplus -s 'sys/"replace-with-oracle-pwd"@FREEPDB1 as sysdba' <<'SQL'
 WHENEVER SQLERROR EXIT SQL.SQLCODE

 CREATE USER vector_demo IDENTIFIED BY "replace-with-vector-demo-password";

 GRANT CREATE SESSION, CREATE TABLE, CREATE SEQUENCE, UNLIMITED TABLESPACE TO vector_demo;

 EXIT
 SQL

Questa è una scorciatoia di sviluppo locale per il container della demo. CREATE SEQUENCE è necessario perché le tabelle usano colonne identity. 

In produzione, rivedremmo i privilegi con un amministratore del database e applicheremmo il principio del minimo privilegio per l'esatto carico applicativo.

Installa le dipendenze Python

Crea e attiva un virtual environment.

python -m venv .venv
 source .venv/bin/activate
 python -m pip install --upgrade pip

Installa i pacchetti Python usati dalla demo.

python -m pip install oracledb openai

Imposta le variabili d'ambiente

Archivia le credenziali del database e le impostazioni per gli embedding in variabili d'ambiente invece di inserirle in hard-code nei file Python.

export DB_USER="vector_demo"
 export DB_PASSWORD="replace-with-vector-demo-password"
 export DB_DSN="localhost:1521/FREEPDB1"
 export OPENAI_API_KEY="replace-with-your-api-key"
 export EMBEDDING_MODEL="text-embedding-3-small"
 export EMBEDDING_DIM="1536"

OPENAI_API_KEY è richiesta solo per i passaggi di embedding e ricerca semantica. EMBEDDING_DIM deve corrispondere al numero di dimensioni restituite dal modello di embedding selezionato.

Progetto demo Oracle AI Vector Search

Costruiremo la demo in otto checkpoint. Ogni script aggiunge un concetto e produce output che possiamo verificare prima di proseguire.

Il checkpoint solo-database è completo dopo i Passi 1–3. A quel punto ci saremo connessi a Oracle Database, avremo archiviato vettori manuali, li avremo interrogati per distanza e creato la tabella semantica. La chiave API OpenAI diventa necessaria al Passo 4.

Passo 1: Connettiti al database locale

Per prima cosa verificheremo che Python possa connettersi a Oracle Database come utente applicativo vector_demo. Questo script legge DB_USER, DB_PASSWORD e DB_DSN dall'ambiente e stampa la modalità del driver e la versione del database.

Crea lo script

Salva il seguente codice come 01_check_connection.py.

import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	# Load required database settings from environment variables.
 	user = required_env("DB_USER")
     password = required_env("DB_PASSWORD")
 	dsn = required_env("DB_DSN")

 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Open a Thin-mode connection with the application user.
 	with oracledb.connect(user=user, password=password, dsn=dsn) as connection:
         mode = "thin" if oracledb.is_thin_mode() else "thick"
         print("Connected to Oracle Database.")
         print(f"Driver mode: {mode}")
         print(f"Database version: {connection.version}")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui il controllo della connessione.

python 01_check_connection.py

Output atteso

L'output dovrebbe confermare che la connessione funziona e che il driver è in modalità Thin.

Connected to Oracle Database.
 Driver mode: thin
 Database version: 23.26.1.0.0

Ora sappiamo che il database locale, il nome del servizio, le credenziali e il driver Python funzionano prima di creare qualsiasi tabella vettoriale.

Passo 2: Fai esperienza con vettori manuali

Prima di introdurre i modelli di embedding, archivieremo tre piccoli vettori su cui possiamo ragionare. La chiamata array.array("f", values) crea un array a virgola mobile a 32 bit che python-oracledb può associare a una colonna VECTOR(..., FLOAT32).
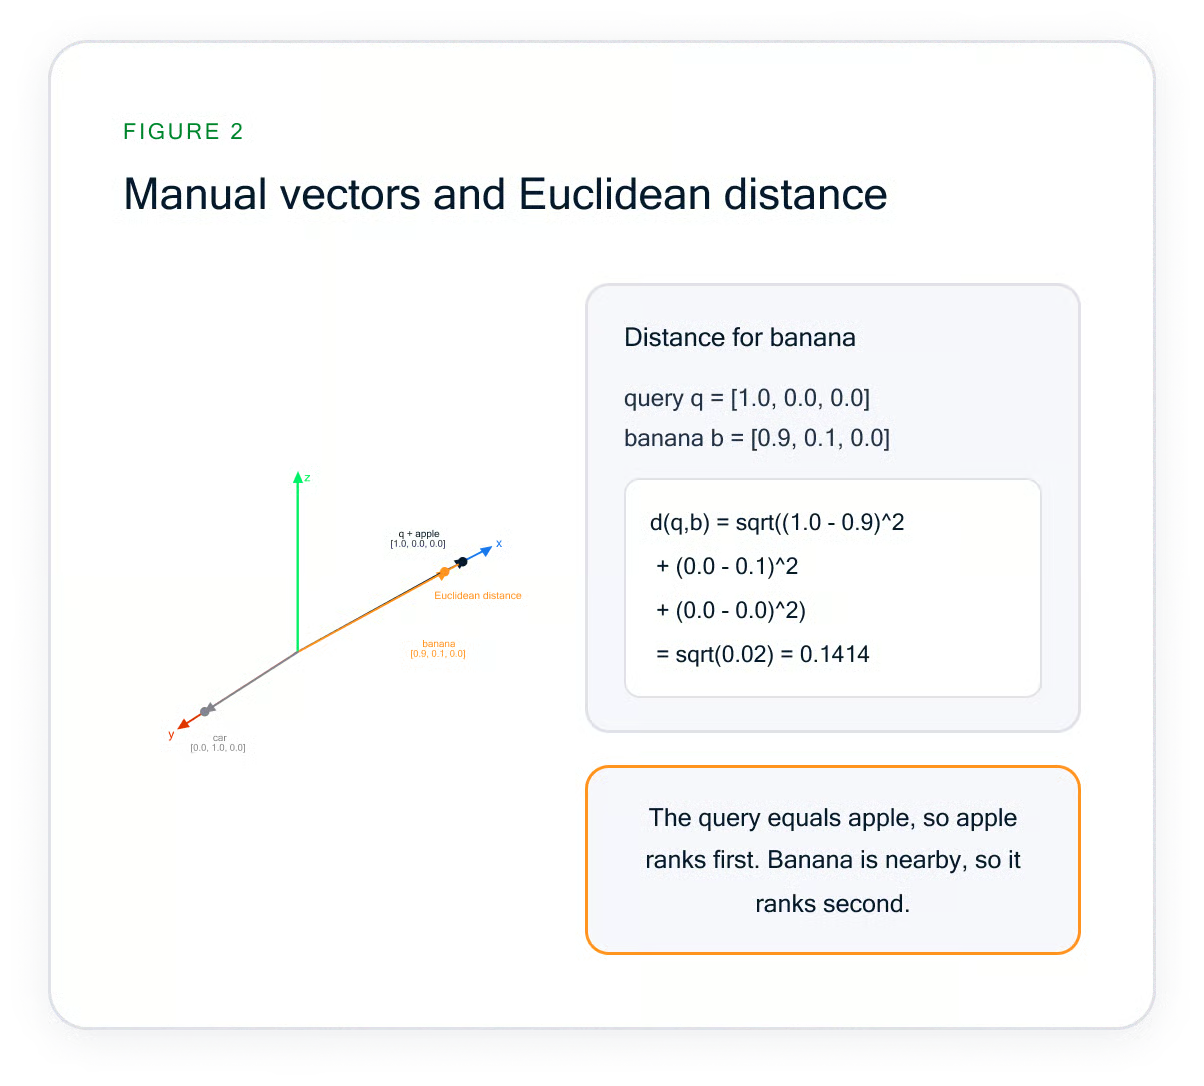
Vettori tridimensionali apple, banana e car che mostrano la distanza euclidea dal vettore di query apple.

Figura 2. Vettori manuali e distanza euclidea.

L'esempio manuale usa la distanza euclidea. Il vettore apple ha distanza 0,0000 perché coincide con il vettore di query. Il vettore banana è secondo perché sqrt((1.0 - 0.9)^2 + (0.0 - 0.1)^2 + (0.0 - 0.0)^2) = 0,1414.

Crea lo script

Salva il seguente codice come 02_manual_vectors.py.

import array
 import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Define three small vectors so the distance calculation is easy to inspect.
 	rows = [
         ("apple", array.array("f", [1.0, 0.0, 0.0])),
         ("banana", array.array("f", [0.9, 0.1, 0.0])),
         ("car", array.array("f", [0.0, 1.0, 0.0])),
 	]

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Recreate the table so the script can be run repeatedly.
             cursor.execute(
                 """
                 BEGIN
                 	EXECUTE IMMEDIATE 'DROP TABLE manual_vectors PURGE';
                 EXCEPTION
                 	WHEN OTHERS THEN
                     	IF SQLCODE <> -942 THEN
                         	RAISE;
                     	END IF;
                 END;
                 """
             )
             cursor.execute(
                 """
                 CREATE TABLE manual_vectors (
                 	id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
                 	label VARCHAR2(100),
                 	embedding VECTOR(3, FLOAT32)
                 )
                 """
             )
             # Bind each vector as a 32-bit floating-point array.
             cursor.executemany(
                 """
                 INSERT INTO manual_vectors (label, embedding)
                 VALUES (:1, :2)
                 """,
                 rows,
             )
             connection.commit()

             # Rank rows by Euclidean distance from the query vector.
             cursor.execute(
                 """
                 SELECT label,
                    	VECTOR_DISTANCE(
                        	embedding,
                        	:query_vector,
                        	EUCLIDEAN
                    	) AS distance
                 FROM manual_vectors
                 ORDER BY distance
                 FETCH EXACT FIRST 2 ROWS ONLY
                 """,
                 query_vector=array.array("f", [1.0, 0.0, 0.0]),
             )

             print("Created manual_vectors.")
             print("Inserted 3 manual vectors.")
             print("\nNearest manual vectors:")
             for rank, (label, distance) in enumerate(cursor, start=1):
                 print(f"{rank}. {label:<6} distance={float(distance):.4f}")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui lo script dei vettori manuali.

python 02_manual_vectors.py

Output atteso

Il vettore identico appare per primo con distanza 0,0000, e il vettore banana vicino appare secondo.

Created manual_vectors.
 Inserted 3 manual vectors.

 Nearest manual vectors:
 1. apple  distance=0.0000
 2. banana distance=0.1414

Questa è l'idea alla base della vector search: le righe vengono classificate per vicinanza matematica a un vettore di query. I modelli di embedding genereranno vettori più grandi, ma il comportamento del database è lo stesso.

Passo 3: Crea la tabella dei documenti semantici

Ora che sappiamo che i vettori funzionano, creeremo una vera tabella in stile applicativo. Il dettaglio importante è che la dimensione della colonna vettoriale deve corrispondere alla dimensione in uscita del modello di embedding.

La dimensione fa parte del contratto della tabella. Se un modello di embedding restituisce 1.536 numeri, la colonna deve essere dichiarata come VECTOR(1536, FLOAT32). 

Se in seguito passiamo a un modello con una lunghezza di output diversa, dobbiamo ricreare o migrare la colonna vettoriale affinché insert e query continuino a usare vettori compatibili.

Poiché il DDL non può associare la dimensione del vettore come una normale bind variable SQL, lo script converte EMBEDDING_DIM in intero prima di usarla nella CREATE TABLE.

Crea lo script

Salva il seguente codice come 03_create_documents_table.py.

import os

 import oracledb

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         dimension = int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc

 	if dimension <= 0:
         raise SystemExit("EMBEDDING_DIM must be a positive integer.")

 	return dimension


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

 	# Validate the configured model name and vector dimension.
     model_name = required_env("EMBEDDING_MODEL")
     dimension = configured_dimension()

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Recreate the documents table so the script is repeatable.
             cursor.execute(
                 """
                 BEGIN
                 	EXECUTE IMMEDIATE 'DROP TABLE documents PURGE';
                 EXCEPTION
                 	WHEN OTHERS THEN
                     	IF SQLCODE <> -942 THEN
                         	RAISE;
                     	END IF;
                 END;
                 """
             )
             cursor.execute(
                 f"""
                 CREATE TABLE documents (
                 	id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
                 	title VARCHAR2(200) NOT NULL,
                 	content VARCHAR2(1000) NOT NULL,
                 	embedding VECTOR({dimension}, FLOAT32)
                 )
                 """
             )

     print(f"Embedding model: {model_name}")
     print(f"Embedding dimension: {dimension}")
     print("Recreated documents table.")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui lo script di creazione della tabella.

python 03_create_documents_table.py

Output atteso

L'output dovrebbe mostrare il modello di embedding configurato e la dimensione del vettore.

Embedding model: text-embedding-3-small
 Embedding dimension: 1536
 Recreated documents table.

Abbiamo completato la parte solo database. Oracle Database può archiviare e confrontare vettori in locale; ora sostituiremo i vettori scritti a mano con embedding generati dal testo.

Passo 4: Verifica la dimensione del modello di embedding

Prima di inserire gli embedding, chiederemo al modello di embedding un vettore e ne verificheremo la lunghezza. Questo previene l'errore più comune nelle tabelle vettoriali: inserire un vettore la cui lunghezza non corrisponde alla dimensione della colonna VECTOR.

Un modello di embedding non è solo un convertitore testo-numeri; definisce lo spazio di significato per l'applicazione. Tutti gli embedding di documenti e query in questa demo devono provenire dallo stesso modello.

Usare un unico modello garantisce che una distanza piccola rappresenti un significato simile, piuttosto che due vettori non correlati che casualmente hanno forme simili. Il modello determina anche la lunghezza del vettore, motivo per cui controlliamo la dimensione restituita prima di caricare i dati.

Crea lo script

Salva il seguente codice come 04_check_embedding_dimension.py.

import os

 from openai import OpenAI


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         return int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc


 def main():
     required_env("OPENAI_API_KEY")

     model_name = required_env("EMBEDDING_MODEL")
     expected_dimension = configured_dimension()

 	# Request one embedding to confirm the model output dimension.
 	client = OpenAI()
     response = client.embeddings.create(
         model=model_name,
         input="Oracle AI Vector Search dimension check",
 	)

     returned_dimension = len(response.data[0].embedding)

     print(f"Embedding model: {model_name}")
     print(f"Returned embedding length: {returned_dimension}")
     print(f"Configured EMBEDDING_DIM: {expected_dimension}")

 	# Stop before loading data if the table dimension is incompatible.
 	if returned_dimension != expected_dimension:
         raise SystemExit(
             "Dimension check failed. Update EMBEDDING_DIM, rerun "
             "03_create_documents_table.py, and try again."
     	)

     print("Dimension check passed.")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui il controllo della dimensione.

python 04_check_embedding_dimension.py

Output atteso

Per il modello e la dimensione predefiniti, l'output dovrebbe essere simile a questo.

Embedding model: text-embedding-3-small
 Returned embedding length: 1536
 Configured EMBEDDING_DIM: 1536
 Dimension check passed.

Se in futuro scegliamo un modello di embedding diverso, dovremmo aggiornare EMBEDDING_MODEL, impostare EMBEDDING_DIM alla lunghezza del vettore restituito e ricreare la tabella documents.

Passo 5: Genera e inserisci gli embedding dei documenti

Ora genereremo gli embedding per un piccolo dataset autonomo e li inseriremo in Oracle Database. 

Ogni embedding viene convertito in array.array("f", embedding) prima del binding così da corrispondere alla colonna vettoriale FLOAT32.

Crea lo script

Salva il seguente codice come 05_insert_embeddings.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 DOCUMENTS = [
 	(
         "Oracle AI Vector Search",
         "Oracle Database can store vector embeddings in native VECTOR "
         "columns and query them with SQL similarity search.",
 	),
 	(
         "Semantic Search for Applications",
         "Semantic search ranks results by meaning, helping applications "
         "find related content even when exact words differ.",
 	),
 	(
         "Vector Index Workflow",
         "Vector indexes help approximate nearest-neighbor search scale "
         "when datasets grow beyond small examples.",
 	),
 	(
         "Local Docker Development",
         "Docker containers make it practical to run a local database for "
         "development and repeatable tutorials.",
 	),
 	(
         "Python Database Code",
         "Python applications can connect to Oracle Database with the "
         "oracledb driver and use environment variables for credentials.",
 	),
 	(
         "Acoustic Guitar Practice",
         "Daily guitar practice improves timing, chord transitions, and "
         "confidence when learning new songs.",
 	),
 	(
         "Weeknight Vegetable Soup",
         "A simple soup can combine onions, carrots, beans, herbs, and "
         "broth for an easy weeknight meal.",
 	),
 ]

 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def configured_dimension():
 	try:
         return int(required_env("EMBEDDING_DIM"))
 	except ValueError as exc:
         raise SystemExit("EMBEDDING_DIM must be an integer.") from exc


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")
     model_name = required_env("EMBEDDING_MODEL")
     expected_dimension = configured_dimension()

 	# Generate embeddings for all sample documents in one API request.
 	client = OpenAI()
     response = client.embeddings.create(
         model=model_name,
         input=[content for _, content in DOCUMENTS],
 	)

 	# Restore the response order using each item's index.
     embeddings = [
         item.embedding
     	for item in sorted(
             response.data,
             key=lambda item: item.index,
     	)
 	]

 	if any(len(embedding) != expected_dimension for embedding in embeddings):
         raise SystemExit(
             "An embedding length did not match EMBEDDING_DIM. "
             "Rerun 04_check_embedding_dimension.py."
     	)

 	# Bind each embedding as a 32-bit floating-point array.
 	rows = [
         (title, content, array.array("f", embedding))
     	for (title, content), embedding in zip(DOCUMENTS, embeddings)
 	]

 	# Replace the sample rows and commit the transaction.
 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             cursor.execute("DELETE FROM documents")
             cursor.executemany(
                 """
                 INSERT INTO documents (title, content, embedding)
                 VALUES (:1, :2, :3)
                 """,
                 rows,
             )
             cursor.execute("SELECT COUNT(*) FROM documents")
             row_count = cursor.fetchone()[0]
             connection.commit()

     print(f"Embedding model: {model_name}")
     print(f"Generated embeddings for {len(DOCUMENTS)} documents.")
     print(f"Inserted {len(DOCUMENTS)} documents.")
     print(f"documents row count: {row_count}")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui lo script di insert.

python 05_insert_embeddings.py

Output atteso

Il conteggio righe dovrebbe corrispondere ai sette documents inline.

Embedding model: text-embedding-3-small
 Generated embeddings for 7 documents.
 Inserted 7 documents.
 documents row count: 7

Ora abbiamo testo ed embedding archiviati insieme in Oracle Database. I documents non correlati su chitarra e zuppa sono inclusi, così i risultati di ricerca hanno corrispondenze vicine e lontane evidenti.

Passo 6: Esegui una query di ricerca semantica

Successivamente, effettueremo l'embedding di una query in linguaggio naturale e la confronteremo con gli embedding dei documenti archiviati. Questo script usa la distanza coseno, comunemente usata per gli embedding testuali perché si concentra sulla direzione del vettore più che sulla magnitudine grezza.

Per la ricerca semantica, la query passa attraverso lo stesso modello di embedding dei documents. Non stiamo chiedendo a SQL di capire direttamente la frase inglese. 

Chiediamo al modello di embedding di trasformare la frase in un vettore, poi chiediamo a Oracle Database di ordinare i vettori archiviati in base alla loro distanza da quel vettore di query.

Crea lo script

Salva il seguente codice come 06_semantic_search.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 QUERY_TEXT = "Where should an AI app keep meaning-based search data?"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate an embedding for the natural-language query.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=QUERY_TEXT,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Rank stored documents by cosine distance from the query vector.
             cursor.execute(
                 """
                 SELECT title,
                    	content,
                    	VECTOR_DISTANCE(
                        	embedding,
                        	:query_vector,
                        	COSINE
                    	) AS distance
                 FROM documents
                 ORDER BY distance
                 FETCH EXACT FIRST 5 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             rows = cursor.fetchall()

 	if not rows:
         raise SystemExit("No documents found. Run 05_insert_embeddings.py first.")

     print(f"Query: {QUERY_TEXT}")
     print("\nTop 5 results:")

 	for rank, (title, content, distance) in enumerate(rows, start=1):
         print(f"{rank}. {title}")
         print(f"   distance: {float(distance):.6f}")
         print(f"   {content[:90]}...")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui lo script di ricerca semantica.

python 06_semantic_search.py

Output atteso

Classifiche e distanze esatte possono variare quando cambia il modello di embedding. Tuttavia, i documents su Oracle AI Vector Search, ricerca semantica, codice database Python e indicizzazione vettoriale dovrebbero posizionarsi in alto.

Query: Where should an AI app keep meaning-based search data?

 Top 5 results:
 1. Oracle AI Vector Search
    distance: <cosine distance from your run>
    Oracle Database can store vector embeddings in native VECTOR columns and query them with SQL...

 2. Semantic Search for Applications
    distance: <cosine distance from your run>
    Semantic search ranks results by meaning, helping applications find related content even when...

 3. Python Database Code
    distance: <cosine distance from your run>
    Python applications can connect to Oracle Database with the oracledb driver and use environment...

 4. Vector Index Workflow
    distance: <cosine distance from your run>
    Vector indexes help approximate nearest-neighbor search scale when datasets grow beyond small...

 5. Local Docker Development
    distance: <cosine distance from your run>
    Docker containers make it practical to run a local database for development and repeatable...

Per le query a distanza euclidea e coseno in questo tutorial, valori più piccoli indicano corrispondenze più vicine. 

Il prodotto scalare è un altro utile approccio di confronto in molti workflow di vector search, specialmente quando magnitudine o vettori normalizzati contano, ma direzione del punteggio e normalizzazione richiedono attenzione. 

Terremo il codice eseguibile su distanza euclidea e coseno così l'interpretazione dei risultati resta semplice.

Se in una futura applicazione normalizziamo gli embedding, dovremo normalizzare in modo coerente sia gli embedding dei documenti archiviati sia quelli delle query; altrimenti, distanze e classifiche possono cambiare.

Passo 7: Confronta ricerca semantica con match di frase

La ricerca semantica è utile perché non richiede che la stessa frase esatta compaia nel documento.

Confrontiamo la query semantica con un semplice predicato di frase esatta.

Questa non è una demo di motore di ricerca full-text; è un piccolo confronto SQL che rende visibile la differenza tra matching letterale e ranking basato sul significato.

Crea lo script

Salva il seguente codice come 07_semantic_vs_keyword.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 SEMANTIC_QUERY = "Where should an AI app keep meaning-based search data?"
 KEYWORD_PHRASE = "meaning-based search data"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate an embedding for the semantic query.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=SEMANTIC_QUERY,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Rank documents by semantic similarity.
             cursor.execute(
                 """
                 SELECT title,
                        VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FROM documents
                 ORDER BY VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FETCH EXACT FIRST 3 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             semantic_rows = cursor.fetchall()

             # Compare semantic results with an exact phrase predicate.
             cursor.execute(
                 """
                 SELECT title
                 FROM documents
                 WHERE LOWER(title || ' ' || content)
                   	LIKE '%' || :phrase || '%'
                 ORDER BY title
                 FETCH FIRST 3 ROWS ONLY
                 """,
                 phrase=KEYWORD_PHRASE.lower(),
             )
             keyword_rows = cursor.fetchall()

     print(f"Semantic query: {SEMANTIC_QUERY}")
     print(f"Keyword phrase: {KEYWORD_PHRASE}")

     print("\nSemantic results:")
 	for rank, (title, distance) in enumerate(semantic_rows, start=1):
         print(f"{rank}. {title}")
         print(f"   distance: {float(distance):.6f}")

     print("\nKeyword results:")
 	if keyword_rows:
     	for rank, (title,) in enumerate(keyword_rows, start=1):
             print(f"{rank}. {title}")
 	else:
         print("0 exact phrase matches")


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui lo script di confronto.

python 07_semantic_vs_keyword.py

Output atteso

La ricerca semantica dovrebbe restituire documents rilevanti anche se la frase chiave esatta non è presente.

Semantic query: Where should an AI app keep meaning-based search data?
 Keyword phrase: meaning-based search data

 Semantic results:
 1. Oracle AI Vector Search
    distance: <cosine distance from your run>
 2. Semantic Search for Applications
    distance: <cosine distance from your run>
 3. Python Database Code
    distance: <cosine distance from your run>

 Keyword results:
 0 exact phrase matches

I tradizionali predicati SQL restano importanti per filtri, join, permessi e matching esatto. La vector search aggiunge un segnale di ranking basato sul significato che possiamo combinare con dati relazionali quando un'applicazione richiede retrieval semantico.

Passo 8: Aggiungi e valida un indice vettoriale

Infine, creeremo un indice vettoriale e valideremo che Oracle Database lo riporti come indice valido di proprietà dello schema della demo. 

Questo passaggio dimostra il workflow di creazione dell'indice; il nostro dataset minuscolo non è abbastanza grande per trarre conclusioni significative sulle performance.

Senza indice, Oracle Database può confrontare esattamente il vettore di query con ciascun vettore archiviato. Questo approccio è adatto a dataset minuscoli ed è utile in fase di apprendimento.

Con dataset più grandi, gli indici vettoriali approssimati riducono lo spazio di ricerca così che le query possano tornare rapidamente pur trovando vicini prossimi. 

Scegli la famiglia di indici dopo aver considerato dimensione dei dati, obiettivi di latenza, requisiti di recall, budget di memoria e frequenza di modifica dei vettori.

La query finale conferma che la ricerca semantica restituisce ancora risultati dopo la creazione dell'indice. 

Non useremo EXPLAIN PLAN o DBMS_XPLAN perché questo tutorial valida la creazione dell'indice con metadati dello schema, non con il piano di esecuzione.

Crea lo script

Salva il seguente codice come 08_create_vector_index.py.

import array
 import os

 import oracledb
 from openai import OpenAI

 INDEX_NAME = "DOCUMENT_EMBEDDING_IDX"
 QUERY_TEXT = "Where should an AI app keep meaning-based search data?"
 ADMIN_USERS = {"SYS", "SYSTEM", "PDBADMIN"}


 def required_env(name):
 	value = os.getenv(name)
 	if not value:
         raise SystemExit(f"Set {name} before running this script.")
 	return value


 def main():
 	user = required_env("DB_USER")
 	if user.upper() in ADMIN_USERS:
         raise SystemExit(
             "Use the vector_demo application user, not an admin user."
     	)

     required_env("OPENAI_API_KEY")

 	# Generate the query vector used for the validation search.
 	client = OpenAI()
     response = client.embeddings.create(
         model=required_env("EMBEDDING_MODEL"),
         input=QUERY_TEXT,
 	)
     query_vector = array.array("f", response.data[0].embedding)

 	with oracledb.connect(
         user=user,
         password=required_env("DB_PASSWORD"),
         dsn=required_env("DB_DSN"),
 	) as connection:
         with connection.cursor() as cursor:
             # Remove a prior index so the script can be rerun safely.
             try:
                 cursor.execute(f"DROP INDEX {INDEX_NAME}")
             except oracledb.DatabaseError as exc:
                 error = exc.args[0]
                 if error.code != 1418:
                 	raise

             # Create an approximate neighbor-partitions vector index.
             cursor.execute(
                 """
                 CREATE VECTOR INDEX document_embedding_idx
                 ON documents (embedding)
                 ORGANIZATION NEIGHBOR PARTITIONS
                 DISTANCE COSINE
                 WITH TARGET ACCURACY 95
                 """
             )

             # Confirm that Oracle reports the vector index as valid.
             cursor.execute(
                 """
                 SELECT index_name, index_type, status
                 FROM user_indexes
                 WHERE index_name = :index_name
                 """,
                 index_name=INDEX_NAME,
             )
             index_row = cursor.fetchone()

             # Confirm that semantic search still returns rows after index creation.
             cursor.execute(
                 """
                 SELECT title
                 FROM documents
                 ORDER BY VECTOR_DISTANCE(embedding, :query_vector, COSINE)
                 FETCH EXACT FIRST 3 ROWS ONLY
                 """,
                 query_vector=query_vector,
             )
             rows = cursor.fetchall()

 	if not index_row:
         raise SystemExit("Vector index was not found in USER_INDEXES.")

     print("Created vector index DOCUMENT_EMBEDDING_IDX.")
     print("\nIndex validation:")
     print(f"Index name: {index_row[0]}")
     print(f"Index type: {index_row[1]}")
     print(f"Status: {index_row[2]}")
     result_count = len(rows)

 	print(
         "\nSemantic search still returns "
         f"{result_count} results after index creation."
 	)


 if __name__ == "__main__":
 	main()

Esegui lo script

Esegui lo script dell'indice.

python 08_create_vector_index.py

Output atteso

L'output dovrebbe includere una riga per DOCUMENT_EMBEDDING_IDX, con INDEX_TYPE impostato a VECTOR e STATUS impostato a VALID.

Created vector index DOCUMENT_EMBEDDING_IDX.

 Index validation:
 Index name: DOCUMENT_EMBEDDING_IDX
 Index type: VECTOR
 Status: VALID

 Semantic search still returns 3 results after index creation.

USER_INDEXES conferma che l'indice esiste ed è valido. Non prova che una specifica query abbia usato l'indice, e questo tutorial non usa l'output del piano di esecuzione come metodo di validazione. 

Per carichi di lavoro di produzione, testeremmo con volumi di dati realistici, pattern di query e obiettivi di performance.

Suggerimenti e troubleshooting per Oracle AI Vector Search

Il container del database si sta ancora avviando

Attendi finché l'avvio non è completo, poi esegui di nuovo docker logs oracle-free-26ai-vector. Il database deve essere pronto prima che Python possa connettersi a localhost:1521/FREEPDB1.

La porta 1521 è già in uso

Arresta il servizio locale in conflitto o modifica il mapping delle porte di Docker. Aggiorna DB_DSN se cambia la porta dell'host.

La connessione al database fallisce

Verifica DB_USER, DB_PASSWORD e DB_DSN. Usa FREEPDB1 nel DSN e collega gli script applicativi come vector_demo, non come SYS, SYSTEM o PDBADMIN.

Manca la chiave API per gli embedding

I Passi 1-3 sono solo database. I Passi 4-8 richiedono OPENAI_API_KEY e possono comportare costi API.

Una dimensione vettoriale non corrisponde

Esegui 04_check_embedding_dimension.py, aggiorna EMBEDDING_DIM, riesegui 03_create_documents_table.py e ricarica gli embedding con 05_insert_embeddings.py.

Un bind vettoriale fallisce

Assicurati che ogni bind di vettori FLOAT32 usi array.array("f", values). Il tutorial usa questo formato per vettori manuali, embedding dei documenti archiviati e embedding delle query.

Le classifiche semantiche differiscono dall'esempio

È previsto. I provider di embedding possono aggiornare i modelli e le distanze in virgola mobile possono variare tra le esecuzioni.

La creazione dell'indice vettoriale fallisce

Conferma che la tabella documents esiste, che lo schema vector_demo ne è il proprietario e che DOCUMENT_EMBEDDING_IDX non sia rimasto da un'esecuzione parziale.

Prepararsi alla produzione

Usa oracledb.create_pool() per il connection pooling, esegui benchmark con volumi di dati realistici, rivedi sicurezza e gestione dei segreti e ottimizza gli indici in base a pattern di query reali.

Arresta e rimuovi il container

Quando il tutorial è completato, arresta e rimuovi il container locale.

docker stop oracle-free-26ai-vector
docker rm oracle-free-26ai-vector

Conclusione

Abbiamo costruito un flusso di lavoro di ricerca semantica locale con Oracle AI Vector Search, Oracle Database Free 26ai e Python. 

Siamo partiti da valori VECTOR(3, FLOAT32) scritti a mano, abbiamo inserito embedding generati dal modello con array.array("f", values), interrogato documents simili con VECTOR_DISTANCE(), confrontato il recupero semantico con un semplice predicato di frase esatta e validato un indice vettoriale tramite USER_INDEXES.

Questo approccio si adatta bene quando gli embedding devono stare accanto ai dati relazionali e vogliamo archiviazione e ricerca visibili in SQL senza aggiungere un database vettoriale separato per il workflow locale. 

La demo è volutamente piccola: insegna le primitive, non la scalabilità in produzione. Applicazioni più grandi dovrebbero eseguire benchmark con dati realistici, rivedere sicurezza e privilegi, usare connection pooling e validare le scelte di indicizzazione su pattern di query reali.

Poi possiamo approfondire l'implementazione con queste risorse:

FAQs

Che cos&apos;è Oracle AI Vector Search?

Oracle AI Vector Search è un insieme di funzionalità di Oracle Database per archiviare, indicizzare e interrogare embedding vettoriali insieme ai dati relazionali.

Ho bisogno di una chiave API OpenAI per completare il tutorial?

I passaggi con vettori manuali e setup del database non richiedono una chiave API. I Passi 4-8 richiedono un provider di embedding e la OPENAI_API_KEY configurata.

Perché EMBEDDING_DIM deve corrispondere al modello di embedding?

La dimensione della colonna VECTOR deve essere uguale al numero di valori restituiti dal modello di embedding. Una mancata corrispondenza fa fallire l'inserimento del vettore.

Quali metriche di distanza usa il tutorial?

L'esempio con vettori manuali usa la distanza euclidea. Gli esempi di ricerca semantica usano la distanza coseno.

Un indice vettoriale valido dimostra che una query ha usato l&apos;indice?

No. USER_INDEXES conferma che l'indice esiste ed è in stato valido, ma non conferma che una specifica query lo abbia utilizzato.


Mark Nelson's photo
Author
Mark Nelson
LinkedIn

Mark Nelson è un architetto ed evangelist per sviluppatori in Oracle.  Lavora all’incrocio tra AI, microservizi e tecnologie database.  È un blogger attivo, autore pubblicato, revisore tecnico per Manning Publications, Section Leader a Stanford Code in Place e mentor presso DeepLearning.ai.  Interviene regolarmente presso Java e Oracle User Group, meetup sull’AI e grandi conferenze.  Ha una passione per l’apprendimento e l’insegnamento.  Vanta oltre trent’anni di esperienza nel settore, in IBM e Oracle.

Argomenti
Intelligenza artificiale
Python

I migliori corsi DataCamp

Corso

Introduzione a Oracle SQL

4 ore
18.5K
Migliora le tue abilità con Oracle SQL, imparando le basi, come aggregare, combinare e personalizzare i dati.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

Mostra AltroMostra Altro

