Kursus
Python Tingkat Menengah
4 jam
1.4M
Dulu, fokus utama ada pada ‘tingkat’ seperti tingkat attrition dan tingkat retensi. Manajer HR menghitung tingkat historis dan mencoba memprediksi tingkat di masa depan menggunakan alat data warehousing. Angka-angka ini menunjukkan dampak agregat dari churn, tetapi itu baru separuh gambaran. Pendekatan lain adalah berfokus pada catatan individual selain agregat.
Ada banyak studi kasus tentang customer churn. Dalam customer churn, Anda dapat memprediksi siapa dan kapan seorang pelanggan berhenti membeli. Employee churn mirip dengan customer churn. Fokusnya terutama pada karyawan, bukan pelanggan. Di sini, Anda dapat memprediksi siapa dan kapan seorang karyawan akan mengakhiri masa kerjanya. Employee churn mahal, dan peningkatan kecil sekalipun dapat menghasilkan dampak yang signifikan. Ini akan membantu kita merancang rencana retensi yang lebih baik dan meningkatkan kepuasan karyawan.
Employee churn dapat didefinisikan sebagai kebocoran atau keluarnya aset intelektual dari sebuah perusahaan atau organisasi. Atau, secara sederhana, ketika karyawan meninggalkan organisasi disebut churn. Definisi lain: ketika seorang anggota populasi meninggalkan populasi, itu disebut churn.
Dalam penelitian, ditemukan bahwa employee churn dipengaruhi oleh usia, masa kerja, gaji, kepuasan kerja, upah, kondisi kerja, potensi pertumbuhan, dan persepsi karyawan tentang keadilan. Variabel lain seperti usia, jenis kelamin, etnis, pendidikan, dan status pernikahan merupakan faktor penting dalam memprediksi employee churn. Dalam beberapa kasus, karyawan dengan keterampilan khusus lebih sulit digantikan. Hal ini memengaruhi pekerjaan yang sedang berjalan dan produktivitas karyawan yang ada. Merekrut karyawan baru sebagai pengganti memiliki biayanya sendiri seperti biaya perekrutan dan pelatihan. Selain itu, karyawan baru memerlukan waktu untuk mempelajari keterampilan hingga setara dengan tingkat keahlian teknis atau bisnis karyawan lama. Organisasi mengatasi masalah ini dengan menerapkan teknik machine learning untuk memprediksi employee churn, yang membantu mereka mengambil tindakan yang diperlukan.
Poin-poin berikut membantu Anda memahami employee dan customer churn dengan lebih baik:
Perusahaan memilih karyawan untuk direkrut, sedangkan dalam pemasaran Anda tidak dapat memilih pelanggan Anda.
Karyawan akan menjadi wajah perusahaan Anda, dan secara kolektif, karyawan menghasilkan semua yang dilakukan perusahaan Anda.
Kehilangan pelanggan memengaruhi pendapatan dan citra merek. Mendapatkan pelanggan baru lebih sulit dan mahal dibanding mempertahankan pelanggan yang sudah ada. Employee churn juga menyakitkan bagi perusahaan dan organisasi. Dibutuhkan waktu dan upaya untuk menemukan serta melatih pengganti.
Employee churn memiliki dinamika yang unik dibanding customer churn. Ini membantu kita merancang rencana retensi karyawan yang lebih baik dan meningkatkan kepuasan karyawan. Algoritme data science dapat memprediksi churn di masa depan.
Exploratory Data Analysis adalah proses awal analisis, di mana Anda dapat merangkum karakteristik data seperti pola, tren, outlier, dan pengujian hipotesis menggunakan statistik deskriptif dan visualisasi.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineMari kita muat dulu dataset HR yang diperlukan menggunakan fungsi read CSV dari pandas. Anda dapat mengunduh datanya dari tautan ini.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Setelah memuat dataset, Anda mungkin ingin mengetahui sedikit lebih banyak tentangnya. Anda dapat memeriksa nama atribut dan tipe data menggunakan info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Anda dapat menjelaskan 10 atribut secara rinci sebagai berikut:
Dalam dataset yang diberikan, ada dua jenis karyawan: yang tetap dan yang keluar dari perusahaan. Jadi, Anda dapat membagi data menjadi dua grup dan membandingkan karakteristiknya. Di sini, Anda dapat mencari rata-rata kedua grup menggunakan fungsi groupby() dan mean().
left = data.groupby('left')
left.mean()

Di sini dapat diinterpretasikan, karyawan yang keluar dari perusahaan memiliki tingkat kepuasan rendah, tingkat promosi rendah, gaji rendah, dan bekerja lebih banyak dibandingkan yang tetap di perusahaan.
Fungsi describe() di pandas sangat praktis untuk mendapatkan berbagai statistik ringkas. Fungsi ini mengembalikan jumlah, mean, standar deviasi, nilai minimum dan maksimum, serta kuantil dari data.
data.describe()

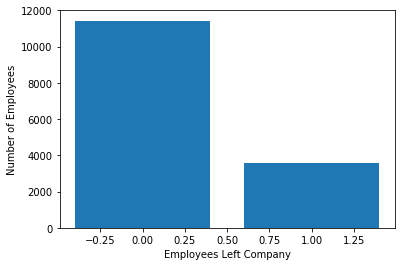
Mari periksa berapa banyak karyawan yang keluar?
Di sini, Anda dapat membuat grafik batang menggunakan Matplotlib. Grafik batang cocok untuk menunjukkan jumlah variabel diskret.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Karyawan Keluar dari Perusahaan')
plt.ylabel('Jumlah Karyawan')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Di sini, Anda dapat melihat dari sekitar 15.000, sekitar 3.571 keluar, dan 11.428 tetap. Jumlah karyawan yang keluar adalah 23% dari total karyawan.
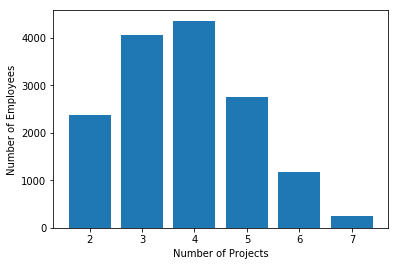
Demikian pula, Anda juga dapat membuat grafik batang untuk menghitung jumlah karyawan yang dikerahkan pada berapa banyak proyek?
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Jumlah Proyek')
plt.ylabel('Jumlah Karyawan')
plt.show()
Demikian pula, Anda juga dapat membuat grafik batang untuk menghitung jumlah karyawan berdasarkan berapa lama pengalamannya?
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Jumlah Tahun Bekerja di Perusahaan')
plt.ylabel('Jumlah Karyawan')
plt.show()
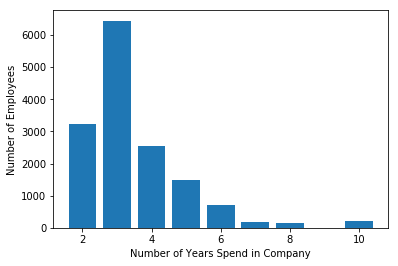
Sebagian besar karyawan memiliki pengalaman antara 2–4 tahun. Selain itu, ada kesenjangan besar antara karyawan berpengalaman 3 tahun dan 4 tahun.
Begini cara Anda menganalisis fitur satu per satu, tetapi ini akan memakan waktu. Opsi yang lebih baik adalah menggunakan pustaka Seaborn dan memplot semua grafik dalam sekali jalan menggunakan subplot.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
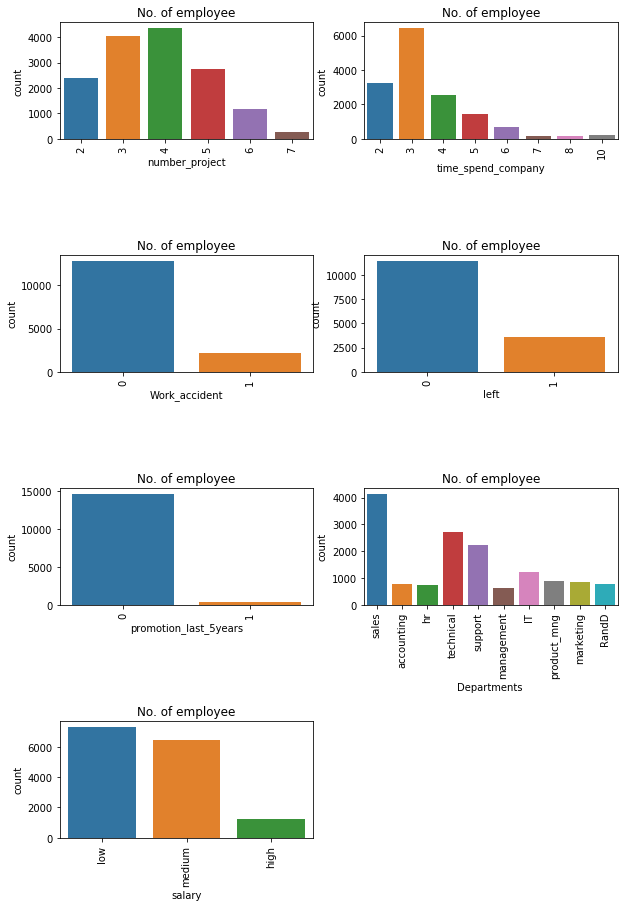
Anda dapat mengamati poin-poin berikut pada visualisasi di atas:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
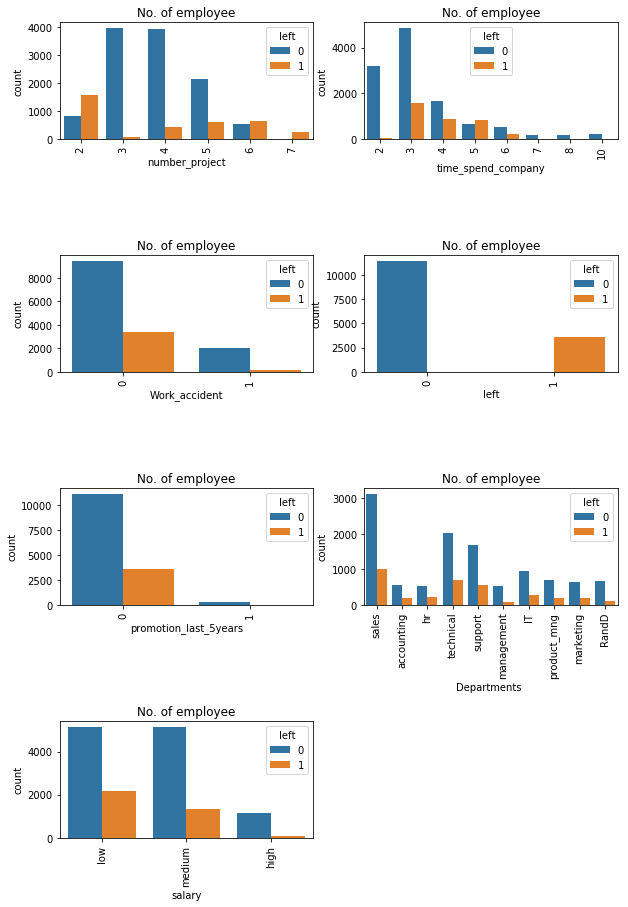
Anda dapat mengamati poin-poin berikut pada visualisasi di atas:
Fitur-fitur berikut paling memengaruhi seseorang untuk keluar dari perusahaan:
Mari cari tahu kelompok karyawan yang keluar. Anda dapat mengamati bahwa faktor terpenting bagi karyawan untuk tetap atau keluar adalah kepuasan dan kinerja di perusahaan. Jadi mari kita kelompokkan mereka menggunakan analisis klaster.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
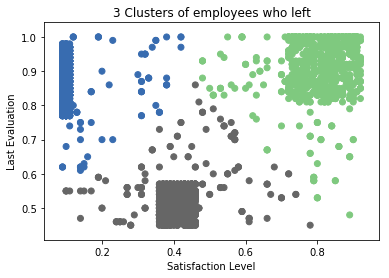
Di sini, karyawan yang keluar dari perusahaan dapat dikelompokkan menjadi 3 tipe karyawan:
Banyak algoritme machine learning memerlukan data masukan numerik, jadi Anda perlu merepresentasikan kolom kategorikal dalam kolom numerik.
Untuk melakukan encoding data ini, Anda dapat memetakan setiap nilai ke sebuah angka. Misalnya, nilai kolom Salary dapat direpresentasikan sebagai low:0, medium:1, dan high:2.
Proses ini dikenal sebagai label encoding, dan sklearn dengan mudah melakukannya untuk Anda menggunakan LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Di sini, Anda mengimpor modul preprocessing dan membuat objek Label Encoder. Menggunakan objek LabelEncoder ini Anda melakukan fit dan transform kolom "salary" dan "Departments " menjadi kolom numerik.
Untuk memahami kinerja model, membagi dataset menjadi training set dan test set adalah strategi yang baik.
Mari bagi dataset menggunakan fungsi train_test_split(). Anda perlu memberikan 3 parameter: fitur, target, dan ukuran test_set. Selain itu, Anda dapat menggunakan random_state untuk memilih rekaman secara acak.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Di sini, dataset dipecah menjadi dua bagian dengan rasio 70:30. Artinya 70% data digunakan untuk pelatihan model dan 30% untuk pengujian model.
Mari bangun model prediksi employee churn.
Di sini, Anda akan memprediksi churn menggunakan Gradient Boosting Classifier.
Pertama, impor modul GradientBoostingClassifier dan buat objek classifier Gradient Boosting menggunakan fungsi GradientBoostingClassifier().
Lalu, latih model Anda pada train set menggunakan fit() dan lakukan prediksi pada test set menggunakan predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Anda mendapatkan tingkat klasifikasi 97%, yang dianggap akurat.
Precision: Precision berkaitan dengan ketepatan, yaitu seberapa tepat model Anda. Dengan kata lain, ketika model membuat prediksi, seberapa sering prediksi itu benar. Dalam kasus prediksi Anda, ketika model Gradient Boosting memprediksi seorang karyawan akan keluar, karyawan tersebut benar-benar keluar 95% dari waktu.
Recall: Jika ada karyawan yang keluar pada test set dan model Gradient Boosting Anda dapat mengidentifikasinya 92% dari waktu.
Selamat, Anda telah mencapai akhir tutorial ini!
Dalam tutorial ini, Anda telah mempelajari apa itu Employee Churn, bagaimana bedanya dengan customer churn, analisis data eksploratori dan visualisasi dataset employee churn menggunakan matplotlib dan seaborn, pembangunan model dan evaluasinya menggunakan paket scikit-learn di Python.
Saya menantikan masukan atau pertanyaan dari Anda. Anda dapat mengajukan pertanyaan dengan meninggalkan komentar, dan saya akan berusaha sebaik mungkin untuk menjawabnya.
Jika Anda tertarik untuk mempelajari lebih lanjut tentang Python, lihat kursus Intermediate Python for Data Science dari DataCamp.
Pelajari lebih lanjut tentang Python
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




