Kurs
Python für Fortgeschrittene
4 Std.
1.4M
Früher lag der Fokus vor allem auf Kennzahlen wie Fluktuations- und Retentionsrate. HR-Manager berechnen vergangene Raten und versuchen, mithilfe von Data-Warehousing-Tools die Zukunft vorherzusagen. Diese Raten zeigen zwar die aggregierten Auswirkungen von Fluktuation, bilden aber nur die halbe Wahrheit ab. Ein weiterer Ansatz ist, neben den Aggregaten auch die individuellen Datensätze in den Blick zu nehmen.
Es gibt zahlreiche Fallstudien zur Kundenabwanderung. Dabei lässt sich vorhersagen, wer und wann keine Käufe mehr tätigt. Mitarbeiterfluktuation ist dem sehr ähnlich – nur steht hier die Mitarbeiterin oder der Mitarbeiter im Mittelpunkt statt der Kundschaft. Du kannst also prognostizieren, wer das Unternehmen wann verlassen wird. Fluktuation ist teuer, und schon kleine Verbesserungen haben große Wirkung. Das hilft, bessere Retentionspläne zu entwickeln und die Mitarbeiterzufriedenheit zu steigern.
Mitarbeiterfluktuation lässt sich als Abfluss oder Weggang von intellektuellem Kapital aus einem Unternehmen beschreiben. Einfach gesagt: Wenn Mitarbeitende die Organisation verlassen, sprechen wir von Fluktuation. Allgemeiner: Verlässt ein Mitglied eine Population, handelt es sich um Churn.
Forschungen zeigen: Fluktuation wird von Faktoren wie Alter, Betriebszugehörigkeit, Bezahlung, Arbeitszufriedenheit, Gehalt, Arbeitsbedingungen, Entwicklungsmöglichkeiten und dem Fairness-Empfinden beeinflusst. Weitere Variablen wie Alter, Geschlecht, Ethnie, Bildung und Familienstand spielen ebenfalls eine Rolle bei der Vorhersage. In manchen Fällen – etwa bei Mitarbeitenden mit Nischenkompetenzen – ist Ersatz schwer zu finden. Das beeinträchtigt laufende Projekte und die Produktivität des Teams. Neueinstellungen verursachen zudem Kosten für Recruiting und Training, und es dauert, bis neue Mitarbeitende das gleiche technische oder fachliche Niveau erreichen. Unternehmen begegnen dem, indem sie Machine-Learning-Methoden einsetzen, um Fluktuation vorherzusagen – und rechtzeitig gegenzusteuern.
Die folgenden Punkte helfen, Mitarbeiter- und Kundenfluktuation besser einzuordnen:
Im HR wählt das Unternehmen aus, wen es einstellt – im Marketing kannst du dir deine Kundschaft nicht aussuchen.
Mitarbeitende sind das Gesicht deines Unternehmens und erbringen gemeinsam alle Leistungen, die dein Unternehmen ausmachen.
Der Verlust von Kundinnen und Kunden schadet Umsatz und Marke. Neukundengewinnung ist schwieriger und teurer als die Bindung bestehender Kundschaft. Mitarbeiterfluktuation ist für Unternehmen ebenso schmerzhaft: Ersatz zu finden und einzuarbeiten kostet Zeit und Ressourcen.
Mitarbeiterfluktuation folgt eigenen Dynamiken gegenüber der Kundenabwanderung. Eine fundierte Analyse hilft, bessere Retentionspläne zu entwickeln und die Zufriedenheit zu erhöhen. Data-Science-Algorithmen können zukünftige Fluktuation vorhersagen.
Explorative Datenanalyse ist der Einstieg in die Analyse: Du fasst Eigenschaften der Daten wie Muster, Trends, Ausreißer und Hypothesentests mithilfe beschreibender Statistik und Visualisierung zusammen.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineLass uns zuerst den benötigten HR-Datensatz mit der CSV-Ladefunktion von pandas einlesen. Du kannst die Daten über diesen Link herunterladen.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Nachdem der Datensatz geladen ist, willst du sicher mehr darüber wissen. Mit info() prüfst du Spaltennamen und Datentypen.
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Die 10 Attribute im Überblick:
Im Datensatz gibt es zwei Gruppen: Mitarbeitende, die geblieben sind, und solche, die gegangen sind. Teile die Daten in zwei Gruppen und vergleiche ihre Merkmale. Den Durchschnitt beider Gruppen erhältst du mit groupby() und mean().
left = data.groupby('left')
left.mean()

Hier siehst du: Mitarbeitende, die gegangen sind, hatten eine geringere Zufriedenheit, seltener Beförderungen, ein niedrigeres Gehalt und arbeiteten im Schnitt mehr Stunden als diejenigen, die geblieben sind.
Die Funktion describe() in pandas liefert bequem verschiedene zusammenfassende Statistiken. Sie gibt Anzahl, Mittelwert, Standardabweichung, Minimum, Maximum sowie Quantile der Daten zurück.
data.describe()

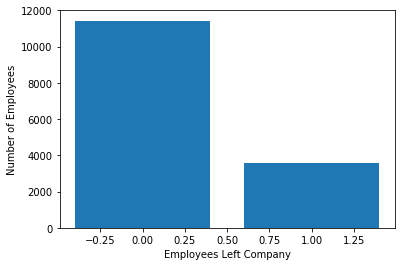
Schauen wir, wie viele Mitarbeitende gegangen sind.
Dafür bietet sich ein Balkendiagramm mit Matplotlib an. Es eignet sich gut für Häufigkeiten diskreter Variablen.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Employees Left Company')
plt.ylabel('Number of Employees')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Von rund 15.000 Personen sind ca. 3.571 gegangen und 11.428 geblieben. Der Anteil der Abgänge liegt bei 23 % der Belegschaft.
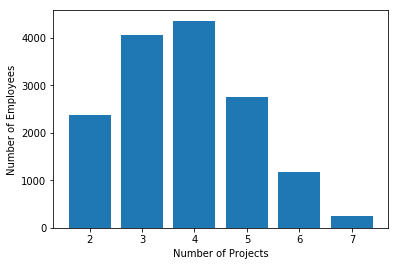
Analog kannst du ein Balkendiagramm erstellen, um zu zählen, wie viele Mitarbeitende auf wie viele Projekte eingesetzt sind.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Number of Projects')
plt.ylabel('Number of Employees')
plt.show()
Auch für die Berufserfahrung lässt sich ein Balkendiagramm erstellen, das die Anzahl der Mitarbeitenden je Erfahrungsstufe zeigt.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Number of Years Spend in Company')
plt.ylabel('Number of Employees')
plt.show()
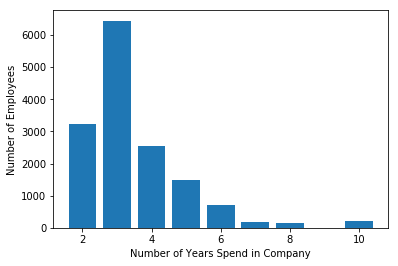
Die meisten Mitarbeitenden haben 2 bis 4 Jahre Erfahrung. Zwischen 3 und 4 Jahren zeigt sich zudem ein deutlicher Sprung.
Feature für Feature zu analysieren ist aufwendig. Effizienter ist es, mit der Seaborn-Bibliothek alle Diagramme in einem Durchlauf als Subplots zu plotten.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
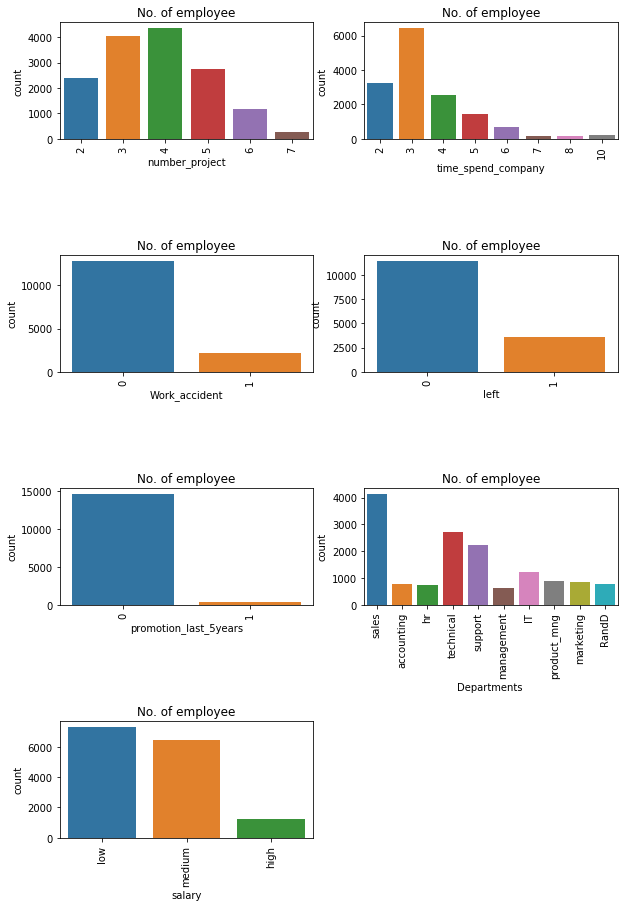
Aus der obigen Visualisierung lassen sich folgende Punkte ablesen:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
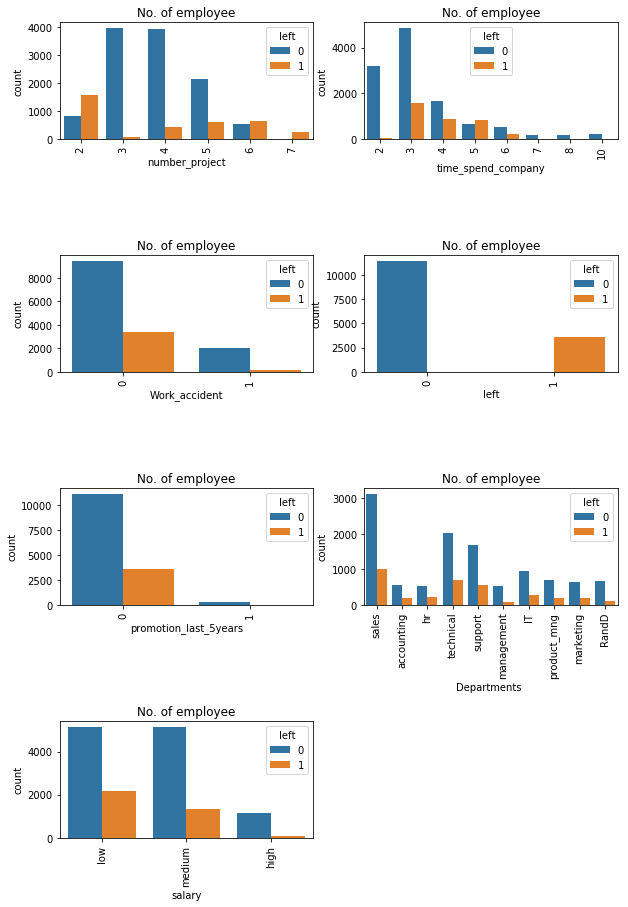
Daraus ergeben sich weitere Beobachtungen:
Diese Faktoren beeinflussen den Weggang besonders stark:
Wer sind die Gruppen der Gehenden? Zufriedenheit und Performance sind zentrale Faktoren für Bleiben oder Gehen. Bündeln wir diese Personen per Clusteranalyse in Gruppen.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
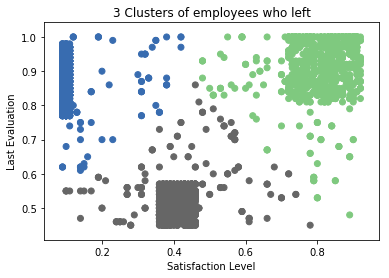
Die Gehenden lassen sich in drei Gruppen einteilen:
Viele Machine-Learning-Algorithmen benötigen numerische Eingaben. Kategoriale Spalten musst du daher in numerische Merkmale überführen.
Zur Kodierung kannst du Werte auf Zahlen abbilden, z. B. für die Spalte Salary: low:0, medium:1, high:2.
Dieser Prozess heißt Label-Encoding, und sklearn erledigt das bequem mit dem LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Hier importierst du das Modul preprocessing und erstellst ein LabelEncoder-Objekt. Damit transformierst du die Spalten "salary" und "Departments " in numerische Werte.
Um die Modellgüte zu beurteilen, ist es sinnvoll, den Datensatz in Trainings- und Testdaten zu teilen.
Nutzen wir dafür train_test_split(). Du übergibst Features, Zielvariable und die Größe des Testsets. Optional kannst du mit random_state die Auswahl reproduzierbar machen.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Der Datensatz wird im Verhältnis 70:30 geteilt. Bedeutet: 70 % der Daten fürs Training, 30 % fürs Testen.
Lass uns ein Vorhersagemodell für Mitarbeiterfluktuation bauen.
Wir verwenden hierfür einen Gradient Boosting Classifier.
Zuerst importierst du den GradientBoostingClassifier und erstellst mit GradientBoostingClassifier() das Modellobjekt.
Dann passt du das Modell mit fit() auf den Trainingsdaten an und sagst mit predict() die Testdaten voraus.
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Mit einer Treffergenauigkeit von 97 % liefert das Modell eine starke Performance.
Precision: Präzision beschreibt, wie oft das Modell bei einer positiven Vorhersage tatsächlich richtig liegt. In deinem Fall: Wenn das Gradient-Boosting-Modell prognostiziert, dass jemand gehen wird, traf das in 95 % der Fälle zu.
Recall: Recall misst, wie viele der tatsächlich Gehenden erkannt werden. Hier identifiziert das Modell 92 % der Fälle korrekt.
Glückwunsch, du hast das Ende dieses Tutorials erreicht!
Du hast gelernt, was Mitarbeiterfluktuation ist, wie sie sich von Kundenchurn unterscheidet, wie du explorative Datenanalyse und Visualisierung des Fluktuationsdatensatzes mit matplotlib und seaborn durchführst sowie den Modellaufbau und die Bewertung mit dem Python scikit-learn-Paket.
Ich freue mich auf dein Feedback und deine Fragen. Stell sie gern in den Kommentaren – ich gebe mein Bestes, um zu antworten.
Wenn du mehr über Python lernen möchtest, schau dir den DataCamp-Kurs Intermediate Python for Data Science an.
Mehr über Python lernen
Kurs
Kurs
Kurs
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Sejal Jaiswal
24 Min.