Kurs
Orta Seviye Python
4 sa
1.4M
Geçmişte odak çoğunlukla yıpranma oranı ve elde tutma oranı gibi "oranlar" üzerindeydi. İK yöneticileri, geçmiş oranları hesaplayıp veri ambarı araçlarıyla gelecekteki oranları tahmin etmeye çalışır. Bu oranlar devrin toplam etkisini sunar, ancak bu resmin yalnızca yarısıdır. Diğer bir yaklaşım, toplamın yanı sıra bireysel kayıtlara da odaklanmaktır.
Müşteri devri üzerine birçok vaka çalışması mevcuttur. Müşteri devrinde, bir müşterinin ne zaman ve kimin satın almayı durduracağını tahmin edebilirsiniz. Çalışan devri müşteri devrine benzer. Temelde müşteriden ziyade çalışana odaklanır. Burada, bir çalışanın hizmetine ne zaman ve kimin son vereceğini tahmin edebilirsiniz. Çalışan devri pahalıdır ve kademeli iyileştirmeler bile önemli sonuçlar verir. Daha iyi elde tutma planları tasarlamamıza ve çalışan memnuniyetini artırmamıza yardımcı olur.
Çalışan devri, bir şirketten veya organizasyondan entelektüel varlığın sızması ya da ayrılması olarak tanımlanabilir. Basitçe söylemek gerekirse, çalışanlar organizasyondan ayrıldığında buna devir (churn) denir. Bir başka tanım da, bir popülasyonun bir üyesi popülasyondan ayrıldığında bunun devre karşılık geldiğidir.
Araştırmalarda, çalışan devrinin yaş, kıdem, ücret, iş tatmini, maaş, çalışma koşulları, büyüme potansiyeli ve çalışanın adalet algısından etkilendiği bulunmuştur. Yaş, cinsiyet, etnik köken, eğitim ve medeni durum gibi diğer değişkenler de çalışan devrinin tahmininde önemli faktörlerdir. Nitelikli niş becerilere sahip çalışanların yerine yenisini koymak daha zordur. Bu durum devam eden işleri ve mevcut çalışanların üretkenliğini etkiler. Yerine yeni çalışan almak; işe alım ve eğitim gibi maliyetler doğurur. Ayrıca, yeni bir çalışanın, eski bir çalışanın teknik veya iş uzmanlığı seviyesine ulaşması zaman alacaktır. Kuruluşlar bu sorunu, gerekli önlemleri almalarına yardımcı olan makine öğrenimi tekniklerini uygulayarak çalışan devrini tahmin etmek suretiyle ele alır.
Aşağıdaki noktalar, çalışan ve müşteri devrini daha iyi anlamanıza yardımcı olur:
İş dünyasında bir çalışanı işe almayı siz seçersiniz; pazarlamada ise müşterilerinizi seçemezsiniz.
Çalışanlar şirketinizin yüzüdür ve bir araya geldiklerinde şirketinizin yaptığı her şeyi üretirler.
Bir müşteriyi kaybetmek gelirleri ve marka imajını etkiler. Yeni müşteri kazanmak, mevcut müşteriyi elde tutmaya kıyasla daha zor ve daha maliyetlidir. Çalışan devri de şirketler ve organizasyonlar için sancılıdır. Yerine birini bulmak ve eğitmek zaman ve emek gerektirir.
Çalışan devrinin, müşteri devrine kıyasla kendine özgü dinamikleri vardır. Daha iyi çalışan elde tutma planları tasarlamamıza ve çalışan memnuniyetini artırmamıza yardımcı olur. Veri bilimi algoritmaları gelecekteki devri tahmin edebilir.
Keşifsel Veri Analizi, betimsel istatistikler ve görselleştirme kullanarak örüntü, trend, aykırı değerler ve hipotez testleri gibi verinin özelliklerini özetlediğiniz ilk analiz sürecidir.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineÖnce pandas'ın CSV okuma fonksiyonunu kullanarak gerekli İK veri kümesini yükleyelim. Veriyi bu bağlantıdan indirebilirsiniz.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Veri kümesini yükledikten sonra, onun hakkında biraz daha bilgi edinmek isteyebilirsiniz. info() kullanarak öznitelik adlarını ve veri tiplerini kontrol edebilirsiniz.
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
10 özniteliği şu şekilde ayrıntılı olarak açıklayabilirsiniz:
Verilen veri kümesinde, şirkette kalan ve şirketten ayrılan olmak üzere iki tür çalışan vardır. Bu nedenle veriyi iki gruba ayırıp özelliklerini karşılaştırabilirsiniz. Burada, groupby() ve mean() fonksiyonlarını kullanarak her iki grubun ortalamasını bulabilirsiniz.
left = data.groupby('left')
left.mean()

Buradan şu şekilde yorumlayabilirsiniz: Şirketten ayrılan çalışanların memnuniyet düzeyi, terfi oranı ve maaşı düşüktür; şirkette kalanlara kıyasla daha fazla çalışmışlardır.
pandas'ta describe() fonksiyonu çeşitli özet istatistikleri elde etmede kullanışlıdır. Bu fonksiyon sayım, ortalama, standart sapma, minimum ve maksimum değerler ile çeyreklikleri döndürür.
data.describe()

Kaç çalışanın ayrıldığını kontrol edelim.
Burada, Matplotlib kullanarak bir çubuk grafik çizebilirsiniz. Çubuk grafik, ayrık değişken sayılarını göstermek için uygundur.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Şirketten Ayrılan Çalışanlar')
plt.ylabel('Çalışan Sayısı')
plt.show()
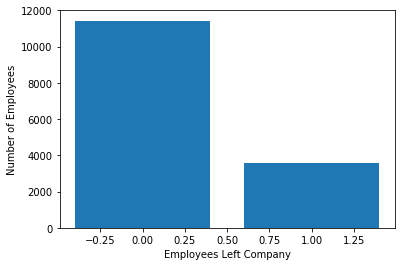
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Burada, yaklaşık 15.000 çalışandan 3.571'inin ayrıldığını ve 11.428'inin kaldığını görebilirsiniz. Ayrılan çalışanların sayısı toplam istihdamın %23'üdür.
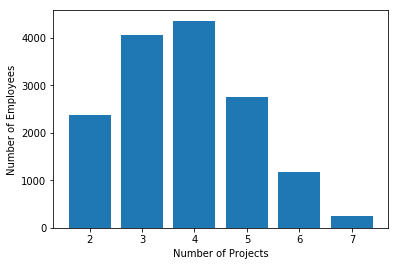
Benzer şekilde, kaç projede görevlendirildiklerine göre çalışan sayılarını göstermek için de bir çubuk grafik çizebilirsiniz.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Proje Sayısı')
plt.ylabel('Çalışan Sayısı')
plt.show()
Benzer şekilde, deneyim süresine göre çalışan sayılarını göstermek için de bir çubuk grafik çizebilirsiniz.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Şirkette Geçirilen Yıl Sayısı')
plt.ylabel('Çalışan Sayısı')
plt.show()
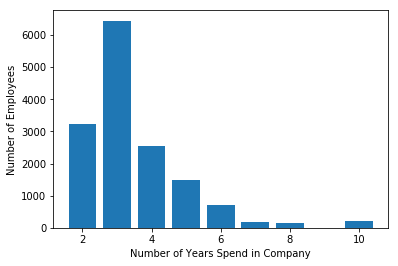
Çalışanların çoğunun deneyimi 2-4 yıl arasında. Ayrıca, 3 ve 4 yıl deneyimli çalışanlar arasında büyük bir fark var.
Özellikleri tek tek bu şekilde analiz edebilirsiniz, ancak bu zaman alıcı olur. Daha iyi bir seçenek, Seaborn kütüphanesini kullanarak alt grafiklerle tüm grafikleri tek seferde çizmektir.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
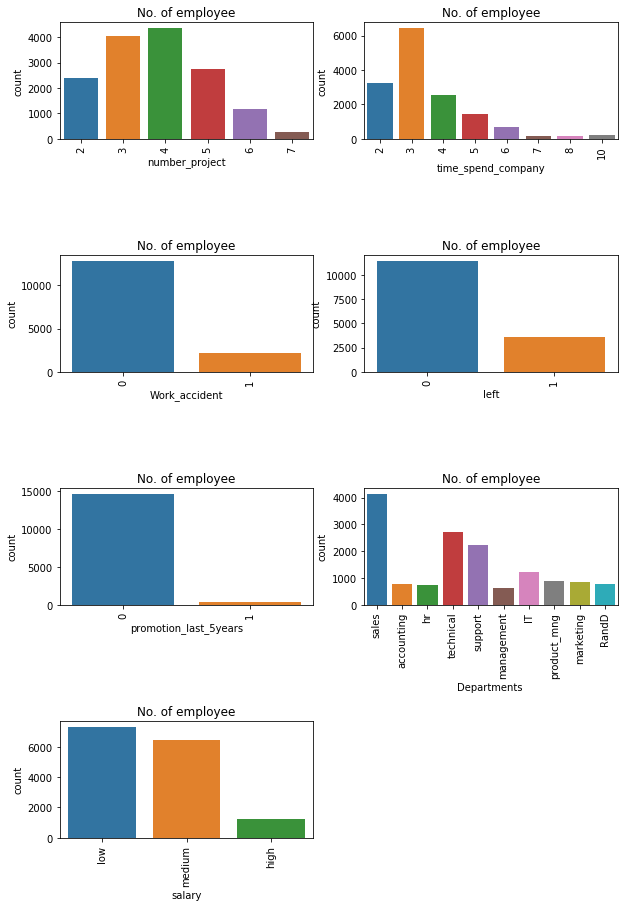
Yukarıdaki görselleştirmede aşağıdaki noktaları gözlemleyebilirsiniz:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
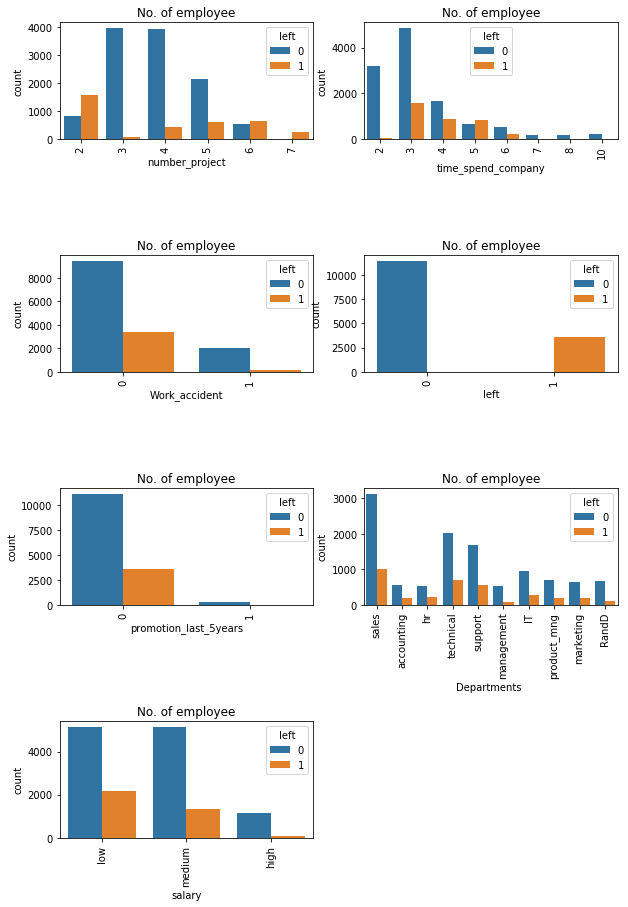
Yukarıdaki görselleştirmede aşağıdaki noktaları gözlemleyebilirsiniz:
Bir kişinin şirketten ayrılmasını en çok etkileyen özellikler şunlardır:
Ayrılan çalışan gruplarını bulalım. Bir çalışanın kalması veya ayrılması için en önemli faktörlerin şirketteki memnuniyet ve performans olduğunu gözlemleyebilirsiniz. Öyleyse bunları kümeleme analizi kullanarak gruplandıralım.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
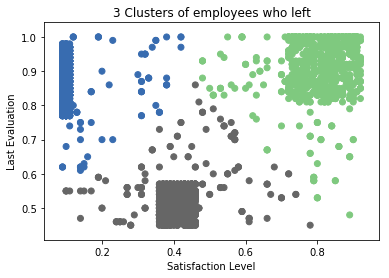
Burada, şirketten ayrılan çalışanlar 3 tür çalışanda gruplanabilir:
Pek çok makine öğrenimi algoritması sayısal girdi verisi gerektirir; bu nedenle kategorik sütunları sayısal olarak temsil etmeniz gerekir.
Bu veriyi kodlamak için, her değeri bir sayıya eşleyebilirsiniz. Örneğin Salary sütunu düşük:0, orta:1 ve yüksek:2 olarak temsil edilebilir.
Bu işleme etiket kodlama (label encoding) denir ve sklearn bunu LabelEncoder kullanarak sizin için kolayca yapar.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Burada preprocessing modülünü içe aktardınız ve bir LabelEncoder nesnesi oluşturdunuz. Bu LabelEncoder nesnesini kullanarak "salary" ve "Departments " sütunlarını sayısal sütunlara dönüştürüp fit ve transform işlemlerini uyguladınız.
Model performansını anlamak için veri kümesini eğitim ve test seti olarak ayırmak iyi bir stratejidir.
Veri kümesini train_test_split() fonksiyonunu kullanarak bölelim. 3 parametre iletmeniz gerekir: özellikler, hedef ve test seti boyutu. Ayrıca, kayıtları rastgele seçmek için random_state kullanabilirsiniz.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Burada, veri kümesi 70:30 oranında iki parçaya ayrılmıştır. Yani verinin %70'i model eğitimi, %30'u model testi için kullanılacaktır.
Bir çalışan devri tahmin modeli kuralım.
Burada devri, Gradient Boosting Classifier kullanarak tahmin edeceksiniz.
Önce GradientBoostingClassifier modülünü içe aktarın ve GradientBoostingClassifier() fonksiyonunu kullanarak bir Gradient Boosting sınıflandırıcı nesnesi oluşturun.
Ardından, modelinizi eğitim seti üzerinde fit() ile eğitin ve test seti üzerinde predict() kullanarak tahmin yapın.
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Güzel, %97'lik bir sınıflandırma oranı elde ettiniz; bu iyi bir doğruluk olarak kabul edilir.
Kesinlik (Precision): Kesinlik, modelinizin ne kadar isabetli olduğuyla ilgilidir. Başka bir deyişle, model bir tahminde bulunduğunda, bunun ne sıklıkla doğru olduğudur. Sizin tahmin durumunuzda, Gradient Boosting modeliniz bir çalışanın ayrılacağını tahmin ettiğinde, bu çalışan olguların %95'inde gerçekten ayrılmış.
Duyarlılık (Recall): Test setinde ayrılan bir çalışan varsa, Gradient Boosting modeliniz bunu vakaların %92'sinde tespit edebiliyor.
Tebrikler, bu eğitimin sonuna geldiniz!
Bu eğitimde Çalışan Devri nedir?, müşteri devrinden farkı nedir, matplotlib ve seaborn kullanarak çalışan devri veri kümesinin keşifsel veri analizi ve görselleştirmesini, ayrıca python scikit-learn paketi ile model kurma ve değerlendirmeyi öğrendiniz.
Her türlü geri bildirim veya sorunuzu duymaktan memnuniyet duyarım. Yorum bırakarak soru sorabilirsiniz; yanıtlamak için elimden gelenin en iyisini yapacağım.
Python hakkında daha fazla bilgi edinmekle ilgileniyorsanız, DataCamp'in Veri Bilimi için Orta Düzey Python kursuna göz atın.
Python hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




