Khóa học
Python nâng cao
4 giờ
1.4M
Trước đây, phần lớn sự tập trung là vào các “tỷ lệ” như tỷ lệ nghỉ việc (attrition) và tỷ lệ giữ chân. Các quản lý nhân sự (HR) tính toán các tỷ lệ trước đây và cố gắng dự đoán các tỷ lệ trong tương lai bằng công cụ kho dữ liệu. Những tỷ lệ này cho thấy tác động tổng hợp của churn, nhưng đó mới chỉ là một nửa bức tranh. Một cách tiếp cận khác là tập trung vào từng hồ sơ cá nhân bên cạnh mức tổng hợp.
Có rất nhiều nghiên cứu tình huống về churn khách hàng. Với churn khách hàng, bạn có thể dự đoán ai và khi nào khách hàng sẽ ngừng mua. Churn nhân sự tương tự churn khách hàng, nhưng tập trung vào nhân viên thay vì khách hàng. Ở đây, bạn có thể dự đoán ai và khi nào một nhân viên sẽ chấm dứt làm việc. Churn nhân sự rất tốn kém, và những cải tiến nhỏ cũng có thể mang lại kết quả đáng kể. Nó giúp chúng ta thiết kế các kế hoạch giữ chân tốt hơn và cải thiện mức độ hài lòng của nhân viên.
Churn nhân sự có thể được định nghĩa là sự thất thoát hay rời đi của tài sản trí tuệ khỏi một công ty hoặc tổ chức. Nói cách khác, khi nhân viên rời tổ chức thì được xem là churn. Một định nghĩa khác: khi một thành viên rời khỏi một quần thể, điều đó được gọi là churn.
Trong nghiên cứu, người ta thấy rằng churn nhân sự bị ảnh hưởng bởi tuổi, thâm niên, lương, mức độ hài lòng trong công việc, điều kiện làm việc, tiềm năng phát triển và cảm nhận của nhân viên về sự công bằng. Một số biến khác như tuổi, giới tính, sắc tộc, học vấn và tình trạng hôn nhân cũng là yếu tố quan trọng trong việc dự đoán churn. Ở một số trường hợp, nhân viên có kỹ năng chuyên biệt sẽ khó thay thế hơn, ảnh hưởng đến công việc đang diễn ra và năng suất của nhân viên hiện hữu. Tuyển dụng nhân viên mới để thay thế có chi phí như chi phí tuyển dụng và đào tạo. Ngoài ra, nhân viên mới cần thời gian để đạt trình độ kỹ thuật hay hiểu biết nghiệp vụ tương đương với nhân viên cũ. Các tổ chức giải quyết vấn đề này bằng cách áp dụng kỹ thuật học máy để dự đoán churn nhân sự, giúp họ đưa ra hành động cần thiết.
Các điểm sau giúp bạn hiểu churn nhân sự và churn khách hàng tốt hơn:
Doanh nghiệp chọn nhân viên để tuyển, còn trong marketing bạn không thể chọn khách hàng của mình.
Nhân viên là bộ mặt của công ty bạn, và tập thể nhân viên tạo ra mọi thứ công ty bạn làm.
Mất một khách hàng ảnh hưởng đến doanh thu và hình ảnh thương hiệu. Thu hút khách hàng mới khó và tốn kém hơn so với giữ chân khách hàng hiện có. Churn nhân sự cũng gây đau đầu cho doanh nghiệp và tổ chức. Nó đòi hỏi thời gian và công sức để tìm và đào tạo người thay thế.
Churn nhân sự có những động lực riêng so với churn khách hàng. Nó giúp chúng ta thiết kế các kế hoạch giữ chân nhân viên tốt hơn và cải thiện sự hài lòng. Các thuật toán khoa học dữ liệu có thể dự đoán churn trong tương lai.
Phân tích dữ liệu khám phá (EDA) là bước đầu trong quá trình phân tích, trong đó bạn tóm tắt các đặc trưng của dữ liệu như mẫu hình, xu hướng, giá trị ngoại lai và kiểm định giả thuyết thông qua thống kê mô tả và trực quan hóa.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineTrước tiên, hãy nạp tập dữ liệu HR cần thiết bằng hàm đọc CSV của pandas. Bạn có thể tải dữ liệu từ liên kết này.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Sau khi nạp tập dữ liệu, bạn có thể muốn biết thêm đôi chút về nó. Bạn có thể kiểm tra tên thuộc tính và kiểu dữ liệu bằng info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Bạn có thể mô tả chi tiết 10 thuộc tính như sau:
Trong tập dữ liệu này, có hai nhóm nhân viên: người ở lại và người rời công ty. Vì vậy, bạn có thể chia dữ liệu thành hai nhóm và so sánh đặc trưng của họ. Ở đây, bạn có thể tìm giá trị trung bình của cả hai nhóm bằng groupby() và mean().
left = data.groupby('left')
left.mean()

Từ đây có thể diễn giải rằng, nhân viên rời công ty có mức hài lòng thấp, tỷ lệ thăng chức thấp, lương thấp và làm việc nhiều hơn so với những người ở lại.
Hàm describe() trong pandas rất tiện lợi để lấy các thống kê tóm tắt. Hàm này trả về số lượng, trung bình, độ lệch chuẩn, giá trị nhỏ nhất và lớn nhất, cùng các phân vị của dữ liệu.
data.describe()

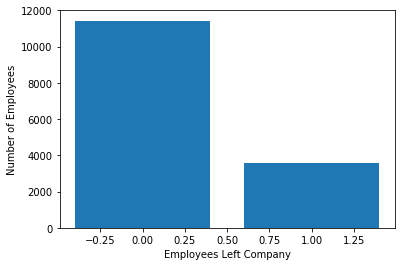
Hãy kiểm tra có bao nhiêu nhân viên đã rời công ty?
Ở đây, bạn có thể vẽ biểu đồ cột bằng Matplotlib. Biểu đồ cột phù hợp để hiển thị số đếm của biến rời rạc.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Employees Left Company')
plt.ylabel('Number of Employees')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Ở đây, bạn thấy trong khoảng 15.000 người thì có 3.571 người rời đi và 11.428 người ở lại. Số nhân viên rời đi chiếm 23% tổng số lao động.
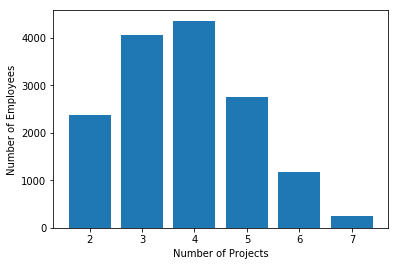
Tương tự, bạn có thể vẽ biểu đồ cột để đếm số nhân viên được phân bổ theo số lượng dự án.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Number of Projects')
plt.ylabel('Number of Employees')
plt.show()
Tương tự, bạn có thể vẽ biểu đồ cột để đếm số nhân viên theo mức thâm niên kinh nghiệm.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Number of Years Spend in Company')
plt.ylabel('Number of Employees')
plt.show()
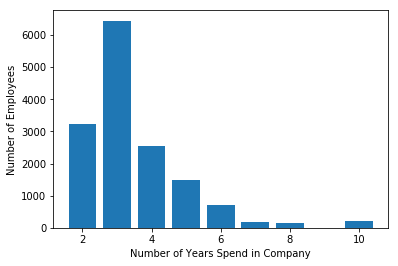
Phần lớn nhân viên có kinh nghiệm từ 2–4 năm. Ngoài ra, có một khoảng cách lớn giữa nhóm 3 năm và 4 năm kinh nghiệm.
Bạn có thể phân tích từng đặc trưng một, nhưng sẽ tốn thời gian. Lựa chọn tốt hơn là dùng thư viện Seaborn và vẽ tất cả biểu đồ trong một lần chạy bằng các subplot.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
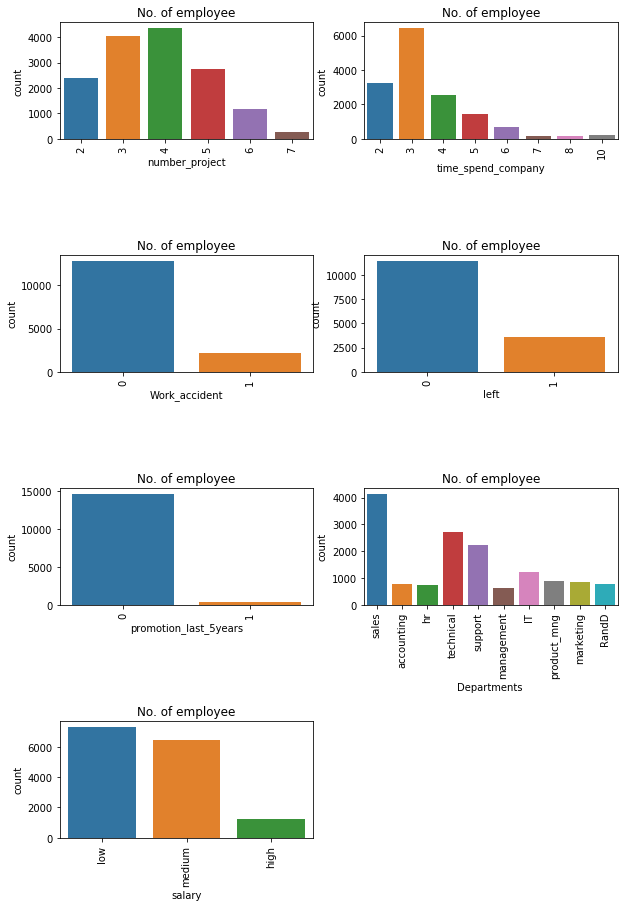
Bạn có thể quan sát những điểm sau trong hình trực quan trên:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
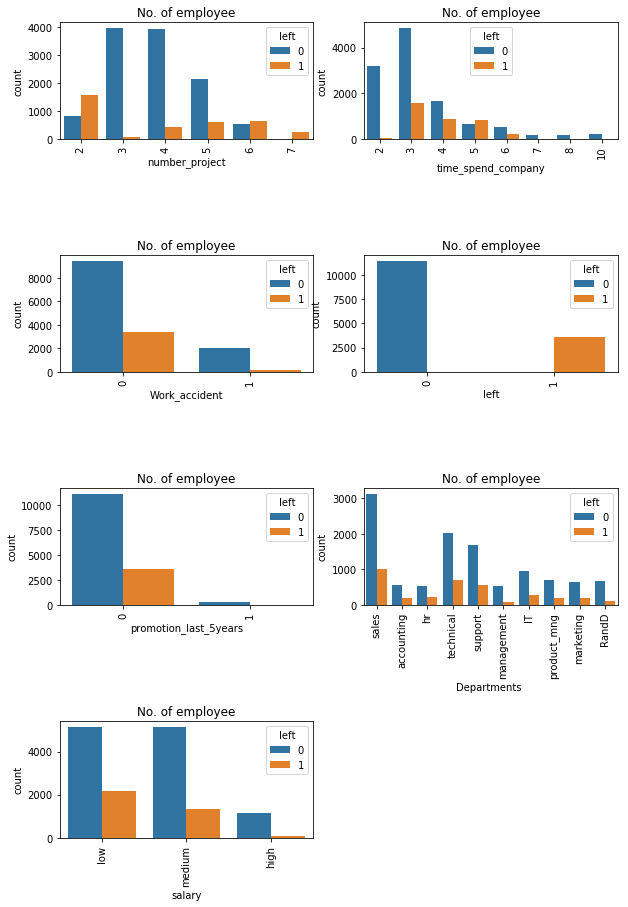
Bạn có thể quan sát những điểm sau trong hình trực quan trên:
Các đặc trưng sau ảnh hưởng nhiều nhất đến việc một người rời công ty:
Hãy tìm các nhóm nhân viên đã rời đi. Bạn có thể nhận thấy yếu tố quan trọng nhất để một nhân viên ở lại hay rời đi là mức hài lòng và hiệu suất trong công ty. Vậy hãy gom họ vào các nhóm bằng phân tích cụm.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
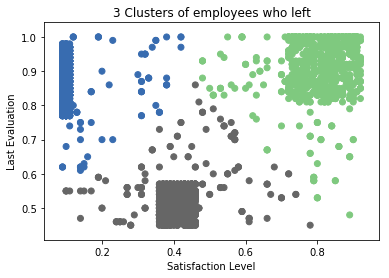
Ở đây, nhân viên rời công ty có thể được nhóm thành 3 loại:
Nhiều thuật toán học máy yêu cầu dữ liệu đầu vào dạng số, nên bạn cần biểu diễn các cột phân loại thành dạng số.
Để mã hóa dữ liệu này, bạn có thể ánh xạ mỗi giá trị sang một con số. Ví dụ, cột Salary có thể biểu diễn low:0, medium:1 và high:2.
Quy trình này gọi là mã hóa nhãn (label encoding), và sklearn hỗ trợ tiện lợi qua LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Ở đây, bạn đã nhập mô-đun preprocessing và tạo đối tượng Label Encoder. Dùng đối tượng này để fit và transform các cột "salary" và "Departments " thành cột số.
Để hiểu hiệu năng mô hình, chia tập dữ liệu thành tập huấn luyện và tập kiểm tra là một chiến lược tốt.
Hãy chia tập dữ liệu bằng hàm train_test_split(). Bạn cần truyền 3 tham số: đặc trưng, mục tiêu và kích thước tập kiểm tra. Ngoài ra, bạn có thể dùng random_state để chọn mẫu ngẫu nhiên.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Ở đây, tập dữ liệu được chia làm hai phần theo tỷ lệ 70:30. Tức là 70% dữ liệu dùng để huấn luyện mô hình và 30% để kiểm tra mô hình.
Hãy xây dựng một mô hình dự đoán churn nhân sự.
Ở đây, bạn sẽ dự đoán churn bằng Gradient Boosting Classifier.
Đầu tiên, nhập mô-đun GradientBoostingClassifier và tạo đối tượng bộ phân loại Gradient Boosting bằng hàm GradientBoostingClassifier().
Sau đó, fit mô hình trên tập huấn luyện bằng fit() và dự đoán trên tập kiểm tra bằng predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Bạn đạt tỷ lệ phân loại 97%, được xem là độ chính xác tốt.
Precision: Precision nói về mức độ chính xác, tức mô hình của bạn chính xác đến đâu. Nói cách khác, khi mô hình đưa ra dự đoán, thì đúng bao nhiêu lần. Trong trường hợp này, khi mô hình Gradient Boosting dự đoán một nhân viên sẽ rời đi, thì 95% thời gian nhân viên đó thực sự rời đi.
Recall: Nếu trong tập kiểm tra có một nhân viên đã rời đi, mô hình Gradient Boosting có thể nhận diện đúng 92% trường hợp đó.
Chúc mừng bạn đã hoàn thành bài hướng dẫn này!
Trong hướng dẫn này, bạn đã học Churn nhân sự là gì, nó khác churn khách hàng ra sao, EDA và trực quan hóa tập dữ liệu churn nhân sự bằng matplotlib và seaborn, xây dựng và đánh giá mô hình bằng gói python scikit-learn.
Rất mong nhận được phản hồi hoặc câu hỏi từ bạn. Bạn có thể đặt câu hỏi bằng cách để lại bình luận, tôi sẽ cố gắng phản hồi tốt nhất.
Nếu bạn quan tâm học thêm về Python, hãy xem khóa Intermediate Python for Data Science của DataCamp.
Tìm hiểu thêm về Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
