Curso
Python intermediário
4 h
1.4M
No passado, o foco maior era em “taxas” como taxa de rotatividade (attrition) e retenção. Gerentes de RH calculavam essas taxas históricas e tentavam prever as futuras usando ferramentas de data warehousing. Essas métricas mostram o impacto agregado do churn — mas contam só metade da história. Outra abordagem é olhar também para os registros individuais, além do agregado.
Há muitos estudos de caso sobre churn de clientes. Em churn de clientes, você prevê quem e quando vai parar de comprar. O churn de funcionários é semelhante, mas o foco é no colaborador em vez do cliente. Aqui, você pode prever quem e quando um funcionário vai encerrar o vínculo. O churn de funcionários é caro, e melhorias incrementais geram resultados significativos. Ele ajuda a desenhar planos de retenção mais eficazes e a aumentar a satisfação dos colaboradores.
Churn de funcionários pode ser definido como a saída — ou “vazamento” — de um ativo intelectual de uma empresa ou organização. Em outras palavras: quando colaboradores deixam a organização, isso é churn. De forma análoga, quando um membro deixa uma população, temos churn.
Pesquisas mostram que o churn de funcionários é afetado por idade, tempo de casa, remuneração, satisfação no trabalho, salário, condições de trabalho, potencial de crescimento e percepção de justiça. Outras variáveis como gênero, etnia, escolaridade e estado civil também são fatores importantes na previsão de churn. Em alguns casos, colaboradores com habilidades de nicho são mais difíceis de substituir, impactando o andamento dos trabalhos e a produtividade do time. Contratar substitutos tem custos (recrutamento e treinamento) e o novo colaborador precisa de tempo para atingir o mesmo nível de proficiência técnica ou de negócio do profissional anterior. Para lidar com isso, muitas organizações aplicam técnicas de machine learning para prever churn e, assim, agir com antecedência.
Os pontos a seguir ajudam a entender melhor as diferenças entre churn de cliente e churn de funcionário:
No RH, a empresa escolhe quem contratar; no marketing, você não escolhe seus clientes.
Os colaboradores são a cara da sua empresa e, juntos, produzem tudo o que a companhia entrega.
Perder um cliente afeta receita e imagem de marca. Ganhar novos clientes é mais difícil e custoso do que reter os atuais. O churn de funcionários também dói: exige tempo e esforço para encontrar e treinar um substituto.
O churn de funcionários tem dinâmicas próprias quando comparado ao churn de clientes. Entendê-las ajuda a criar planos de retenção mais eficientes e a elevar a satisfação interna. Algoritmos de data science podem prever o churn futuro.
A análise exploratória de dados é o processo inicial em que você resume características do conjunto de dados — padrões, tendências, outliers — e testa hipóteses usando estatística descritiva e visualização.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineVamos carregar o dataset de RH com a função read_csv do pandas. Você pode baixar os dados por este link.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Depois de carregar o dataset, é útil saber um pouco mais sobre ele. Você pode verificar nomes de atributos e tipos de dados usando info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Descrição dos 10 atributos:
No dataset, há dois tipos de colaboradores: os que ficaram e os que saíram. Podemos dividir em dois grupos e comparar suas características. Aqui, calculamos as médias de cada grupo usando groupby() e mean().
left = data.groupby('left')
left.mean()

Interpretando: quem saiu tinha satisfação mais baixa, menor taxa de promoção, salários mais baixos e trabalhava mais horas do que quem ficou.
A função describe() no pandas é prática para obter estatísticas-resumo: contagem, média, desvio padrão, valores mínimo e máximo e quantis.
data.describe()

Vamos ver quantos colaboradores saíram.
Aqui, usamos um gráfico de barras com Matplotlib. Esse tipo de gráfico é ótimo para contagens de variáveis discretas.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Colaboradores que saíram')
plt.ylabel('Número de colaboradores')
plt.show()
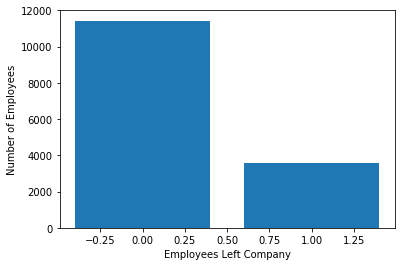
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Dos ~15.000, cerca de 3.571 saíram e 11.428 ficaram. Ou seja, 23% do total saiu.
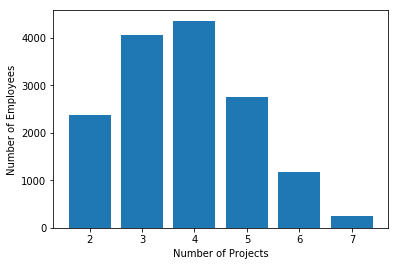
Também podemos contar quantos colaboradores atuam em cada quantidade de projetos.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Número de projetos')
plt.ylabel('Número de colaboradores')
plt.show()
Também podemos analisar a distribuição por tempo de empresa (experiência).
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Anos de empresa')
plt.ylabel('Número de colaboradores')
plt.show()
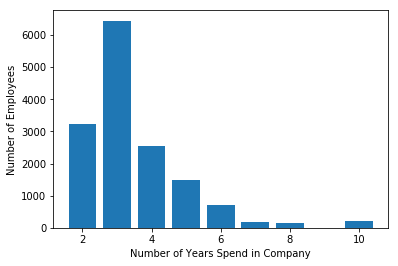
A maioria tem entre 2 e 4 anos de casa. Há também um grande salto entre 3 e 4 anos.
Analisar recurso por recurso funciona, mas consome tempo. Uma opção melhor é usar a biblioteca Seaborn e plotar tudo de uma vez com subplots.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
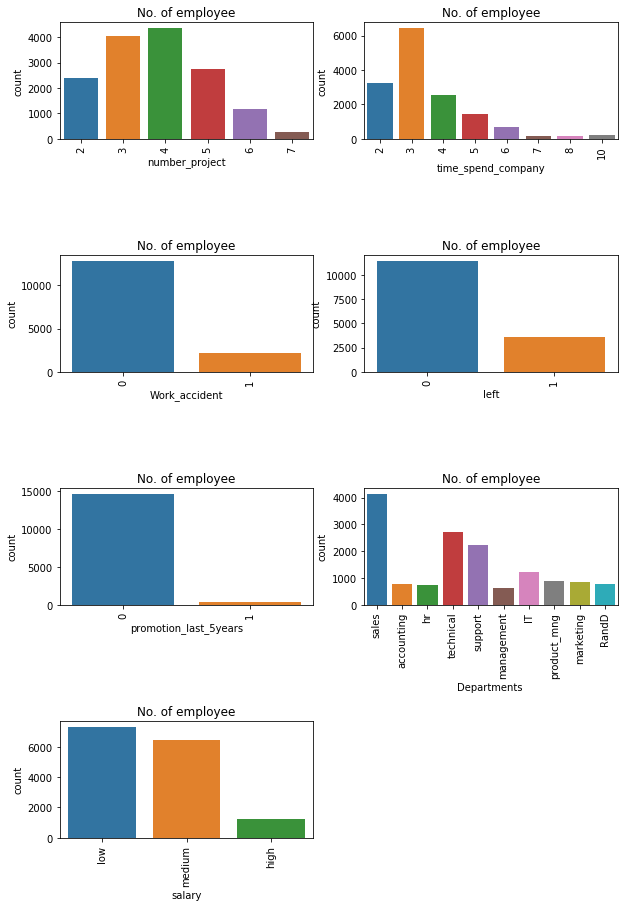
Observações a partir da visualização acima:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
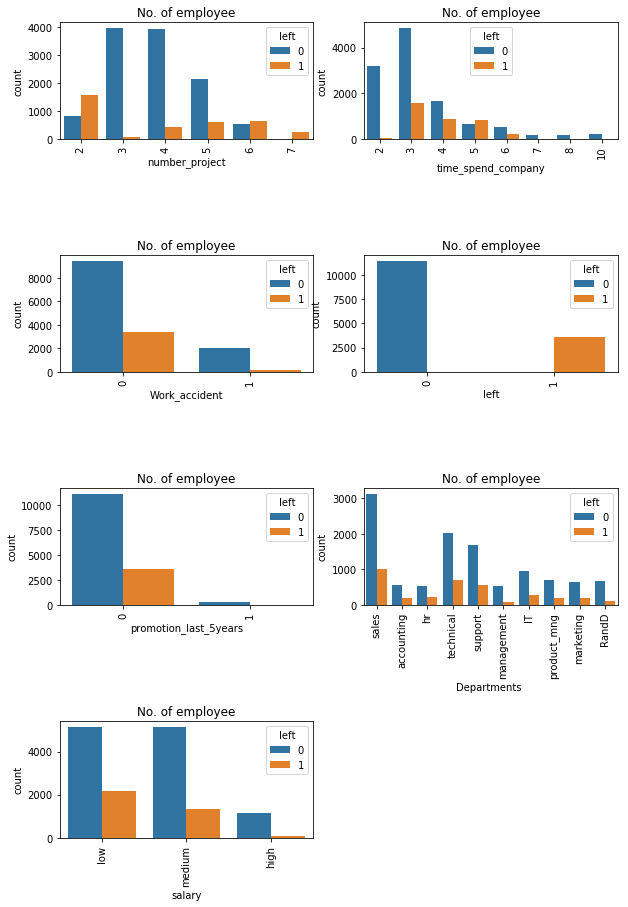
Mais insights a partir do gráfico:
Fatores que mais influenciam alguém a deixar a empresa:
Vamos identificar grupos entre os que saíram. Satisfação e desempenho parecem ser os fatores mais importantes para ficar ou sair. Então, vamos agrupá-los via clusterização.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
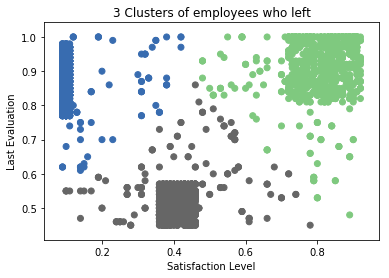
Entre os que saíram, podemos identificar 3 perfis:
Muitos algoritmos de machine learning exigem entradas numéricas, então precisamos converter colunas categóricas em numéricas.
Para codificar, podemos mapear cada valor para um número. Ex.: na coluna Salary, low:0, medium:1, high:2.
Esse processo é chamado de label encoding, e o sklearn facilita isso com o LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Aqui, importamos o módulo de pré-processamento e criamos um LabelEncoder. Com ele, aplicamos fit_transform para converter as colunas "salary" e "Departments " em valores numéricos.
Para avaliar o desempenho do modelo, é boa prática dividir o dataset em treino e teste.
Vamos usar train_test_split(). Você precisa passar 3 parâmetros: features, target e tamanho do conjunto de teste. Opcionalmente, use random_state para aleatoriedade reprodutível.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Aqui, o dataset foi dividido em 70:30 — 70% para treinar e 30% para testar.
Vamos construir um modelo para prever o churn de funcionários.
Usaremos um Gradient Boosting Classifier.
Primeiro, importe o módulo e crie o objeto do classificador com GradientBoostingClassifier().
Depois, ajuste no conjunto de treino com fit() e gere previsões no teste com predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Excelente: a taxa de acerto foi de 97%, uma ótima precisão geral.
Precisão (Precision): mede quão corretas são as previsões positivas. No nosso caso, quando o modelo previu que alguém sairia, isso ocorreu em 95% das vezes.
Revocação (Recall): entre os funcionários que de fato saíram no conjunto de teste, o modelo identificou 92% deles.
Parabéns por chegar até o fim deste tutorial!
Você aprendeu o que é churn de funcionários, como ele difere do churn de clientes, como fazer análise exploratória e visualização do dataset com matplotlib e seaborn, e como construir e avaliar modelos com o scikit-learn em Python.
Fico no aguardo de feedbacks e perguntas. Deixe um comentário e farei o possível para responder.
Se quiser se aprofundar em Python, confira o curso Intermediate Python for Data Science da DataCamp.
Aprenda mais sobre Python
Curso
Curso
Curso
blog
Javier Canales Luna
13 min
blog
Armstrong Asenavi
15 min
Tutorial
Moez Ali
9 min
Tutorial
Karlijn Willems
14 min
Tutorial
Abid Ali Awan
6 min
Tutorial
Thushan Ganegedara
15 min