Cours
Python intermédiaire
4 h
1.4M
Par le passé, l’attention se portait surtout sur des « taux » comme le taux d’attrition et le taux de rétention. Les responsables RH calculaient les taux historiques et tentaient d’anticiper les taux futurs avec des outils de stockage et d’analyse de données. Ces indicateurs mesurent l’impact global du churn, mais ne racontent que la moitié de l’histoire. Une autre approche consiste à analyser, en plus de l’agrégé, les enregistrements individuels.
On trouve de nombreuses études de cas sur le churn client. Dans ce contexte, l’objectif est de prédire qui et quand un client cessera d’acheter. Le churn des employés est comparable, mais centré sur les collaborateurs. Ici, vous cherchez à prédire qui et quand un employé mettra fin à sa collaboration. Le churn des employés est coûteux, et de petites améliorations peuvent avoir un fort impact. Cela permet d’élaborer de meilleurs plans de rétention et d’améliorer la satisfaction des employés.
Le churn des employés peut être défini comme la fuite ou le départ d’un actif intellectuel d’une entreprise ou d’une organisation. Plus simplement, lorsque des employés quittent l’organisation, on parle de churn. D’un point de vue populations, lorsqu’un individu quitte la population, on parle de churn.
La recherche montre que le churn des employés est influencé par l’âge, l’ancienneté, la rémunération, la satisfaction au travail, le salaire, les conditions de travail, le potentiel d’évolution et le sentiment d’équité. D’autres variables comme l’âge, le genre, l’origine, le niveau d’études et la situation matrimoniale jouent aussi un rôle. Certains profils rares sont plus difficiles à remplacer, ce qui affecte l’activité en cours et la productivité des équipes en place. Recruter un remplaçant a un coût (recrutement, formation), et il faut du temps pour atteindre le niveau d’expertise technique ou métier d’un collaborateur expérimenté. Les organisations s’attaquent à ce problème en appliquant des techniques d’apprentissage automatique pour prédire le churn, afin de prendre les mesures nécessaires.
Voici quelques points pour mieux comprendre le churn employé vs client :
En entreprise, vous choisissez les employés que vous embauchez, alors qu’en marketing vous ne choisissez pas vos clients.
Les employés sont le visage de votre entreprise et, collectivement, réalisent tout ce que votre entreprise produit.
Perdre un client affecte le chiffre d’affaires et l’image de marque. Acquérir de nouveaux clients est plus difficile et coûteux que de retenir les clients existants. Le churn des employés est tout aussi douloureux pour les organisations : trouver et former un remplaçant demande du temps et des efforts.
Le churn des employés a des dynamiques propres par rapport au churn client. L’analyser aide à concevoir de meilleurs plans de rétention et à améliorer la satisfaction. Les algorithmes de data science permettent d’anticiper le churn futur.
L’analyse exploratoire des données est la phase initiale où l’on résume les caractéristiques des données (motifs, tendances, valeurs aberrantes) et où l’on teste des hypothèses grâce aux statistiques descriptives et à la visualisation.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineCommençons par charger le jeu de données RH requis avec la fonction read_csv de pandas. Vous pouvez télécharger les données via ce lien.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Après avoir chargé le jeu de données, vous voudrez en savoir un peu plus. Consultez les noms d’attributs et types de données avec info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Description détaillée des 10 attributs :
Dans ce jeu de données, vous avez deux types d’employés : ceux qui sont restés et ceux qui ont quitté l’entreprise. Vous pouvez donc scinder les données en deux groupes et comparer leurs caractéristiques. Calculez ensuite la moyenne des deux groupes avec groupby() et mean().
left = data.groupby('left')
left.mean()

Interprétation : les employés qui ont quitté l’entreprise présentent un niveau de satisfaction plus faible, un taux de promotion plus bas, des salaires plus faibles et travaillent davantage que ceux qui sont restés.
La fonction describe() de pandas est pratique pour obtenir des statistiques récapitulatives. Elle renvoie le nombre de valeurs, la moyenne, l’écart type, les valeurs min et max, ainsi que les quantiles.
data.describe()

Voyons combien d’employés sont partis.
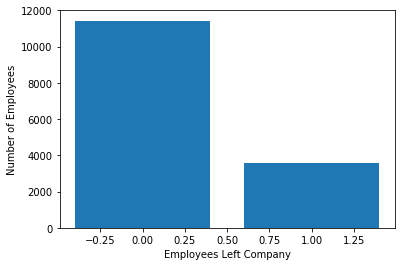
Ici, vous pouvez tracer un diagramme en barres avec Matplotlib. Il est adapté pour afficher des effectifs de variables discrètes.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Employés ayant quitté')
plt.ylabel("Nombre d'employés")
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
On observe qu’environ 3 571 sur 15 000 sont partis, et 11 428 sont restés. Les départs représentent 23 % de l’effectif total.
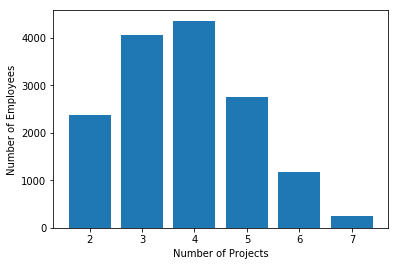
De même, tracez un diagramme en barres pour compter le nombre d’employés selon le nombre de projets.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Nombre de projets')
plt.ylabel("Nombre d'employés")
plt.show()
Tracez également un diagramme en barres du nombre d’employés par niveau d’ancienneté.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel("Nombre d'années passées dans l'entreprise")
plt.ylabel("Nombre d'employés")
plt.show()
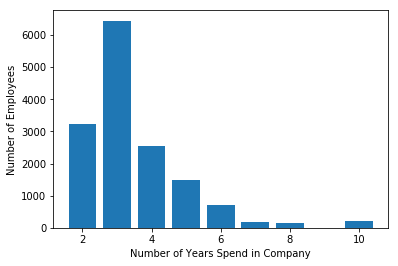
La majorité des employés ont entre 2 et 4 ans d’expérience. On note aussi un écart marqué entre 3 et 4 ans d’ancienneté.
Analyser les variables une par une prend du temps. Mieux vaut utiliser la bibliothèque Seaborn et tracer tous les graphiques en une seule exécution grâce aux sous-graphiques.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("Nb. d'employés")
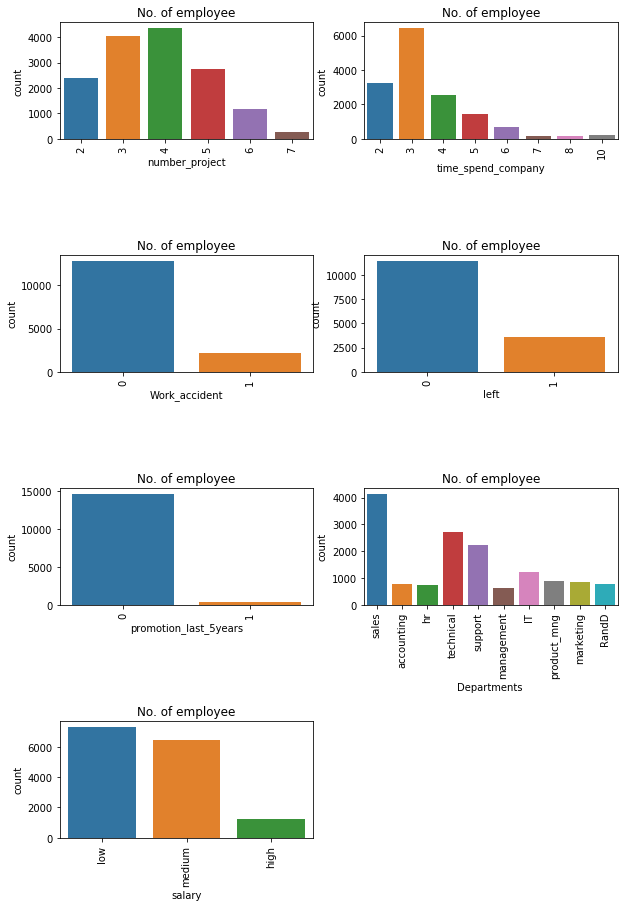
On peut tirer les enseignements suivants de la visualisation ci-dessus :
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("Nb. d'employés")
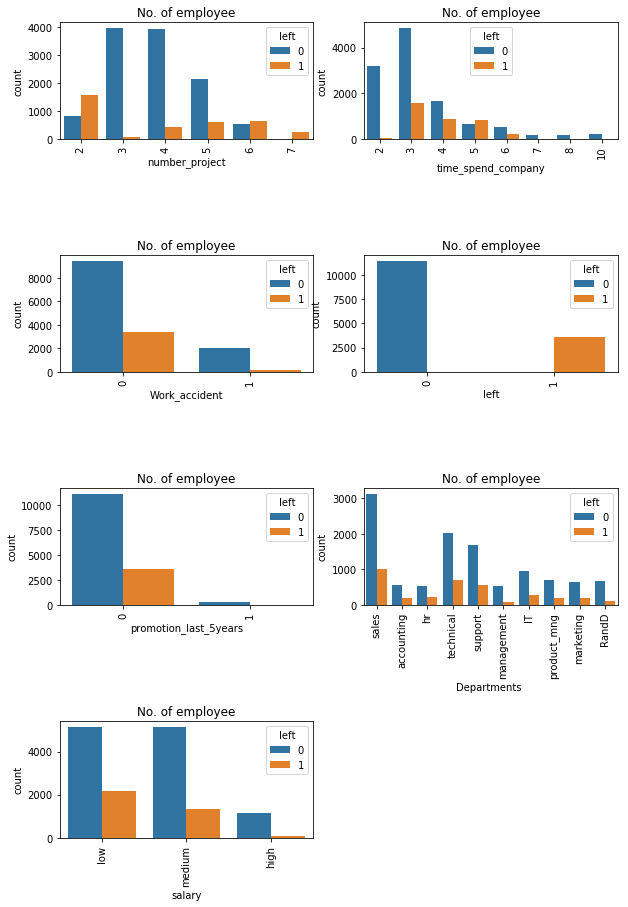
Ce que l’on observe :
Les facteurs suivants influencent le plus la décision de quitter l’entreprise :
Identifions les groupes d’employés qui sont partis. Les facteurs essentiels pour rester ou partir sont la satisfaction et la performance. Regroupons-les via une analyse par clusters.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
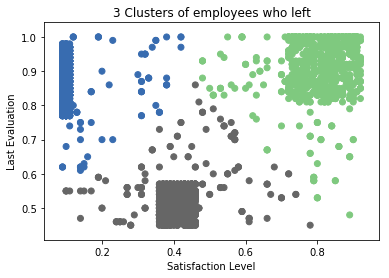
Ici, les employés partis se répartissent en 3 profils :
De nombreux algorithmes d’apprentissage automatique exigent des données numériques ; il faut donc convertir les colonnes catégorielles en variables numériques.
Pour encoder, on peut par exemple mapper Salary ainsi : low : 0, medium : 1, high : 2.
Ce procédé s’appelle le label encoding, et sklearn le gère facilement via LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Ici, vous importez le module preprocessing et créez un objet LabelEncoder. Vous l’utilisez pour ajuster et transformer les colonnes "salary" et "Departments " en numériques.
Pour évaluer les performances du modèle, il est recommandé de diviser le jeu de données en ensemble d’entraînement et de test.
Utilisons train_test_split(). Vous devez passer 3 paramètres : caractéristiques, cible et taille de l’ensemble de test. Vous pouvez ajouter random_state pour un tirage reproductible.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Le jeu de données est scindé en deux parties selon un ratio de 70/30 : 70 % pour l’entraînement et 30 % pour le test.
Construisons un modèle de prédiction du churn des employés.
Nous allons utiliser un Gradient Boosting Classifier.
Commencez par importer le module GradientBoostingClassifier et créez l’objet de modèle avec GradientBoostingClassifier().
Entraînez le modèle sur l’ensemble d’apprentissage avec fit() puis prédisez sur l’ensemble de test avec predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Vous obtenez un taux de classification de 97 %, ce qui correspond à une excellente précision.
Précision (precision) : indique à quel point le modèle est précis lorsqu’il prédit un positif. Dans notre cas, lorsqu’il prédit qu’un employé va partir, cela s’avère correct dans 95 % des cas.
Rappel (recall) : parmi les employés partis présents dans l’ensemble de test, le modèle en identifie 92 %.
Félicitations, vous êtes arrivé au terme de ce tutoriel !
Vous avez découvert ce qu’est le churn des employés, en quoi il diffère du churn client, comment mener une analyse exploratoire et visualiser le jeu de données avec matplotlib et seaborn, puis comment construire et évaluer un modèle avec le package scikit-learn de Python.
Vos retours et questions sont les bienvenus. Laissez un commentaire : je ferai de mon mieux pour vous répondre.
Si vous souhaitez approfondir Python, découvrez le cours DataCamp Intermediate Python for Data Science.
Approfondir Python
Cours
Cours
Cours