Curso
Python intermedio
4 h
1.4M
Tradicionalmente, la atención se ha centrado en "tasas" como la de rotación y la de retención. Los responsables de RR. HH. calculaban las tasas pasadas e intentaban prever las futuras con herramientas de data warehousing. Estas tasas muestran el impacto agregado del churn, pero solo cuentan la mitad de la historia. Otra forma de abordar el problema es analizar también los registros individuales además del agregado.
Abundan los casos prácticos sobre churn de clientes: en ese contexto, puedes predecir quién y cuándo dejará de comprar. El churn de empleados es similar, pero se centra en la plantilla en lugar de los clientes. Aquí puedes predecir quién y cuándo dará por terminada su relación laboral. El churn de empleados es costoso, y pequeñas mejoras generan grandes resultados. Ayuda a diseñar mejores planes de retención y a aumentar la satisfacción del equipo.
El churn de empleados puede definirse como la fuga o salida de un activo intelectual de una empresa u organización. Dicho de forma sencilla: cuando las personas dejan la organización, hablamos de churn. Otra definición general: cuando un miembro abandona una población, se produce churn.
La investigación muestra que el churn de empleados está influido por la edad, la antigüedad, la remuneración, la satisfacción en el puesto, el salario, las condiciones de trabajo, el potencial de crecimiento y la percepción de equidad. Otras variables como la edad, el género, la etnia, la formación o el estado civil también son relevantes para predecir el churn. En algunos casos, los perfiles con habilidades muy específicas son más difíciles de sustituir, lo que afecta al trabajo en curso y a la productividad del resto del equipo. Incorporar sustitutos conlleva costes de contratación y formación. Además, la persona recién incorporada necesitará tiempo para alcanzar el mismo nivel de conocimiento técnico o de negocio que tenía quien se fue. Para afrontar este problema, muchas organizaciones aplican técnicas de machine learning que predicen el churn de empleados y facilitan la toma de decisiones.
Estos puntos te ayudarán a entender mejor las diferencias entre el churn de clientes y el de empleados:
En el negocio, eliges a quién contratas; en marketing, no eliges a tus clientes.
Las personas son la cara de tu empresa y, en conjunto, son quienes hacen posible todo lo que produces.
Perder un cliente afecta a los ingresos y a la marca. Captar clientes nuevos es más difícil y caro que retener a los actuales. El churn de empleados también es doloroso para cualquier organización: requiere tiempo y esfuerzo encontrar y formar a la sustitución.
El churn de empleados tiene dinámicas propias frente al churn de clientes. Analizarlo ayuda a diseñar mejores planes de retención y a mejorar la satisfacción. Con algoritmos de ciencia de datos podemos predecir el churn futuro.
El análisis exploratorio de datos es el proceso inicial en el que resumimos las características de los datos —patrones, tendencias, valores atípicos e hipótesis— mediante estadística descriptiva y visualización.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlinePrimero carguemos el dataset de RR. HH. con la función read_csv de pandas. Puedes descargar los datos en este enlace.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Una vez cargado el dataset, quizá quieras conocerlo un poco más. Puedes consultar los nombres de atributos y tipos de dato con info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Descripción de los 10 atributos:
En el dataset tenemos dos tipos de empleados: quienes se quedaron y quienes se marcharon. Podemos dividir los datos en dos grupos y comparar sus características. Aquí calculamos el promedio de ambos grupos con groupby() y mean().
left = data.groupby('left')
left.mean()

Se observa que quienes dejaron la empresa tenían menor satisfacción, menos promociones, salarios más bajos y trabajaban más horas que quienes se quedaron.
La función describe() de pandas es muy útil para obtener estadísticas resumidas: devuelve el recuento, media, desviación estándar, valores mínimo y máximo y cuantiles.
data.describe()

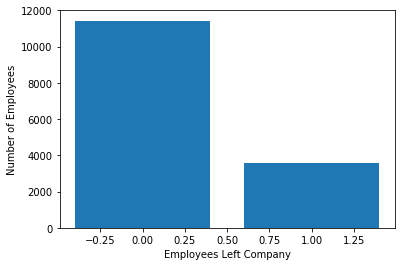
Veamos cuántos empleados se marcharon.
Podemos dibujar un gráfico de barras con Matplotlib. Es adecuado para mostrar recuentos de variables discretas.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Empleados que dejaron la empresa')
plt.ylabel('Número de empleados')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Aquí vemos que, de unos 15.000 empleados, 3.571 se marcharon y 11.428 se quedaron. Quienes se marcharon representan el 23 % del total.
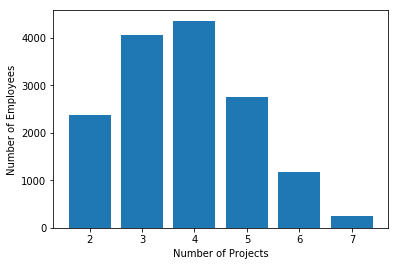
De igual forma, podemos representar cuántas personas trabajan en cada número de proyectos.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Número de proyectos')
plt.ylabel('Número de empleados')
plt.show()
También podemos representar cuántas personas hay según su antigüedad.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Años en la empresa')
plt.ylabel('Número de empleados')
plt.show()
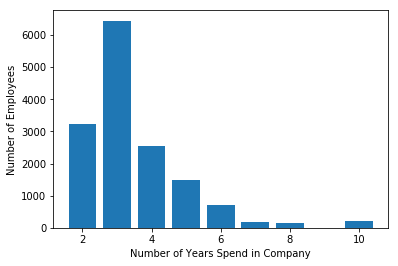
La mayoría acumula entre 2 y 4 años de experiencia. Además, hay una gran caída entre 3 y 4 años.
Analizar las variables una a una es lento. Mejor emplear Seaborn y generar todas las gráficas de una vez con subplots.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
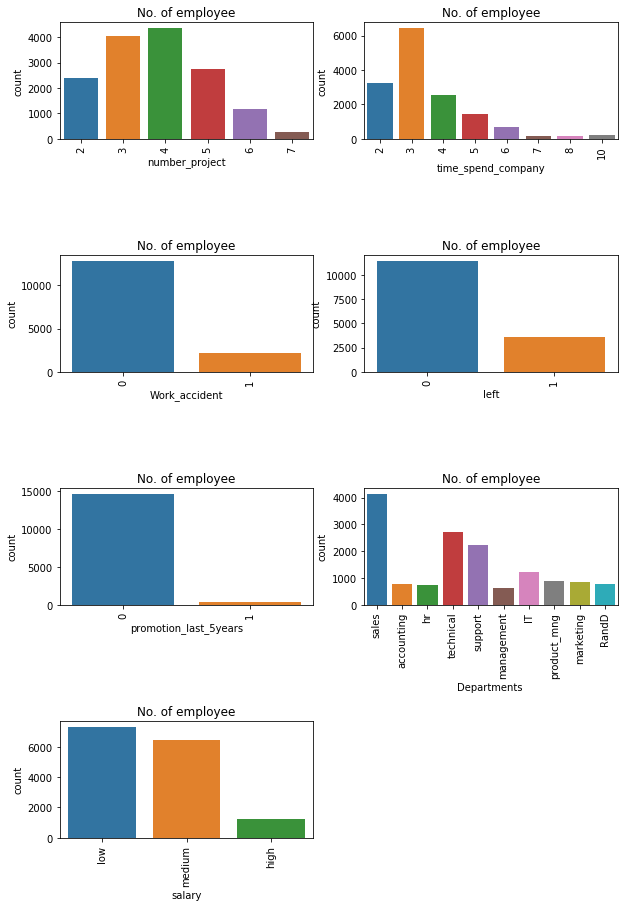
Observaciones de la visualización anterior:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
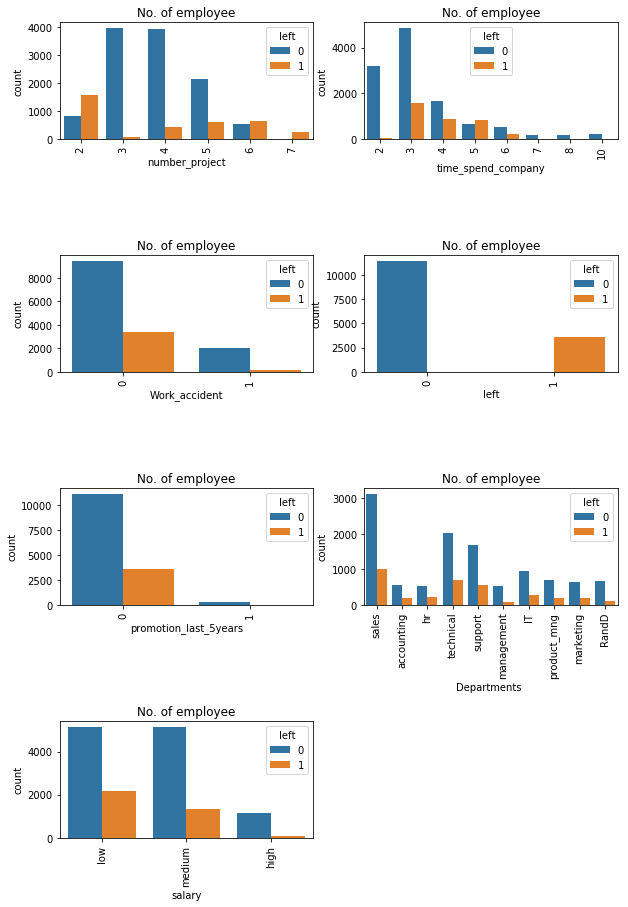
Más observaciones:
Factores que más influyen en que alguien deje la empresa:
Identifiquemos grupos entre quienes se marcharon. Los factores más importantes para quedarse o irse son la satisfacción y el desempeño. Agrupemos a las personas según estas variables con análisis de clústeres.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
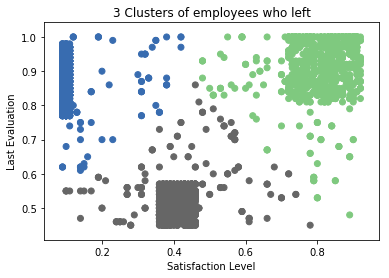
Entre quienes se marcharon, se aprecian 3 tipos de perfiles:
Muchos algoritmos de machine learning requieren entradas numéricas, así que hay que transformar las columnas categóricas en numéricas.
Para codificarlas, puedes mapear cada valor a un número. Por ejemplo, en salary: low:0, medium:1 y high:2.
Este proceso se llama label encoding y sklearn lo facilita con LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Aquí importamos el módulo preprocessing y creamos un objeto LabelEncoder. Con él transformamos las columnas "salary" y "Departments " a formato numérico.
Para evaluar el rendimiento del modelo, es buena práctica separar el dataset en entrenamiento y prueba.
Usemos train_test_split(). Hay que pasarle tres parámetros: características, objetivo y tamaño del conjunto de prueba. Además, random_state permite seleccionar registros de forma reproducible.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
El dataset se divide en una proporción 70:30: el 70 % para entrenar y el 30 % para probar.
Vamos a construir un modelo de predicción de churn de empleados.
Usaremos un Gradient Boosting Classifier.
Primero importa el módulo GradientBoostingClassifier y crea el objeto con GradientBoostingClassifier().
Después, ajusta el modelo con fit() sobre el conjunto de entrenamiento y realiza predicciones sobre el de prueba con predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Has obtenido una tasa de acierto del 97 %, una precisión muy buena.
Precisión: indica lo certero que es el modelo cuando predice positivos. En este caso, cuando el modelo de Gradient Boosting predijo que una persona se iba a marchar, acertó el 95 % de las veces.
Exhaustividad (recall): de entre quienes se marcharon presentes en el conjunto de prueba, el modelo los identificó en el 92 % de los casos.
¡Enhorabuena! Has llegado al final de este tutorial.
Has aprendido qué es el churn de empleados, en qué se diferencia del churn de clientes, cómo hacer análisis exploratorio y visualización del dataset con matplotlib y seaborn, y cómo construir y evaluar un modelo con el paquete scikit-learn de Python.
Me encantará leer tus comentarios o dudas. Déjalos abajo y haré lo posible por responder.
Si quieres seguir aprendiendo Python, echa un vistazo al curso Intermediate Python for Data Science de DataCamp.
Más sobre Python
Curso
Curso
Curso
Tutorial
Thushan Ganegedara
15 min
Tutorial
Duong Vu
11 min
Tutorial
Moez Ali
9 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Abid Ali Awan
6 min
Tutorial
Kevin Babitz
8 min