Cursus
Python voor gemiddeld niveau
4 uur
1.4M
Vroeger lag de nadruk vooral op ‘rates’ zoals verloop- en retentiecijfers. HR-managers berekenen de eerdere cijfers en proberen met datawarehousingtools de toekomstige cijfers te voorspellen. Deze percentages tonen de totale impact van verloop, maar dat is maar de halve waarheid. Een andere aanpak is om, naast het totaalplaatje, ook naar individuele records te kijken.
Er zijn veel casestudy’s over klantverloop beschikbaar. Bij klantverloop kun je voorspellen wie en wanneer een klant stopt met kopen. Verloop van medewerkers lijkt daarop, maar richt zich op de medewerker in plaats van de klant. Hier kun je voorspellen wie, en wanneer een medewerker zijn dienstverband beëindigt. Verloop is kostbaar en kleine verbeteringen leveren al significante resultaten op. Het helpt bij het ontwerpen van betere retentieplannen en het verhogen van medewerkerstevredenheid.
Verloop van medewerkers kun je zien als het weglekken of vertrek van een intellectueel kapitaal uit een bedrijf of organisatie. Simpeler gezegd: wanneer medewerkers de organisatie verlaten, noemen we dat verloop. Een andere definitie: wanneer een lid een populatie verlaat, spreken we van verloop.
Uit onderzoek blijkt dat verloop wordt beïnvloed door leeftijd, diensttijd, beloning, werktevredenheid, salaris, arbeidsomstandigheden, doorgroeimogelijkheden en de perceptie van eerlijkheid. Andere variabelen zoals leeftijd, geslacht, etniciteit, opleiding en burgerlijke staat bleken belangrijk bij de voorspelling van verloop. In sommige gevallen zijn medewerkers met nichevaardigheden lastiger te vervangen. Dat heeft impact op lopend werk en de productiviteit van bestaande medewerkers. Nieuwe medewerkers werven en inwerken kost geld, zoals wervings- en trainingskosten. Ook heeft een nieuwe medewerker tijd nodig om vaardigheden te ontwikkelen tot het niveau van de technisch of zakelijk ervaren collega die vertrekt. Organisaties pakken dit aan met machine learning om verloop te voorspellen en tijdig in te grijpen.
De volgende punten helpen om verloop van medewerkers en klanten beter te begrijpen:
Bij werving kies je als bedrijf de medewerker; in marketing kies je je klanten niet.
Medewerkers zijn het gezicht van je bedrijf en samen realiseren zij alles wat je bedrijf doet.
Een klant verliezen raakt omzet en merkbeeld. Nieuwe klanten werven is lastiger en duurder dan bestaande behouden. Verloop van medewerkers is ook pijnlijk voor organisaties. Het kost tijd en moeite om een vervanger te vinden en op te leiden.
Verloop van medewerkers heeft een eigen dynamiek ten opzichte van klantverloop. Inzicht hierin helpt bij betere retentieplannen en hogere medewerkerstevredenheid. Data science-algoritmes kunnen toekomstig verloop voorspellen.
Exploratory Data Analysis is een eerste analysefase waarin je kenmerken van data samenvat, zoals patronen, trends, uitschieters en hypothesetoetsing met beschrijvende statistiek en visualisatie.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineLaten we eerst de benodigde HR-dataset laden met de read CSV-functie van pandas. Je kunt de data downloaden via deze link.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Na het laden wil je wellicht wat meer over de dataset weten. Je kunt kolomnamen en datatypes bekijken met info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
De 10 attributen kun je als volgt beschrijven:
In de dataset zijn er twee soorten medewerkers: zij die zijn gebleven en zij die zijn vertrokken. Je kunt de data dus in twee groepen splitsen en hun kenmerken vergelijken. Met groupby() en mean() vind je het gemiddelde van beide groepen.
left = data.groupby('left')
left.mean()

Hieruit kun je afleiden dat medewerkers die het bedrijf hebben verlaten een lagere tevredenheid, lagere promotiekans, lager salaris hadden en meer werkten dan wie bleef.
De functie describe() in pandas is handig voor samenvattende statistiek. Deze functie geeft het aantal, gemiddelde, standaarddeviatie, minimum- en maximumwaarden en de kwartielen terug.
data.describe()

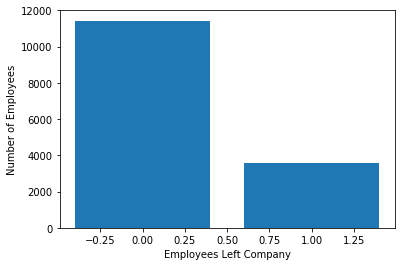
Laten we kijken hoeveel medewerkers zijn vertrokken.
Hiervoor kun je een staafdiagram plotten met Matplotlib. Een staafdiagram is geschikt om aantallen van discrete variabelen te tonen.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Employees Left Company')
plt.ylabel('Number of Employees')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Je ziet hier dat van ongeveer 15.000 medewerkers er 3.571 zijn vertrokken en 11.428 zijn gebleven. Het aantal vertrokken medewerkers is 23% van het totaal.
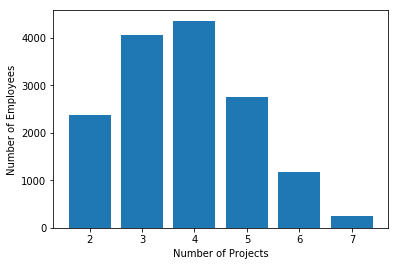
Op vergelijkbare wijze kun je ook een staafdiagram maken om te tellen hoeveel medewerkers op hoeveel projecten zijn ingezet.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Number of Projects')
plt.ylabel('Number of Employees')
plt.show()
Ook kun je een staafdiagram maken om te tellen hoeveel medewerkers hoeveel ervaring hebben.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Number of Years Spend in Company')
plt.ylabel('Number of Employees')
plt.show()
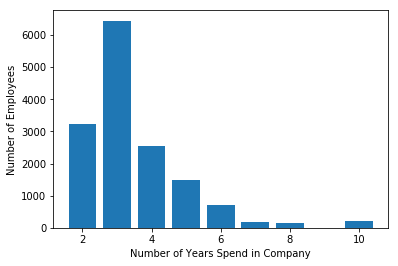
De meeste medewerkers hebben 2–4 jaar ervaring. Er is ook een groot gat tussen 3 en 4 jaar ervaring.
Zo kun je kenmerken één voor één analyseren, maar dat kost tijd. Een betere optie is de Seaborn-bibliotheek te gebruiken en alle grafieken in één keer te plotten met subplots.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
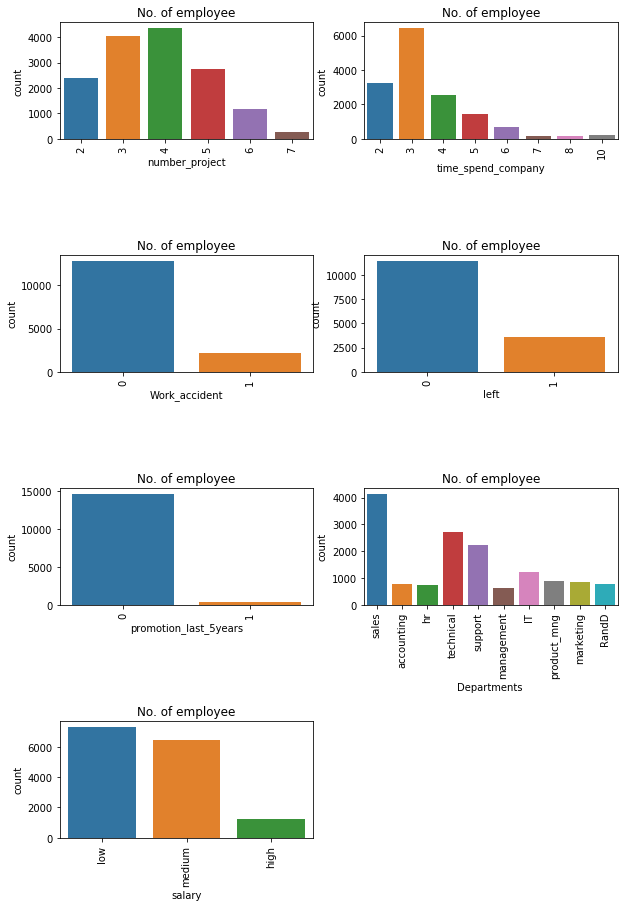
In de bovenstaande visualisatie kun je het volgende zien:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
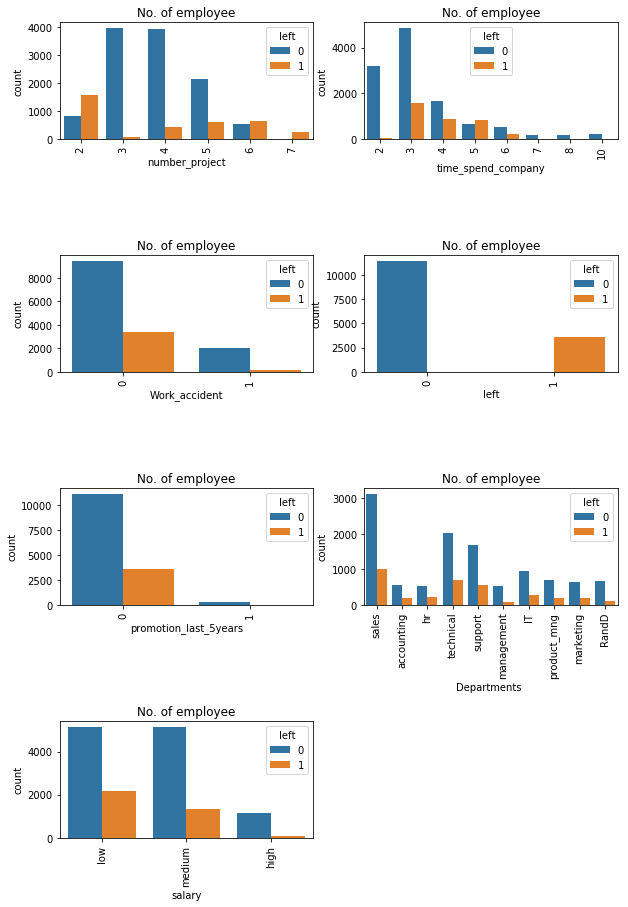
Hier zie je onder meer:
De volgende kenmerken beïnvloeden het vertrek het meest:
Laten we de groepen medewerkers vinden die vertrokken zijn. De belangrijkste factoren om te blijven of te vertrekken zijn tevredenheid en performance. Laten we mensen op basis daarvan clusteren.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
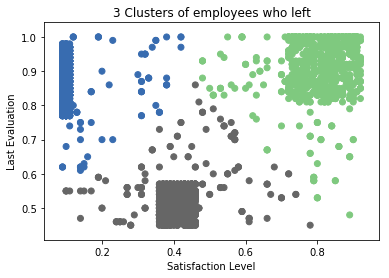
Medewerkers die zijn vertrokken, kun je in drie typen groeperen:
Veel machinelearning-algoritmen vereisen numerieke input, dus categorische kolommen moeten numeriek worden gerepresenteerd.
Om dit te encoderen kun je elke waarde aan een getal koppelen. Bijv. de Salary-kolom: low:0, medium:1 en high:2.
Dit heet label encoding en sklearn doet dit handig met LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Je importeerde de preprocessing-module en maakte een LabelEncoder-object. Met dit object heb je de kolommen "salary" en "Departments " getransformeerd naar numeriek.
Om modelprestatie te begrijpen is het een goede strategie om de dataset op te splitsen in een trainings- en testset.
We splitsen de dataset met train_test_split(). Je geeft 3 parameters mee: features, target en de grootte van de testset. Optioneel kun je random_state gebruiken om willekeurig te selecteren.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
De dataset is hier in twee delen opgesplitst in een verhouding van 70:30. Dus 70% voor training en 30% voor testen.
Laten we een voorspellingsmodel voor verloop bouwen.
We voorspellen verloop met een Gradient Boosting Classifier.
Importeer eerst de module GradientBoostingClassifier en maak een classifier-object met GradientBoostingClassifier().
Train vervolgens je model op de trainset met fit() en voorspel op de testset met predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Je behaalde een classificatienauwkeurigheid van 97%, wat goed is.
Precisie: Precisie gaat over hoe vaak je model gelijk heeft wanneer het een positieve voorspelling doet. In dit geval: wanneer je Gradient Boosting-model voorspelde dat een medewerker zou vertrekken, klopte dat 95% van de tijd.
Recall: Als er in de testset een vertrokken medewerker voorkomt, herkent je Gradient Boosting-model die in 92% van de gevallen.
Gefeliciteerd, je bent aan het einde van deze tutorial gekomen!
In deze tutorial heb je geleerd wat verloop van medewerkers is, hoe het verschilt van klantverloop, hoe je verkennende data-analyse en visualisatie uitvoert op een verloopdataset met matplotlib en seaborn, en hoe je een model bouwt en evalueert met de scikit-learn-package voor Python.
Ik hoor graag je feedback of vragen. Laat een reactie achter met je vraag; ik doe mijn best om te antwoorden.
Ben je geïnteresseerd in meer Python? Bekijk dan DataCamp’s cursus Intermediate Python for Data Science.
Leer meer over Python
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

