{count, plural, one {कोर्स} other {कोर्स}}
इंटरमीडिएट Python
{hours} घंटा
1.4M
पहले, ध्यान का अधिकतर केंद्र ‘दर’ जैसे एट्रिशन रेट और रिटेंशन रेट पर रहता था। HR मैनेजर पिछली दरों की गणना कर डेटा वेयरहाउसिंग टूल्स से भविष्य की दरों का अनुमान लगाने की कोशिश करते हैं। ये दरें churn के समग्र प्रभाव को दिखाती हैं, लेकिन यह तस्वीर का आधा हिस्सा है। एक दूसरा तरीका यह है कि समग्र के साथ-साथ व्यक्तिगत रिकॉर्ड पर भी ध्यान दिया जाए।
ग्राहक churn पर बहुत से केस स्टडी उपलब्ध हैं। ग्राहक churn में आप अनुमान लगा सकते हैं कि कौन और कब ग्राहक खरीदना बंद करेगा। कर्मचारी churn ग्राहक churn के समान है। इसमें केंद्र ग्राहक के बजाय कर्मचारी होता है। यहां, आप भविष्यवाणी कर सकते हैं कि कौन और कब कोई कर्मचारी सेवा समाप्त करेगा। कर्मचारी churn महंगा होता है, और छोटे-छोटे सुधार भी बड़े नतीजे देते हैं। यह हमें बेहतर रिटेंशन प्लान बनाने और कर्मचारी संतुष्टि में सुधार करने में मदद करेगा।
कर्मचारी churn को किसी कंपनी या संगठन से बौद्धिक संपदा के रिसाव या प्रस्थान के रूप में परिभाषित किया जा सकता है। सरल शब्दों में, जब कर्मचारी संगठन छोड़ते हैं, तो उसे churn कहा जाता है। एक और परिभाषा यह हो सकती है कि जब किसी जनसंख्या का सदस्य उस जनसंख्या को छोड़ देता है, तो वह churn कहलाता है।
अनुसंधान में पाया गया कि कर्मचारी churn पर उम्र, कार्यकाल, वेतन, नौकरी संतुष्टि, सैलरी, कार्य परिस्थितियाँ, विकास की संभावनाएँ और निष्पक्षता को लेकर कर्मचारी की धारणा का प्रभाव पड़ता है। कुछ अन्य चर जैसे उम्र, लिंग, जातीयता, शिक्षा, और वैवाहिक स्थिति, कर्मचारी churn की भविष्यवाणी में महत्वपूर्ण कारक थे। कुछ मामलों में, निचे स्किल वाले कर्मचारियों को बदलना कठिन होता है। इसका प्रभाव चल रहे काम और मौजूदा कर्मचारियों की उत्पादकता पर पड़ता है। प्रतिस्थापन के रूप में नए कर्मचारियों को नियुक्त करने में भर्ती और प्रशिक्षण जैसी लागतें आती हैं। साथ ही, नया कर्मचारी पुराने कर्मचारी के तकनीकी या व्यावसायिक विशेषज्ञता के समान स्तर की कौशल सीखने में समय लेगा। संगठन इस समस्या से निपटने के लिए मशीन लर्निंग तकनीकों का उपयोग कर कर्मचारी churn की भविष्यवाणी करते हैं, जो उन्हें आवश्यक कार्रवाई करने में मदद करता है।
निम्नलिखित बिंदु आपको कर्मचारी और ग्राहक churn को बेहतर तरीके से समझने में मदद करते हैं:
बिज़नेस किसी कर्मचारी को नियुक्त करने के लिए चुनता है, जबकि मार्केटिंग में आप अपने ग्राहकों को नहीं चुन सकते।
कर्मचारी आपकी कंपनी का चेहरा होते हैं, और सामूहिक रूप से, वही आपकी कंपनी का सारा काम करते हैं।
एक ग्राहक को खोना राजस्व और ब्रांड इमेज को प्रभावित करता है। मौजूदा ग्राहक को बनाए रखने की तुलना में नए ग्राहक हासिल करना कठिन और महंगा है। कर्मचारी churn भी कंपनियों/संगठनों के लिए पीड़ादायक होता है। प्रतिस्थापन ढूंढने और प्रशिक्षण में समय और प्रयास लगता है।
कर्मचारी churn की गतिशीलता ग्राहक churn की तुलना में अलग होती है। यह हमें बेहतर कर्मचारी रिटेंशन प्लान बनाने और कर्मचारी संतुष्टि बढ़ाने में मदद करता है। डेटा साइंस एल्गोरिद्म भविष्य के churn का पूर्वानुमान लगा सकते हैं।
एक्सप्लोरेटरी डेटा एनालिसिस एक प्रारंभिक प्रक्रिया है जिसमें आप वर्णनात्मक आँकड़ों और विज़ुअलाइज़ेशन का उपयोग करके पैटर्न, ट्रेंड, आउट्लायर और परिकल्पना परीक्षण जैसे डेटा के गुणों का सार प्रस्तुत करते हैं।
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlineआइए पहले pandas की read CSV फ़ंक्शन का उपयोग करके आवश्यक HR डेटासेट लोड करें। आप यह डेटा इस लिंक से डाउनलोड कर सकते हैं।
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

डेटासेट लोड करने के बाद, आप इसके बारे में थोड़ा और जानना चाहेंगे। आप info() का उपयोग करके एट्रिब्यूट के नाम और डाटाटाइप की जाँच कर सकते हैं।
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
आप 10 एट्रिब्यूट को विस्तार से इस प्रकार वर्णित कर सकते हैं:
दिए गए डेटासेट में, आपके पास दो तरह के कर्मचारी हैं—एक जो रुके और दूसरे जो कंपनी छोड़कर चले गए। इसलिए, आप डेटा को दो समूहों में बाँटकर उनकी विशेषताओं की तुलना कर सकते हैं। यहाँ, आप groupby() और mean() फ़ंक्शन का उपयोग करके दोनों समूहों का औसत निकाल सकते हैं।
left = data.groupby('left')
left.mean()

यहाँ आप देख सकते हैं, जिन्होंने कंपनी छोड़ी, उनका संतुष्टि स्तर कम था, प्रमोशन दर कम थी, सैलरी कम थी, और उन्होंने कंपनी में रुके कर्मचारियों की तुलना में अधिक काम किया।
pandas में describe() फ़ंक्शन विभिन्न समरी आँकड़े प्राप्त करने में सुविधाजनक है। यह फ़ंक्शन डेटा की काउंट, मीन, स्टैंडर्ड डिविएशन, न्यूनतम और अधिकतम मान और क्वांटाइल्स लौटाता है।
data.describe()

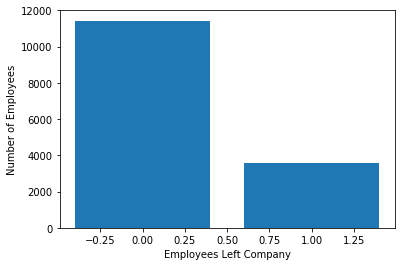
आइए देखें कितने कर्मचारियों ने कंपनी छोड़ी?
यहाँ, आप Matplotlib का उपयोग करके बार ग्राफ़ प्लॉट कर सकते हैं। बार ग्राफ़ असतत वेरिएबल काउंट दिखाने के लिए उपयुक्त है।
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Employees Left Company')
plt.ylabel('Number of Employees')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
यहाँ, आप देख सकते हैं कि लगभग 15,000 में से 3,571 ने छोड़ा, और 11,428 रुके। कंपनी छोड़ने वाले कर्मचारियों की संख्या कुल रोजगार का 23% है।
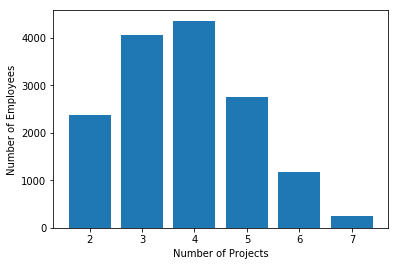
इसी तरह, आप बार ग्राफ़ प्लॉट कर सकते हैं कि कितने कर्मचारियों को कितने प्रोजेक्ट पर तैनात किया गया है?
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Number of Projects')
plt.ylabel('Number of Employees')
plt.show()
इसी तरह, आप यह गिनने के लिए भी बार ग्राफ़ प्लॉट कर सकते हैं कि अनुभव के आधार पर कितने कर्मचारी हैं?
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Number of Years Spend in Company')
plt.ylabel('Number of Employees')
plt.show()
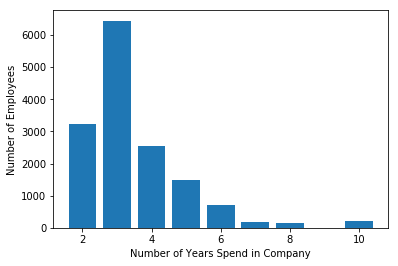
ज्यादातर कर्मचारियों का अनुभव 2-4 वर्षों के बीच है। साथ ही, 3 और 4 वर्ष के अनुभव वाले कर्मचारियों के बीच बड़ा अंतर है।
आप इस तरह एक-एक फीचर का विश्लेषण कर सकते हैं, लेकिन यह समय लेने वाला होगा। बेहतर विकल्प है Seaborn लाइब्रेरी का उपयोग कर सबप्लॉट्स के साथ एक ही रन में सभी ग्राफ़ प्लॉट करना।
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
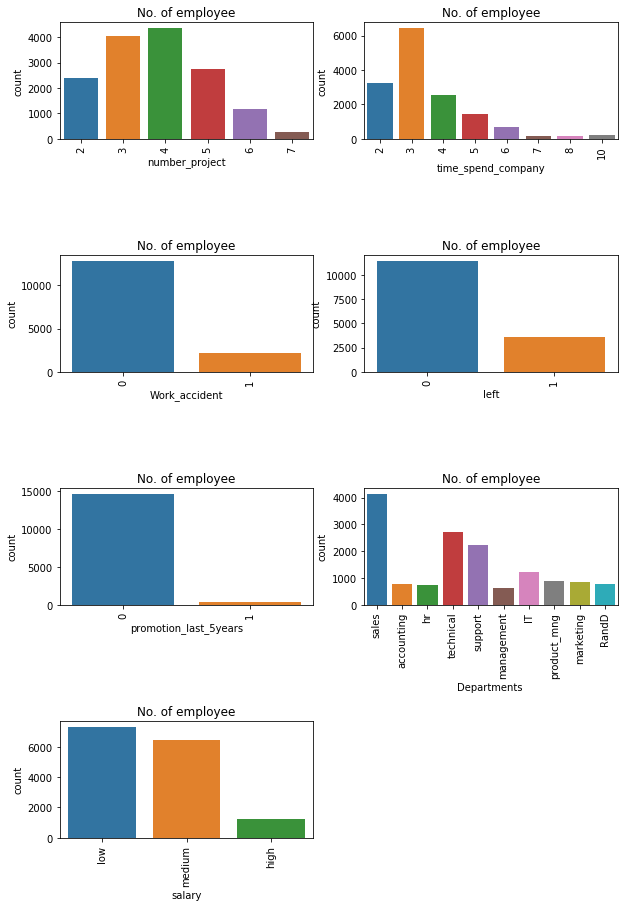
ऊपर दिए गए विज़ुअलाइज़ेशन में आप निम्न बिंदु देख सकते हैं:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
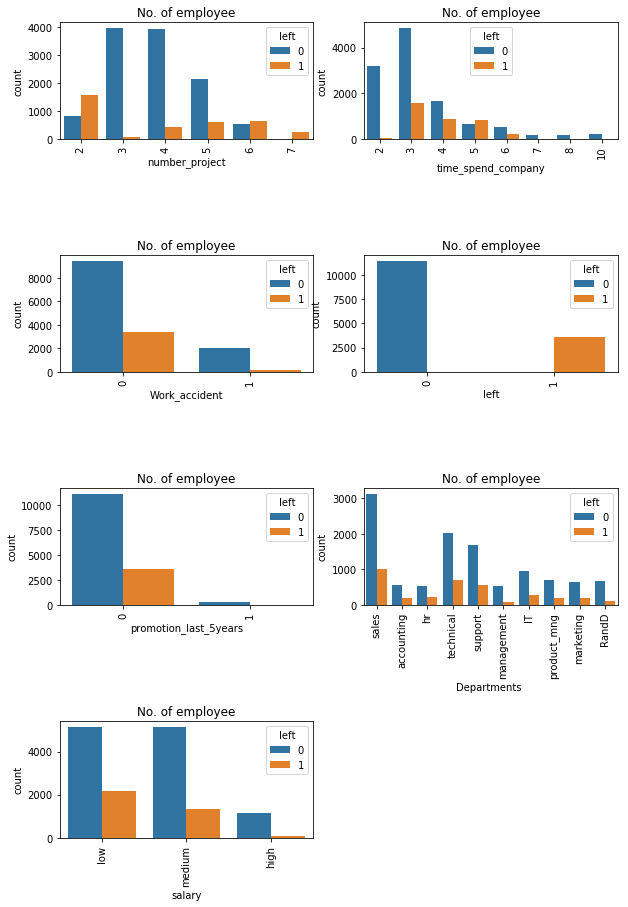
ऊपर दिए गए विज़ुअलाइज़ेशन में आप निम्न बिंदु देख सकते हैं:
निम्नलिखित फीचर किसी व्यक्ति को कंपनी छोड़ने के लिए सबसे अधिक प्रभावित करते हैं:
आइए उन कर्मचारियों के समूह ढूँढें जिन्होंने छोड़ा। आप देख सकते हैं कि किसी भी कर्मचारी के रुकने या छोड़ने के लिए सबसे महत्वपूर्ण कारक कंपनी में संतुष्टि और प्रदर्शन है। तो आइए क्लस्टर विश्लेषण का उपयोग करके उन्हें समूहों में बाँटें।
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
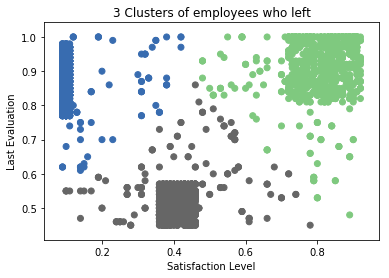
यहाँ, कंपनी छोड़ने वाले कर्मचारियों को 3 प्रकार के कर्मचारियों में बाँटा जा सकता है:
कई मशीन लर्निंग एल्गोरिद्म को संख्यात्मक इनपुट डेटा की आवश्यकता होती है, इसलिए आपको श्रेणीबद्ध कॉलम को संख्यात्मक कॉलम में दर्शाना होगा।
इस डेटा को एन्कोड करने के लिए, आप प्रत्येक मान को एक संख्या से मैप कर सकते हैं। जैसे, Salary कॉलम के मान low:0, medium:1, और high:2 से दर्शाए जा सकते हैं।
इस प्रक्रिया को लेबल एन्कोडिंग कहा जाता है, और sklearn इसे LabelEncoder का उपयोग करके सुविधाजनक रूप से कर देता है।
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
यहाँ, आपने preprocessing मॉड्यूल आयात किया और एक Label Encoder ऑब्जेक्ट बनाया। इस LabelEncoder ऑब्जेक्ट का उपयोग कर आपने "salary" और "Departments " कॉलम को संख्यात्मक कॉलम में फिट और ट्रांसफॉर्म किया।
मॉडल प्रदर्शन समझने के लिए, डेटासेट को ट्रेनिंग सेट और टेस्ट सेट में बाँटना एक अच्छा तरीका है।
आइए train_test_split() फ़ंक्शन का उपयोग करके डेटासेट विभाजित करें। आपको 3 पैरामीटर देने हैं: फीचर, टारगेट और टेस्ट सेट का आकार। अतिरिक्त रूप से, आप रिकॉर्ड को रैंडम चुनने के लिए random_state का उपयोग कर सकते हैं।
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
यहाँ, डेटासेट को 70:30 के अनुपात में दो हिस्सों में बाँटा गया है। यानी 70% डेटा मॉडल ट्रेनिंग के लिए और 30% मॉडल टेस्टिंग के लिए उपयोग होगा।
आइए कर्मचारी churn का एक पूर्वानुमान मॉडल बनाते हैं।
यहाँ, आप Gradient Boosting Classifier का उपयोग करके churn की भविष्यवाणी करने जा रहे हैं।
पहले, GradientBoostingClassifier मॉड्यूल आयात करें और GradientBoostingClassifier() फ़ंक्शन का उपयोग कर Gradient Boosting क्लासिफ़ायर ऑब्जेक्ट बनाएँ।
फिर, fit() का उपयोग कर अपने मॉडल को ट्रेन सेट पर फिट करें और predict() का उपयोग कर टेस्ट सेट पर प्रेडिक्शन करें।
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
ठीक है, आपको 97% की क्लासिफिकेशन दर मिली है, जिसे अच्छी सटीकता माना जाता है।
प्रिसिजन: प्रिसिजन का मतलब है सटीक होना, यानी आपका मॉडल कितना सटीक है। दूसरे शब्दों में, जब मॉडल कोई प्रेडिक्शन करता है, तो वह कितनी बार सही होता है। आपके प्रेडिक्शन मामले में, जब आपके Gradient Boosting मॉडल ने किसी कर्मचारी के छोड़ने की भविष्यवाणी की, तो वह कर्मचारी 95% समय वास्तव में छोड़ गया।
रिकॉल: यदि टेस्ट सेट में कोई ऐसा कर्मचारी मौजूद है जिसने छोड़ा, तो आपका Gradient Boosting मॉडल उसे 92% समय पहचान लेता है।
बधाई हो, आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं!
इस ट्यूटोरियल में, आपने सीखा कि Employee Churn क्या है, यह ग्राहक churn से कैसे अलग है, matplotlib और seaborn का उपयोग कर कर्मचारी churn डेटासेट का एक्सप्लोरेटरी डेटा एनालिसिस और विज़ुअलाइज़ेशन कैसे करें, तथा python scikit-learn पैकेज का उपयोग कर मॉडल बनाना और उसका मूल्यांकन कैसे करें।
मुझे आपके किसी भी फीडबैक या प्रश्न का इंतज़ार रहेगा। आप कमेंट छोड़कर प्रश्न पूछ सकते हैं, और मैं पूरी कोशिश करूँगा कि उसका जवाब दूँ।
यदि आप Python के बारे में और सीखने में रुचि रखते हैं, तो DataCamp का Intermediate Python for Data Science कोर्स देखें।
Python के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}