Corso
Python - Livello Intermedio
4 ore
1.4M
In passato, l’attenzione era rivolta soprattutto ai “tassi”, come il tasso di abbandono e quello di retention. Gli HR Manager calcolano i tassi storici e cercano di prevedere i tassi futuri usando strumenti di data warehousing. Questi tassi mostrano l’impatto aggregato del churn, ma sono solo metà del quadro. Un altro approccio è concentrarsi sui singoli record oltre che sugli aggregati.
Esistono molti case study sul churn dei clienti. Nel customer churn puoi prevedere chi e quando smetterà di acquistare. L’employee churn è simile, ma si concentra sui dipendenti invece che sui clienti. Qui puoi prevedere chi e quando interromperà il rapporto di lavoro. L’employee churn è costoso e anche piccoli miglioramenti possono generare risultati significativi. Aiuta a progettare piani di retention migliori e a migliorare la soddisfazione dei dipendenti.
L’employee churn può essere definito come una perdita o fuoriuscita di asset intellettuali da un’azienda o organizzazione. In parole semplici, quando i dipendenti lasciano l’organizzazione si parla di churn. Un’altra definizione è quando un membro di una popolazione lascia la popolazione.
Dalla ricerca emerge che l’employee churn è influenzato da età, anzianità, retribuzione, soddisfazione lavorativa, salario, condizioni di lavoro, potenziale di crescita e percezione di equità. Altre variabili come età, genere, etnia, istruzione e stato civile sono fattori importanti nella previsione dell’employee churn. In alcuni casi, i dipendenti con competenze di nicchia sono più difficili da sostituire: ciò impatta il lavoro in corso e la produttività dei colleghi. Acquisire nuovi dipendenti come sostituti ha costi propri, come quelli di assunzione e formazione. Inoltre, il nuovo assunto impiegherà tempo per raggiungere un livello di competenze tecniche o di business simile a quello di un collega più esperto. Le organizzazioni affrontano questo problema applicando tecniche di machine learning per prevedere l’employee churn, così da poter intervenire di conseguenza.
I seguenti punti ti aiutano a comprendere meglio l’employee churn e il customer churn:
Nel business scegli i dipendenti da assumere, mentre nel marketing non puoi scegliere i tuoi clienti.
I dipendenti sono il volto della tua azienda e, collettivamente, producono tutto ciò che la tua azienda realizza.
Perdere un cliente influisce su ricavi e immagine del brand. Acquisire nuovi clienti è più difficile e costoso rispetto a trattenere quelli esistenti. Anche l’employee churn è doloroso per le aziende e le organizzazioni: richiede tempo e impegno per trovare e formare un sostituto.
L’employee churn ha dinamiche specifiche rispetto al customer churn. Ci aiuta a progettare piani di retention migliori e a migliorare la soddisfazione dei dipendenti. Gli algoritmi di data science possono prevedere il churn futuro.
L’Exploratory Data Analysis è una fase iniziale in cui puoi riassumere le caratteristiche dei dati, come pattern, trend, outlier e testare ipotesi usando statistiche descrittive e visualizzazioni.
#import modules
import pandas  # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
% matplotlib inlinePer prima cosa carichiamo il dataset HR richiesto usando la funzione di pandas per leggere i CSV. Puoi scaricare i dati da questo link.
data=pandas.read_csv('HR_comma_sep.csv')
data.head()

data.tail()

Dopo aver caricato il dataset, potresti volerlo conoscere meglio. Puoi controllare i nomi degli attributi e i tipi di dato usando info().
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 14,999 entries, 0 to 14,998
Data columns (total 10 columns):
satisfaction_level       14999 non-null float64
last_evaluation          14999 non-null float64
number_project           14999 non-null int64
average_montly_hours     14999 non-null int64
time_spend_company       14999 non-null int64
Work_accident            14999 non-null int64
left                     14999 non-null int64
promotion_last_5years    14999 non-null int64
Departments              14999 non-null object
salary                   14999 non-null object
dtypes: float64(2), int64(6), object(2)
memory usage: 1.1+ MB
Puoi descrivere in dettaglio i 10 attributi come segue:
Nel dataset hai due tipi di dipendenti: chi è rimasto e chi ha lasciato l’azienda. Puoi quindi dividere i dati in due gruppi e confrontarne le caratteristiche. Qui puoi trovare la media di entrambi i gruppi usando le funzioni groupby() e mean().
left = data.groupby('left')
left.mean()

Qui puoi interpretare che i dipendenti che hanno lasciato l’azienda avevano un basso livello di soddisfazione, un basso tasso di promozione, salari più bassi e lavoravano di più rispetto a chi è rimasto.
La funzione describe() in pandas è comoda per ottenere varie statistiche riassuntive. Restituisce conteggio, media, deviazione standard, valori minimo e massimo e i quantili dei dati.
data.describe()

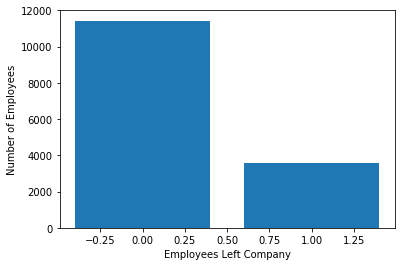
Vediamo quanti dipendenti hanno lasciato.
Qui puoi tracciare un grafico a barre usando Matplotlib. Il grafico a barre è adatto a mostrare i conteggi di variabili discrete.
left_count=data.groupby('left').count()
plt.bar(left_count.index.values, left_count['satisfaction_level'])
plt.xlabel('Dipendenti che hanno lasciato l\'azienda')
plt.ylabel('Numero di dipendenti')
plt.show()
data.left.value_counts()
0    11428
1     3571
Name: left, dtype: int64
Qui puoi vedere che su circa 15.000 dipendenti, 3.571 hanno lasciato e 11.428 sono rimasti. Il numero di chi ha lasciato è il 23% del totale.
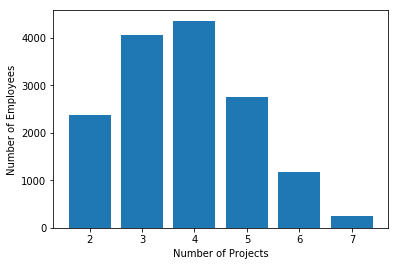
Allo stesso modo, puoi tracciare un grafico a barre per contare quanti dipendenti sono assegnati a quanti progetti.
num_projects=data.groupby('number_project').count()
plt.bar(num_projects.index.values, num_projects['satisfaction_level'])
plt.xlabel('Numero di progetti')
plt.ylabel('Numero di dipendenti')
plt.show()
Analogamente, puoi tracciare un grafico a barre per contare i dipendenti in base all’esperienza maturata.
time_spent=data.groupby('time_spend_company').count()
plt.bar(time_spent.index.values, time_spent['satisfaction_level'])
plt.xlabel('Anni trascorsi in azienda')
plt.ylabel('Numero di dipendenti')
plt.show()
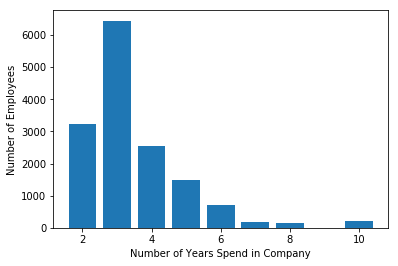
La maggior parte dei dipendenti ha tra 2 e 4 anni di esperienza. C’è anche un grande divario tra chi ha 3 e 4 anni.
Analizzare le feature una per una è possibile, ma richiede tempo. Un’opzione migliore è usare la libreria Seaborn e tracciare tutti i grafici in un’unica esecuzione con i sottoplot.
features=['number_project','time_spend_company','Work_accident','left', 'promotion_last_5years','Departments ','salary']
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data)
    plt.xticks(rotation=90)
    plt.title("No. of employee")
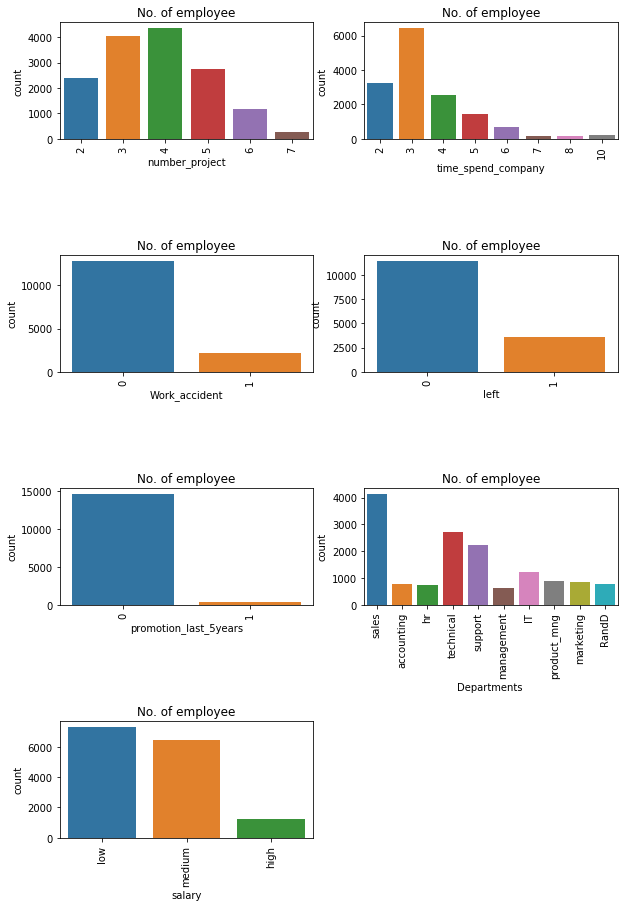
Dalla visualizzazione sopra puoi osservare:
fig=plt.subplots(figsize=(10,15))
for i, j in enumerate(features):
    plt.subplot(4, 2, i+1)
    plt.subplots_adjust(hspace = 1.0)
    sns.countplot(x=j,data = data, hue='left')
    plt.xticks(rotation=90)
    plt.title("No. of employee")
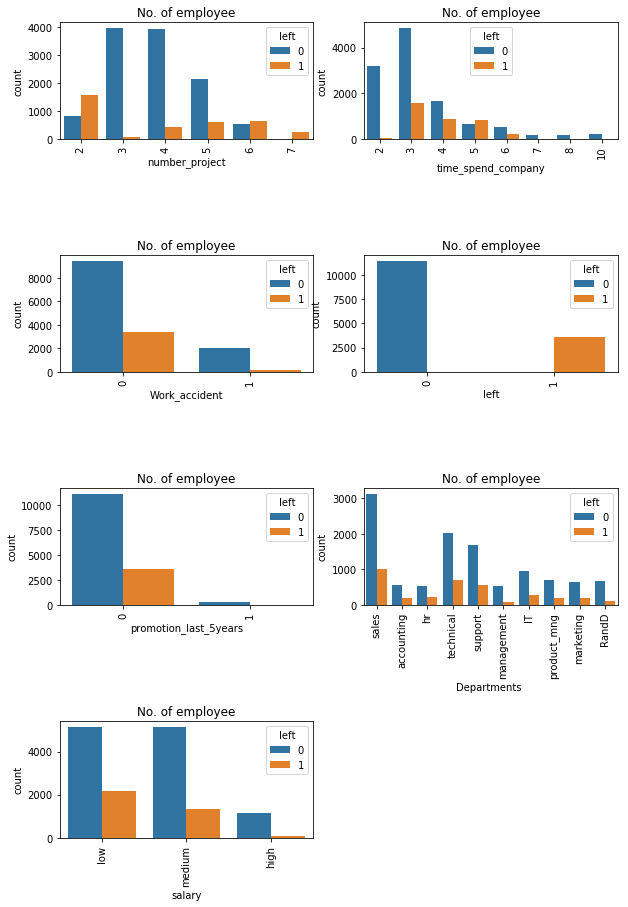
Dalla visualizzazione sopra puoi osservare:
Le seguenti caratteristiche influenzano maggiormente la decisione di lasciare l’azienda:
Vediamo i gruppi di dipendenti che hanno lasciato. Puoi osservare che i fattori più importanti per restare o lasciare sono la soddisfazione e la performance in azienda. Raggruppiamoli quindi con un’analisi per cluster.
#import module
from sklearn.cluster import KMeans
# Filter data
left_emp =  data[['satisfaction_level', 'last_evaluation']][data.left == 1]
# Create groups using K-means clustering.
kmeans = KMeans(n_clusters = 3, random_state = 0).fit(left_emp)
# Add new column "label" annd assign cluster labels.
left_emp['label'] = kmeans.labels_
# Draw scatter plot
plt.scatter(left_emp['satisfaction_level'], left_emp['last_evaluation'], c=left_emp['label'],cmap='Accent')
plt.xlabel('Satisfaction Level')
plt.ylabel('Last Evaluation')
plt.title('3 Clusters of employees who left')
plt.show()
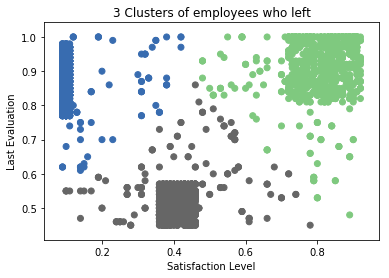
Qui, i dipendenti che hanno lasciato l’azienda possono essere raggruppati in 3 tipologie:
Molti algoritmi di machine learning richiedono input numerici, quindi è necessario rappresentare le colonne categoriche come numeriche.
Per codificare questi dati, puoi mappare ogni valore a un numero. Ad esempio, i valori della colonna Salary possono essere rappresentati come low:0, medium:1 e high:2.
Questo processo è noto come label encoding e sklearn lo gestisce comodamente con LabelEncoder.
# Import LabelEncoder
from sklearn import preprocessing
#creating labelEncoder
le = preprocessing.LabelEncoder()
# Converting string labels into numbers.
data['salary']=le.fit_transform(data['salary'])
data['Departments ']=le.fit_transform(data['Departments '])
Qui hai importato il modulo preprocessing e creato un oggetto LabelEncoder. Usandolo hai effettuato fit e transform delle colonne "salary" e "Departments " in colonne numeriche.
Per capire le prestazioni del modello, suddividere il dataset in training set e test set è una buona strategia.
Dividiamo il dataset usando la funzione train_test_split(). Devi passare 3 parametri: feature, target e dimensione del test set. Inoltre, puoi usare random_state per selezionare i record in modo casuale.
#Spliting data into Feature and
X=data[['satisfaction_level', 'last_evaluation', 'number_project',
       'average_montly_hours', 'time_spend_company', 'Work_accident',
       'promotion_last_5years', 'Departments ', 'salary']]
y=data['left']
# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)  # 70% training and 30% test
Qui, il dataset è stato suddiviso in due parti nel rapporto 70:30. Significa che il 70% dei dati è usato per l’addestramento e il 30% per il test.
Costruiamo un modello per prevedere l’employee churn.
Qui userai un Gradient Boosting Classifier per prevedere il churn.
Per prima cosa importa il modulo GradientBoostingClassifier e crea un classificatore Gradient Boosting usando la funzione GradientBoostingClassifier().
Poi, allena il modello sul train set con fit() ed effettua le previsioni sul test set con predict().
#Import Gradient Boosting Classifier model
from sklearn.ensemble import GradientBoostingClassifier

#Create Gradient Boosting Classifier
gb = GradientBoostingClassifier()

#Train the model using the training sets
gb.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = gb.predict(X_test)
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy, how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
# Model Precision
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall
print("Recall:",metrics.recall_score(y_test, y_pred))
Accuracy: 0.971555555556
Precision: 0.958252427184
Recall: 0.920708955224
Hai ottenuto un tasso di classificazione del 97%, considerato un’ottima accuratezza.
Precision: la precision riguarda l’essere precisi, cioè quanto è preciso il modello. In altre parole, quando il modello fa una previsione, quanto spesso è corretta. Nel tuo caso, quando il modello di Gradient Boosting ha previsto che un dipendente avrebbe lasciato, quel dipendente ha effettivamente lasciato il 95% delle volte.
Recall: se nel test set è presente un dipendente che ha lasciato, il tuo modello di Gradient Boosting lo identifica nel 92% dei casi.
Congratulazioni, sei arrivato alla fine di questo tutorial!
In questo tutorial hai imparato che cos’è l’Employee Churn, come differisce dal customer churn, come fare analisi esplorativa e visualizzazione del dataset di employee churn usando matplotlib e seaborn, e come costruire e valutare un modello usando il pacchetto scikit-learn di Python.
Aspetto volentieri feedback o domande. Puoi lasciare un commento e farò del mio meglio per risponderti.
Se vuoi approfondire Python, dai un’occhiata al corso di DataCamp Intermediate Python for Data Science.
Scopri di più su Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



