- Brève introduction à la régression avec Python
- Régression logistique et mise à l'échelle des données : le jeu de données sur le vin
- Glossaire
Dans le premier article de cette série, j'ai étudié le rôle du prétraitement dans les tâches de classification en apprentissage automatique (ML), avec un focus sur l'algorithme des k plus proches voisins (k-NN) et le jeu de données sur la qualité du vin. Vous avez vu que centrer et mettre à l'échelle les données numériques améliorait les performances de k-NN pour plusieurs métriques (p. ex. l'exactitude). Vous avez également vu que le prétraitement ne se fait pas en vase clos et que sa valeur ne se mesure qu'au sein d'un pipeline ML orienté prédiction. Cependant, nous n'avons considéré le prétraitement qu'avec un seul modèle, k-NN. Dans ce cas, le modèle a nettement mieux performé — mais est-ce toujours le cas ? Pas nécessairement ! Dans cet article, j'examine l'effet de la mise à l'échelle et du centrage des données numériques sur un autre modèle de base, la régression logistique. Vous pouvez réviser en consultant l'article précédent et/ou le glossaire en bas de page. Nous allons à nouveau travailler sur le jeu de données sur la qualité du vin. Tous les exemples sont en Python. Si vous débutez avec Python, découvrez nos cours de data science ici. J'utiliserai les bibliothèques pandas pour la gestion des dataframes et scikit-learn pour l'apprentissage automatique.
Je commencerai par une brève introduction à la régression, utilisable pour prédire la valeur d'une variable numérique comme des classes. Je présenterai la régression linéaire, la régression logistique, puis j'utiliserai cette dernière pour prédire la qualité d'un vin rouge. Vous verrez ensuite si le centrage et la mise à l'échelle aident notre modèle dans un contexte de régression.
Brève introduction à la régression avec Python
Régression linéaire en Python
Comme indiqué ci-dessus, la régression sert couramment à prédire la valeur d'une variable numérique à partir d'une autre. Par exemple, ci-dessous nous effectuons une régression linéaire sur les données du logement à Boston (jeu de données intégré à scikit-learn) : ici, la variable indépendante (axe des x) est le nombre de pièces et la variable dépendante (axe des y) est le prix.
Comment fonctionne une telle régression ? En bref, la mécanique est la suivante : nous souhaitons ajuster un modèle \(y = ax + b\) aux données \((x_i,y_i)\), c'est-à-dire trouver les \(a\) et \(b\) optimaux, étant données les observations. Dans la formulation des moindres carrés ordinaires (OLS, de loin la plus courante), on suppose que l'erreur se situe sur la variable dépendante. Ainsi, les \(a\) et \(b\) optimaux minimisent \[SSE = \sum_i (y_i - (ax_i + b))^2\] et cette optimisation est généralement réalisée par descente de gradient. Voici une simple régression linéaire sur les données immobilières de Boston :
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()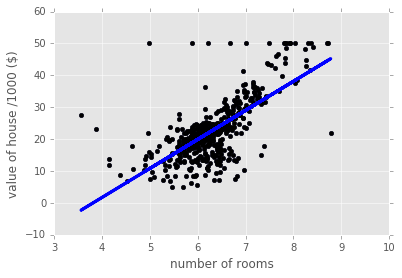
Cette régression saisit la tendance globale croissante des données mais pas grand-chose de plus. Nous n'avons utilisé qu'une variable prédictive, alors que nous aurions pu en exploiter bien d'autres ; dans ce cas, le modèle comporterait \(n\) coefficients \(a_1,\ldots,a_n\), un par variable prédictive. À noter que l'ampleur du coefficient \(a_i\) indique à quel point la variable correspondante est corrélée à la variable cible.
Régression logistique en Python
La régression peut aussi s'appliquer aux problèmes de classification. Le premier exemple naturel est la régression logistique. En classification binaire (deux étiquettes), on peut représenter les classes par 0 et 1. En notant à nouveau la variable prédictive \(x\), le modèle de régression logistique est donné par la fonction logistique \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] C'est une courbe sigmoïde (en S), illustrée ci-dessous. Pour un \(x\) donné, si \(F(x) <0.5\), le modèle prédit y = 0 et, si \(F(X) > 0.5\), le modèle prédit \(y = 1\). Si nous avons plusieurs variables prédictives, nous aurons \(n\) coefficients \(a_1,\ldots,a_n\), un par variable. Ici, l'ampleur du coefficient \(a_i\) indique la force avec laquelle la variable correspondante influe sur la variable cible.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()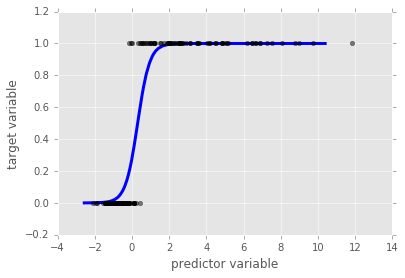
Régression logistique et mise à l'échelle des données : le jeu de données sur le vin
Maintenant que nous avons vu la mécanique de la régression logistique, implémentons un classificateur logistique sur notre savoureux jeu de données sur le vin. J'importe les données et je trace la variable cible (bon/mauvais vin) pour mémoire :
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()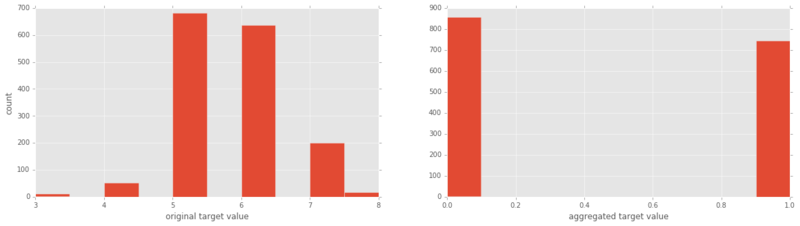
Lançons maintenant notre régression logistique et voyons ses performances !
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Tel quel, cette régression logistique fait mieux que K-NN (avec ou sans mise à l'échelle). Passons maintenant à la mise à l'échelle et relançons la régression logistique :
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320C'est très intéressant ! Les performances de la régression logistique ne se sont pas améliorées après mise à l'échelle. Pourquoi, alors que nous avions observé une nette amélioration pour les k plus proches voisins avec l'échelle normalisée ? La raison est que, s'il existe des variables prédictives à grande amplitude qui n'influencent pas la variable cible, un algorithme de régression va attribuer de faibles coefficients \(a_i\) à ces variables, de sorte qu'elles pèsent peu dans les prédictions. Les k plus proches voisins n'ont pas ce mécanisme intégré ; il est donc d'autant plus nécessaire d'échelonner les données.
Dans le prochain article, j'examinerai en détail ces résultats très différents du centrage et de la mise à l'échelle pour k-NN et la régression logistique en synthétisant un jeu de données, en ajoutant du bruit, puis en observant comment le centrage et la mise à l'échelle modifient les performances des deux modèles en fonction de l'intensité du bruit.
Dans la fenêtre interactive ci-dessous, vous pouvez expérimenter vous-même. Vous pouvez mettre les données à l'échelle en définissant sc = True, si vous le souhaitez. Exécutez ensuite l'ensemble du script pour obtenir l'exactitude du modèle de régression logistique ainsi qu'un rapport de classification.
Glossaire
Apprentissage supervisé : tâche consistant à inférer une variable cible à partir de variables prédictives. Par exemple, déduire la variable cible « présence d'une maladie cardiaque » à partir de variables prédictives telles que « âge », « sexe » et « statut fumeur ».
Tâche de classification : une tâche d'apprentissage supervisé est une tâche de classification si la variable cible est catégorielle (p. ex. « clic » ou « non », « tumeur maligne » ou « bénigne »).
Tâche de régression : une tâche d'apprentissage supervisé est une tâche de régression si la variable cible varie de façon continue (p. ex. le prix d'une maison) ou est une variable catégorielle ordonnée comme la « note de qualité d'un vin ».
k plus proches voisins : algorithme de classification qui assigne à un point de données l'étiquette décidée par vote majoritaire de ses k plus proches voisins.
Prétraitement : ensemble d'opérations utilisées par les data scientists pour mettre les données dans une forme plus adaptée à l'objectif poursuivi. Par exemple, avant une analyse de sentiment sur des tweets, vous pouvez retirer les balises HTML, les espaces superflus, développer les abréviations et découper les tweets en listes de mots.
Centrage et mise à l'échelle : deux formes de prétraitement de données numériques, c'est-à-dire des données constituées de nombres, par opposition aux catégories ou chaînes de caractères ; centrer une variable consiste à soustraire sa moyenne à chaque point pour obtenir une moyenne nulle ; mettre à l'échelle une variable consiste à multiplier chaque point par une constante afin de modifier l'amplitude des données. Voir le corps de l'article pour leur importance et des exemples.
Cet article a été généré à partir d'un notebook Jupyter. Vous pouvez télécharger le notebook ici.