- Ein kurzer Einstieg in Regression mit Python
- Logistische Regression und Skalierung: Der Weindatensatz
- Glossar
Im ersten Artikel dieser Reihe habe ich die Rolle des Preprocessings in ML-Klassifikationsaufgaben beleuchtet, mit einem Deep Dive in den Algorithmus k-Nearest Neighbors (k-NN) und den Weinqualitätsdatensatz. Dort hast du gesehen, dass das Zentrieren und Skalieren numerischer Daten die Performance von k-NN in mehreren Kennzahlen (z. B. Genauigkeit) verbessert hat. Du hast auch gesehen, dass Preprocessing nicht im luftleeren Raum stattfindet und sein Wert nur im Kontext einer vorhersageorientierten ML-Pipeline bewertet werden kann. Allerdings haben wir die Bedeutung des Preprocessings nur für ein einzelnes Modell betrachtet, k-NN. In diesem Fall schnitt unser Modell deutlich besser ab — aber ist das immer so? Nicht unbedingt! In diesem Artikel untersuche ich die Rolle des Skalierens und Zentrierens numerischer Daten bei einem weiteren Basismodell, der logistischen Regression. Vielleicht willst du zur Auffrischung den vorherigen Artikel und/oder das Glossar am Ende dieses Beitrags ansehen. Wieder verwenden wir den Weinqualitätsdatensatz. Alle Beispiele sind in Python. Wenn du Python noch nicht kennst, findest du hier unsere Data-Science-Kurse. Ich nutze die Bibliotheken pandas für DataFrames und scikit-learn für Machine Learning.
Ich gebe zunächst einen kurzen Überblick über Regression, die sowohl zur Vorhersage numerischer Variablen als auch von Klassen genutzt werden kann. Ich stelle lineare Regression und logistische Regression vor und nutze Letztere dann, um die Qualität von Rotwein vorherzusagen. Anschließend siehst du, ob Zentrieren und Skalieren unserem Modell im Regressionskontext hilft.
Ein kurzer Einstieg in Regression mit Python
Lineare Regression in Python
Wie oben erwähnt, wird Regression häufig genutzt, um den Wert einer numerischen Variablen aus einer anderen vorherzusagen. Unten führen wir zum Beispiel eine lineare Regression auf Boston-Housing-Daten durch (ein in scikit-learn enthaltener Datensatz): Hier ist die unabhängige Variable (x-Achse) die Zimmeranzahl und die abhängige Variable (y-Achse) der Preis.
Wie funktioniert eine solche Regression? Kurz gesagt, so: Wir wollen ein Modell \(y = ax + b\) an die Daten \((x_i,y_i)\) anpassen, d. h. die optimalen Werte für \(a\) und \(b\) finden. In der Formulierung der kleinsten Quadrate (OLS, mit Abstand am häufigsten) nimmt man an, dass der Fehler in der abhängigen Variable auftritt. Daher werden die optimalen \(a\) und \(b\) durch Minimieren von \[SSE = \sum_i (y_i - (ax_i + b))^2\] gefunden, und diese Optimierung erfolgt häufig per Gradientenabstieg. Hier führen wir eine einfache lineare Regression auf den Boston-Housing-Daten aus:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()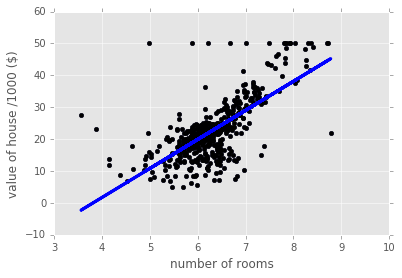
Diese Regression erfasst den allgemeinen Aufwärtstrend der Daten, aber nicht viel mehr. Wir haben nur eine Prädiktorvariable genutzt; man könnte viele weitere verwenden — dann gäbe es \(n\) Koeffizienten \(a_1,\ldots,a_n\) im Modell, je einen pro Prädiktor. Bemerkenswert ist, dass die Größe von \(a_i\) anzeigt, wie stark die entsprechende Variable mit der Zielvariablen korreliert.
Logistische Regression in Python
Regression kann auch für Klassifikationsprobleme eingesetzt werden. Das naheliegendste Beispiel ist die logistische Regression. Bei binärer Klassifikation (zwei Labels) kann man die Labels als 0 und 1 auffassen. Bezeichnen wir die Prädiktorvariable wieder mit \(x\), dann ist das Modell durch die logistische Funktion gegeben: \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] Das ist eine S-förmige Kurve (Sigmoid), ein Beispiel siehst du unten. Für ein gegebenes \(x\) gilt: Wenn \(F(x) < 0.5\), sagt das Modell \(y = 0\) voraus, andernfalls bei \(F(x) > 0.5\) \(y = 1\). Haben wir mehr als eine Prädiktorvariable, gibt es entsprechend \(n\) Koeffizienten \(a_1,\ldots,a_n\). In diesem Fall zeigt die Größe von \(a_i\), wie stark die entsprechende Variable die Zielvariable beeinflusst.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()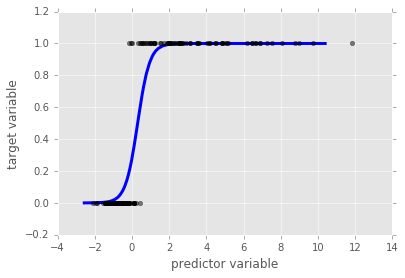
Logistische Regression und Skalierung: Der Weindatensatz
Jetzt, da wir die Mechanik der logistischen Regression gesehen haben, setzen wir einen Klassifikator auf unseren köstlichen Weindatensatz auf. Ich importiere die Daten und zeichne zur Auffrischung die Zielvariable (guter/schlechter Wein):
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()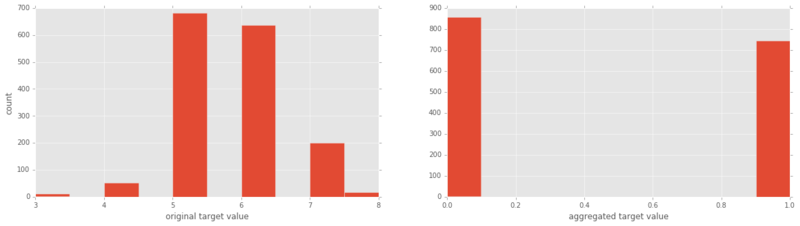
Lass uns nun die logistische Regression ausführen und sehen, wie sie abschneidet!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Out of the box schneidet diese logistische Regression besser ab als k-NN (mit oder ohne Skalierung). Jetzt skalieren wir die Daten und führen erneut logistische Regression aus:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320Das ist spannend! Die Performance der logistischen Regression hat sich durch Skalieren nicht verbessert. Warum nicht — zumal wir gesehen haben, dass k-Nearest Neighbors durch Skalieren deutlich zulegt? Der Grund: Wenn es Prädiktorvariablen mit großen Wertebereichen gibt, die die Zielvariable kaum beeinflussen, setzt ein Regressionsalgorithmus die entsprechenden Koeffizienten \(a_i\) klein, sodass sie die Vorhersage wenig beeinflussen. k-Nearest Neighbors hat so einen eingebauten Mechanismus nicht — deshalb mussten wir dort unbedingt skalieren.
Im nächsten Artikel werde ich die stark unterschiedlichen Effekte von Zentrieren und Skalieren bei k-NN und logistischer Regression aufdröseln: Wir synthetisieren einen Datensatz, fügen Rauschen hinzu und beobachten, wie sich die Performance beider Modelle in Abhängigkeit von der Rauschstärke verändert.
Im interaktiven Fenster unten kannst du selbst mit den Daten spielen. Du kannst die Daten skalieren, indem du sc = True setzt. Führe dann das komplette Skript aus, um die Genauigkeit des logistischen Regressionsmodells sowie einen Classification Report auszugeben.
Glossar
Überwachtes Lernen (Supervised Learning): Die Aufgabe, aus Prädiktorvariablen eine Zielvariable abzuleiten. Beispiel: Die Zielvariable „Vorliegen einer Herzerkrankung“ aus Prädiktoren wie „Alter“, „Geschlecht“ und „Raucherstatus“ vorhersagen.
Klassifikationsaufgabe: Eine Aufgabe des überwachten Lernens ist eine Klassifikationsaufgabe, wenn die Zielvariable aus Kategorien besteht (z. B. „Klick“ oder „kein Klick“, „bösartig“ oder „gutartig“ bei Tumoren).
Regressionsaufgabe: Eine Aufgabe des überwachten Lernens ist eine Regressionsaufgabe, wenn die Zielvariable kontinuierlich ist (z. B. Hauspreis) oder eine geordnete kategoriale Variable wie die „Qualitätsbewertung von Wein“.
k-Nearest Neighbors: Ein Algorithmus für Klassifikationsaufgaben, bei dem ein Datenpunkt das Label erhält, das durch Mehrheitsentscheid seiner k nächsten Nachbarn bestimmt wird.
Preprocessing: Verschiedene Schritte, mit denen Data Scientists Daten so aufbereiten, dass sie für das jeweilige Vorhaben besser geeignet sind. Beispiel: Bevor du eine Sentimentanalyse auf Twitter-Daten durchführst, willst du vielleicht HTML-Tags und überflüssige Leerzeichen entfernen, Abkürzungen ausschreiben und Tweets in Wortlisten zerlegen.
Zentrieren und Skalieren: Zwei Formen des Preprocessings von numerischen Daten, also Daten, die aus Zahlen bestehen (im Gegensatz zu Kategorien oder Strings). Zentrieren bedeutet, vom jeweiligen Datenpunkt den Mittelwert der Variable abzuziehen, sodass der neue Mittelwert 0 ist. Skalieren bedeutet, jeden Datenpunkt mit einer Konstante zu multiplizieren, um den Wertebereich zu verändern. Im Artikel findest du Beispiele und warum das wichtig ist.
Dieser Artikel wurde aus einem Jupyter-Notebook generiert. Das Notebook kannst du hier herunterladen.