- Python के साथ रिग्रेशन का संक्षिप्त परिचय
- लॉजिस्टिक रिग्रेशन और डेटा स्केलिंग: वाइन डेटा सेट
- शब्दावली
इस श्रृंखला के पहले लेख में, मैंने मशीन लर्निंग (ML) की क्लासिफिकेशन टास्क में प्रीप्रोसेसिंग की भूमिका को खोजा, खासकर k-Nearest Neighbours एल्गोरिदम (k-NN) और वाइन क्वालिटी डेटा सेट के संदर्भ में। वहाँ आपने देखा कि संख्यात्मक डेटा को सेंटर और स्केल करने से कई मॉडल प्रदर्शन मानकों (जैसे सटीकता) में k-NN का प्रदर्शन बेहतर हुआ। आपने यह भी देखा कि प्रीप्रोसेसिंग अलग-थलग नहीं होती—इसका मूल्यांकन भविष्यवाणी-उन्मुख ML पाइपलाइन के संदर्भ में ही किया जा सकता है। हालांकि, हमने प्रीप्रोसेसिंग का महत्व केवल एक ही मॉडल, k-NN, के संदर्भ में देखा। उस मामले में हमारा मॉडल काफ़ी बेहतर चला, पर क्या यह हमेशा होगा? ज़रूरी नहीं! इस लेख में, मैं एक अन्य बुनियादी मॉडल—लॉजिस्टिक रिग्रेशन—में संख्यात्मक डेटा को स्केल और सेंटर करने की भूमिका की पड़ताल करूंगा। आप चाहें तो पिछला लेख और/या नीचे दी गई शब्दावली दोबारा देख सकते हैं। एक बार फिर, हम वाइन क्वालिटी डेटा सेट का अध्ययन करेंगे। सभी उदाहरण Python में होंगे। यदि आप Python से परिचित नहीं हैं, तो आप हमारे सभी डेटा साइंस पाठ्यक्रम यहाँ देख सकते हैं। मैं pandas का उपयोग डेटा फ़्रेम के लिए और scikit-learn का उपयोग मशीन लर्निंग के लिए करूंगा।
मैं पहले रिग्रेशन का संक्षिप्त परिचय दूंगा, जिसका उपयोग संख्यात्मक मान के साथ-साथ वर्गों का अनुमान लगाने के लिए भी किया जा सकता है। मैं लीनियर रिग्रेशन, लॉजिस्टिक रिग्रेशन का परिचय दूंगा और फिर बाद वाले का उपयोग करके रेड वाइन की गुणवत्ता का अनुमान लगाऊंगा। इसके बाद आप देखेंगे कि रिग्रेशन सेटिंग में सेंटरिंग और स्केलिंग हमारे मॉडल की मदद करती है या नहीं।
Python के साथ रिग्रेशन का संक्षिप्त परिचय
Python में लीनियर रिग्रेशन
जैसा कि ऊपर उल्लेख किया गया है, रिग्रेशन का उपयोग सामान्यतः एक संख्यात्मक चर के मान का दूसरे से अनुमान लगाने के लिए किया जाता है। उदाहरण के लिए, नीचे हम बॉस्टन हाउसिंग डेटा (scikit-learn में अंतर्निहित डेटा सेट) पर लीनियर रिग्रेशन करते हैं: इस मामले में, स्वतंत्र चर (x-अक्ष) कमरों की संख्या है और आश्रित चर (y-अक्ष) कीमत है।
ऐसा रिग्रेशन कैसे काम करता है? संक्षेप में, तंत्र यह है: हम डेटा \((x_i,y_i)\) पर एक मॉडल \(y = ax + b\) फिट करना चाहते हैं, यानी दिए गए डेटा के अनुसार इष्टतम \(a\) और \(b\) ढूंढना चाहते हैं। ऑर्डिनरी लीस्ट स्क्वेयर्स (OLS, सबसे सामान्य) निर्माण में यह मान लिया जाता है कि त्रुटि आश्रित चर में होगी। इसी कारण, इष्टतम \(a\) और \(b\) को \[SSE = \sum_i (y_i - (ax_i + b))^2\] को न्यूनतम करके पाया जाता है और यह अनुकूलन प्रायः ग्रेडिएंट डीसेंट नामक एल्गोरिदम से किया जाता है। यहाँ हम बॉस्टन हाउसिंग डेटा पर एक सरल लीनियर रिग्रेशन करते हैं:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()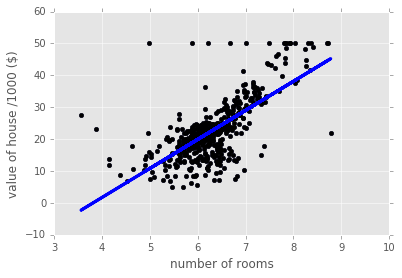
यह रिग्रेशन डेटा की समग्र बढ़ती प्रवृत्ति को तो पकड़ता है, लेकिन उससे अधिक नहीं। हमने केवल एक प्रेडिक्टर चर का उपयोग किया, जबकि हम और भी कई का उपयोग कर सकते थे—ऐसे में मॉडल में हमारे पास \(n\) गुणांक \(a_1,\ldots,a_n\) होते, प्रत्येक प्रेडिक्टर चर के लिए एक। ध्यान देने योग्य है कि चर \(a_i\) का परिमाण हमें बताता है कि संबंधित चर लक्ष्य चर के साथ कितना मज़बूती से सहसंबद्ध है।
Python में लॉजिस्टिक रिग्रेशन
रिग्रेशन का उपयोग क्लासिफिकेशन समस्याओं के लिए भी किया जा सकता है। इसका पहला स्वाभाविक उदाहरण लॉजिस्टिक रिग्रेशन है। द्विआधारी क्लासिफिकेशन (दो लेबल) में, हम लेबल को 0 और 1 के रूप में सोच सकते हैं। फिर से प्रेडिक्टर चर को \(x\) मानते हुए, लॉजिस्टिक रिग्रेशन मॉडल लॉजिस्टिक फ़ंक्शन से दिया जाता है: \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] यह एक सिग्मॉइडल (S-आकृति) वक्र है और नीचे एक उदाहरण देख सकते हैं। किसी भी दिए गए \(x\) के लिए, यदि \(F(x) <0.5\) हो, तो लॉजिस्टिक मॉडल y = 0 की भविष्यवाणी करता है, और यदि \(F(X) > 0.5\) हो, तो मॉडल \(y = 1\) की भविष्यवाणी करता है। एक से अधिक प्रेडिक्टर चर होने की स्थिति में हमारे पास \(n\) गुणांक \(a_1,\ldots,a_n\) भी होते हैं, प्रत्येक प्रेडिक्टर चर के लिए एक। इस स्थिति में, चर \(a_i\) का परिमाण हमें बताता है कि संबंधित चर प्रेडिक्शन को कितनी मज़बूती से प्रभावित करता है।
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()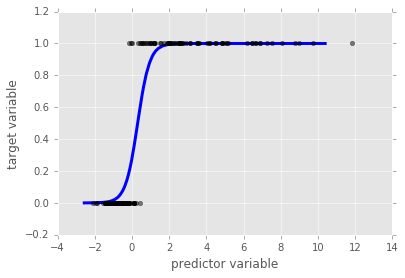
लॉजिस्टिक रिग्रेशन और डेटा स्केलिंग: वाइन डेटा सेट
अब जबकि हमने लॉजिस्टिक रिग्रेशन की कार्यप्रणाली देख ली है, आइए अपने स्वादिष्ट वाइन डेटा सेट पर लॉजिस्टिक रिग्रेशन क्लासिफायर लागू करें। मैं डेटा इम्पोर्ट करूंगा और लक्ष्य चर (अच्छी/खराब वाइन) का प्लॉट एक रिफ्रेशर के रूप में दिखाऊंगा:
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()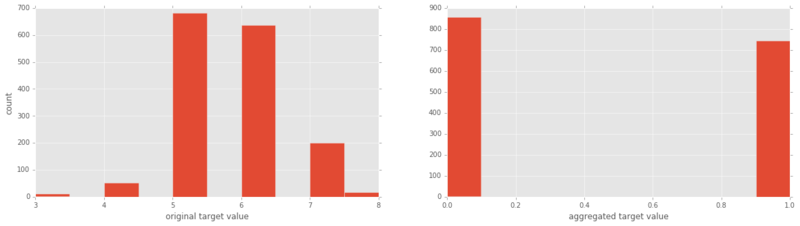
अब अपना लॉजिस्टिक रिग्रेशन चलाते हैं और देखते हैं इसका प्रदर्शन कैसा है!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320बॉक्स से बाहर ही, यह लॉजिस्टिक रिग्रेशन K-NN से बेहतर प्रदर्शन करता है (स्केलिंग के साथ या बिना)। अब अपने डेटा को स्केल करते हैं और लॉजिस्टिक रिग्रेशन चलाते हैं:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320यह बहुत दिलचस्प है! डेटा स्केलिंग के साथ लॉजिस्टिक रिग्रेशन का प्रदर्शन बेहतर नहीं हुआ। क्यों नहीं, खासकर जब हमने देखा कि k-Nearest Neighbours का प्रदर्शन स्केलिंग से काफ़ी बेहतर हुआ था? कारण यह है कि यदि कुछ प्रेडिक्टर चर का रेंज बड़ा है लेकिन वे लक्ष्य चर को प्रभावित नहीं करते, तो रिग्रेशन एल्गोरिदम संबंधित गुणांक \(a_i\) को छोटा कर देगा ताकि वे भविष्यवाणी पर अधिक असर न डालें। K-nearest neighbours में ऐसी अंतर्निहित रणनीति नहीं होती और इसलिए वहाँ हमें डेटा स्केल करना बहुत ज़रूरी था।
अगले लेख में, मैं कृत्रिम रूप से एक डेटा सेट बनाकर, उसमें शोर जोड़कर, और यह देखकर कि शोर की तीव्रता के फलन के रूप में सेंटरिंग और स्केलिंग दोनों मॉडलों के प्रदर्शन को कैसे बदलते हैं, k-NN और लॉजिस्टिक रिग्रेशन में मिले एकदम अलग परिणामों को खोलकर समझाऊंगा।
नीचे दी गई इंटरैक्टिव विंडो में, आप स्वयं डेटा से खेल सकते हैं। चाहें तो sc = True सेट करके डेटा को स्केल कर सकते हैं। फिर पूरी स्क्रिप्ट चलाएँ ताकि लॉजिस्टिक रिग्रेशन मॉडल की शुद्धता के साथ एक क्लासिफिकेशन रिपोर्ट भी प्राप्त हो।
शब्दावली
Supervised learning: प्रेडिक्टर वेरिएबल से टारगेट वेरिएबल का अनुमान लगाने का कार्य। उदाहरण के लिए, टारगेट वेरिएबल ‘हृदय रोग की उपस्थिति’ का, ‘आयु’, ‘लिंग’, और ‘धूम्रपान की स्थिति’ जैसे प्रेडिक्टर वेरिएबल से अनुमान।
Classification task: यदि टारगेट वेरिएबल श्रेणियों से बना है (जैसे ‘क्लिक’ या ‘नहीं’, ‘घातक’ या ‘सौम्य’ ट्यूमर), तो सुपरवाइज्ड लर्निंग का कार्य एक क्लासिफिकेशन टास्क है।
Regression task: यदि टारगेट वेरिएबल एक सतत रूप से बदलने वाला चर है (जैसे घर की कीमत) या ‘वाइन की गुणवत्ता रेटिंग’ जैसी क्रमबद्ध श्रेणीबद्ध चर है, तो सुपरवाइज्ड लर्निंग का कार्य एक रिग्रेशन टास्क है।
k-Nearest Neighbors: क्लासिफिकेशन टास्क के लिए एक एल्गोरिदम, जिसमें किसी डेटा बिंदु को उसके k निकटतम पड़ोसियों के बहुमत मत से तय लेबल सौंपा जाता है।
Preprocessing: वे विविध क्रियाएँ जो डेटा वैज्ञानिक अपने डेटा को इच्छित प्रयोजन के लिए अधिक उपयुक्त रूप में लाने हेतु करते हैं। उदाहरण के लिए, ट्विटर डेटा पर सेंटिमेंट एनालिसिस करने से पहले, आप कोई भी HTML टैग, अतिरिक्त स्पेस हटाना, संक्षेपों का विस्तार करना और ट्वीट्स को उनके शब्दों की सूचियों में विभाजित करना चाहेंगे।
Centering and Scaling: ये दोनों संख्यात्मक डेटा की प्रीप्रोसेसिंग के रूप हैं—अर्थात संख्याओं से बना डेटा, न कि श्रेणियों या स्ट्रिंग्स आदि। किसी चर को सेंटर करना मतलब प्रत्येक डेटा बिंदु से उस चर के औसत को घटाना ताकि नए चर का औसत 0 हो; किसी चर को स्केल करना मतलब डेटा की रेंज बदलने के लिए प्रत्येक डेटा बिंदु को एक नियतांक से गुणा करना। इनके महत्व के लिए उदाहरणों सहित लेख के मुख्य भाग को देखें।
यह लेख एक Jupyter नोटबुक से जनरेट किया गया है। आप नोटबुक यहाँ से डाउनलोड कर सकते हैं।