Bu seri'nin ilk yazısında, makine öğreniminde (ML) sınıflandırma görevlerinde ön işlemenin rolünü, k-En Yakın Komşu algoritması (k-NN) ve şarap kalitesi veri kümesi üzerinden derinlemesine inceledim. Orada, sayısal verilerin merkezlenmesi ve ölçeklenmesinin k-NN performansını çeşitli model ölçütlerinde (örn. doğruluk) iyileştirdiğini gördünüz. Ayrıca, ön işlemenin bağlamdan bağımsız gerçekleşmediğini ve değerinin ancak tahmine odaklı bir ML hattı bağlamında değerlendirilebileceğini gördünüz. Ancak, ön işlemenin önemini yalnızca tek bir model, k-NN bağlamında gördük. Bu durumda modelimiz belirgin şekilde daha iyi performans gösterdi ama bu her zaman böyle mi olacak? Mutlaka değil! Bu yazıda, başka bir temel model olan lojistik regresyonda sayısal verilerin ölçeklenmesi ve merkezlenmesinin rolünü inceleyeceğim. İsterseniz kendinizi tazelemek için önceki yazıya ve/veya bu yazının sonundaki terimler sözlüğüne göz atabilirsiniz. Yine şarap kalitesi veri kümesini inceleyeceğiz. Tüm örnekler Python ile olacak. Python'a aşina değilseniz, tüm veri bilimi kurslarımıza buradan göz atabilirsiniz. Veri çerçevesi ihtiyaçlarımız için pandas ve makine öğrenimi için scikit-learn kütüphanelerini kullanacağım.
Önce, bir sayısal değişkenin veya sınıfların değerini tahmin etmek için kullanılabilen regresyona kısaca giriş yapacağım. Doğrusal regresyonu, lojistik regresyonu tanıtacak ve ardından ikincisini kırmızı şarabın kalitesini tahmin etmek için kullanacağım. Sonrasında, merkezleme ve ölçeklemenin bir regresyon ortamında modelimize yardımcı olup olmadığını göreceksiniz.
Python ile Regresyona Kısa Bir Giriş
Python'da Doğrusal Regresyon
Yukarıda belirtildiği gibi, regresyon yaygın olarak bir sayısal değişkenin değerini başka birinden tahmin etmek için kullanılır. Örneğin, aşağıda Boston konut verileri üzerinde (scikit-learn içinde yerleşik bir veri kümesi) bir doğrusal regresyon gerçekleştiriyoruz: bu durumda, bağımsız değişken (x ekseni) oda sayısı, bağımlı değişken (y ekseni) ise fiyattır.
Böyle bir regresyon nasıl çalışır? Kısaca, mekanik şu şekildedir: Veriye \( (x_i,y_i) \) bir \( y = ax + b \) modeli uydurmak isteriz; yani, verilen veri ile en iyi \( a \) ve \( b \) değerlerini bulmak isteriz. Sıradan en küçük kareler (OLS, açık ara en yaygını) formülasyonunda, hatanın bağımlı değişkende ortaya çıkacağı varsayılır. Bu nedenle, en iyi \( a \) ve \( b \), \[SSE = \sum_i (y_i - (ax_i + b))^2\] ifadesini en aza indirerek bulunur ve bu optimizasyon genellikle gradyan inişi adı verilen bir algoritma ile gerçekleştirilir. Aşağıda Boston konut verileri üzerinde basit bir doğrusal regresyon yapıyoruz:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()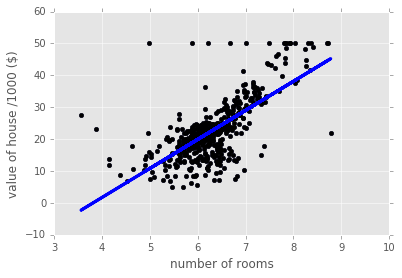
Bu regresyon, verilerin genel artan eğilimini yakalıyor ancak fazlasını değil. Yalnızca bir yordayıcı değişken kullandık; daha fazlasını da kullanabilirdik ki bu durumda modelde her bir yordayıcı değişken için birer tane olmak üzere \( a_1,\ldots,a_n \) olmak üzere \( n \) katsayıya sahip olurduk. \( a_i \) değişkeninin büyüklüğünün, karşılık gelen değişkenin hedef değişkenle ne kadar güçlü ilişkilendiğini bize söylediğine dikkat etmek gerekir.
Python'da Lojistik Regresyon
Regresyon, sınıflandırma problemleri için de kullanılabilir. Bunun doğal ilk örneği lojistik regresyondur. İkili sınıflandırmada (iki etiket), etiketleri 0 ve 1 olarak düşünebiliriz. Yordayıcı değişkeni yine \( x \) ile gösterirsek, lojistik regresyon modeli lojistik fonksiyon ile verilir: \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] Bu, sigmoidal (S-şekilli) bir eğridir ve aşağıda bir örneğini görebilirsiniz. Herhangi bir \( x \) için, eğer \( F(x) < 0.5 \) ise lojistik model y = 0 tahmin eder; buna karşılık, eğer \( F(X) > 0.5 \) ise model \( y = 1 \) tahmin eder. Yine, birden fazla yordayıcı değişkenimiz varsa, her biri için birer tane olmak üzere \( a_1,\ldots,a_n \) şeklinde \( n \) katsayıya sahip oluruz. Bu durumda, \( a_i \) değişkeninin büyüklüğü, karşılık gelen değişkenin hedef değişkeni ne ölçüde etkilediğini gösterir.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()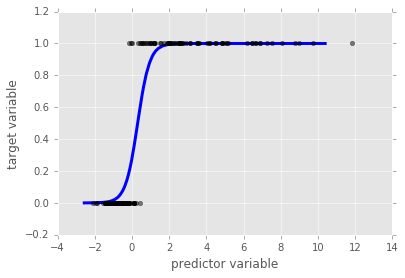
Lojistik Regresyon ve Veri Ölçekleme: Şarap Veri Kümesi
Artık lojistik regresyonun işleyişini gördüğümüze göre, lezzetli şarap veri kümemiz üzerinde bir lojistik regresyon sınıflandırıcısı uygulayalım. Verileri içe aktaracağım ve hedef değişkeni (iyi/kötü şarap) tazeleme amaçlı görselleştireceğim:
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()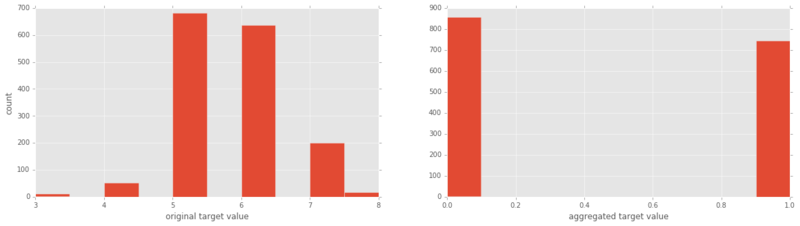
Şimdi lojistik regresyonumuzu çalıştıralım ve nasıl performans gösterdiğine bakalım!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Kutudan çıktığı haliyle, bu lojistik regresyon, K-NN'den (ölçekleme olsun ya da olmasın) daha iyi performans gösteriyor. Şimdi verilerimizi ölçekleyip lojistik regresyon uygulayalım:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320Bu oldukça ilginç! Lojistik regresyonun performansı, veri ölçekleme ile iyileşmedi. Neden, özellikle de k-En Yakın Komşu'nun performansının ölçekleme ile önemli ölçüde arttığını görmüşken? Bunun nedeni, hedef değişkeni etkilemeyen geniş aralıklara sahip yordayıcı değişkenler varsa, bir regresyon algoritmasının karşılık gelen \( a_i \) katsayılarını küçük yaparak tahminleri çok etkilememelerini sağlamasıdır. K-en yakın komşuların böyle yerleşik bir stratejisi yoktur; bu yüzden verileri ölçeklemeye ciddi biçimde ihtiyaç duyduk.
Bir sonraki yazıda, sentetik bir veri kümesi oluşturarak, gürültü ekleyerek ve merkezleme ile ölçeklemenin her iki modelin performansını gürültü şiddetinin bir fonksiyonu olarak nasıl değiştirdiğine bakarak, k-NN ve lojistik regresyonda merkezleme ve ölçeklemenin çok farklı sonuçlarını açacağım.
Aşağıdaki etkileşimli pencerede verilerle kendiniz oynayabilirsiniz. İsterseniz sc = True ayarlayarak verileri ölçekleyebilirsiniz. Ardından, lojistik regresyon modelinin doğruluğunu ve bir sınıflandırma raporunu görmek için tüm betiği çalıştırın.
Sözlük
Denetimli öğrenme: Hedef değişkeninin yordayıcı değişkenlerden çıkarılması görevi. Örneğin, ‘kalp hastalığı varlığı’ hedef değişkenini, ‘yaş’, ‘cinsiyet’ ve ‘sigara içme durumu’ gibi yordayıcı değişkenlerden çıkarmak.
Sınıflandırma görevi: Hedef değişkenin kategorilerden oluştuğu (örn. ‘tıkladı’ veya ‘tıkladı değil’, ‘malign’ veya ‘benign’ tümör) bir denetimli öğrenme görevi bir sınıflandırma görevidir.
Regresyon görevi: Hedef değişkenin sürekli değişen bir değişken (örn. bir evin fiyatı) veya ‘şarabın kalite derecesi’ gibi sıralı kategorik bir değişken olduğu bir denetimli öğrenme görevi bir regresyon görevidir.
k-En Yakın Komşu: Bir veri noktasına, en yakın k komşusunun çoğunluk oyu ile belirlenen etiketin atandığı bir sınıflandırma görevi algoritması.
Ön işleme: Veri bilimcilerin, verilerini yapmak istedikleri işleme daha uygun bir hale getirmek için kullanacakları çok sayıda işlem. Örneğin, Twitter verilerinin duygu analizini yapmadan önce, HTML etiketlerini ve boşlukları temizlemek, kısaltmaları açmak ve tweet'leri içerdikleri kelimelerin listelerine bölmek isteyebilirsiniz.
Merkezleme ve Ölçekleme: Bunlar, sayılar gibi sayısal verilerin ön işlenmesine yönelik iki yöntemdir; örneğin kategoriler veya dizgeler yerine. Bir değişkeni merkezlemek, her veri noktasından değişkenin ortalamasını çıkararak yeni değişkenin ortalamasını 0 yapmaktır; bir değişkeni ölçeklemek ise veri aralığını değiştirmek amacıyla her veri noktasını sabit bir sayı ile çarpmaktır. Bunların önemine ve örneklerine yazı içinde bakınız.
Bu makale bir Jupyter defterinden üretildi. Defteri buradan indirebilirsiniz.




