
Last chance! 50% off DataCamp Premium
Sale ends in
In het eerste artikel van deze reeks onderzocht ik de rol van preprocessing bij machine learning (ML) classificatietaken, met een deep dive in het k-Nearest Neighbours-algoritme (k-NN) en de wijnkwaliteitsdataset. Daar zag je dat centreren en schalen van numerieke data de prestaties van k-NN verbeterde voor een aantal maatstaven voor modelprestaties (bijv. nauwkeurigheid). Je zag ook dat preprocessing niet in een vacuüm plaatsvindt en dat de waarde ervan alleen kan worden beoordeeld binnen de context van een op voorspelling gerichte ML-pijplijn. We zagen echter alleen het belang van preprocessing in de context van één model, k-NN. In dit geval presteerde ons model aanzienlijk beter, maar is dat altijd zo? Niet per se! In dit artikel verken ik de rol van schalen en centreren van numerieke data in een ander basismodel: logistische regressie. Misschien wil je je geheugen opfrissen door het vorige artikel en/of de woordenlijst onderaan dit stuk te bekijken. We verkennen opnieuw de wijnkwaliteitsdataset. Alle voorbeelden zijn in Python. Als je niet bekend bent met Python, bekijk dan al onze data science-cursussen hier. Ik gebruik de libraries pandas voor onze dataframe-behoeften en scikit-learn voor onze machine learning-behoeften.
Eerst geef ik een korte introductie tot regressie, dat kan worden gebruikt om zowel de waarde van een numerieke variabele als klassen te voorspellen. Ik introduceer lineaire regressie, logistische regressie en gebruik vervolgens die laatste om de kwaliteit van rode wijn te voorspellen. Daarna zie je of centreren en schalen ons model helpt in een regressie-context.
Zoals hierboven vermeld, wordt regressie vaak gebruikt om de waarde van een numerieke variabele te voorspellen op basis van een andere. Hieronder voeren we bijvoorbeeld een lineaire regressie uit op Boston-huisgegevens (een ingebouwde dataset in scikit-learn): in dit geval is de onafhankelijke variabele (x-as) het aantal kamers en de afhankelijke variabele (y-as) de prijs.
Hoe werkt zo’n regressie? Kort samengevat zijn de mechanismen als volgt: we willen een model \(y = ax + b\) fitten op de data \((x_i,y_i)\), dat wil zeggen, we willen de optimale \(a\) en \(b\) vinden, gegeven de data. In de ordinary least squares (OLS, veruit de meest gebruikte) formulering wordt aangenomen dat de fout optreedt in de afhankelijke variabele. Daarom worden de optimale \(a\) en \(b\) gevonden door \[SSE = \sum_i (y_i - (ax_i + b))^2\] te minimaliseren, en deze optimalisatie wordt vaak bereikt met een algoritme dat gradient descent heet. Hier voeren we een eenvoudige lineaire regressie uit op de Boston-huisgegevens:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()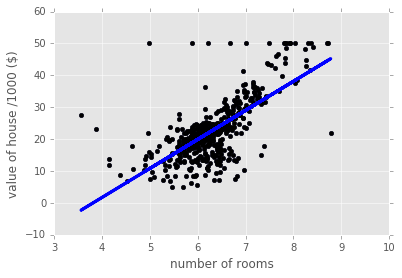
Deze regressie pakt de algemene stijgende trend van de data, maar niet veel meer. We hebben slechts één predictorvariabele gebruikt en hadden er veel meer kunnen gebruiken; in dat geval zouden we \(n\) coëfficiënten \(a_1,\ldots,a_n\) in het model hebben, één voor elke predictorvariabele. Het is het vermelden waard dat de grootteorde van de variabele \(a_i\) ons vertelt hoe sterk de corresponderende variabele correleert met de doelvariabele.
Regressie kan ook worden gebruikt voor classificatieproblemen. Het eerste voor de hand liggende voorbeeld hiervan is logistische regressie. Bij binaire classificatie (twee labels) kun je de labels zien als 0 & 1. Met de predictorvariabele aangeduid als \(x\), wordt het logistische regressiemodel gegeven door de logistische functie \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] Dit is een sigmoïde (S-vormige) kromme; hieronder zie je een voorbeeld. Voor een gegeven \(x\), als \(F(x) <0.5\), dan voorspelt het logistische model y = 0 en, als \(F(X) > 0.5\), voorspelt het model \(y = 1\). Opnieuw, als we meer dan één predictorvariabele hebben, hebben we ook \(n\) coëfficiënten \(a_1,\ldots,a_n\), één voor elke predictorvariabele. In dit geval vertelt de grootteorde van de variabele \(a_i\) ons hoe sterk de corresponderende variabele de doelvariabele beïnvloedt.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()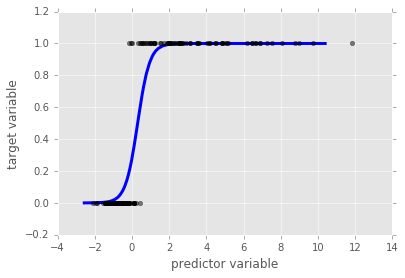
Nu we de mechanismen van logistische regressie hebben gezien, implementeren we een logistische classificatie op onze heerlijke wijndataset. Ik importeer de data en plot de doelvariabele (goede/slechte wijn) als opfrisser:
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()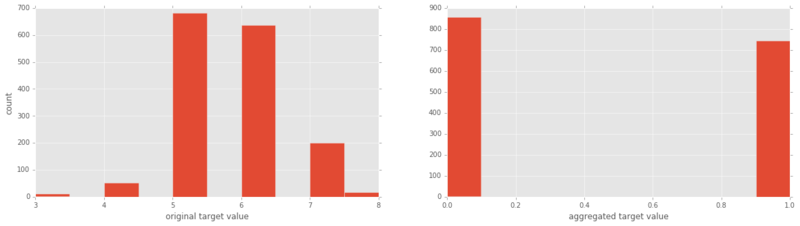
Laten we nu onze logistische regressie draaien en zien hoe die presteert!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Zo uit de doos presteert deze logistische regressie beter dan K-NN (met of zonder schalen). Laten we nu onze data schalen en logistische regressie uitvoeren:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320Dit is erg interessant! De prestaties van logistische regressie verbeterden niet door dataschaling. Waarom niet, zeker omdat we zagen dat de prestaties van k-Nearest Neighbours aanzienlijk verbeterden met schalen? De reden is dat, als er predictorvariabelen zijn met grote bereiken die de doelvariabele niet beïnvloeden, een regressie-algoritme de corresponderende coëfficiënten \(a_i\) klein zal maken zodat ze de voorspellingen niet zo sterk beïnvloeden. K-nearest neighbours heeft zo’n ingebouwde strategie niet, en daarom moesten we de data juist wel schalen.
In het volgende artikel pak ik de sterk verschillende resultaten van centreren en schalen in k-NN en logistische regressie uit door een dataset te synthetiseren, ruis toe te voegen en te bekijken hoe centreren en schalen de prestaties van beide modellen veranderen als functie van de ruissterkte.
In het interactieve venster hieronder kun je zelf met de data spelen. Je kunt de data schalen door sc = True in te stellen, als je dat wilt. Voer vervolgens het volledige script uit om de nauwkeurigheid van het logistische regressiemodel te rapporteren, samen met een classificatierapport.
Supervised learning: De taak om een doelvariabele af te leiden uit predictorvariabelen. Bijvoorbeeld: het afleiden van de doelvariabele ‘aanwezigheid van hartziekte’ uit predictorvariabelen zoals ‘leeftijd’, ‘geslacht’ en ‘rookstatus’.
Classificatietaak: Een taak van supervised learning is een classificatietaak als de doelvariabele uit categorieën bestaat (bijv. ‘klik’ of ‘geen’, ‘kwaadaardig’ of ‘goedaardig’ gezwel).
Regressietaak: Een taak van supervised learning is een regressietaak als de doelvariabele een continu variërende variabele is (bijv. prijs van een huis) of een geordende categorische variabele zoals ‘kwaliteitsbeoordeling van wijn’.
k-Nearest Neighbors: Een algoritme voor classificatietaken waarbij een datapunt het label krijgt dat wordt bepaald door een meerderheid van zijn k dichtstbijzijnde buren.
Preprocessing: Allerlei bewerkingen die data scientists gebruiken om hun data in een vorm te krijgen die beter aansluit bij wat ze ermee willen doen. Bijvoorbeeld: voordat je sentimentanalyse uitvoert op Twitter-gegevens, wil je misschien alle html-tags en witruimtes verwijderen, afkortingen uitschrijven en de tweets opsplitsen in lijsten met de woorden die ze bevatten.
Centreren en schalen: Dit zijn vormen van preprocessing van numerieke data, dat wil zeggen data die uit getallen bestaat, in tegenstelling tot bijvoorbeeld categorieën of strings; centreren van een variabele is het gemiddelde van de variabele van elk datapunt aftrekken zodat het gemiddelde van de nieuwe variabele 0 is; schalen van een variabele is elk datapunt met een constante vermenigvuldigen om het bereik van de data te veranderen. Zie de hoofdtekst van het artikel voor het belang hiervan, met voorbeelden.
Dit artikel is gegenereerd vanuit een Jupyter-notebook. Je kunt de notebook hier downloaden.
blog
Adel Nehme
15 min

