- uma breve introdução à regressão com Python
- regressão logística e padronização de dados: o conjunto de dados de vinho
- glossário
No primeiro artigo desta série, explorei o papel do pré-processamento em tarefas de classificação de machine learning (ML), com um mergulho no algoritmo k-Nearest Neighbours (k-NN) e no conjunto de dados de qualidade de vinhos. Lá você viu que centralizar e padronizar dados numéricos melhorou o desempenho do k-NN em diversas métricas do modelo (por exemplo, acurácia). Você também viu que o pré-processamento não acontece no vácuo e que seu valor só pode ser avaliado dentro do contexto de um pipeline de ML orientado a predição. Porém, vimos a importância do pré-processamento apenas no contexto de um único modelo, o k-NN. Nesse caso, nosso modelo teve um ganho significativo — mas isso sempre acontece? Nem sempre! Neste artigo, vou explorar o papel de padronizar e centralizar dados numéricos em outro modelo básico, a regressão logística. Pode valer a pena revisitar o artigo anterior e/ou o glossário no fim da página. Mais uma vez, vamos usar o dataset de qualidade de vinhos. Todos os exemplos serão em Python. Se você não está familiarizado com Python, confira nossos cursos de ciência de dados aqui. Vou usar as bibliotecas pandas para manipular dataframes e scikit-learn para machine learning.
Primeiro, farei uma breve introdução à regressão, que pode ser usada para prever tanto o valor de uma variável numérica quanto classes. Vou apresentar a regressão linear, a regressão logística e, em seguida, usar a segunda para prever a qualidade de vinhos tintos. Depois, você verá se centralizar e padronizar ajuda nosso modelo em um cenário de regressão.
Uma breve introdução à regressão com Python
Regressão linear em Python
Como mencionado acima, a regressão é comumente usada para prever o valor de uma variável numérica a partir de outra. Por exemplo, abaixo executamos uma regressão linear nos dados de imóveis de Boston (um dataset embutido no scikit-learn): neste caso, a variável independente (eixo x) é o número de quartos e a variável dependente (eixo y) é o preço.
Como funciona essa regressão? Em resumo, a mecânica é a seguinte: queremos ajustar um modelo \(y = ax + b\) aos dados \((x_i,y_i)\), isto é, encontrar os \(a\) e \(b\) ótimos, dados os dados. Na formulação de mínimos quadrados ordinários (OLS, de longe a mais comum), assume-se que o erro ocorre na variável dependente. Por isso, os \(a\) e \(b\) ótimos são obtidos minimizando \[SSE = \sum_i (y_i - (ax_i + b))^2\] e essa otimização é geralmente feita com um algoritmo conhecido como gradiente descendente. Aqui fazemos uma regressão linear simples com os dados de imóveis de Boston:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()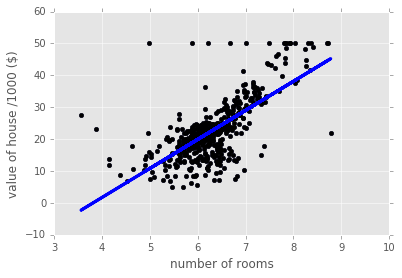
Essa regressão captura a tendência geral de crescimento dos dados, mas não muito além disso. Usamos apenas uma variável preditora, mas poderíamos ter usado várias — nesse caso, teríamos \(n\) coeficientes \(a_1,\ldots,a_n\) no modelo, um para cada variável preditora. Vale notar que a magnitude de \(a_i\) indica quão fortemente a variável correspondente se correlaciona com a variável alvo.
Regressão logística em Python
A regressão também pode ser usada para problemas de classificação. O primeiro exemplo natural é a regressão logística. Em classificação binária (dois rótulos), podemos pensar nos rótulos como 0 e 1. Novamente denotando a variável preditora por \(x\), o modelo de regressão logística é dado pela função logística \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] Ela tem formato sigmoide (em S) e você pode ver um exemplo abaixo. Para um dado \(x\), se \(F(x) <0.5\), o modelo logístico prediz y = 0 e, se \(F(X) > 0.5\), o modelo prediz \(y = 1\). Novamente, se tivermos mais de uma variável preditora, também teremos \(n\) coeficientes \(a_1,\ldots,a_n\), um para cada variável preditora. Nesse caso, a magnitude de \(a_i\) indica quão fortemente a variável correspondente afeta a variável alvo.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()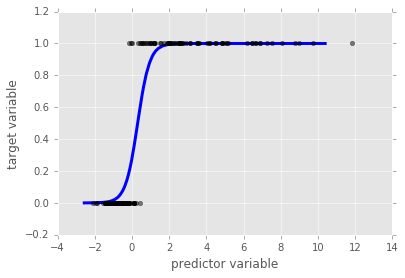
Regressão logística e padronização de dados: o conjunto de dados de vinho
Agora que vimos a mecânica da regressão logística, vamos implementar um classificador de regressão logística no nosso delicioso dataset de vinhos. Vou importar os dados e plotar a variável alvo (vinho bom/ruim) para relembrar:
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()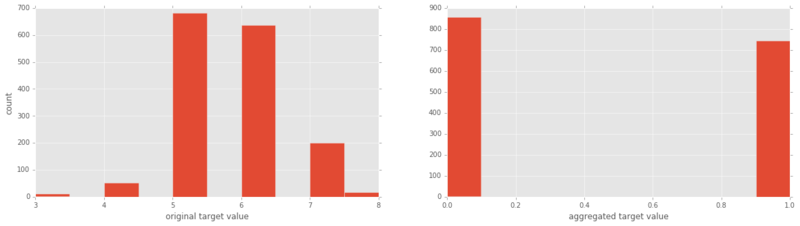
Agora vamos rodar nossa regressão logística e ver como ela se sai!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Pronto para usar, essa regressão logística supera o K-NN (com ou sem padronização). Agora vamos padronizar os dados e rodar a regressão logística:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320Muito interessante! O desempenho da regressão logística não melhorou com a padronização. Por quê, especialmente considerando que o desempenho do k-Nearest Neigbours melhorou bastante com a padronização? O motivo é que, se houver variáveis preditoras com grandes faixas que não afetam a variável alvo, um algoritmo de regressão tende a atribuir coeficientes \(a_i\) pequenos a elas, de modo que influenciem pouco as previsões. O k-nearest neighbours não tem essa estratégia embutida, então precisamos bastante da padronização nesse caso.
No próximo artigo, vou destrinchar os resultados tão diferentes de centralizar e padronizar em k-NN e regressão logística sintetizando um dataset, adicionando ruído e observando como essas técnicas alteram o desempenho de ambos os modelos em função da intensidade do ruído.
No painel interativo abaixo, você pode experimentar os dados por conta própria. Você pode padronizar os dados definindo sc = True, se quiser. Depois, execute todo o script para ver a acurácia do modelo de regressão logística, junto com um relatório de classificação.
Glossário
Aprendizado supervisionado: A tarefa de inferir uma variável alvo a partir de variáveis preditoras. Por exemplo, inferir a variável alvo "presença de doença cardíaca" a partir de variáveis preditoras como "idade", "sexo" e "tabagismo".
Tarefa de classificação: Uma tarefa de aprendizado supervisionado é uma tarefa de classificação quando a variável alvo consiste em categorias (por exemplo, "clique" ou "não", "maligno" ou "benigno").
Tarefa de regressão: Uma tarefa de aprendizado supervisionado é uma tarefa de regressão quando a variável alvo é contínua (por exemplo, preço de um imóvel) ou uma variável categórica ordenada, como "nota de qualidade do vinho".
k-Nearest Neighbors: Um algoritmo para tarefas de classificação no qual um ponto de dados recebe o rótulo decidido pela maioria entre seus k vizinhos mais próximos.
Pré-processamento: Conjunto de operações que cientistas de dados usam para deixar os dados mais apropriados ao objetivo desejado. Por exemplo, antes de fazer análise de sentimento em dados do Twitter, você pode querer remover tags HTML, espaços em branco, expandir abreviações e segmentar os tweets nas listas de palavras que contêm.
Centralização e padronização: Ambas são formas de pré-processamento de dados numéricos, isto é, dados compostos por números (e não categorias ou strings). Centralizar uma variável é subtrair de cada ponto de dado a média da variável, de modo que a nova média seja 0; padronizar é multiplicar cada ponto de dado por uma constante para alterar a faixa (escala) dos dados. Veja o corpo do artigo para entender a importância disso, com exemplos.
Este artigo foi gerado a partir de um Jupyter notebook. Você pode baixar o notebook aqui.




