- Breve introducción a la regresión con Python
- Regresión logística y escalado de datos: el conjunto de vinos
- Glosario
En el primer artículo de esta serie exploré el papel del preprocesamiento en tareas de clasificación de machine learning (ML), con un análisis en profundidad del algoritmo k-Nearest Neighbours (k-NN) y el conjunto de datos de calidad del vino. Allí viste que centrar y escalar datos numéricos mejoró el rendimiento de k-NN en varias métricas del modelo (p. ej., exactitud). También vimos que el preprocesamiento no ocurre en el vacío y que su valor solo puede juzgarse en el contexto de una canalización de ML orientada a la predicción. Sin embargo, solo analizamos la importancia del preprocesamiento en el contexto de un único modelo, k-NN. En ese caso, el modelo funcionó notablemente mejor, pero ¿siempre será así? ¡No necesariamente! En este artículo, voy a explorar el papel de escalar y centrar datos numéricos en otro modelo básico: la regresión logística. Puede que quieras ponerte al día consultando el artículo anterior y/o el glosario de términos al final. Una vez más, trabajaremos con el conjunto de datos de calidad del vino. Todos los ejemplos estarán en Python. Si no estás familiarizado con Python, puedes ver todos nuestros cursos de ciencia de datos aquí. Utilizaré las librerías pandas para trabajar con dataframes y scikit-learn para las necesidades de machine learning.
Primero haré una breve introducción a la regresión, que puede usarse tanto para predecir el valor de una variable numérica como para clasificar. Presentaré la regresión lineal, la regresión logística y después usaré esta última para predecir la calidad del vino tinto. Luego verás si centrar y escalar ayudan a nuestro modelo en un escenario de regresión.
Breve introducción a la regresión con Python
Regresión lineal en Python
Como se comentaba más arriba, la regresión se usa habitualmente para predecir el valor de una variable numérica a partir de otra. Por ejemplo, abajo realizamos una regresión lineal con datos de viviendas de Boston (un conjunto integrado en scikit-learn): en este caso, la variable independiente (eje x) es el número de habitaciones y la dependiente (eje y) es el precio.
¿Cómo funciona esta regresión? En resumen, la mecánica es la siguiente: queremos ajustar un modelo \(y = ax + b\) a los datos \((x_i,y_i)\), es decir, hallar los \(a\) y \(b\) óptimos dados los datos. En la formulación de mínimos cuadrados ordinarios (OLS, con diferencia la más común) se asume que el error se produce en la variable dependiente. Por ello, los \(a\) y \(b\) óptimos se encuentran minimizando \[SSE = \sum_i (y_i - (ax_i + b))^2\] y esta optimización suele lograrse con un algoritmo conocido como descenso por gradiente. Aquí realizamos una regresión lineal simple con los datos de viviendas de Boston:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()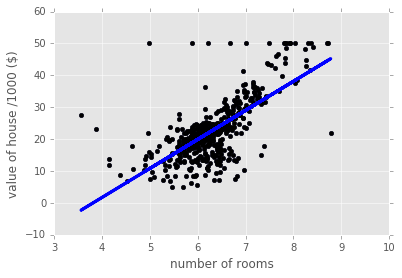
Esta regresión capta la tendencia creciente general de los datos, pero poco más. Hemos usado solo una variable predictora y podríamos haber usado muchas más; en ese caso tendríamos \(n\) coeficientes \(a_1,\ldots,a_n\) en el modelo, uno por cada variable predictora. Conviene destacar que la magnitud de \(a_i\) nos indica cuánto se correlaciona esa variable con la variable objetivo.
Regresión logística en Python
La regresión también puede usarse para problemas de clasificación. El primer ejemplo natural es la regresión logística. En clasificación binaria (dos etiquetas), podemos pensar en etiquetas 0 y 1. Denotando de nuevo la variable predictora como \(x\), el modelo de regresión logística viene dado por la función logística \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] Es una curva sigmoide (en S) y puedes ver un ejemplo abajo. Para cualquier \(x\), si \(F(x) <0.5\), el modelo predice y = 0 y, si \(F(X) > 0.5\), el modelo predice \(y = 1\). De nuevo, si tenemos más de una variable predictora, contamos con \(n\) coeficientes \(a_1,\ldots,a_n\), uno por cada variable. En este caso, la magnitud de \(a_i\) indica cuánto influye la variable correspondiente en la predicción.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()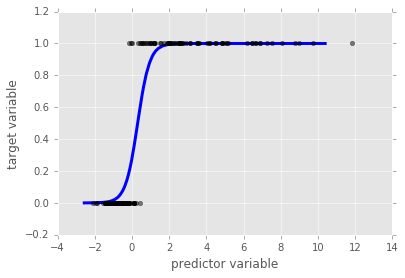
Regresión logística y escalado de datos: el conjunto de vinos
Ahora que hemos visto la mecánica de la regresión logística, vamos a implementar un clasificador de regresión logística en nuestro delicioso conjunto de datos de vino. Importaré los datos y representaré la variable objetivo (vino bueno/malo) para refrescar conceptos:
# Import necessary modules
from sklearn import linear_model
from sklearn_cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()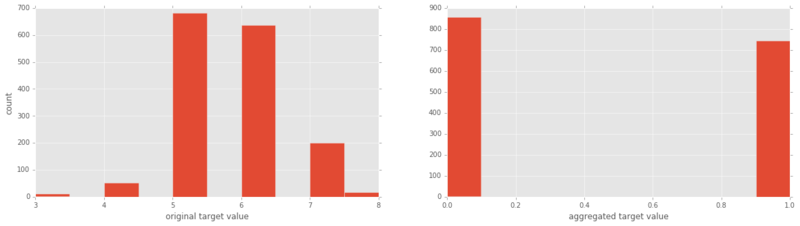
¡Vamos ahora a ejecutar nuestra regresión logística y ver cómo rinde!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Tal cual, esta regresión logística funciona mejor que K-NN (con o sin escalado). Ahora vamos a escalar los datos y a ejecutar de nuevo la regresión logística:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320¡Esto es muy interesante! El rendimiento de la regresión logística no mejoró al escalar los datos. ¿Por qué, especialmente cuando vimos que el rendimiento de k-Nearest Neigbours mejoraba notablemente con el escalado? La razón es que, si hay variables predictoras con rangos grandes que no afectan a la variable objetivo, un algoritmo de regresión hará pequeños los coeficientes correspondientes \(a_i\) para que influyan menos en las predicciones. K-Nearest Neighbours no tiene esa estrategia incorporada, por lo que en su caso sí necesitábamos escalar los datos.
En el próximo artículo, analizaré los resultados tan distintos de centrar y escalar en k-NN y en regresión logística sintetizando un conjunto de datos, añadiendo ruido y viendo cómo centrar y escalar alteran el rendimiento de ambos modelos en función de la intensidad del ruido.
En la ventana interactiva de abajo puedes trastear con los datos. Puedes escalar los datos estableciendo sc = True, si quieres. Después ejecuta todo el script para ver la exactitud del modelo de regresión logística, junto con un informe de clasificación.
Glosario
Aprendizaje supervisado: La tarea de inferir una variable objetivo a partir de variables predictoras. Por ejemplo, inferir la variable objetivo «presencia de enfermedad cardiaca» a partir de variables predictoras como «edad», «sexo» y «tabaquismo».
Tarea de clasificación: Una tarea de aprendizaje supervisado es una tarea de clasificación si la variable objetivo consta de categorías (p. ej., «clic» o «no clic», «maligno» o «benigno»).
Tarea de regresión: Una tarea de aprendizaje supervisado es una tarea de regresión si la variable objetivo es continua (p. ej., el precio de una vivienda) o una variable categórica ordenada como la «calificación de calidad del vino».
k-Nearest Neighbors: Un algoritmo para tareas de clasificación en el que a un punto de datos se le asigna la etiqueta decidida por la mayoría de sus k vecinos más cercanos.
Preprocesamiento: Conjunto de operaciones que las y los data scientists aplican para dejar los datos en una forma más adecuada para su propósito. Por ejemplo, antes de hacer análisis de sentimiento en datos de Twitter, quizá quieras eliminar etiquetas HTML, espacios en blanco, expandir abreviaturas y dividir los tuits en listas de palabras.
Centrado y escalado: Ambas son formas de preprocesar datos numéricos, es decir, datos compuestos por números (en lugar de categorías o cadenas). Centrar una variable consiste en restar su media a cada dato para que la media de la nueva variable sea 0; escalar una variable consiste en multiplicar cada dato por una constante para modificar el rango de los datos. Consulta el cuerpo del artículo para ver su importancia y ejemplos.
Este artículo se generó a partir de un cuaderno de Jupyter. Puedes descargarlo aquí.