- Breve introduzione alla regressione con Python
- Regressione logistica e scaling dei dati: il dataset del vino
- Glossario
Nel primo articolo di questa serie ho esplorato il ruolo del preprocessing nei task di classificazione di machine learning (ML), con un approfondimento sull'algoritmo k-Nearest Neighbours (k-NN) e sul dataset sulla qualità del vino. Lì hai visto che centrare e scalare i dati numerici ha migliorato le prestazioni di k-NN per diverse metriche del modello (ad es. accuratezza). Hai anche visto che il preprocessing non avviene nel vuoto e che il suo valore può essere valutato solo nel contesto di una pipeline ML orientata alla previsione. Tuttavia, abbiamo visto l'importanza del preprocessing solo nel contesto di un singolo modello, k-NN. In quel caso, il nostro modello ha funzionato significativamente meglio, ma sarà sempre così? Non necessariamente! In questo articolo esplorerò il ruolo dello scaling e del centraggio dei dati numerici in un altro modello di base, la regressione logistica. Potresti voler rinfrescare la memoria dando un'occhiata al precedente articolo e/o al glossario dei termini in fondo al pezzo. Anche questa volta esploreremo il dataset sulla qualità del vino. Tutti gli esempi qui presenti saranno in Python. Se non conosci Python, puoi consultare tutti i nostri corsi di data science qui. Utilizzerò le librerie pandas per le esigenze legate ai dataframe e scikit-learn per quelle di machine learning.
Per prima cosa fornirò una breve introduzione alla regressione, che può essere usata per prevedere sia il valore di una variabile numerica sia delle classi. Presenterò la regressione lineare, la regressione logistica e poi userò quest'ultima per prevedere la qualità del vino rosso. Vedrai quindi se centraggio e scaling aiutano il nostro modello in un contesto di regressione.
Breve introduzione alla regressione con Python
Regressione lineare in Python
Come accennato sopra, la regressione è comunemente usata per prevedere il valore di una variabile numerica a partire da un'altra. Per esempio, qui sotto eseguiamo una regressione lineare sui dati delle case di Boston (un dataset integrato in scikit-learn): in questo caso, la variabile indipendente (asse x) è il numero di stanze e la variabile dipendente (asse y) è il prezzo.
Come funziona una tale regressione? In breve, la meccanica è la seguente: vogliamo adattare ai dati \((x_i,y_i)\) un modello \(y = ax + b\), cioè vogliamo trovare i valori ottimali di \(a\) e \(b\) dati i dati. Nella formulazione dei minimi quadrati ordinari (OLS, di gran lunga la più comune), si assume che l'errore si manifesti nella variabile dipendente. Per questo motivo, gli \(a\) e \(b\) ottimali si trovano minimizzando \[SSE = \sum_i (y_i - (ax_i + b))^2\] e questa ottimizzazione è spesso ottenuta con un algoritmo noto come discesa del gradiente. Qui eseguiamo una semplice regressione lineare sui dati delle case di Boston:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()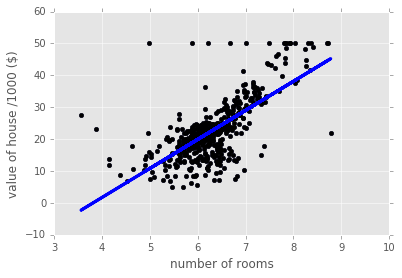
Questa regressione cattura l'andamento generale crescente dei dati ma non molto altro. Abbiamo usato una sola variabile predittiva, ma avremmo potuto usarne molte di più: in tal caso avremmo \(n\) coefficienti \(a_1,\ldots,a_n\) nel modello, uno per ciascuna variabile predittiva. Vale la pena notare che l'ampiezza del coefficiente \(a_i\) ci dice quanto fortemente la variabile corrispondente è correlata con la variabile target.
Regressione logistica in Python
La regressione può essere usata anche per problemi di classificazione. Il primo esempio naturale è la regressione logistica. Nella classificazione binaria (due etichette), possiamo pensare alle etichette come 0 e 1. Denotando di nuovo la variabile predittiva con \(x\), il modello di regressione logistica è dato dalla funzione logistica \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] È una curva sigmoidale (a S) e puoi vederne un esempio qui sotto. Per un dato \(x\), se \(F(x) <0.5\), allora il modello logistico predice y = 0 e, viceversa, se \(F(X) > 0.5\) il modello predice \(y = 1\). Anche in questo caso, se abbiamo più di una variabile predittiva, abbiamo anche \(n\) coefficienti \(a_1,\ldots,a_n\), uno per ciascuna variabile predittiva. In questo caso, l'ampiezza del coefficiente \(a_i\) ci dice quanto fortemente la variabile corrispondente influisce sulla variabile predetta.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()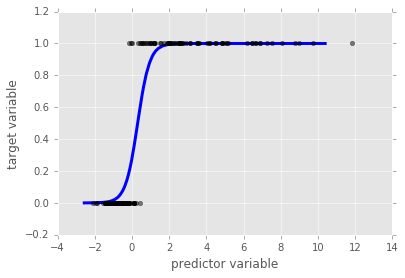
Regressione logistica e scaling dei dati: il dataset del vino
Ora che abbiamo visto la meccanica della regressione logistica, implementiamo un classificatore di regressione logistica sul nostro delizioso dataset del vino. Importerò i dati e tracerò la variabile target (vino buono/cattivo) come promemoria:
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()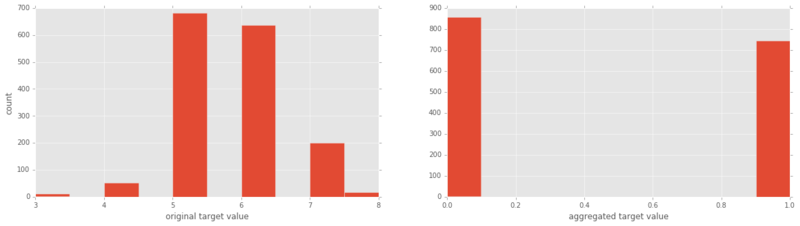
Ora eseguiamo la nostra regressione logistica e vediamo come si comporta!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Senza ulteriori interventi, questa regressione logistica va meglio di K-NN (con o senza scaling). Ora scaliamo i dati ed eseguiamo la regressione logistica:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320Molto interessante! Le prestazioni della regressione logistica non sono migliorate con lo scaling dei dati. Perché no, soprattutto quando abbiamo visto che le prestazioni di k-Nearest Neighbours miglioravano sensibilmente con lo scaling? Il motivo è che, se ci sono variabili predittive con ampi intervalli che non influiscono sulla variabile target, un algoritmo di regressione renderà piccoli i coefficienti corrispondenti \(a_i\) in modo che non influenzino troppo le previsioni. k-Nearest Neighbours non ha una strategia incorporata di questo tipo e quindi avevamo davvero bisogno di scalare i dati.
Nel prossimo articolo analizzerò i risultati assai diversi di centraggio e scaling in k-NN e regressione logistica sintetizzando un dataset, aggiungendo rumore e osservando come centraggio e scaling modifichino le prestazioni di entrambi i modelli in funzione dell'intensità del rumore.
Nella finestra interattiva qui sotto puoi sperimentare direttamente con i dati. Puoi scalare i dati impostando sc = True, se vuoi. Quindi esegui l'intero script per ottenere l'accuratezza del modello di regressione logistica, insieme a un report di classificazione.
Glossario
Apprendimento supervisionato: Il compito di inferire una variabile target a partire da variabili predittive. Per esempio, inferire la variabile target "presenza di cardiopatia" da variabili predittive come "età", "sesso" e "stato di fumatore".
Task di classificazione: Un task di apprendimento supervisionato è un task di classificazione se la variabile target è composta da categorie (ad es. "click" o "no", tumore "maligno" o "benigno").
Task di regressione: Un task di apprendimento supervisionato è un task di regressione se la variabile target è una variabile che varia continuamente (ad es. il prezzo di una casa) o una variabile categoriale ordinata come la "valutazione della qualità del vino".
k-Nearest Neighbors: Un algoritmo per task di classificazione, in cui a un punto dati viene assegnata l'etichetta decisa dalla maggioranza dei suoi k vicini più prossimi.
Preprocessing: Qualsiasi insieme di operazioni che i data scientist utilizzano per portare i dati in una forma più adatta a ciò che vogliono farne. Per esempio, prima di eseguire un'analisi del sentiment su dati di Twitter, potresti voler rimuovere eventuali tag html, spazi bianchi, espandere le abbreviazioni e suddividere i tweet in liste di parole contenute.
Centraggio e scaling: Sono entrambi forme di preprocessing di dati numerici, cioè dati costituiti da numeri, a differenza per esempio di categorie o stringhe; centrare una variabile significa sottrarre da ogni dato la media della variabile in modo che la media della nuova variabile sia 0; scalare una variabile significa moltiplicare ogni dato per una costante per modificare l'intervallo dei dati. Vedi il corpo dell'articolo per l'importanza di questi passaggi, con esempi.
Questo articolo è stato generato da un notebook Jupyter. Puoi scaricare il notebook qui.



