
Corso
Sviluppare applicazioni LLM con LangChain
3 ore
52K
Hai mai sognato di far girare il tuo ChatGPT direttamente sul portatile?
Con i rapidi progressi dei Large Language Model (LLM), la possibilità di portare questi potenti modelli sull’hardware consumer sta diventando realtà.
La chiave per sbloccare questo potenziale è la quantizzazione, una tecnica che permette di ridurre le dimensioni di questi modelli sempre più grandi per eseguirli su dispositivi di tutti i giorni con un degrado minimo delle prestazioni — se implementata correttamente!
In questa guida approfondiremo il concetto di quantizzazione, spiegando come funziona e le diverse possibilità per quantizzare gli LLM. Infine, quantizzeremo il nostro modello in due semplici passaggi usando la libreria Quanto di Hugging Face.
Immergiamoci a fondo! Puoi seguire passo passo usando DataCamp DataLab.
Con l’evoluzione degli LLM, la loro complessità è cresciuta esponenzialmente, portando a un aumento significativo del numero di parametri. Per esempio, il primo modello GPT, lanciato nel 2018, aveva 0,11 miliardi di parametri. Alla fine del 2019, GPT-2 è arrivato a 1,5 miliardi, e GPT-3, rilasciato a fine 2020, è schizzato a 175 miliardi di parametri.
Oggi, GPT-4 vanta oltre 1 trilione di parametri. Questo forte incremento pone una sfida: man mano che i modelli crescono, crescono anche i requisiti di memoria, spesso superando la capacità di acceleratori hardware avanzati come le GPU.
Questa crescente richiesta di memoria limita sia l’addestramento sia l’hosting dei modelli per l’inferenza, limitando di conseguenza l’accessibilità e l’adozione di soluzioni basate su LLM.
Questa crescita porta all’esigenza urgente di rendere questi modelli più accessibili riducendone le dimensioni. Modificando la precisione di alcune componenti del modello, la quantizzazione riduce l’ingombro di memoria mantenendo livelli di prestazioni simili.
La quantizzazione è una tecnica di compressione dei modelli che converte pesi e attivazioni all’interno di un large language model da valori ad alta precisione a valori a precisione inferiore. Significa passare da un tipo di dato che può contenere più informazioni a uno che ne contiene meno. Un esempio tipico è la conversione da un numero in virgola mobile a 32 bit a un intero a 8 bit.
Ridurre il numero di bit richiesti per ciascuno dei pesi o delle attivazioni del modello porta a una diminuzione significativa delle sue dimensioni complessive. Di conseguenza, la quantizzazione riduce gli LLM per consumare meno memoria, richiedere meno spazio di archiviazione ed essere più efficienti dal punto di vista energetico.
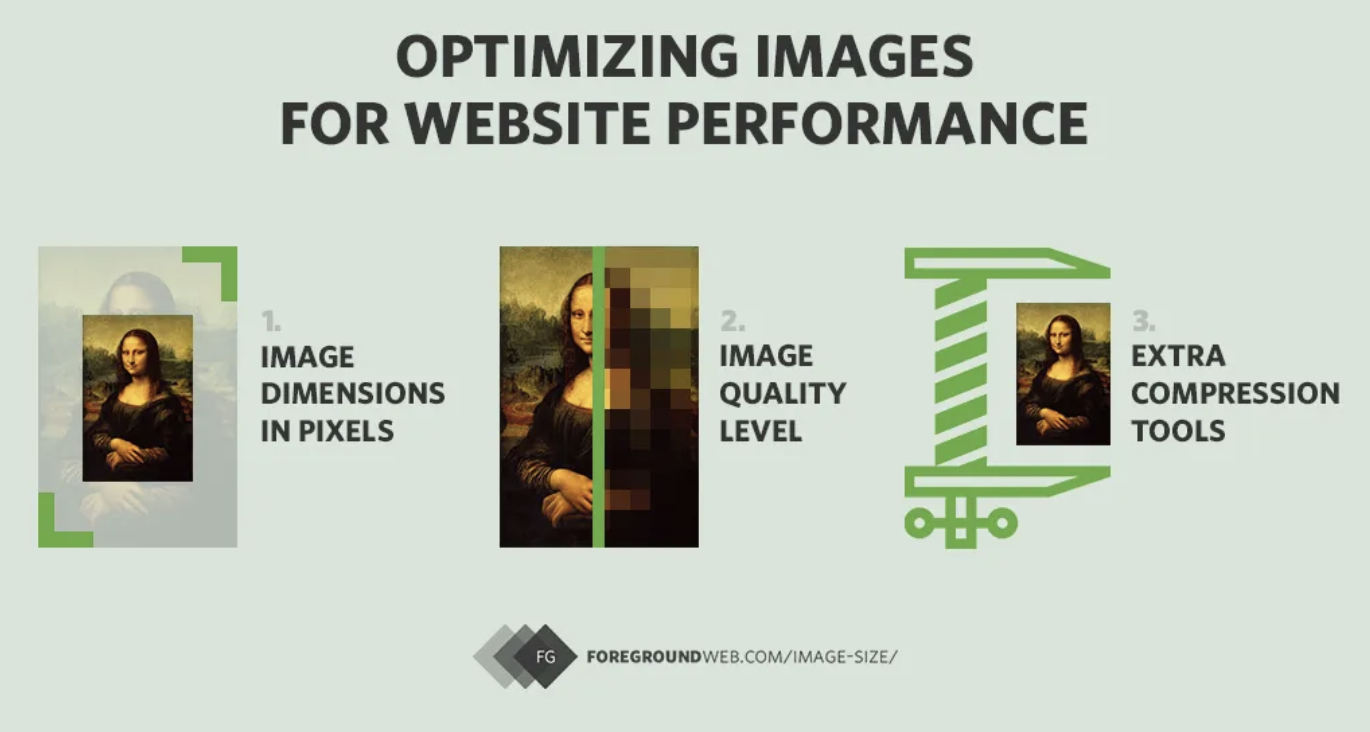
Un’analogia efficace per comprendere la quantizzazione è la compressione delle immagini. Le immagini ad alta risoluzione sono spesso compresse per l’uso su siti web. Ciò comporta la riduzione della dimensione dell’immagine rimuovendo parte dei dati o dei bit di informazione. Sebbene questo in genere riduca in qualche misura la qualità, diminuisce anche le dimensioni e il peso del file, facendo caricare più velocemente le pagine web pur garantendo un’esperienza visiva soddisfacente.
Schema della compressione delle immagini per un caricamento più rapido in applicazioni come le pagine web.
Allo stesso modo, quantizzare un LLM riduce i requisiti computazionali, permettendone l’esecuzione su hardware meno potente pur fornendo prestazioni adeguate. Le immagini compresse sono più facili da gestire, così come i modelli quantizzati sono più distribuibili su varie piattaforme, sebbene ci sia un piccolo compromesso in termini di dettaglio o precisione. Come vedremo, il processo di quantizzazione introduce anche un po’ di rumore.
La quantizzazione viene normalmente applicata ai pesi di un large language model, anche se può essere applicata anche alle attivazioni. I pesi del modello sono parametri in una rete neurale che determinano l’intensità delle connessioni tra neuroni nei diversi strati. I pesi sono essenzialmente i coefficienti appresi che trasformano i dati in ingresso mentre attraversano la rete.
I pesi sono inizialmente impostati su valori casuali e privi di significato e vengono aggiustati durante l’addestramento in base all’errore tra l’output previsto e i target reali. Questo processo di aggiustamento è guidato da algoritmi di ottimizzazione come la discesa del gradiente.
Se vuoi saperne di più sugli interni degli LLM, il corso Developing Large Language Models fa per te!
Una possibilità per quantizzare un modello è ridurre la precisione dei suoi pesi. Per illustrarlo, concentriamoci sulla matrice a sinistra nell’immagine sotto, che rappresenta una matrice di pesi 3x3 con precisione a quattro decimali:
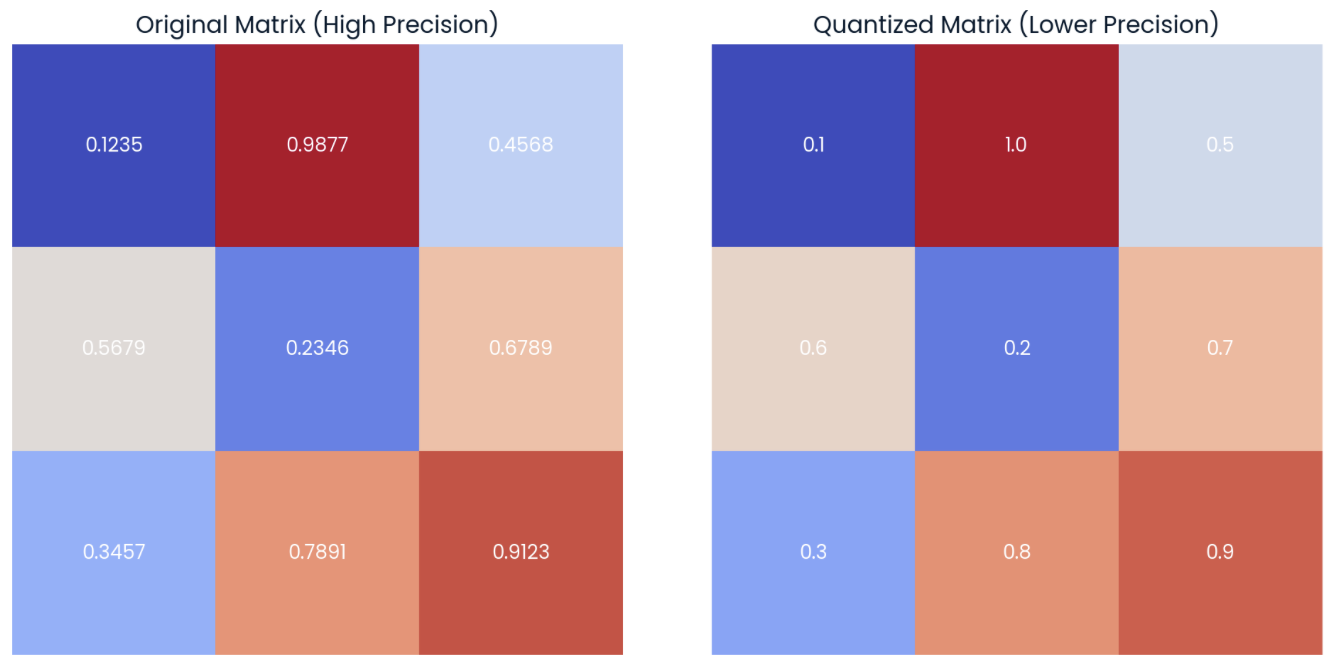
Esempio di una matrice casuale di pesi con precisione a quattro decimali (a sinistra) e la sua forma quantizzata (a destra) applicando l’arrotondamento a una cifra decimale.
Nella matrice a destra possiamo osservare la versione quantizzata della matrice originale. Questa matrice “quantizzata” è calcolata arrotondando gli elementi dell’originale a una cifra decimale.
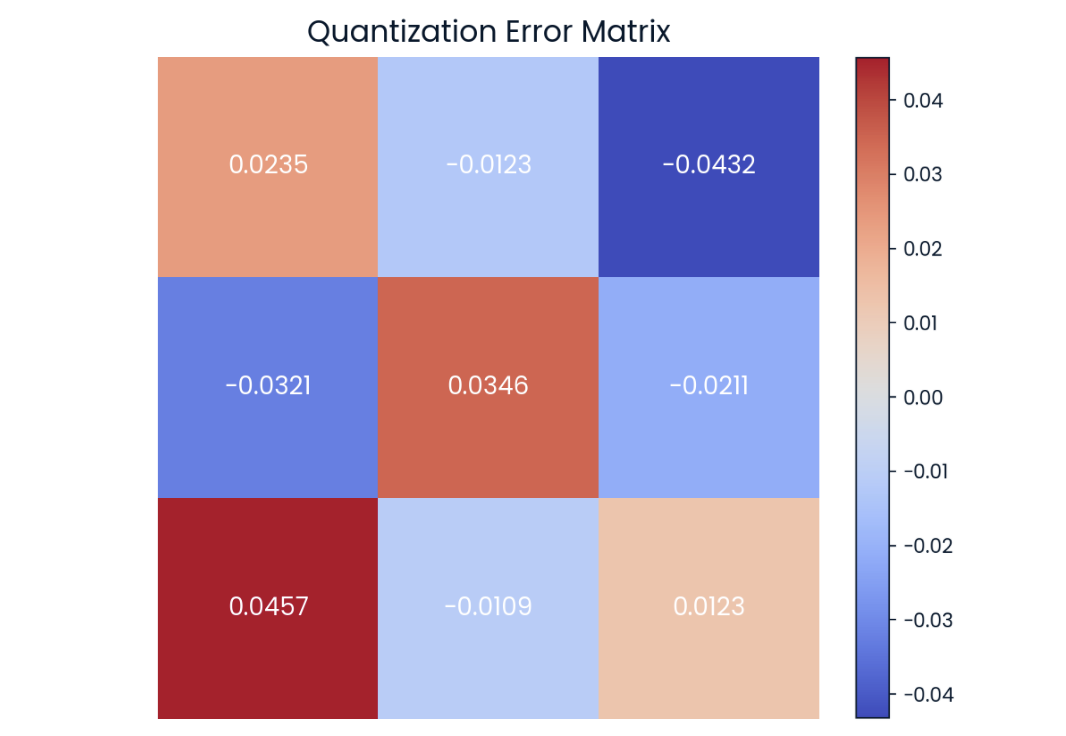
Possiamo osservare che le matrici sopra non sono completamente uguali ma molto simili. La differenza punto per punto è nota come errore di quantizzazione, che possiamo rappresentare anche in forma matriciale:
Errore di quantizzazione in forma di matrice. Più scuro è il colore, maggiore è l’errore.
La ricerca attuale sulla quantizzazione si concentra nel ridurre il più possibile questa differenza per evitare qualunque degrado prestazionale.
In questo semplice esempio ci limitiamo ad arrotondare gli elementi della matrice. In pratica, la quantizzazione viene eseguita convertendo i valori numerici in un diverso tipo di dato, ad esempio passando da un tipo a maggiore precisione a uno a precisione inferiore. Per esempio, il tipo di archiviazione predefinito per la maggior parte dei modelli è float32.
In questo caso, servirebbero 4 byte per parametro (4 volte precisione a 8 bit). Quindi, per una matrice 3x3 come nell’esempio, l’ingombro di memoria totale è di 36 byte.
Cambiando il tipo di dato — detto anche downcasting — in int8, servirebbe un solo byte per parametro. Quindi, l’ingombro totale della matrice diventerebbe di 9 byte.
Il tipo di dato selezionato per i pesi del modello determina quanto possiamo ridurre il modello. I tipi floating-point tradizionali, come float32 e float16, sono stati lo standard in molte applicazioni di machine learning, offrendo un equilibrio tra accuratezza ed efficienza computazionale. In particolare, mentre float32 offre alta precisione e un ampio intervallo dinamico, richiede più memoria e potenza di calcolo. Al contrario, float16 offre precisione e intervallo ridotti, accelerando notevolmente i calcoli.
float32 e l’efficienza di float16. Questo ha portato alla creazione del cosiddetto Brain Floating Point (bfloat16), che mantiene l’intervallo dinamico di float32 ma con precisione ridotta.
Downcasting è il termine formale per indicare la conversione da un tipo di dato a precisione superiore a uno a precisione inferiore. Usando il downcasting, riduciamo l’ingombro di memoria e aumentiamo la velocità, poiché i calcoli a precisione inferiore richiedono anche meno memoria.
In questa sezione, vedremo come funziona il downcasting da float32— il tipo di archiviazione predefinito per la maggior parte dei modelli — al bfloat16 di Google, e osserveremo come in genere comporti una certa perdita di dati.
Partiamo definendo un tensore casuale in PyTorch con elementi di tipo float32 e mostriamo i primi cinque elementi:
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
Ora possiamo effettuare il downcasting del tensore a bfloat16 usando il metodo .to(dtype) e osservare i primi 5 nuovi elementi:
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Come possiamo vedere, i valori sono piuttosto vicini, sebbene non identici. La differenza diventa più evidente quando iniziamo a eseguire operazioni sui valori. Per esempio, moltiplicando il tensore originale per sé stesso:
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Se eseguiamo lo stesso calcolo con il tensore quantizzato, vediamo che la differenza è maggiore:
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
Possiamo osservare una chiara differenza tra i risultati finali dovuta alla propagazione dell’errore.
Lo stesso effetto di propagazione dell’errore quando si opera con tensori quantizzati si verifica quando si effettua il downcasting degli LLM, portando a una perdita di informazione. Come abbiamo visto, usare meno memoria implica che il calcolo possa essere meno preciso. L’effetto della moltiplicazione è simile alla reale propagazione dell’errore strato dopo strato, che si accumula e alla fine influisce su alcune previsioni di token.
Con il downcasting, le prestazioni restano accettabili usando il tipo bfloat16, ma non vale per tipi di dato più piccoli.
Il downcasting non è comunemente usato come tecnica di quantizzazione efficace a causa di questa limitazione sui tipi di dato. Invece, si usano altri metodi che mantengono prestazioni più vicine al modello originale riconvertendo a float32 durante l’inferenza.
Esistono diversi tipi di quantizzazione, descritti in dettaglio di seguito:
La quantizzazione lineare è uno degli schemi più popolari per gli LLM. In termini semplici, comporta la mappatura uniforme dell’intervallo di valori in virgola mobile dei pesi originali su un intervallo di valori a punto fisso, usando durante l’inferenza il tipo di dato ad alta precisione.
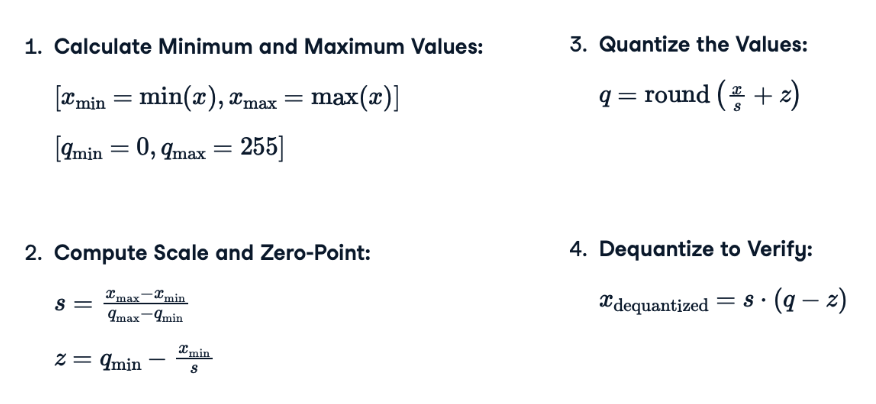
Per renderlo il più semplice possibile, rivediamo i passaggi necessari per applicare la quantizzazione lineare a un modello. Nota che le formule effettive sono mostrate nell’immagine qui sotto:
s) e zero-point (s): la scala adatta l’intervallo dei valori in virgola mobile per rientrare nell’intervallo intero. Lo zero-point assicura che lo zero nell’intervallo in virgola mobile sia rappresentato accuratamente da un intero, mantenendo l’accuratezza e la stabilità numerica, soprattutto per i valori prossimi allo zero.q): questo passaggio comporta la mappatura dei valori in virgola mobile su un intervallo intero a precisione inferiore usando un fattore di scala s e uno zero-point s calcolati nel passaggio precedente. L’operazione di arrotondamento assicura che il risultato finale sia un intero discreto, adatto all’archiviazione e al calcolo in formati a precisione inferiore.Associano ciascuno dei passaggi descritti sopra alla relativa formula:
Equazioni di quantizzazione usate per applicare la quantizzazione lineare a qualsiasi matrice di pesi.
Ti è difficile immaginare come applicare queste formule? Passiamo alla pratica!
Se applichiamo queste formule al tensore di pesi 3x3 a sinistra nell’immagine seguente, otterremo la matrice quantizzata mostrata a destra. Ti consiglio di prenderti qualche minuto per calcolare i valori massimi e minimi dell’intervallo quantizzato e alcuni dei valori quantizzati:
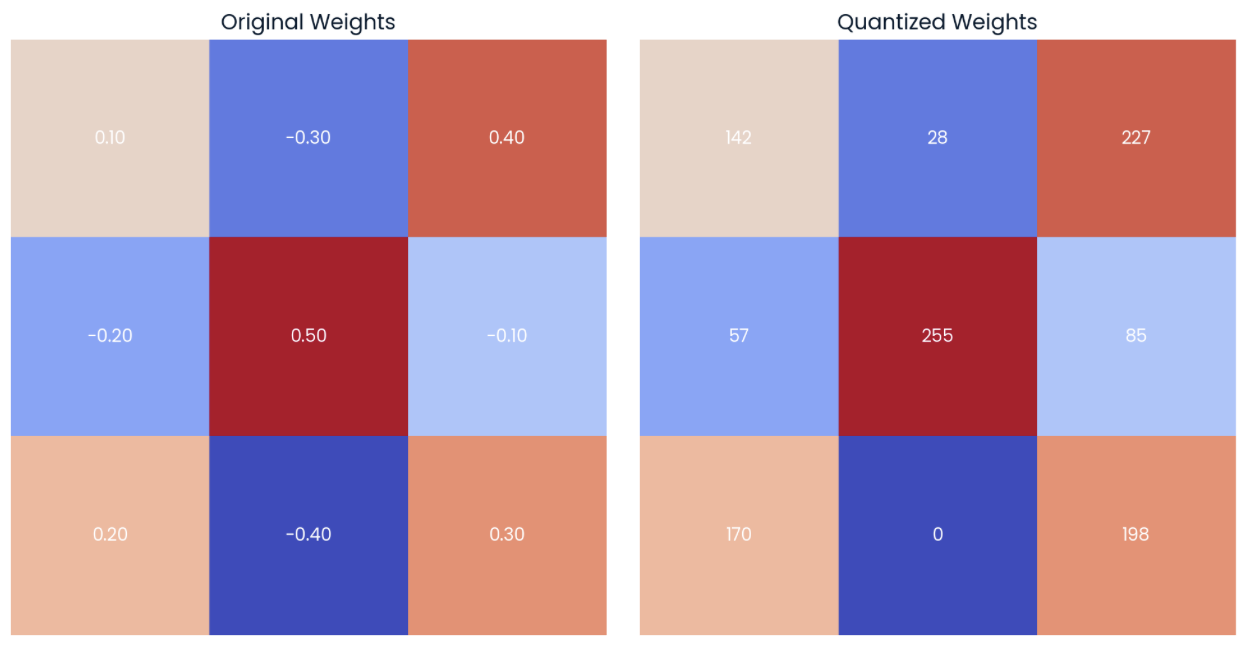
Esempio di una matrice casuale di pesi con precisione a due decimali (a sinistra) con la sua forma quantizzata (a destra) al tipo di dato int8.
Possiamo vedere che il limite inferiore del valore int8 corrisponde al valore minimo del tensore originale (-0.40 → 0), mentre il limite superiore corrisponde al valore massimo del tensore originale (0.50 → 255).
Se ora dequantizziamo i valori usando la formula (4), possiamo vedere che i valori dequantizzati sono vicini a quelli originali (matrice a sinistra). Possiamo calcolare l’errore di quantizzazione calcolando la differenza punto per punto (matrice a destra):
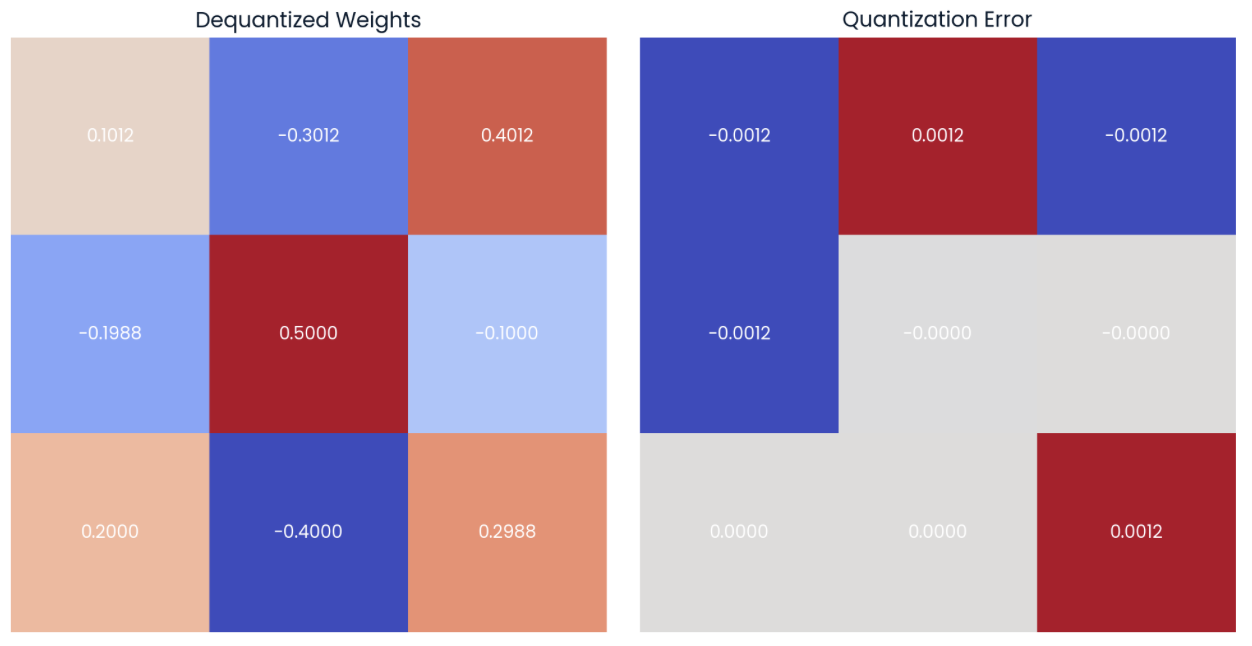
I valori possono essere dequantizzati usando i pesi quantizzati e i valori di scala e zero-point (a sinistra). Si può calcolare la differenza punto per punto o errore di quantizzazione (a destra).
La quantizzazione lineare riduce le dimensioni del modello memorizzando solo i pesi quantizzati e i valori di scala e zero-point in memoria, usandoli poi per calcolare i pesi originali durante l’inferenza e mantenere le prestazioni.
La quantizzazione lineare è un’opzione popolare per la sua semplicità, ma esistono più modi per costruire una mappatura. Un altro metodo oggi piuttosto diffuso è la quantizzazione a blocchi, più accurata della quantizzazione lineare per modelli con distribuzioni di pesi non uniformi.
La quantizzazione a blocchi è un metodo più sofisticato che prevede di quantizzare i pesi in blocchi più piccoli anziché su tutto l’intervallo. Questo metodo si basa su due concetti chiave:
Negli esempi con le matrici ci siamo concentrati soprattutto sul processo di quantizzazione dei pesi di un modello. Sebbene la quantizzazione dei pesi sia un passaggio cruciale per l’ottimizzazione, è importante considerare che anche le attivazioni di un modello possono essere quantizzate.
Quantizzazione delle attivazioni si riferisce al processo di riduzione della precisione degli output intermedi di ciascun livello della rete. A differenza dei pesi, che sono statici (costanti) una volta che il modello è addestrato, le attivazioni sono dinamiche. Ciò significa che le attivazioni cambiano con ogni input alla rete, rendendo più difficile prevederne l’intervallo.
In generale, la quantizzazione delle attivazioni è più difficile da implementare rispetto a quella dei pesi. Richiede un’attenta calibrazione per assicurare che l’intervallo dinamico delle attivazioni sia ben catturato.
La quantizzazione dei pesi e quella delle attivazioni sono tecniche complementari. Applicando entrambe, possiamo ottenere riduzioni significative nella dimensione del modello senza compromettere troppo le prestazioni.
La quantizzazione può essere eseguita anche in momenti diversi. Se prendiamo un modello pre-addestrato e quantizziamo i parametri del modello durante la fase di inferenza, stiamo eseguendo la Post-Training Quantization (PTQ).
Questo metodo non comporta alcuna modifica al processo di addestramento. L’intervallo dinamico dei parametri viene ricalcolato a runtime, in modo simile a come abbiamo lavorato con le matrici di esempio.
Dall’altro lato, esiste anche l’opzione di applicare la Quantization-Aware Training (QAT). Questo approccio prevede la modifica del processo di addestramento per simulare gli effetti della quantizzazione durante l’addestramento. Il modello impara a essere robusto al rumore di quantizzazione, ottenendo una migliore accuratezza.
Durante la QAT, gli stati intermedi dell’addestramento mantengono sia una versione quantizzata dei pesi sia i pesi originali non quantizzati (anch’essi in memoria!). Usiamo quindi la versione quantizzata del modello per l’inferenza, ma la versione non quantizzata dei pesi del modello verrà aggiornata durante la backpropagation.
Come previsto, sebbene più complessa e dispendiosa in termini di tempo, la QAT porta in genere a un’accuratezza superiore rispetto alla PTQ.
Alcuni metodi di quantizzazione richiedono una fase di calibrazione. Per esempio, dobbiamo determinare l’intervallo di attivazione originale di un modello prima della quantizzazione. La calibrazione generale di solito comporta l’esecuzione dell’inferenza su un dataset rappresentativo per ottimizzare i parametri di quantizzazione e minimizzare l’errore di quantizzazione.
Durante questo processo di calibrazione, l’algoritmo di quantizzazione raccoglie statistiche sulla distribuzione e l’intervallo delle attivazioni e dei pesi del modello. Queste statistiche aiutano a determinare i migliori parametri di quantizzazione. Calcolare la scala e lo zero-point quando si quantizzano i pesi è anche una sorta di calibrazione, ma esistono altri tipi:
Tuttavia, metodi di quantizzazione come QLoRA possono essere usati senza alcun passaggio di calibrazione.
Questi metodi in genere sostituiscono tutti i livelli lineari nel modello con livelli lineari quantizzati (QLinear). I livelli QLinear sono progettati per gestire la quantizzazione internamente, eliminando così la necessità di un ulteriore passaggio di calibrazione. Questo rende il processo di quantizzazione più semplice da implementare mantenendo comunque le prestazioni del modello.
Esistono diversi strumenti e librerie in Python che supportano la quantizzazione, fornendo strumenti sia per PTQ che per QAT. Per esempio, pytorch e tensorflow offrono metodi di quantizzazione, anche se integrare la quantizzazione senza soluzione di continuità nei modelli esistenti richiede una profonda comprensione delle librerie e degli interni dei modelli. Vedi le opzioni di quantizzazione nella documentazione ufficiale di PyTorch.
Se ti interessa imparare questi potenti framework, ti consiglio il corso Deep Learning in Python.
La mia opzione preferita per implementare la quantizzazione in pochi passaggi, finora, è la libreria Quanto di Hugging Face, progettata per semplificare il processo di quantizzazione per i modelli PyTorch.
Un tipico workflow di quantizzazione usando la libreria Quanto di Hugging Face consiste nei seguenti passaggi:
1. Selezionare e caricare un modello pre-addestrato e il relativo tokenizer. In questo caso, useremo il modello Pythia 410M di EuletherAI:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Il metodo model.gpt_neox può aiutare a visualizzare i diversi layer del modello caricato:
print(model.gpt_neox)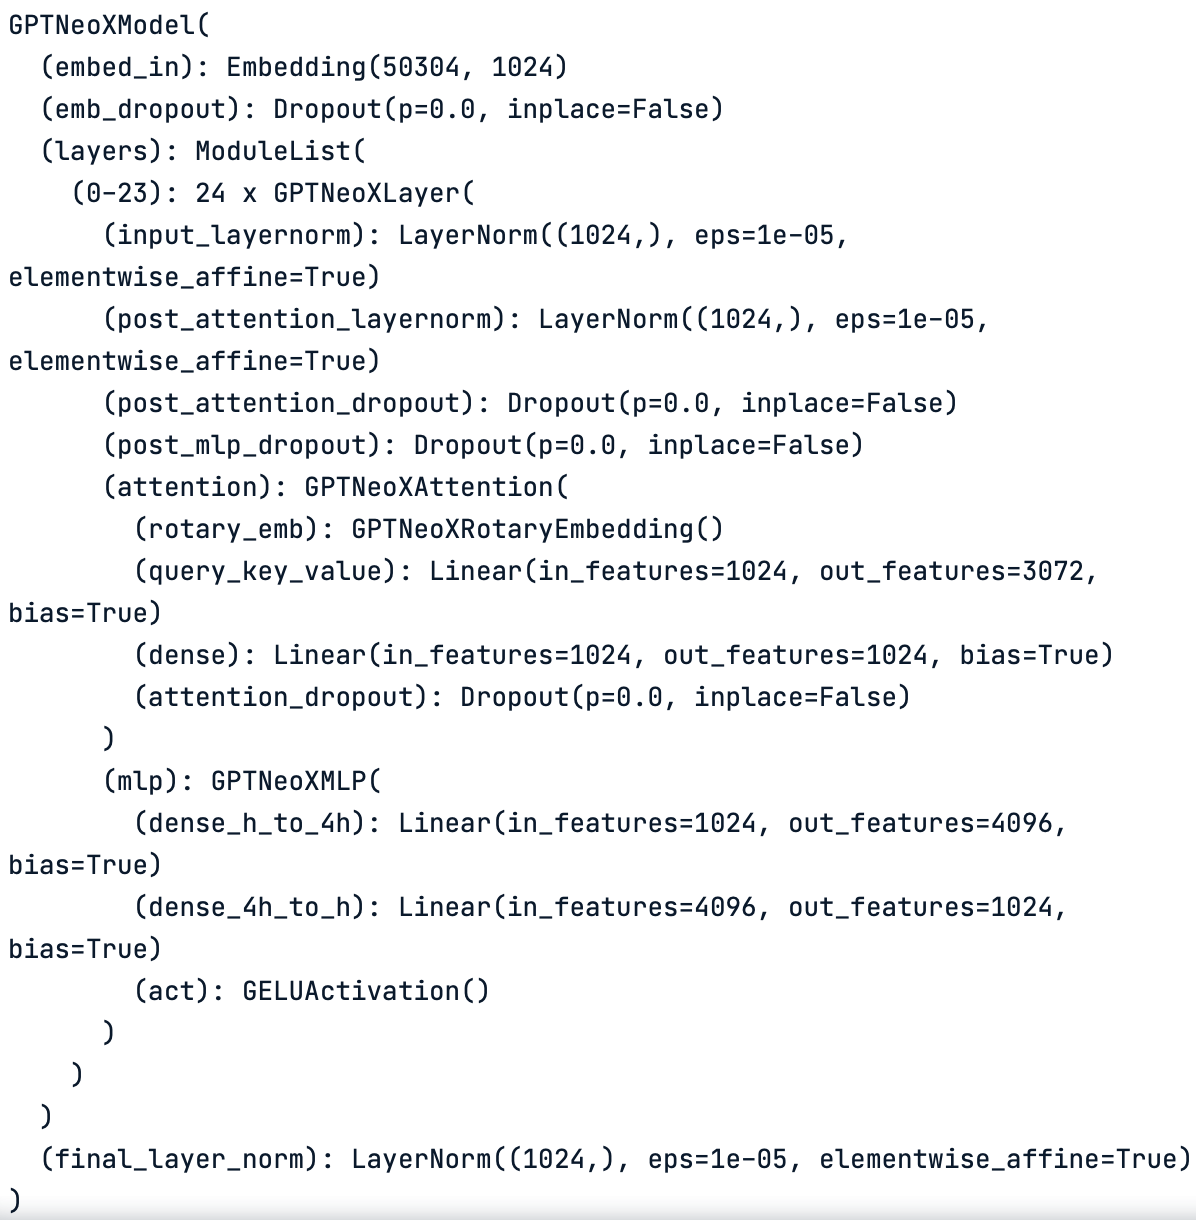
Schema layer per layer del modello originale. Il modello è composto da diversi tipi di layer come layer lineari e di normalizzazione.
Possiamo verificare che il modello funzioni correttamente eseguendo alcune inferenze di test. Per esempio,
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))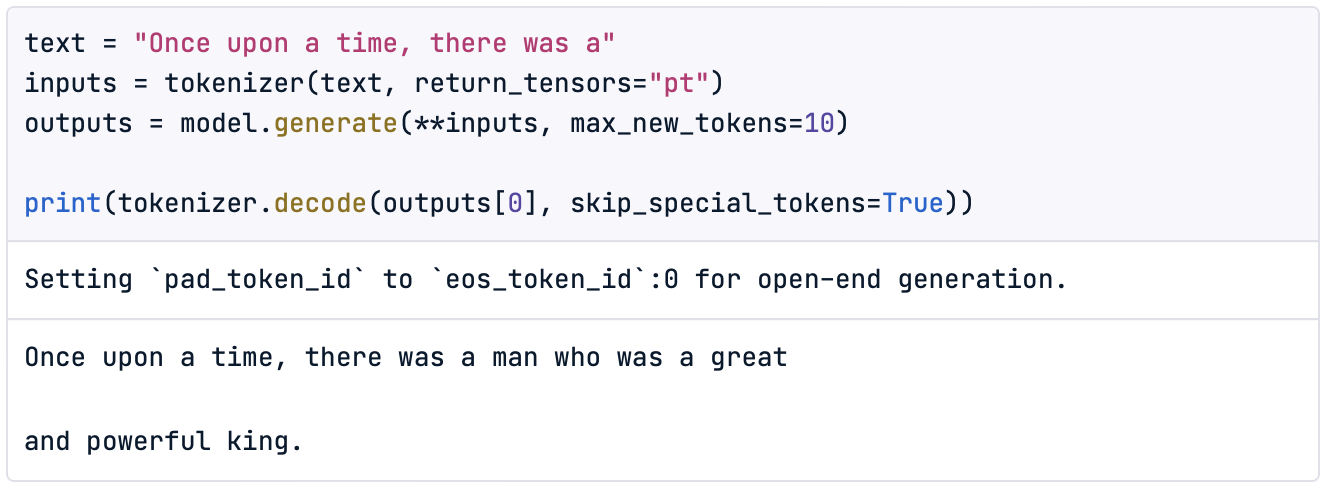
Inoltre, poiché la quantizzazione del modello ci permetterà di ridurne le dimensioni, è anche interessante verificare la dimensione del modello originale prima di iniziare il processo:
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")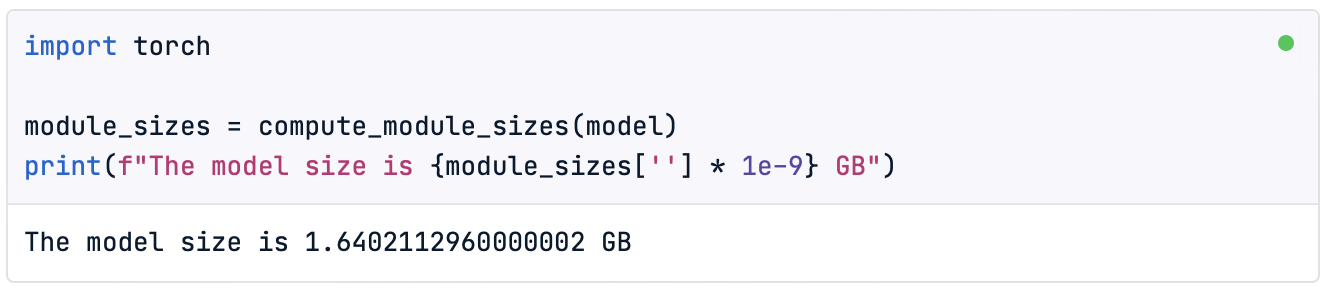
Nota: su DataCamp DataLab trovi il metodo compute_module_sizes() già implementato.
Infine, possiamo anche visualizzare i tensori densi del modello originale come segue:
print(model.gpt_neox.layers[0].attention.dense.weight)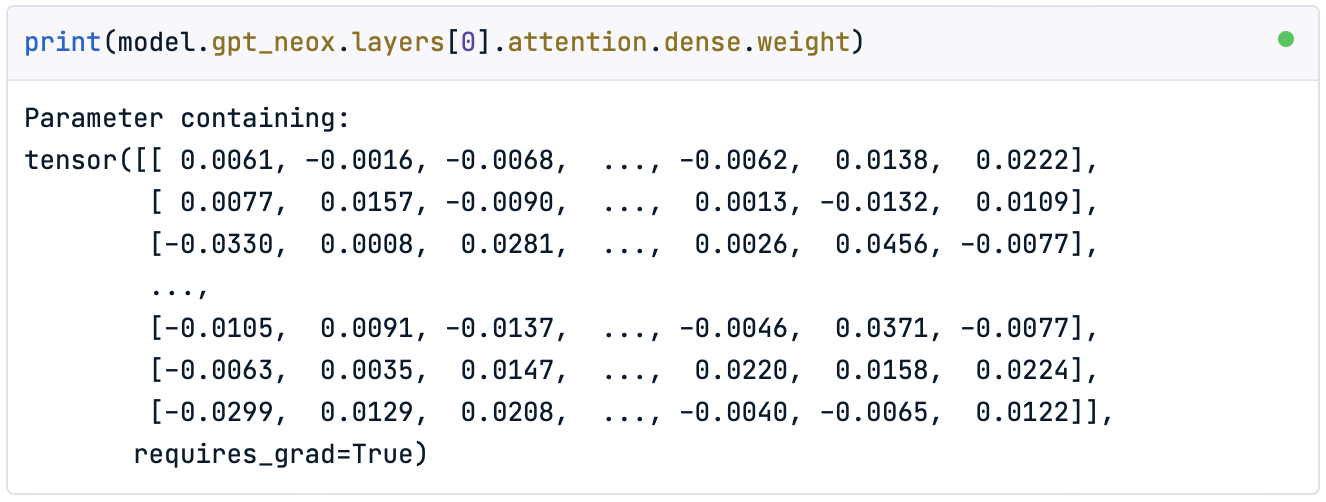
Come possiamo osservare, assomiglia alla matrice non quantizzata con cui abbiamo lavorato durante questo articolo.
2. Quantizzare. Il metodo quantize() consente di convertire subito il modello float standard di default in un modello quantizzato.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
In questo caso, stiamo quantizzando solo i pesi del modello al tipo di dato int8. Questo metodo converte il modello per usare aritmetica a precisione inferiore, includendo il passaggio di calibrazione.
Se ora stampiamo i layer del modello, vedremo che i layer lineari originali (Linear) sono stati sostituiti con layer lineari quantizzati (QLinear):
print(model)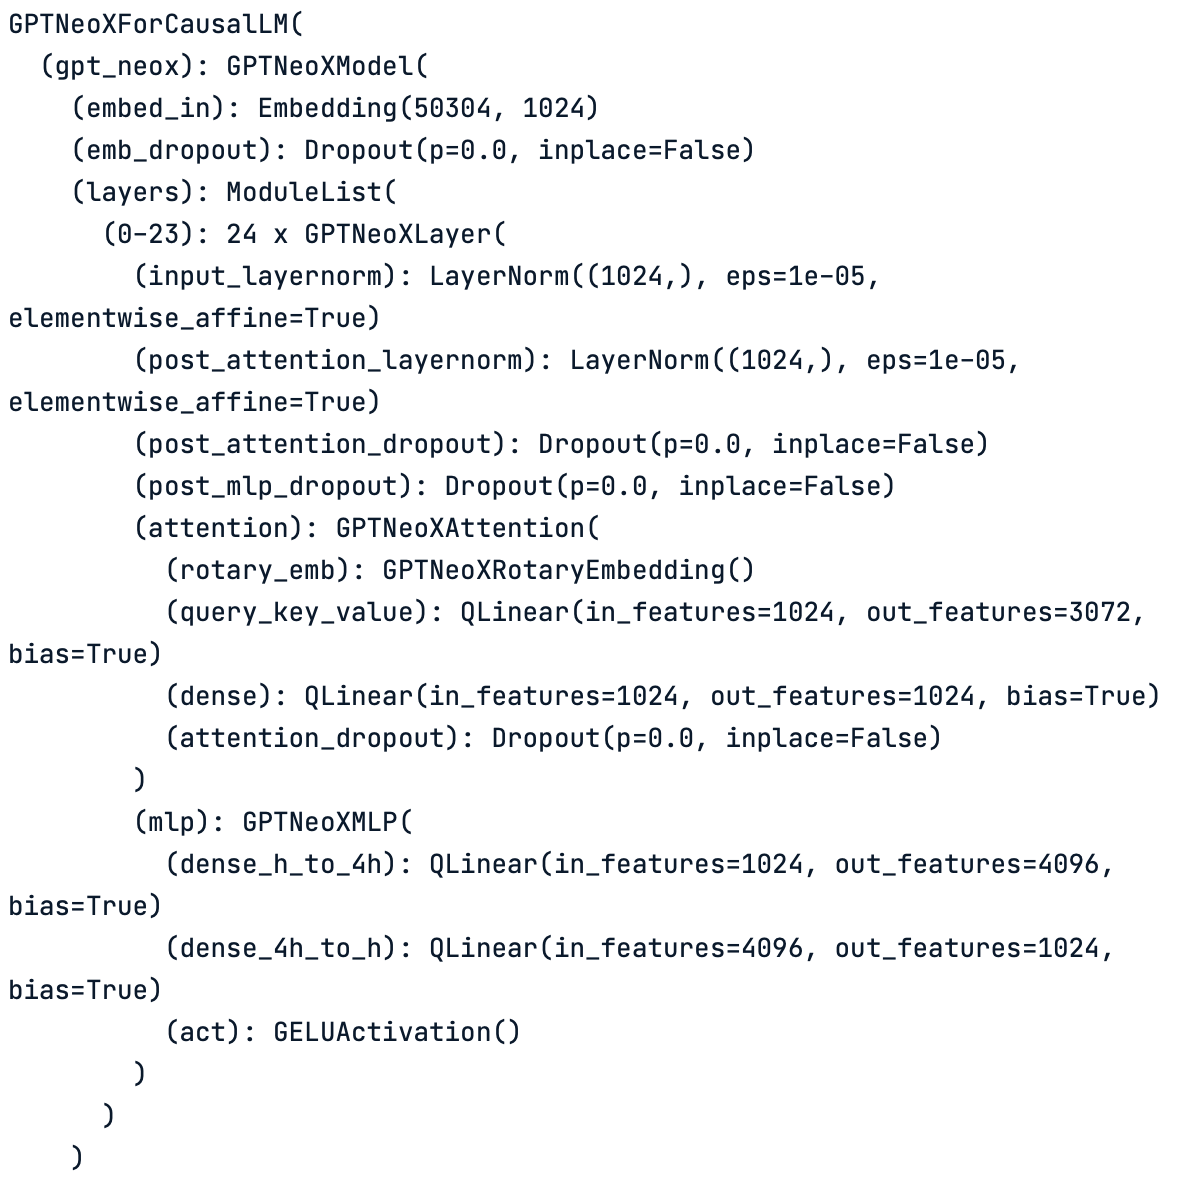
Schema layer per layer del modello quantizzato. Nota come tutti i layer lineari originali siano diventati layer lineari quantizzati (QLinear).
Tuttavia, se stampiamo la matrice dei pesi, vedremo che non sono stati trasformati:
print(model.gpt_neox.layers[0].attention.dense.weight)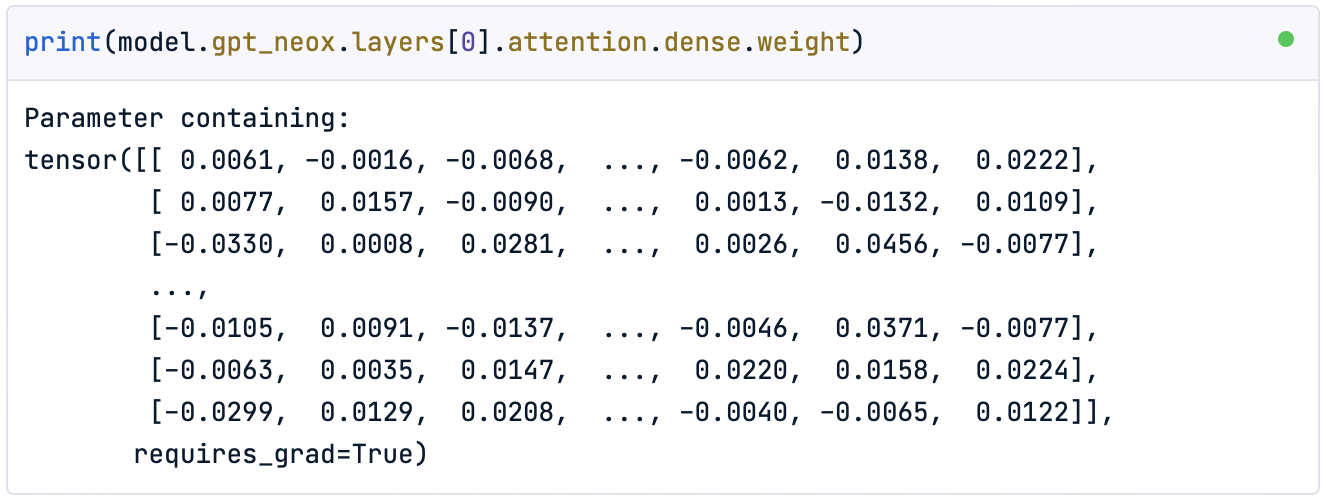
3. Freeze. Per applicare l’effetto della quantizzazione ai pesi, dobbiamo usare il metodo freeze().
freeze(model)Questo metodo incorpora i parametri di quantizzazione nel modello, convertendo di fatto i pesi nel tipo di dato di destinazione. Osserviamo ora i parametri del modello quantizzato:
print(model.gpt_neox.layers[0].attention.dense.weight)
Come possiamo vedere, i pesi sono ora entro l’intervallo del tipo di dato int8 di Pytorch.
4. Verifiche finali. Una volta quantizzato il modello, possiamo verificare la nuova dimensione ridotta:
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")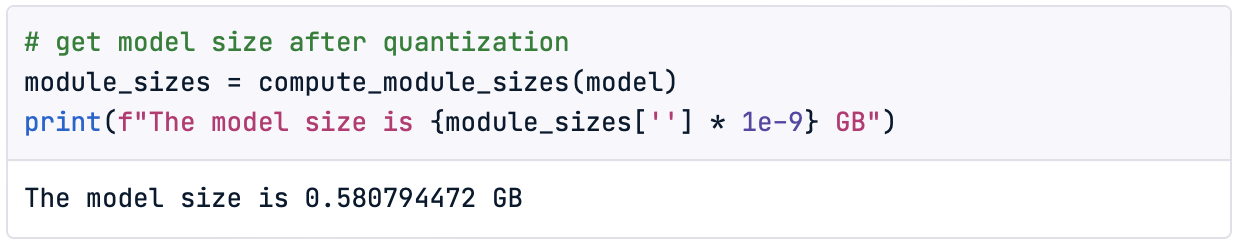
Abbiamo ottenuto un modello che è solo il 35% della dimensione originale!
Infine, verifichiamo le nuove prestazioni del modello con una semplice inferenza:
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))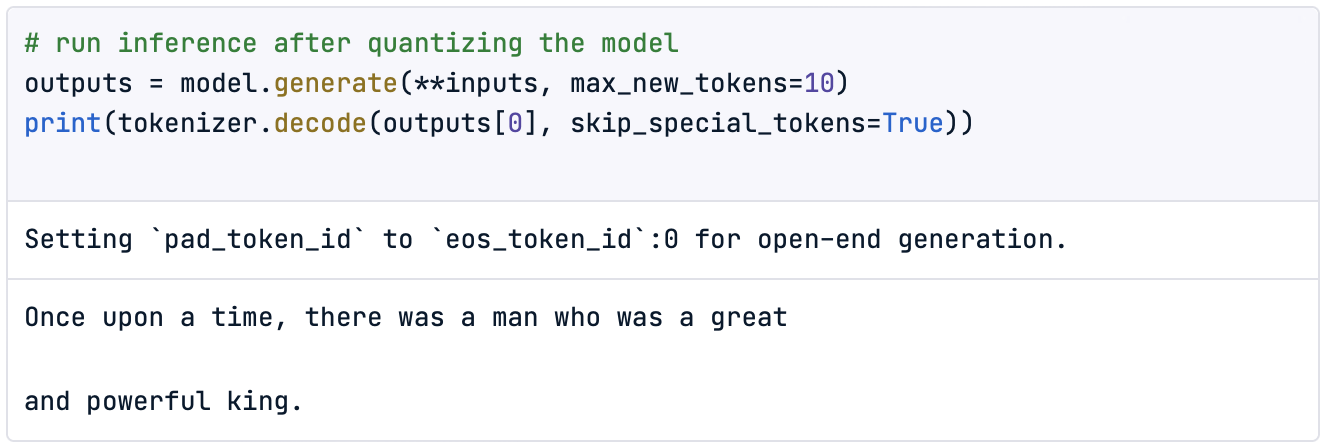
Ovviamente, verificare le prestazioni con una singola inferenza non è significativo, quindi sarebbe buona prassi definire un metodo quantitativo per valutarle.
Ora tocca a te provare!
Le crescenti richieste di memoria degli LLM limitano sia il loro addestramento sia l’hosting per l’inferenza, limitando di conseguenza l’accessibilità e l’adozione di applicazioni basate su LLM.
In questo articolo, abbiamo introdotto il concetto di quantizzazione, che consiste nel ridurre la precisione dei pesi e delle attivazioni del modello per diminuirne l’ingombro di memoria e i requisiti computazionali. Questo processo aiuta a rendere i modelli più efficienti e accessibili, in particolare per il deployment su dispositivi con risorse limitate.
Abbiamo affrontato questa tecnica con alcuni esempi, arrotondando i valori numerici dei pesi. Poi siamo passati a un semplice tipo di quantizzazione noto come downcasting. Con il downcasting di un modello, i parametri vengono convertiti in un tipo di dato più compatto, come bfloat16, per l’inferenza. Sebbene ciò consenta al modello di eseguire calcoli e attivazioni in questo tipo di dato più piccolo, le prestazioni in genere degradano al diminuire della dimensione del tipo di dato, risultando inefficace con tipi interi come int8.
Per risolvere questo problema, abbiamo introdotto la quantizzazione lineare, che mantiene prestazioni più vicine al modello originale riconvertendo a float32 durante l’inferenza. Questo abilita l’uso di tipi di dato ancora più piccoli, come int8.
Abbiamo percorso i passaggi numerici per applicare la quantizzazione lineare e abbiamo implementato la nostra quantizzazione dei pesi usando la libreria Quanto di Hugging Face. In particolare, con la libreria Quanto possiamo quantizzare qualsiasi modello PyTorch, inclusi quelli disponibili su Hugging Face.
Per chi è interessato a provare modelli più pesanti come LLaMa 2 o Mistral, valuta l’upgrade del tuo spazio DataCamp a premium per avere più potenza di calcolo.

Per i modelli più grandi, potremmo richiedere risorse extra accessibili con il DataCamp Premium Plan.
Padroneggiando le tecniche di quantizzazione, possiamo sbloccare tutto il potenziale dei Large Language Model richiedendo meno risorse, rendendo l’IA avanzata più efficiente, accessibile e versatile.
Spero che questo articolo ti aiuti a mettere le mani in pasta con la quantizzazione per gli LLM!
I migliori corsi sugli LLM
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



