Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
50.6K
Hast du schon mal davon geträumt, dein eigenes ChatGPT direkt auf deinem Laptop laufen zu lassen?
Mit den rasanten Fortschritten bei Large Language Models (LLMs) rückt die Idee, diese leistungsstarken Modelle auf Consumer-Hardware zu bringen, in greifbare Nähe.
Der Schlüssel dazu ist die Quantisierung, eine Technik, mit der sich immer größere Modelle so verkleinern lassen, dass sie auf Alltagsgeräten mit minimalen Leistungseinbußen ausgeführt werden können — vorausgesetzt, sie wird richtig umgesetzt!
In diesem Leitfaden tauchen wir in das Konzept der Quantisierung ein, erklären, wie sie funktioniert, und welche Möglichkeiten es für die Quantisierung von LLMs gibt. Abschließend quantisieren wir ein Modell in zwei einfachen Schritten mit der Quanto-Bibliothek von Hugging Face.
Legen wir los! Du kannst Schritt für Schritt im DataCamp DataLab mitmachen.
Mit der Weiterentwicklung von LLMs ist ihre Komplexität exponentiell gestiegen — und mit ihr die Anzahl der Parameter. Das erste GPT-Modell aus dem Jahr 2018 hatte zum Beispiel 0,11 Milliarden Parameter. Ende 2019 wuchs GPT-2 auf 1,5 Milliarden, und GPT-3, veröffentlicht Ende 2020, schoss auf 175 Milliarden Parameter nach oben.
Heute verfügt GPT-4 über mehr als 1 Billion Parameter. Dieser starke Anstieg bringt eine Herausforderung mit sich: Mit der Größe der Modelle steigen auch die Speicheranforderungen — oft über die Kapazität moderner Hardware-Beschleuniger wie GPUs hinaus.
Der wachsende Speicherbedarf limitiert sowohl das Training als auch das Hosten der Modelle für Inferenz — und damit die Verfügbarkeit und Verbreitung von LLM-basierten Lösungen.
Daraus ergibt sich die dringende Notwendigkeit, diese Modelle durch Verkleinerung zugänglicher zu machen. Durch das Ändern der Präzision einzelner Komponenten reduziert die Quantisierung den Speicherbedarf eines Modells, bei weitgehend ähnlicher Performance.
Quantisierung ist eine Modellkompressionstechnik, die Gewichte und Aktivierungen in einem großen Sprachmodell von hochpräzisen auf niedrigere Präzisionswerte umwandelt. Das bedeutet, Daten von einem Typ mit hoher Informationsdichte in einen Typ mit geringerer Informationsdichte zu überführen. Ein typisches Beispiel ist die Umwandlung von 32-Bit-Gleitkommazahlen in 8-Bit-Ganzzahlen.
Weniger Bits pro Gewicht oder Aktivierung führen zu einer deutlichen Verkleinerung des Modells. Dadurch benötigen quantisierte LLMs weniger Arbeitsspeicher, weniger Speicherplatz und sind energieeffizienter.
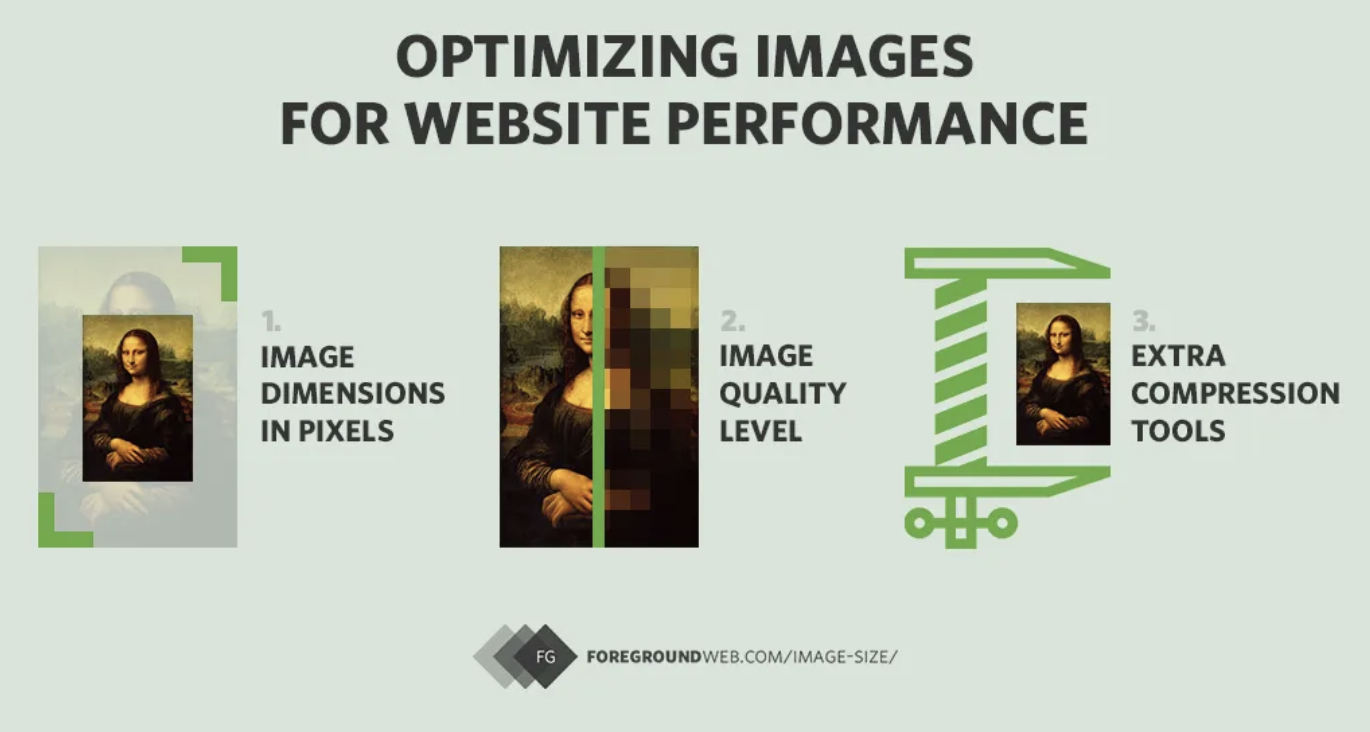
Ein anschaulicher Vergleich ist die Bildkompression. Hochaufgelöste Bilder werden für Websites komprimiert, indem Teile der Daten entfernt werden. Das senkt die Bildqualität etwas, reduziert aber Abmessungen und Dateigröße — Seiten laden schneller, bei weiterhin guter Darstellung.
Schema der Bildkompression für schnelleres Laden in Anwendungen wie Webseiten.
Ähnlich reduziert die Quantisierung eines LLM die Rechenanforderungen. Das Modell läuft auf schwächerer Hardware weiterhin mit ausreichender Leistung. Komprimierte Bilder sind leichter handhabbar — so wie quantisierte Modelle sich breiter ausrollen lassen, auch wenn es leichte Abstriche bei Detail oder Präzision gibt. Wie wir gleich sehen, führt Quantisierung auch zu etwas Rauschen.
In der Regel werden die Gewichte eines großen Sprachmodells quantisiert, teils auch die Aktivierungen. Modellgewichte sind Parameter in einem neuronalen Netz und bestimmen die Stärke der Verbindungen zwischen Neuronen über die Schichten hinweg. Gewichte sind im Kern die gelernten Koeffizienten, die Eingaben beim Durchlaufen des Netzes transformieren.
Anfangs sind Gewichte zufällig und bedeutungslos. Beim Training werden sie anhand des Fehlers zwischen Vorhersage und Zielwert angepasst — gesteuert durch Optimierungsverfahren wie Gradientenabstieg.
Wenn du tiefer in die Interna von LLMs einsteigen willst, ist der Track Developing Large Language Models genau richtig für dich!
Eine Möglichkeit der Quantisierung ist die Reduktion der Präzision der Modellgewichte. Zur Veranschaulichung betrachten wir links in der Abbildung unten eine 3x3-Gewichtsmatrix mit vier Dezimalstellen:
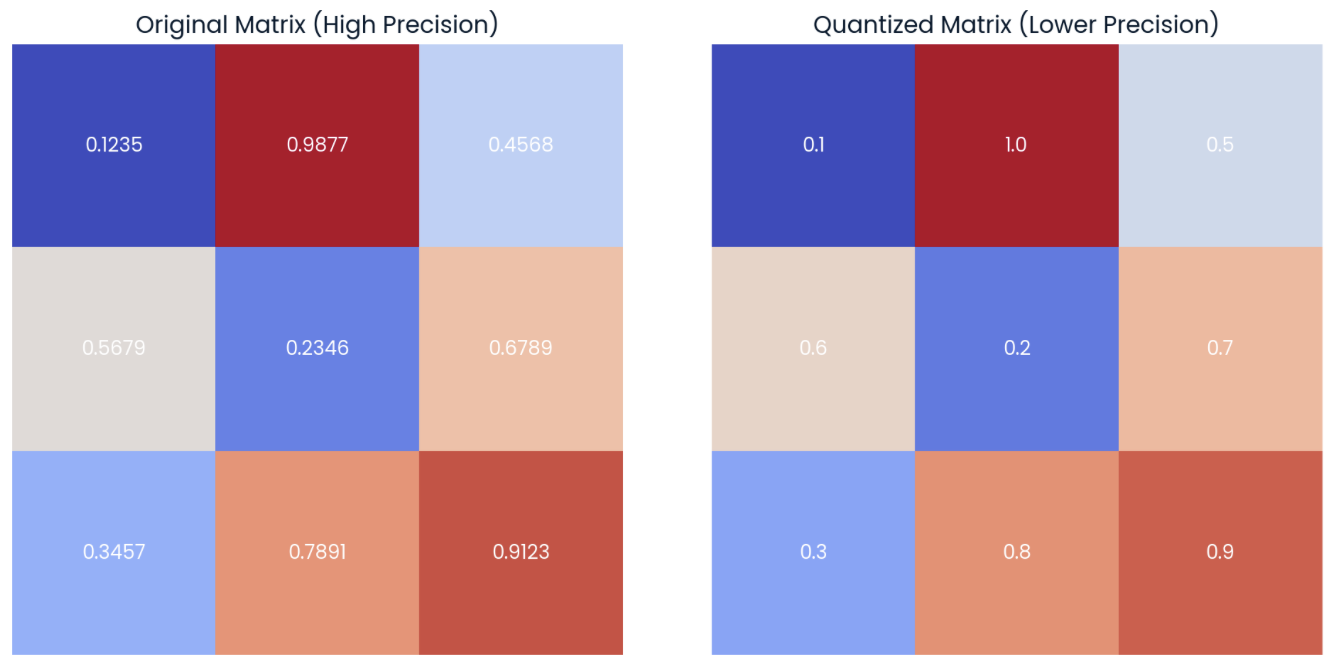
Beispiel einer zufälligen Gewichtsmatrix mit vier Dezimalstellen (links) und der quantisierten Form (rechts) durch Rundung auf eine Dezimalstelle.
Rechts sehen wir die quantisierte Version der Originalmatrix. Diese „quantisierte“ Matrix entsteht, indem die Elemente der Originalmatrix auf eine Nachkommastelle gerundet werden.
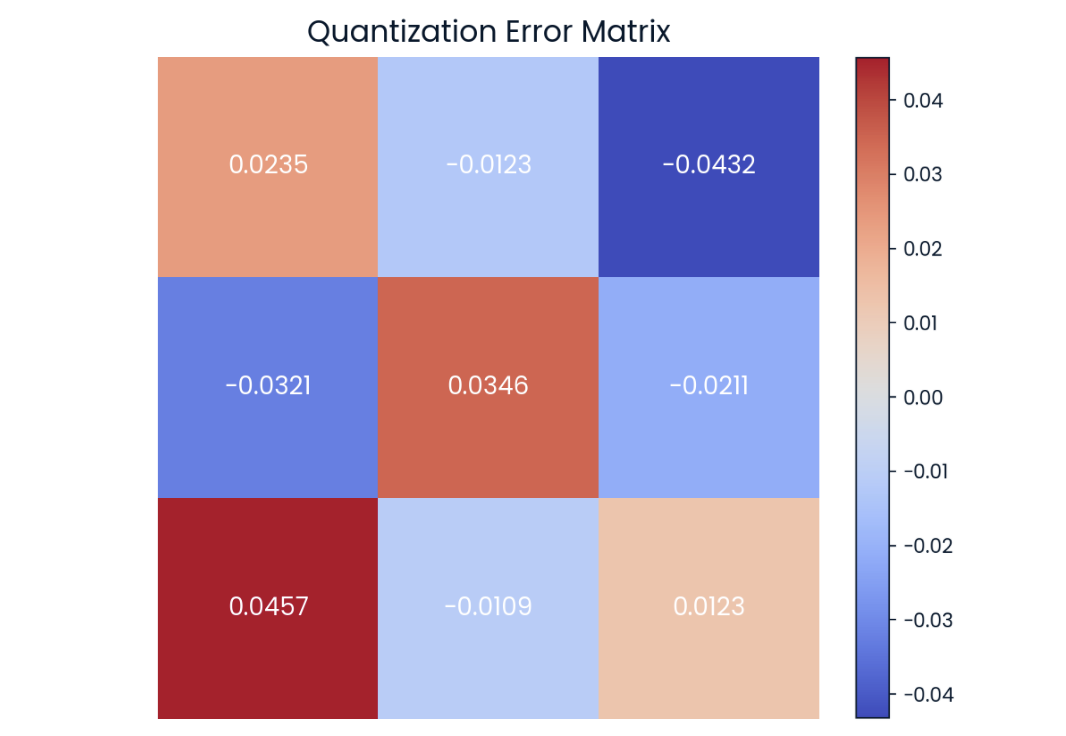
Die Matrizen sind nicht identisch, aber sehr ähnlich. Die punktweise Abweichung nennt man Quantisierungsfehler — auch darstellbar als Matrix:
Quantisierungsfehler in Matrixform. Je dunkler die Farbe, desto größer der Fehler.
Die aktuelle Forschung zielt darauf ab, diese Abweichung so weit wie möglich zu reduzieren, um Leistungseinbußen zu vermeiden.
Im einfachen Beispiel runden wir nur. In der Praxis wird durch Umwandlung in einen anderen Datentyp quantisiert — z. B. von hoher in geringere Präzision. Standardmäßig werden Modelle meist als float32 gespeichert.
Dabei brauchen wir 4 Bytes pro Parameter (4×8 Bit). Für eine 3x3-Matrix wie im Beispiel ergibt das 36 Bytes Speicherbedarf.
Durch Umwandlung — auch Downcasting genannt — in int8 benötigen wir nur 1 Byte pro Parameter. Der Speicherbedarf der Matrix sinkt so auf 9 Bytes.
Der gewählte Datentyp für die Modellgewichte bestimmt, wie stark wir das Modell verkleinern können. Klassische Gleitkommatypen wie float32 und float16 sind in vielen ML-Anwendungen Standard und balancieren Genauigkeit und Effizienz. float32 bietet hohe Präzision und große Dynamik, benötigt aber mehr Speicher und Rechenleistung; float16 reduziert beides deutlich und beschleunigt Berechnungen.
float32 und der Effizienz von float16. So entstand Brain Floating Point (bfloat16), das den Dynamikbereich von float32 beibehält, jedoch mit geringerer Präzision.
Downcasting ist der formale Begriff für die Umwandlung eines Datentyps höherer Präzision in einen mit geringerer Präzision. Dadurch sinkt der Speicherbedarf und Rechenoperationen werden schneller, weil weniger Speicher bewegt wird.
In diesem Abschnitt sehen wir uns an, wie Downcasting von float32 — dem Standard-Speichertyp der meisten Modelle — zu Googles bfloat16 funktioniert und warum dabei typischerweise Daten verloren gehen.
Wir definieren zunächst einen zufälligen PyTorch-Tensor mit Elementen vom Typ float32 und geben die ersten fünf Elemente aus:
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
Nun casten wir den Tensor mit der Methode .to(dtype) auf bfloat16 und betrachten wieder fünf Elemente:
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Die Werte sind sehr ähnlich, aber nicht identisch. Der Unterschied wird deutlicher, sobald wir Operationen ausführen, etwa die Multiplikation des Tensors mit sich selbst:
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Führen wir dieselbe Berechnung mit dem quantisierten Tensor durch, ist die Abweichung größer:
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
Hier sehen wir durch Fehlerfortpflanzung einen deutlichen Unterschied im Endergebnis.
Genau diese Fehlerfortpflanzung tritt beim Downcasting von LLMs auf und führt zu Informationsverlust. Wie gesehen gilt: Weniger Speicher kann geringere Rechengenauigkeit bedeuten. Die Multiplikation verdeutlicht die reale, schichtweise Fehlerakkumulation, die letztlich einzelne Token-Vorhersagen beeinflussen kann.
Mit bfloat16 bleibt die Leistung meist akzeptabel. Für noch kleinere Datentypen gilt das jedoch nicht mehr.
Downcasting ist daher selten die beste Quantisierungsmethode, weil es stark vom Datentyp abhängt. Stattdessen kommen Verfahren zum Einsatz, die bei der Inferenz zurück in float32 konvertieren und so die Performance näher am Original halten.
Es gibt verschiedene Quantisierungsarten. Hier sind die wichtigsten im Überblick:
Die lineare Quantisierung gehört zu den beliebtesten Schemata für LLMs. Vereinfacht gesagt wird der Wertebereich der ursprünglichen Gleitkomma-Gewichte gleichmäßig auf einen Festkomma-Bereich abgebildet, während für die Inferenz der hochpräzise Datentyp genutzt wird.
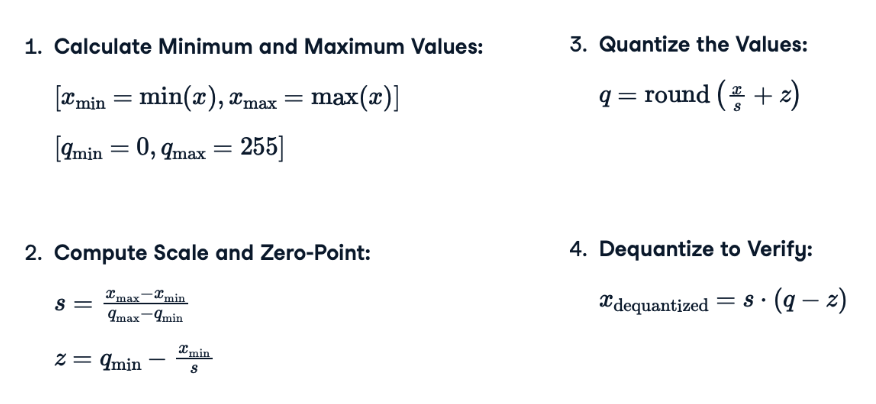
Um es greifbar zu machen, fassen wir die Schritte zur linearen Quantisierung zusammen. Die eigentlichen Formeln siehst du im Bild unten:
s) und Zero-Point (s) bestimmen: Die Skalierung passt den Float-Bereich an den Ganzzahlbereich an. Der Zero-Point stellt sicher, dass Null korrekt als Ganzzahl repräsentiert wird — wichtig für numerische Stabilität, besonders nahe Null.q): Float-Werte werden mit der Skalierung s und dem Zero-Point s in den niedrigpräzisen Ganzzahlbereich abgebildet. Eine Rundung sorgt dafür, dass Ganzzahlen entstehen, die sich effizient speichern und verarbeiten lassen.Hier die zugehörigen Formeln zu jedem Schritt:
Quantisierungsformeln zur Anwendung der linearen Quantisierung auf Gewichtsmatrizen.
Schwer vorstellbar, wie man das anwendet? Dann lass uns praktisch werden!
Wenden wir die Formeln auf den 3x3-Gewichtstensor links im Bild unten an, erhalten wir rechts die quantisierte Matrix. Nimm dir gern ein paar Minuten, um Minimum/Maximum des quantisierten Bereichs und einige quantisierte Werte selbst zu berechnen:
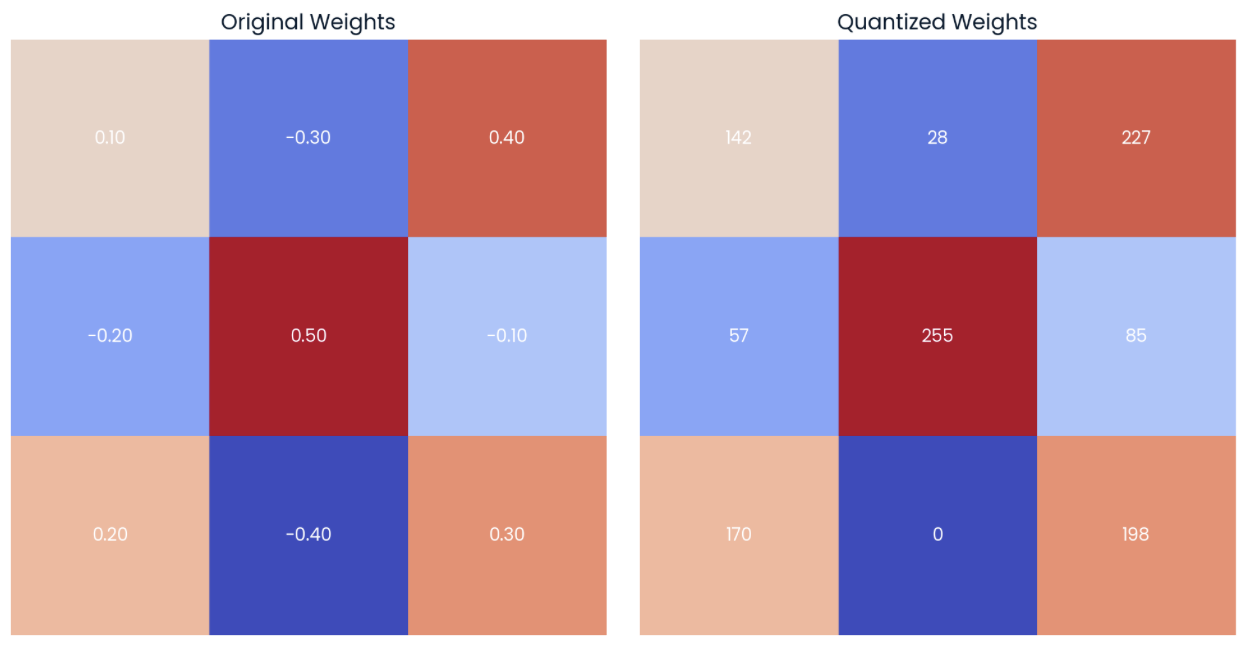
Beispiel einer zufälligen Gewichtsmatrix mit zwei Dezimalstellen (links) und der quantisierten Form (rechts) zum Datentyp int8.
Das untere Ende des int8-Wertebereichs entspricht dem kleinsten Wert im Original (-0,40 → 0), das obere Ende dem größten (0,50 → 255).
Dequantisieren wir die Werte nun mit Formel (4), liegen sie nahe an den Originalwerten (linke Matrix). Der Quantisierungsfehler ergibt sich als punktweise Differenz (rechte Matrix):
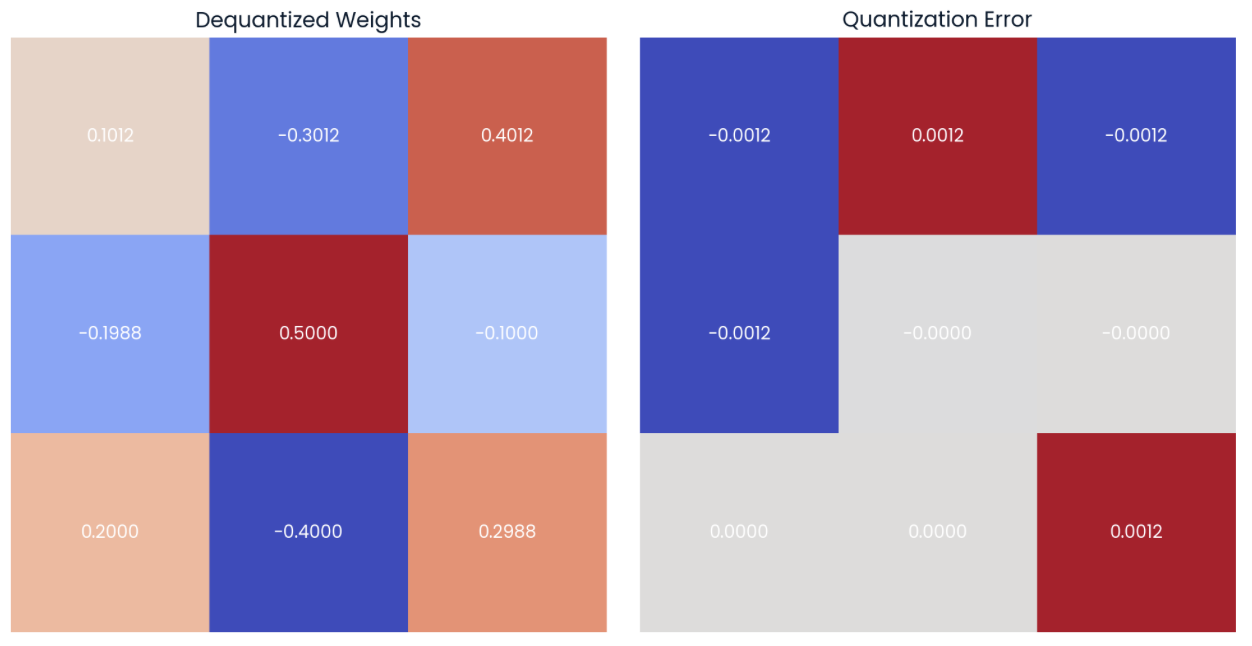
Dequantisierung mithilfe quantisierter Gewichte sowie Skalierung und Zero-Point (links). Rechts der punktweise Unterschied bzw. Quantisierungsfehler.
Die lineare Quantisierung verkleinert das Modell, indem nur die quantisierten Gewichte samt Skalierung und Zero-Point gespeichert werden. Für die Inferenz werden daraus die ursprünglichen Gewichte berechnet — so bleibt die Performance erhalten.
Lineare Quantisierung ist dank ihrer Einfachheit beliebt, doch es gibt mehrere Abbildungsstrategien. Eine aktuell sehr populäre Methode ist die blockweise Quantisierung. Sie ist genauer, wenn die Gewichte nicht gleichmäßig verteilt sind.
Hier werden Gewichte in kleinere Blöcke unterteilt und je Block quantisiert. Die Methode basiert auf zwei Konzepten:
In unseren Matrixbeispielen lag der Fokus auf der Quantisierung der Gewichte. Neben dieser zentralen Optimierung können auch die Aktivierungen eines Modells quantisiert werden.
Aktivierungsquantisierung bedeutet, die Präzision der Zwischenwerte jeder Schicht zu reduzieren. Im Gegensatz zu Gewichten, die nach dem Training konstant sind, sind Aktivierungen dynamisch. Ihr Wertebereich ändert sich mit jeder Eingabe und ist daher schwerer vorherzusagen.
Insgesamt ist Aktivierungsquantisierung aufwendiger als Gewichtsquantisierung. Sie erfordert eine sorgfältige Kalibrierung, damit der dynamische Bereich der Aktivierungen gut erfasst wird.
Beide Techniken ergänzen sich. In Kombination lassen sich Modelle spürbar verkleinern, ohne die Leistung zu stark zu beeinträchtigen.
Quantisierung kann zu unterschiedlichen Zeitpunkten erfolgen. Wenn wir ein vortrainiertes Modell nehmen und seine Parameter für die Inferenzphase quantisieren, ist das Post-Training Quantization (PTQ).
Dabei wird der Trainingsprozess nicht verändert. Der Dynamikbereich der Parameter wird zur Laufzeit neu bestimmt — ähnlich wie in unseren Matrixbeispielen.
Alternativ gibt es Quantization-Aware Training (QAT). Hier wird das Training so angepasst, dass die Effekte der Quantisierung bereits während des Trainings simuliert werden. Das Modell lernt Robustheit gegenüber Quantisierungsrauschen und erzielt dadurch bessere Genauigkeit.
Während QAT werden sowohl quantisierte als auch unquantisierte Gewichte im Speicher gehalten (Zwischenzustände!). Für die Inferenz nutzen wir die quantisierte Version, während die unquantisierten Gewichte in der Backpropagation aktualisiert werden.
Wie zu erwarten, liefert QAT trotz höherer Komplexität und Trainingsaufwand in der Regel bessere Genauigkeit als PTQ.
Manche Quantisierungsmethoden benötigen eine Kalibrierung. Beispielsweise müssen wir den ursprünglichen Aktivierungsbereich eines Modells vor der Quantisierung bestimmen. Allgemeine Kalibrierung bedeutet meist, die Inferenz auf einem repräsentativen Datensatz laufen zu lassen, um die Quantisierungsparameter zu optimieren und den Quantisierungsfehler zu minimieren.
Während der Kalibrierung sammelt der Algorithmus Statistiken zur Verteilung und Spannweite von Aktivierungen und Gewichten. Daraus werden optimale Quantisierungsparameter abgeleitet. Die Berechnung von Skalierung und Zero-Point bei der Gewichtsquantisierung ist ebenfalls eine Form der Kalibrierung. Weitere Ansätze sind:
Methoden wie QLoRA kommen hingegen ohne Kalibrierung aus.
Dabei werden häufig alle linearen Schichten durch quantisierte lineare Schichten (QLinear) ersetzt. QLinear-Schichten handhaben die Quantisierung intern — eine zusätzliche Kalibrierung entfällt. Das vereinfacht die Umsetzung bei zugleich stabiler Leistung.
Mehrere Python-Bibliotheken unterstützen Quantisierung — für PTQ und QAT. Beispielsweise bieten pytorch und tensorflow entsprechende Verfahren, aber die nahtlose Integration in bestehende Modelle erfordert tiefes Bibliotheks- und Architekturwissen. Siehe Quantisierungsoptionen in der offiziellen PyTorch-Dokumentation.
Wenn du diese mächtigen Frameworks lernen möchtest, empfehlen wir den Track Deep Learning in Python.
Mein Favorit für eine unkomplizierte Umsetzung ist derzeit die Quanto-Bibliothek von Hugging Face. Sie vereinfacht die Quantisierung von PyTorch-Modellen deutlich.
Ein typischer Workflow mit Quanto von Hugging Face umfasst folgende Schritte:
1. Vorgefertigtes Modell und passenden Tokenizer auswählen und laden. In diesem Beispiel nutzen wir Pythia 410M von EuletherAI:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Mit model.gpt_neox lassen sich die verschiedenen Schichten des geladenen Modells inspizieren:
print(model.gpt_neox)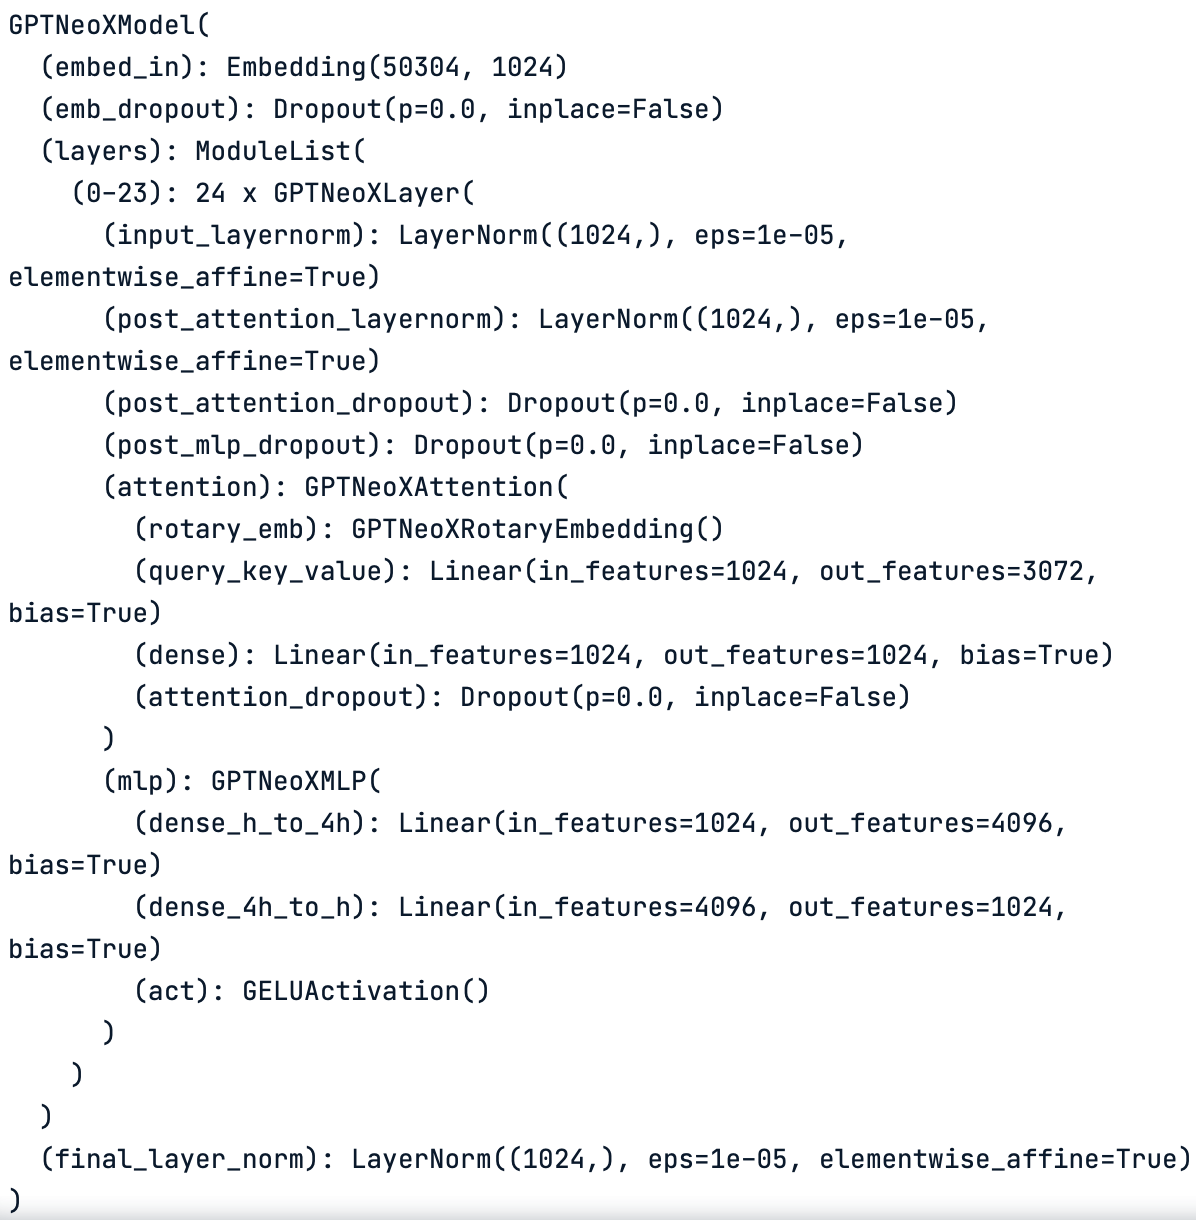
Schicht-für-Schicht-Schema des ursprünglichen Modells. Das Modell besteht aus verschiedenen Schichttypen wie linearen Schichten und Normalisierung.
Wir prüfen die Funktionsfähigkeit mit einer Testinferenz, zum Beispiel so:
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))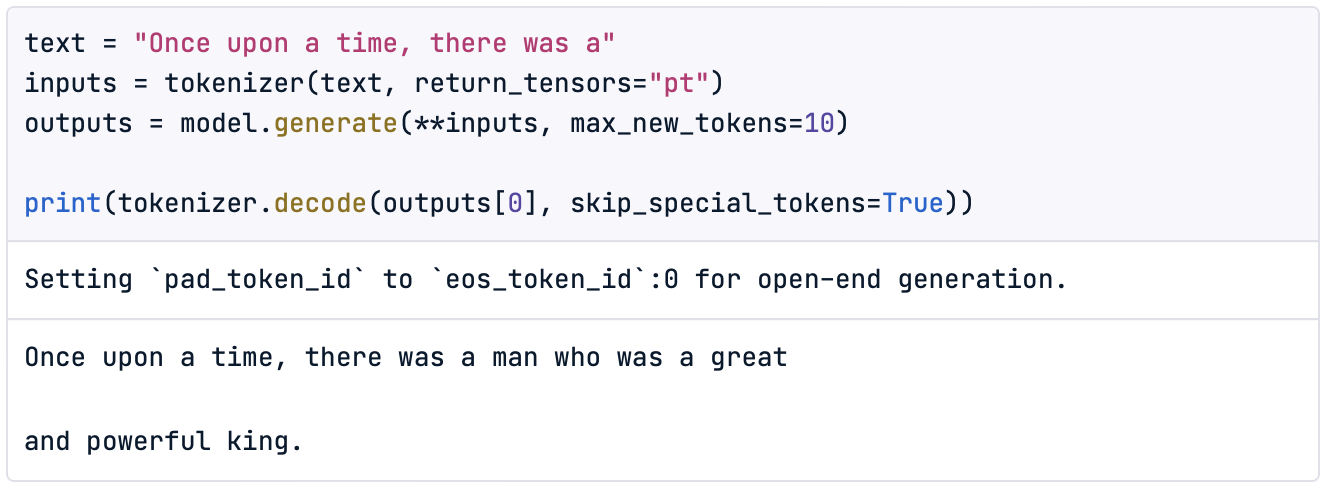
Da die Quantisierung die Modellgröße reduziert, lohnt sich ein Blick auf die Größe vorab:
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")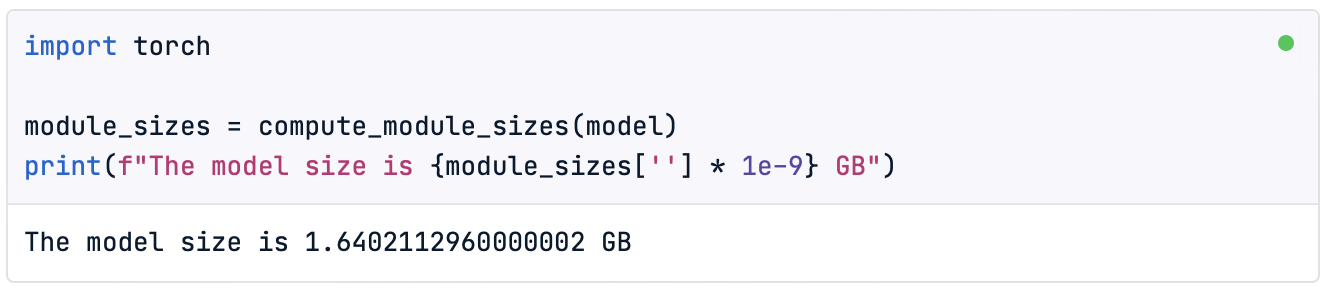
Hinweis: Im DataCamp DataLab ist die Methode compute_module_sizes() implementiert.
Außerdem können wir die dichten Tensoren des Originalmodells wie folgt inspizieren:
print(model.gpt_neox.layers[0].attention.dense.weight)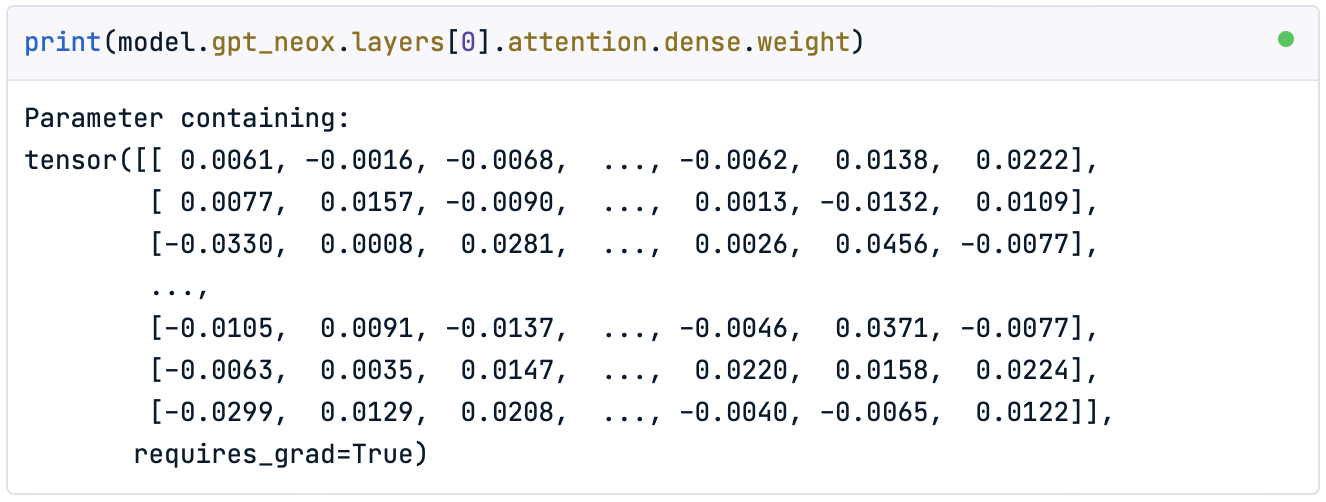
Das erinnert stark an die unquantisierte Matrix aus unserem Beispiel.
2. Quantisieren. Mit quantize() wandelst du das Standard-Float-Modell direkt in ein quantisiertes Modell um.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
Hier quantisieren wir nur die Gewichte auf den Datentyp int8. Die Methode schaltet auf niedrigere Präzision um — inkl. Kalibrierungsschritt.
Geben wir nun die Schichten des Modells aus, sehen wir: Aus ursprünglichen linearen Schichten (Linear) wurden quantisierte lineare Schichten (QLinear):
print(model)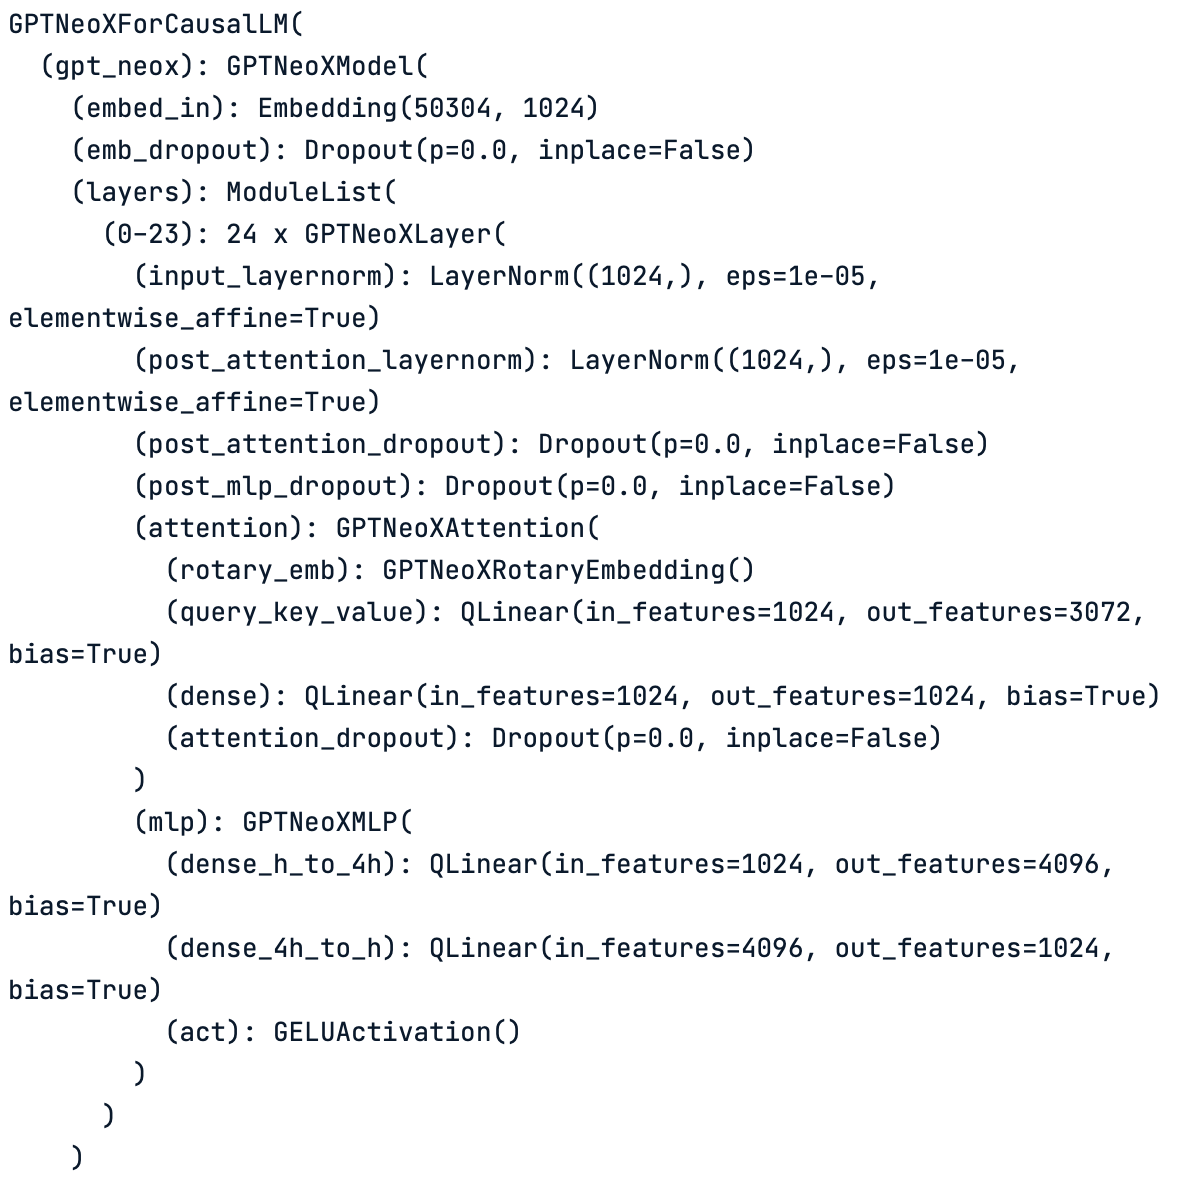
Schicht-für-Schicht-Schema des quantisierten Modells. Beachte, wie alle ursprünglichen linearen Schichten zu quantisierten linearen Schichten (QLinear) wurden.
Drucken wir jedoch die Gewichtsmatrix, sehen wir: Sie wurde noch nicht transformiert:
print(model.gpt_neox.layers[0].attention.dense.weight)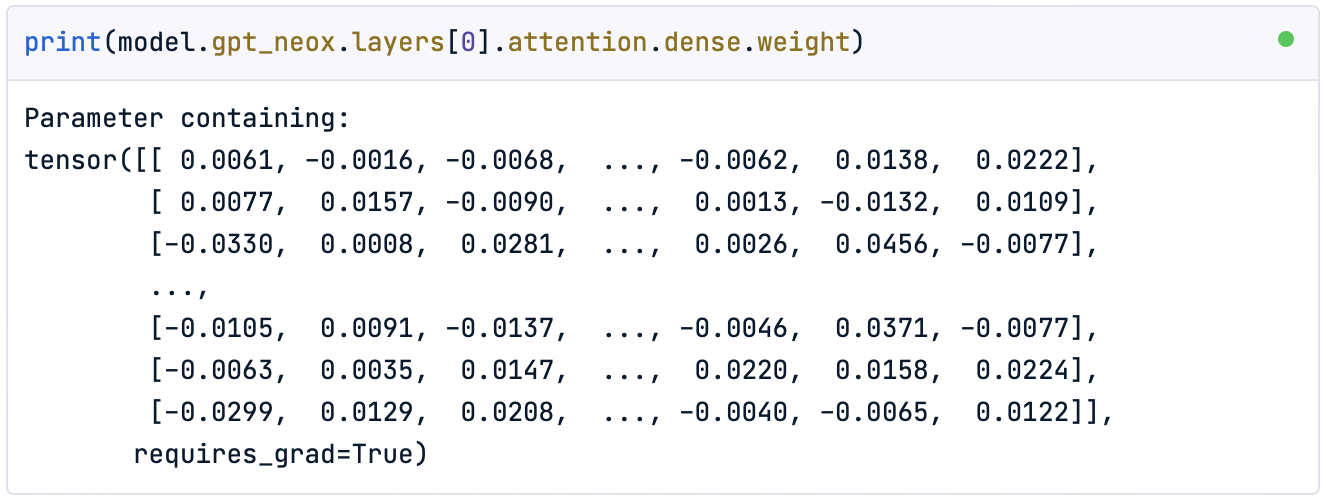
3. Freezen. Um die Quantisierung auf die Gewichte anzuwenden, nutzen wir freeze().
freeze(model)Damit werden die Quantisierungsparameter im Modell verankert und die Gewichte effektiv in den Ziel-Datentyp überführt. So sehen die quantisierten Parameter jetzt aus:
print(model.gpt_neox.layers[0].attention.dense.weight)
Wie zu sehen, liegen die Gewichte nun im Bereich des PyTorch-Datentyps int8.
4. Abschließende Checks. Nach der Quantisierung prüfen wir die neue, reduzierte Modellgröße:
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")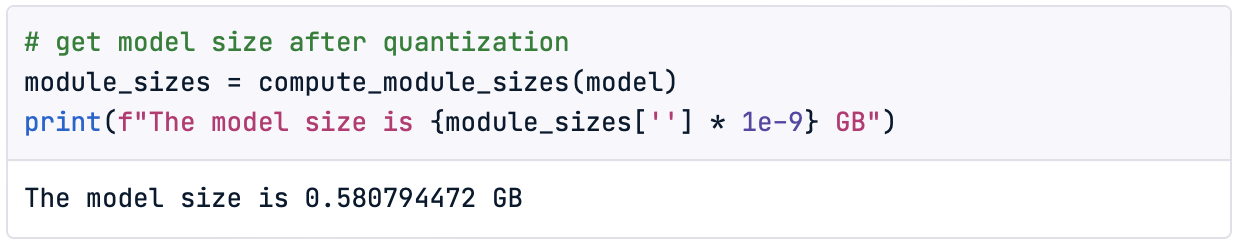
Wir haben das Modell auf nur 35% der ursprünglichen Größe gebracht!
Zum Schluss ein einfacher Performancetest per Inferenz:
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))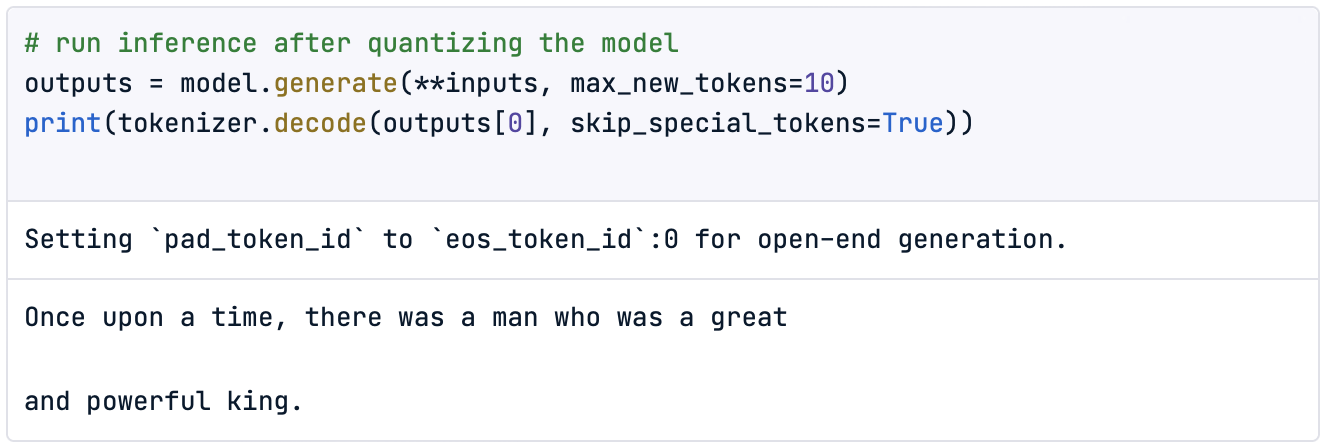
Klar: Eine einzelne Inferenz ist nicht aussagekräftig. Definiere daher am besten einen quantitativen Evaluierungsansatz.
Jetzt bist du dran!
Die steigenden Speicheranforderungen von LLMs erschweren Training und Inferenzhosting und begrenzen so die Verfügbarkeit und Verbreitung LLM-basierter Anwendungen.
In diesem Artikel haben wir Quantisierung als Technik vorgestellt, die Präzision von Gewichten und Aktivierungen zu reduzieren, um den Speicher- und Rechenbedarf zu senken. Das macht Modelle effizienter und zugänglicher — besonders für den Einsatz auf ressourcenbeschränkten Geräten.
Wir sind schrittweise vorgegangen: zunächst mit Rundung der Zahlenwerte, dann mit einer einfachen Quantisierungsform — dem Downcasting. Beim Downcasting werden Parameter für die Inferenz in kompaktere Datentypen wie bfloat16 konvertiert. Das ermöglicht Berechnungen und Aktivierungen in kleinerem Format, jedoch nimmt die Leistung mit der Datentypgröße ab — bei Ganzzahlen wie int8 ist es ineffektiv.
Als Lösung haben wir die lineare Quantisierung eingeführt. Sie hält die Performance näher am Originalmodell, indem zur Inferenz zurück in float32 konvertiert wird. Dadurch lassen sich auch kleinere Datentypen wie int8 nutzen.
Wir sind die numerischen Schritte der linearen Quantisierung durchgegangen und haben die Gewichtsquantisierung mit der Quanto-Bibliothek von Hugging Face umgesetzt. Mit Quanto kannst du grundsätzlich jedes PyTorch-Modell quantisieren — auch jene aus dem Hugging Face Hub.
Wenn du schwergewichtigere Modelle wie LLaMa 2 oder Mistral ausprobieren willst, lohnt sich ein Upgrade deines DataCamp-Bereichs auf Premium für mehr Rechenleistung.

Für größere Modelle brauchst du eventuell zusätzliche Ressourcen aus dem DataCamp Premium Plan.
Wenn wir Quantisierungstechniken beherrschen, können wir das volle Potenzial großer Sprachmodelle mit weniger Ressourcen ausschöpfen — und damit fortschrittliche KI effizienter, zugänglicher und vielseitiger machen.
Ich hoffe, dieser Artikel hilft dir, Quantisierung für LLMs in der Praxis anzuwenden!
Top-LLM-Kurse
Kurs
Lernpfad
Kurs