Cours
Développement d'applications LLM avec LangChain
3 h
50.7K
Avez-vous déjà rêvé de faire tourner votre propre ChatGPT directement sur votre ordinateur portable ?
Avec les progrès fulgurants des grands modèles de langage (LLMs), l’arrivée de ces modèles puissants sur du matériel grand public devient une réalité.
La clé pour libérer ce potentiel réside dans la quantification, une technique qui permet de réduire la taille de ces modèles toujours plus grands afin de les exécuter sur des appareils du quotidien avec une dégradation minimale des performances — si elle est correctement mise en œuvre !
Dans ce guide, nous allons détailler le concept de quantification, expliquer son fonctionnement et passer en revue les différentes approches pour quantifier des LLMs. Enfin, nous quantifierons un modèle en deux étapes simples avec la bibliothèque Quanto de Hugging Face.
Plongeons dans le vif du sujet ! Vous pouvez suivre pas à pas dans DataCamp DataLab.
À mesure que les LLMs évoluent, leur complexité explose, ce qui entraîne une augmentation massive de leur nombre de paramètres. Par exemple, le premier modèle GPT, lancé en 2018, comptait 0,11 milliard de paramètres. Fin 2019, GPT-2 est passé à 1,5 milliard, et GPT-3, publié fin 2020, a grimpé à 175 milliards de paramètres.
Aujourd’hui, GPT-4 dépasserait le billion de paramètres. Cette hausse vertigineuse pose un défi : plus les modèles grossissent, plus leurs besoins en mémoire augmentent, dépassant souvent la capacité d’accélérateurs matériels avancés comme les GPU.
Cette demande croissante en mémoire limite à la fois l’entraînement et l’hébergement en inférence, et freine par conséquent l’accessibilité et l’adoption des solutions fondées sur des LLMs.
Cette évolution crée un besoin urgent : rendre ces modèles plus accessibles en réduisant leur taille. En changeant la précision de certains composants du modèle, la quantification diminue son empreinte mémoire tout en conservant des performances proches.
La quantification est une technique de compression qui convertit les poids et activations d’un grand modèle de langage de valeurs haute précision vers des valeurs de plus faible précision. Autrement dit, on remplace un type de données riche en information par un type plus compact. Un exemple typique consiste à passer d’un nombre à virgule flottante 32 bits à un entier 8 bits.
Réduire le nombre de bits nécessaires pour chaque poids ou activation entraîne une baisse significative de la taille globale. Par conséquent, la quantification compacte les LLMs pour consommer moins de mémoire, occuper moins d’espace de stockage et améliorer l’efficacité énergétique.
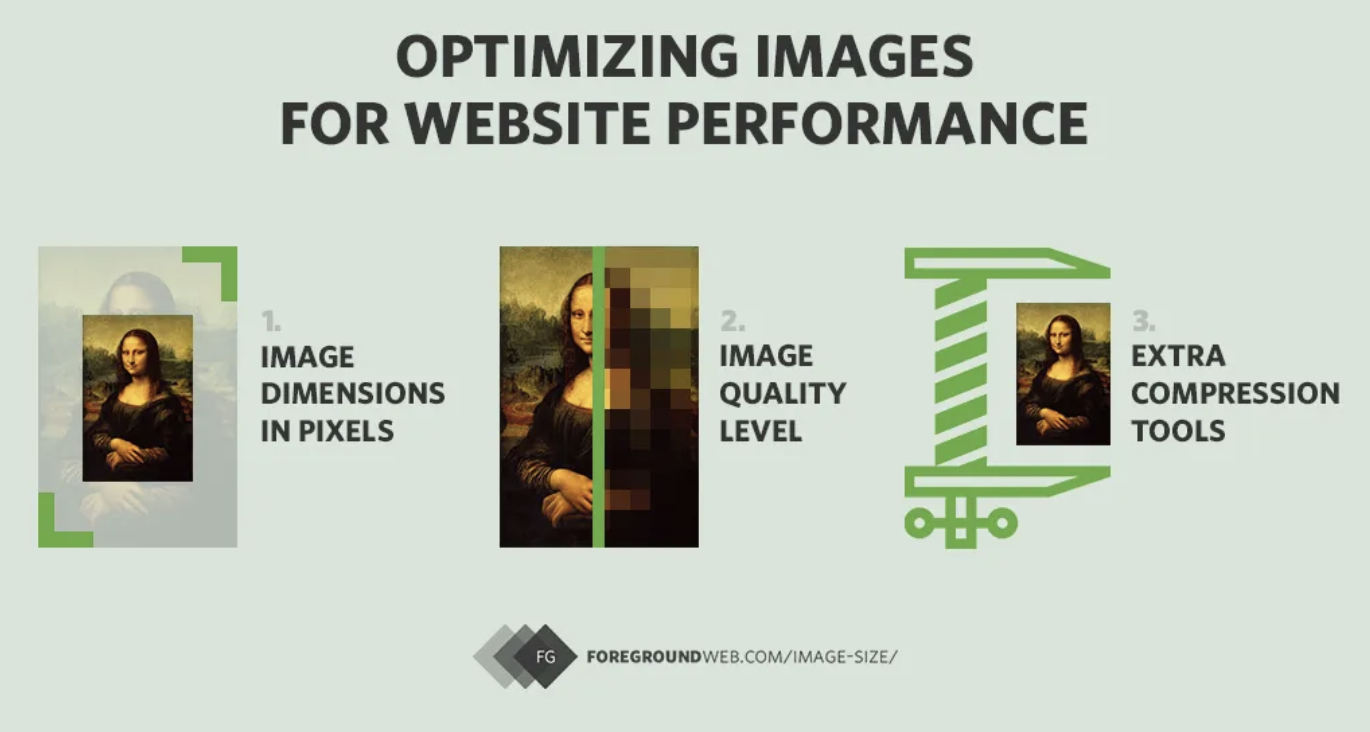
Une analogie parlante est la compression d’image. Les images haute résolution sont souvent compressées pour le web. On réduit la taille en supprimant des données. La qualité visuelle baisse généralement un peu, mais le poids du fichier diminue, ce qui accélère le chargement tout en conservant une expérience satisfaisante.
Schéma de la compression d’image pour un chargement plus rapide dans des applications comme les pages web.
De la même façon, quantifier un LLM réduit les besoins de calcul, ce qui permet de l’exécuter sur du matériel moins puissant tout en obtenant des performances adéquates. Comme les images compressées, les modèles quantifiés sont plus simples à déployer sur différentes plateformes, au prix d’un léger compromis sur le détail ou la précision. Comme nous allons le voir, le processus de quantification introduit également du bruit.
La quantification s’applique généralement aux poids d’un grand modèle de langage, même si l’on peut aussi quantifier les activations. Les poids d’un réseau de neurones sont des paramètres qui déterminent l’intensité des connexions entre neurones à travers les couches. Ce sont en substance les coefficients appris qui transforment les données d’entrée au fil de la propagation dans le réseau.
Initialement aléatoires et dénués de sens, les poids sont ajustés pendant l’entraînement en fonction de l’erreur entre la prédiction et la cible. Cet ajustement est guidé par des algorithmes d’optimisation comme la descente de gradient.
Pour en savoir plus sur le fonctionnement interne des LLMs, le parcours Developing Large Language Models est fait pour vous !
Une option de quantification consiste à réduire la précision des poids. Pour l’illustrer, concentrons-nous sur la matrice de gauche dans l’image ci-dessous, qui représente une matrice 3×3 de poids avec une précision à quatre décimales :
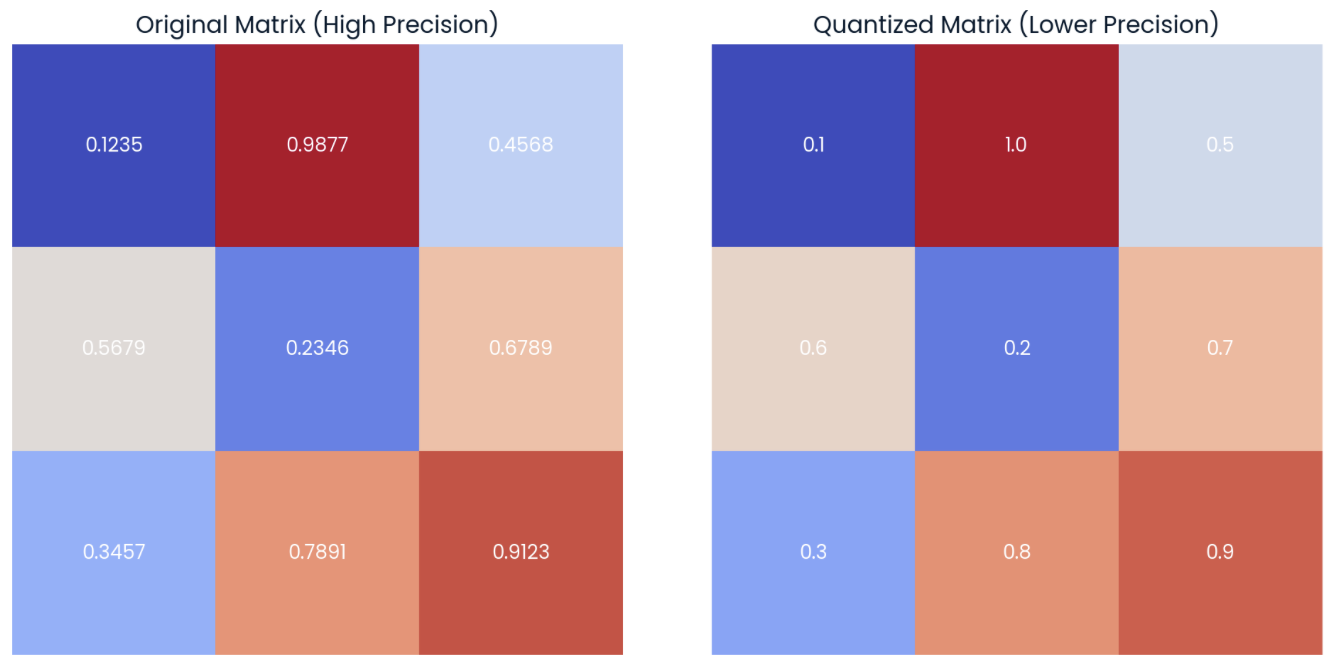
Exemple d’une matrice aléatoire de poids à quatre décimales (gauche) et sa forme quantifiée (droite) par arrondi à une décimale.
Sur la matrice de droite, on observe la version quantifiée de la matrice d’origine. Cette matrice « quantifiée » est obtenue en arrondissant les éléments à une décimale.
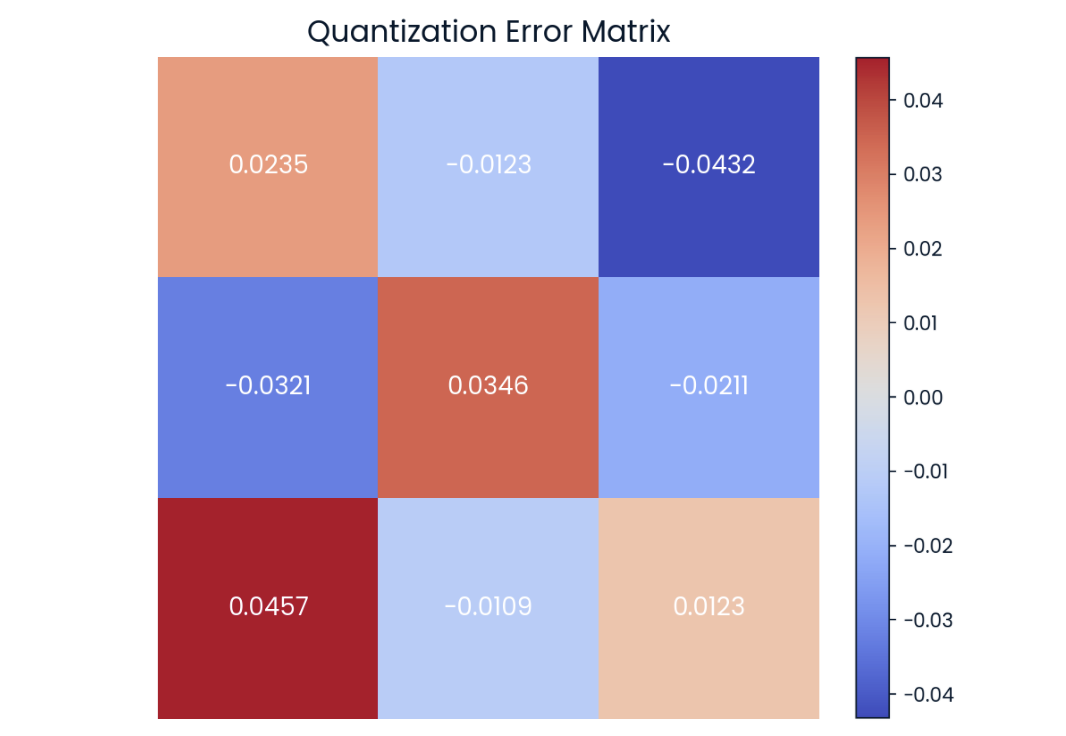
Les deux matrices ne sont pas exactement égales, mais restent très proches. La différence élément par élément s’appelle erreur de quantification, que l’on peut également représenter sous forme matricielle :
Erreur de quantification sous forme matricielle. Plus la couleur est foncée, plus l’erreur est élevée.
La recherche actuelle en quantification vise à réduire au maximum cette différence pour éviter toute dégradation des performances.
Dans cet exemple simple, nous nous contentons d’arrondir les éléments. En pratique, la quantification consiste à convertir des valeurs numériques vers un autre type de données, p. ex. d’un type à plus haute précision vers un type à plus faible précision. Par exemple, le type de stockage par défaut de la plupart des modèles est float32.
Dans ce cas, il faut allouer 4 octets par paramètre (4 fois 8 bits). Ainsi, pour une matrice 3×3 comme dans l’exemple, l’empreinte mémoire totale est de 36 octets.
En changeant de type — on parle aussi de downcasting — vers int8, un seul octet par paramètre suffit. L’empreinte mémoire totale passe alors à 9 octets.
Le type de données choisi pour les poids du modèle conditionne le niveau de réduction possible. Les types en virgule flottante classiques, comme float32 et float16, sont la norme dans de nombreuses applications de ML, offrant un compromis entre précision et efficacité. Concrètement, float32 offre une haute précision et une large plage dynamique, au prix d’une consommation mémoire et de calcul plus élevées. À l’inverse, float16 réduit la précision et la plage, accélérant sensiblement les calculs.
float32 et l’efficacité de float16. Cela a conduit à la création du Brain Floating Point (bfloat16), qui conserve la plage dynamique de float32 mais avec une précision réduite.
Le downcasting est le terme consacré pour convertir un type de données de haute précision vers un type de plus faible précision. En downcastant, on réduit l’empreinte mémoire et on augmente la vitesse, car les calculs en plus faible précision nécessitent aussi moins de mémoire.
Dans cette section, nous allons voir comment passer de float32 — le type de stockage par défaut — au bfloat16 de Google, et constater la perte d’information typique.
Commençons par définir un tenseur aléatoire PyTorch en float32 et afficher ses cinq premiers éléments :
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
Nous pouvons maintenant convertir le tenseur en bfloat16 avec la méthode .to(dtype) et observer les 5 premiers éléments :
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Les valeurs restent très proches, bien que différentes. L’écart devient plus visible quand on effectue des opérations. Par exemple, en multipliant le tenseur par lui-même :
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Si nous effectuons le même calcul avec le tenseur quantifié, l’écart est plus important :
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
On observe une différence nette entre les résultats finaux due à la propagation de l’erreur.
Le même phénomène de propagation d’erreur se produit lors du downcasting des LLMs, entraînant une perte d’information. Comme nous l’avons vu, utiliser moins de mémoire peut rendre le calcul moins précis. L’effet de la multiplication illustre la propagation d’erreur couche après couche, qui s’accumule et finit par affecter certaines prédictions de jetons.
Avec le downcasting, les performances restent acceptables en bfloat16, mais ce n’est généralement pas le cas pour des types plus petits.
Le downcasting est donc rarement utilisé comme technique de quantification efficace à cause de ces limites de types. D’autres méthodes conservent des performances plus proches de l’original en reconvertissant en float32 lors de l’inférence.
Il existe plusieurs types de quantification, décrits ci‑dessous en détail :
La quantification linéaire est l’un des schémas les plus populaires pour les LLMs. En termes simples, elle consiste à projeter de façon uniforme la plage de valeurs flottantes des poids d’origine vers une plage d’entiers fixes, tout en utilisant un type haute précision pour l’inférence.
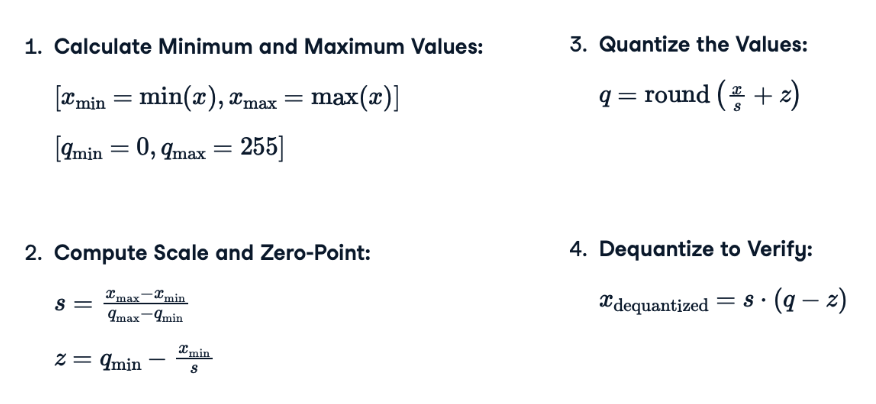
Pour rendre cela très concret, passons en revue les étapes nécessaires. Les formules exactes figurent dans l’image ci-dessous :
s) et le point zéro (s) : l’échelle adapte la plage flottante à la plage d’entiers. Le point zéro garantit que zéro en flottant est correctement représenté par un entier, ce qui préserve l’exactitude, notamment autour de zéro.q) : on projette les flottants vers la plage entière via l’échelle s et le point zéro s calculés. L’arrondi assure un entier discret, adapté au stockage et au calcul en faible précision.Associons chaque étape à sa formule correspondante :
Équations de quantification utilisées pour appliquer la quantification linéaire à une matrice de poids.
Difficile d’imaginer comment appliquer ces formules ? Passons à la pratique !
En appliquant ces formules au tenseur 3×3 de poids à gauche ci‑dessous, nous obtenons la matrice quantifiée à droite. Je vous invite à prendre quelques minutes pour calculer les bornes min/max de la plage quantifiée et quelques valeurs quantifiées :
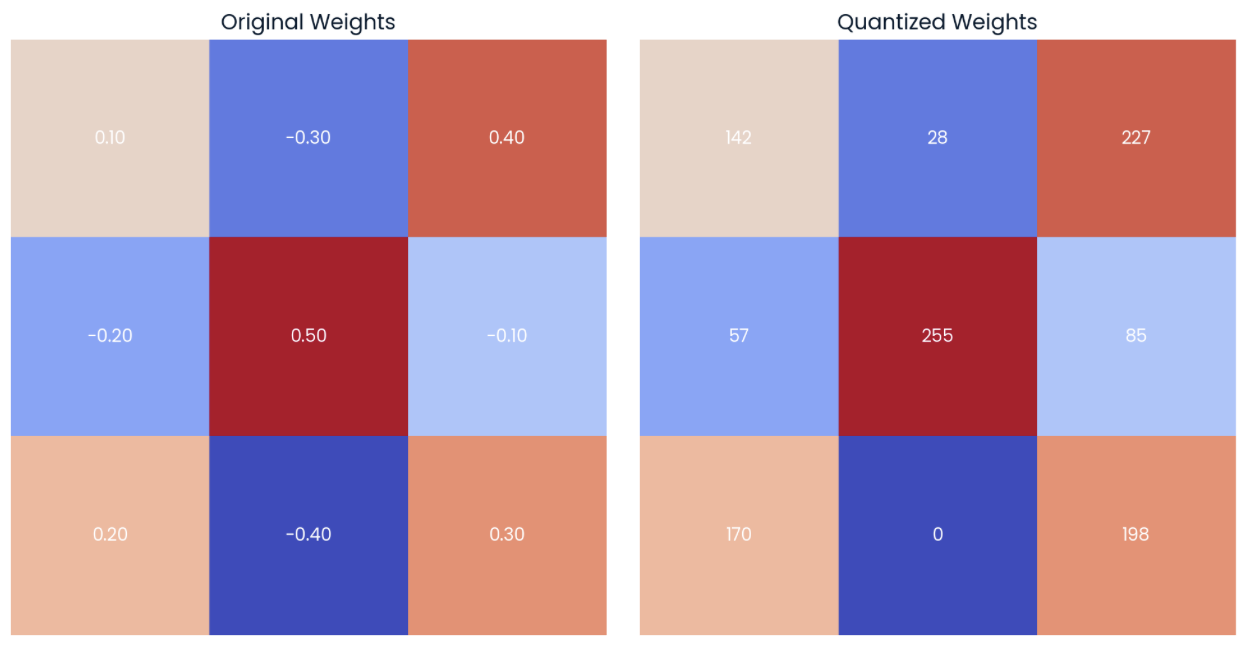
Exemple d’une matrice de poids à deux décimales (gauche) et sa forme quantifiée (droite) en int8.
On constate que la borne inférieure de la valeur int8 correspond au minimum du tenseur d’origine (-0,40 → 0), tandis que la borne supérieure correspond au maximum (0,50 → 255).
En déquantifiant les valeurs avec la formule (4), on voit que les valeurs déquantifiées sont proches des valeurs d’origine (matrice de gauche). On peut calculer l’erreur de quantification via la différence point par point (matrice de droite) :
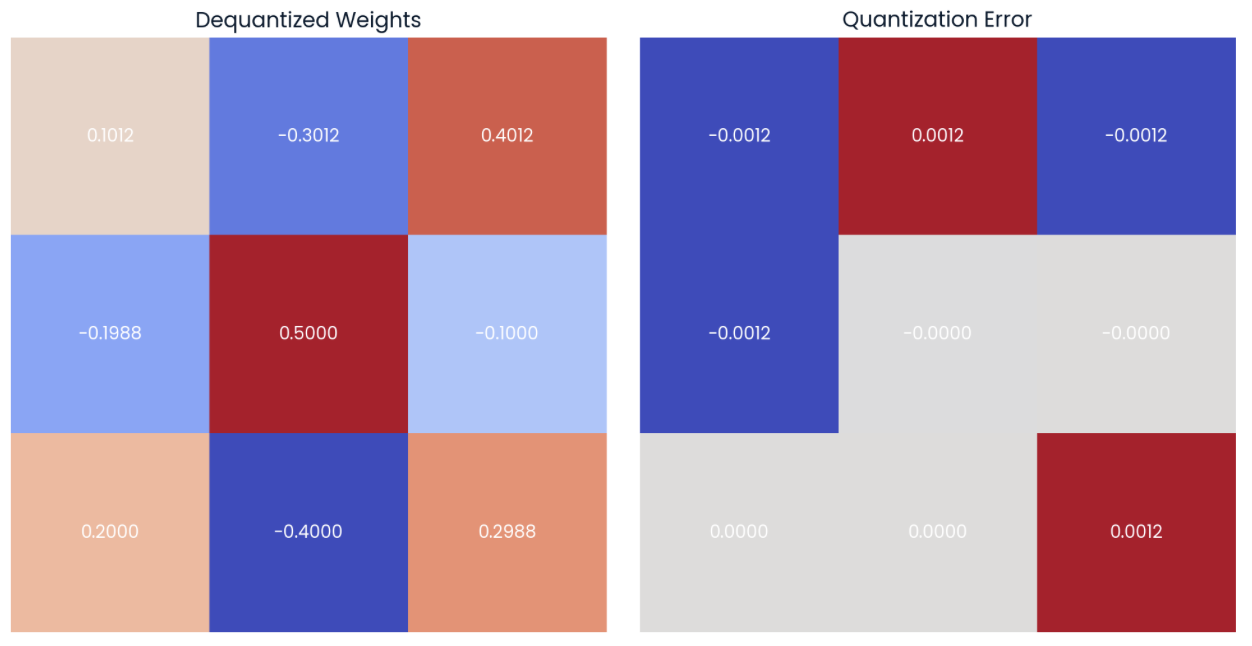
Les valeurs peuvent être déquantifiées à partir des poids quantifiés et des paramètres d’échelle et de point zéro (gauche). On calcule ensuite l’erreur de quantification point par point (droite).
La quantification linéaire réduit la taille du modèle en ne stockant que les poids quantifiés ainsi que l’échelle et le point zéro, tout en recréant les poids d’origine à l’inférence pour préserver les performances.
La quantification linéaire est prisée pour sa simplicité, mais il existe d’autres façons de construire la correspondance. Une méthode très en vogue est la quantification par blocs, plus précise lorsque les distributions de poids sont non uniformes.
Cette approche consiste à quantifier les poids par petits blocs plutôt que sur l’ensemble de la plage. Elle repose sur deux idées clés :
Nos exemples matriciels se sont concentrés sur la quantification des poids. Si elle est cruciale, il ne faut pas oublier que les activations d’un modèle peuvent aussi être quantifiées.
La quantification des activations consiste à réduire la précision des sorties intermédiaires de chaque couche. Contrairement aux poids, qui sont statiques une fois le modèle entraîné, les activations sont dynamiques. Elles varient selon l’entrée du réseau, ce qui rend leur plage plus difficile à prévoir.
De manière générale, la quantification des activations est plus délicate à mettre en œuvre que celle des poids. Elle requiert un calibrage soigné pour bien capturer la plage dynamique.
Ces deux techniques sont complémentaires. En les combinant, on peut réduire significativement la taille d’un modèle sans trop dégrader ses performances.
La quantification peut intervenir à différents moments. Si l’on prend un modèle pré‑entraîné et que l’on quantifie ses paramètres uniquement pour l’inférence, on réalise une quantification post‑entraînement (PTQ).
Cette méthode ne modifie pas l’entraînement. La plage dynamique des paramètres est recalculée à l’exécution, comme dans nos exemples matriciels.
À l’inverse, on peut recourir à la quantification consciente de l’entraînement (QAT). Cette approche adapte le processus d’entraînement pour simuler les effets de la quantification pendant l’apprentissage. Le modèle apprend à être robuste au bruit de quantification, ce qui améliore la précision finale.
Pendant la QAT, les états intermédiaires conservent à la fois une version quantifiée et la version d’origine non quantifiée des poids (en mémoire également !). On utilise donc la version quantifiée pour l’inférence, mais on met à jour la version non quantifiée lors de la rétropropagation.
Comme attendu, bien que plus complexe et chronophage, la QAT conduit généralement à une meilleure précision que la PTQ.
Certaines méthodes de quantification nécessitent un calibrage. Par exemple, il faut déterminer la plage des activations d’un modèle avant quantification. Le calibrage consiste en général à exécuter le modèle sur un jeu de données représentatif afin d’optimiser les paramètres de quantification et de minimiser l’erreur.
Pendant ce processus, l’algorithme collecte des statistiques sur la distribution et la plage des activations et des poids. Ces statistiques servent à déterminer les meilleurs paramètres. Le calcul de l’échelle et du point zéro lors de la quantification des poids est une forme de calibrage, mais il en existe d’autres :
Cependant, des méthodes comme QLoRA peuvent s’employer sans étape de calibrage.
Ces approches remplacent généralement toutes les couches linéaires du modèle par des couches linéaires quantifiées (QLinear). Les couches QLinear gèrent la quantification en interne, ce qui supprime le besoin d’un calibrage additionnel. Cela simplifie la mise en œuvre tout en conservant les performances du modèle.
Plusieurs bibliothèques Python prennent en charge la quantification, tant pour la PTQ que pour la QAT. Par exemple, pytorch et tensorflow proposent des méthodes de quantification, même si une intégration fluide dans des modèles existants exige une bonne compréhension des bibliothèques et des entrailles des modèles. Voir les options de quantification dans la documentation officielle PyTorch.
Si vous souhaitez apprendre ces frameworks puissants, je vous recommande le parcours Deep Learning in Python.
Mon option préférée pour mettre en place la quantification en quelques étapes est la bibliothèque Quanto de Hugging Face, conçue pour simplifier la quantification des modèles PyTorch.
Un flux de travail typique avec la bibliothèque Quanto de Hugging Face comprend les étapes suivantes :
1. Sélectionner et charger un modèle pré‑entraîné et son tokenizer. Ici, nous allons utiliser le modèle Pythia 410M d’EleutherAI :
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
La méthode model.gpt_neox permet de visualiser les différentes couches du modèle chargé :
print(model.gpt_neox)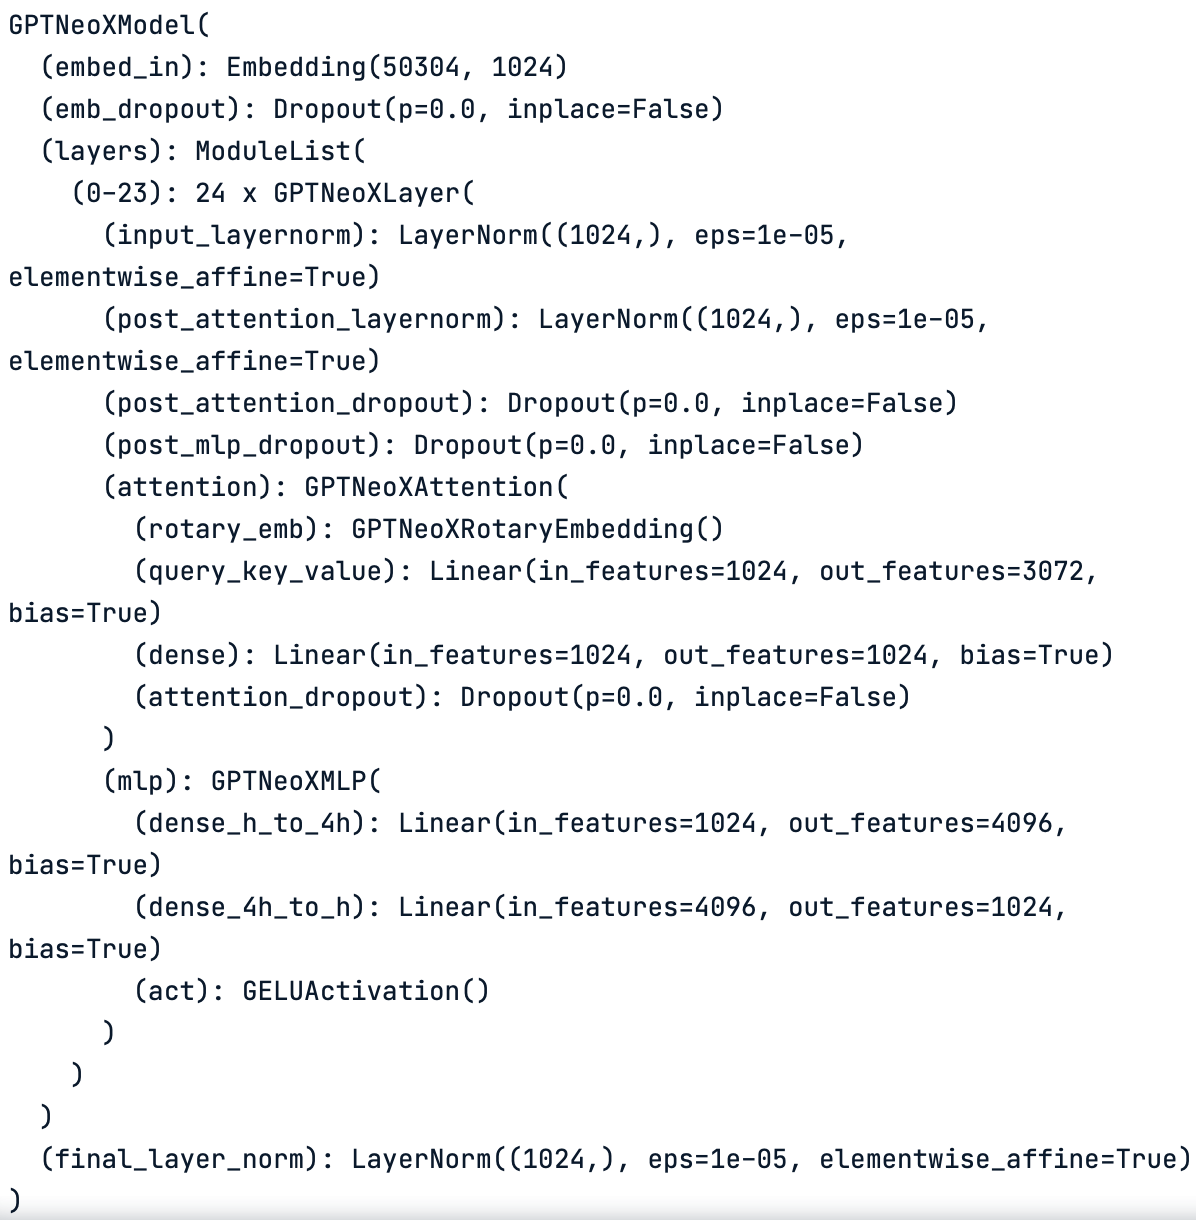
Schéma couche par couche du modèle d’origine. Le modèle comprend des couches linéaires et des couches de normalisation.
Vérifions que le modèle fonctionne correctement via quelques inférences de test. Par exemple,
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))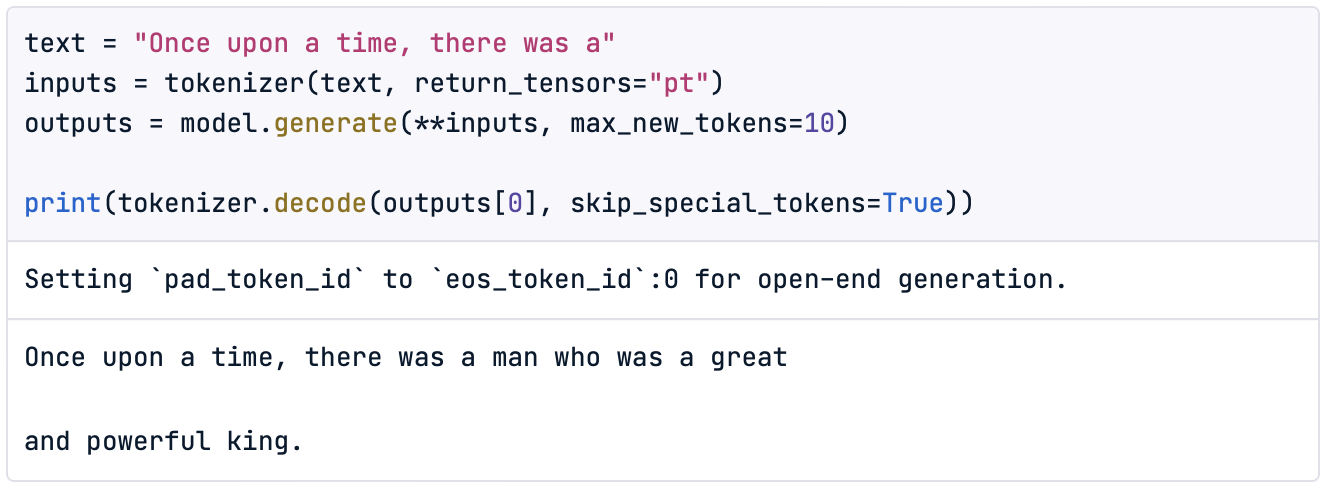
Puisque la quantification va réduire la taille du modèle, il est également intéressant de vérifier la taille initiale avant de démarrer :
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")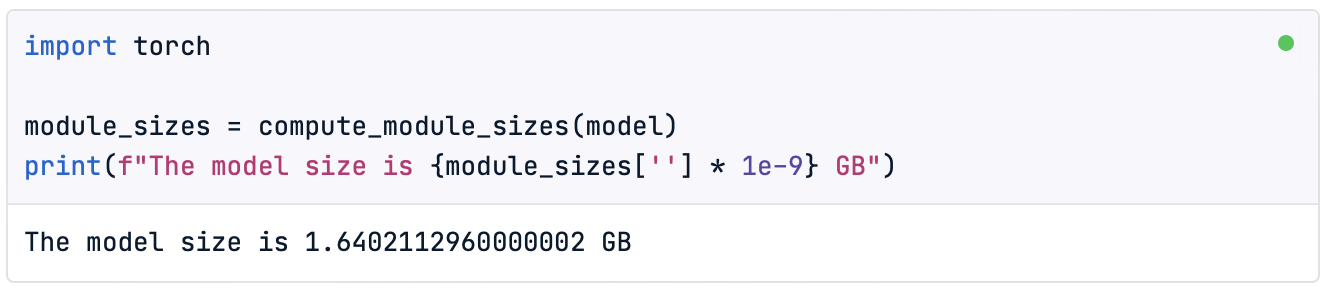
Remarque : dans DataCamp DataLab, la fonction compute_module_sizes() est déjà implémentée.
Enfin, on peut visualiser les tenseurs denses du modèle d’origine comme suit :
print(model.gpt_neox.layers[0].attention.dense.weight)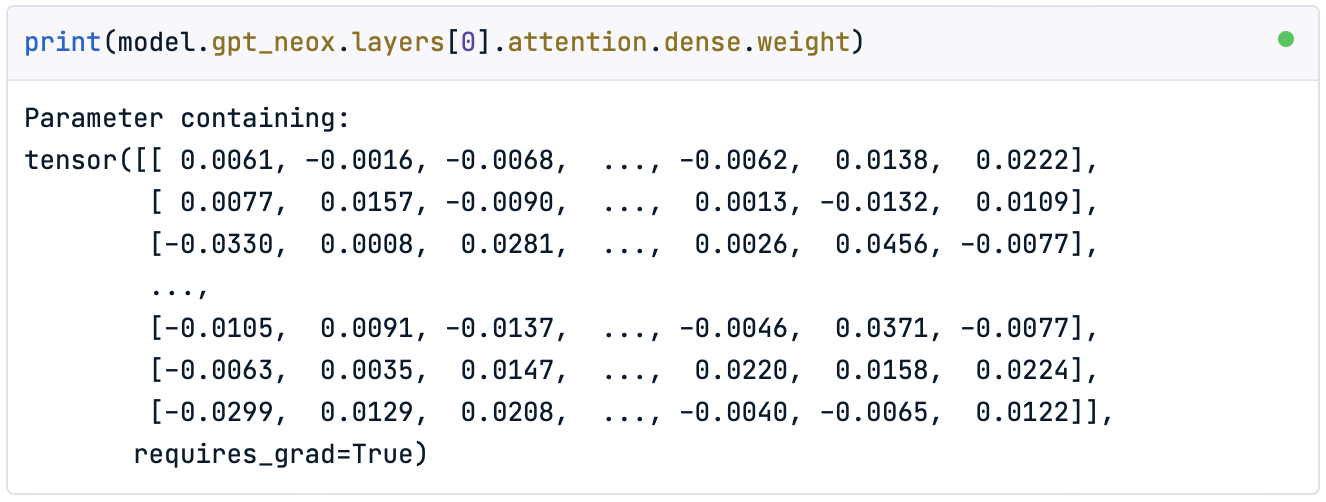
On constate qu’elle ressemble à la matrice non quantifiée utilisée plus haut.
2. Quantifier. La méthode quantize() convertit directement le modèle flottant standard en modèle quantifié.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
Ici, nous quantifions uniquement les poids en int8. Cette méthode convertit le modèle pour utiliser l’arithmétique en faible précision, y compris l’étape de calibrage.
Si nous imprimons désormais les couches du modèle, nous verrons que les couches linéaires d’origine (Linear) ont été remplacées par des couches linéaires quantifiées (QLinear) :
print(model)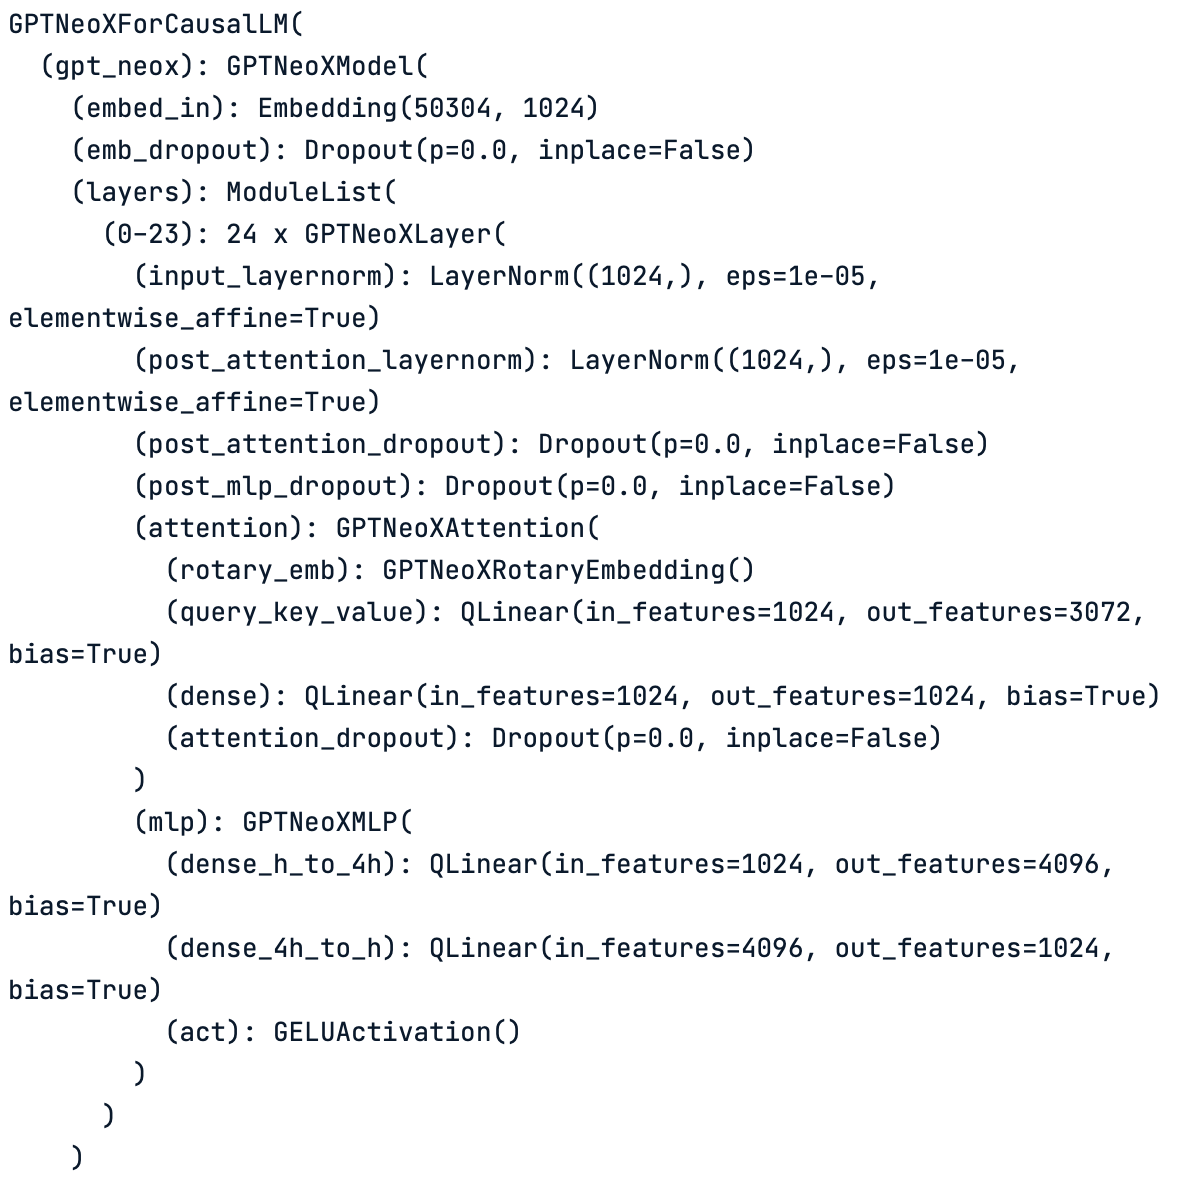
Schéma couche par couche du modèle quantifié. Remarquez que toutes les couches linéaires d’origine ont été remplacées par des couches linéaires quantifiées (QLinear).
Néanmoins, si nous affichons la matrice de poids, elle ne semble pas encore transformée :
print(model.gpt_neox.layers[0].attention.dense.weight)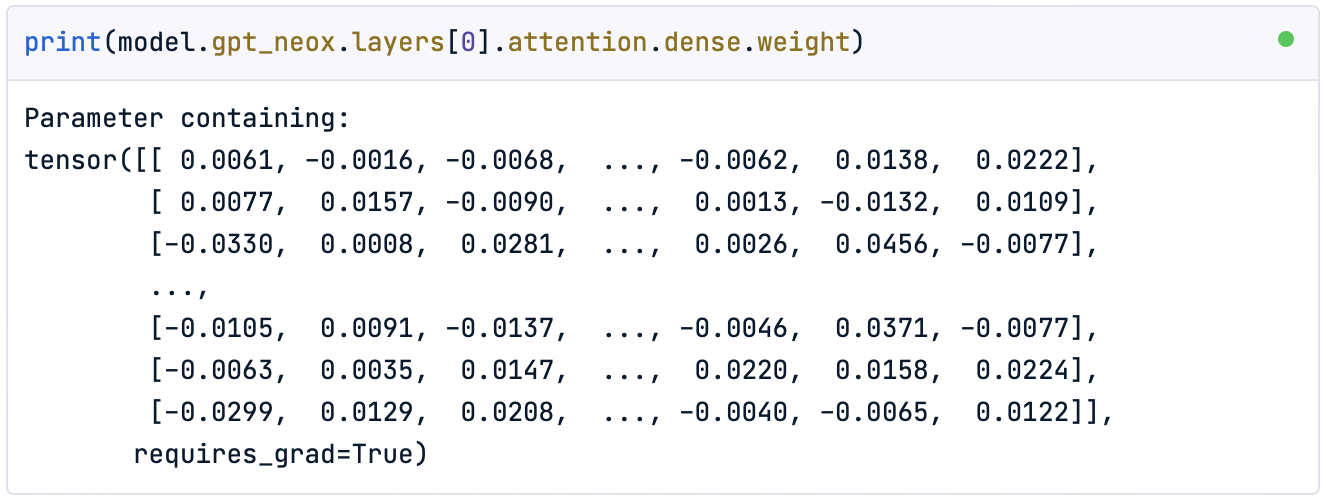
3. Geler (freeze). Pour appliquer effectivement la quantification aux poids, il faut utiliser la méthode freeze().
freeze(model)Cette méthode incorpore les paramètres de quantification dans le modèle, en convertissant effectivement les poids vers le type cible. Observons maintenant les paramètres du modèle quantifié :
print(model.gpt_neox.layers[0].attention.dense.weight)
On voit que les poids sont désormais dans la plage du type int8 de PyTorch.
4. Vérifications finales. Une fois le modèle quantifié, vérifions sa nouvelle taille réduite :
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")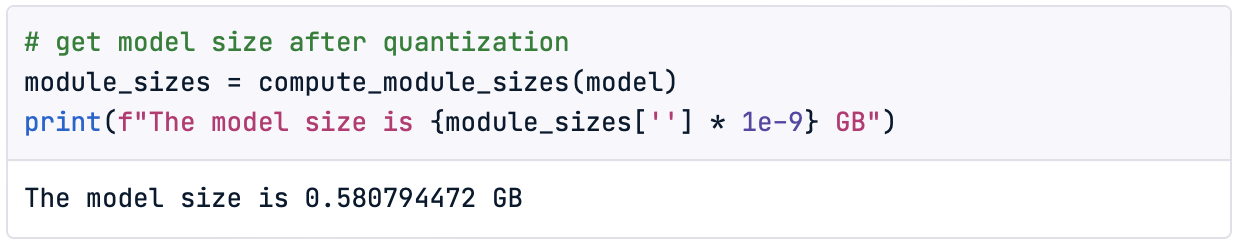
Nous avons obtenu un modèle qui ne représente plus que 35 % de la taille initiale !
Enfin, testons les performances du modèle avec une inférence simple :
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))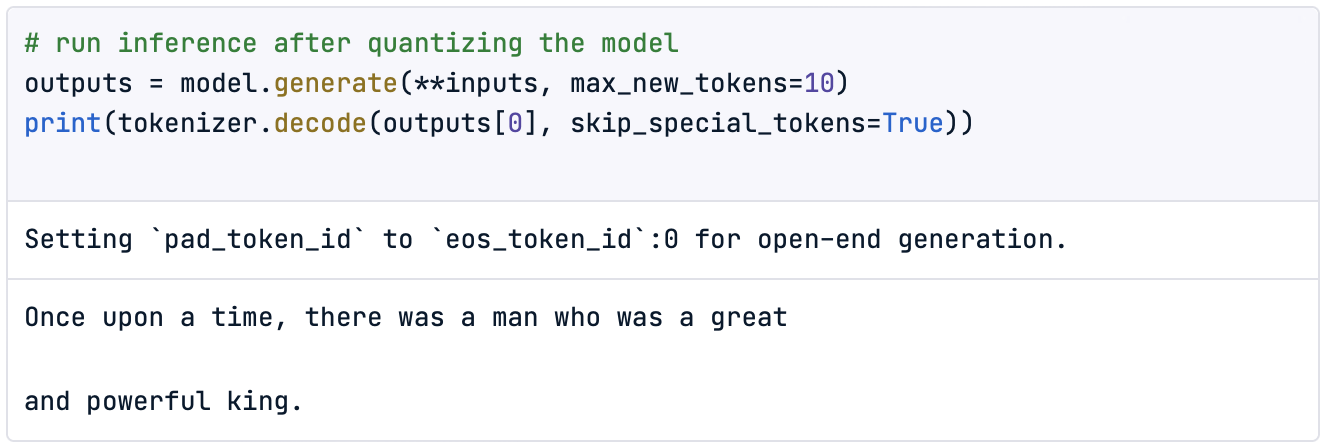
Bien sûr, une seule inférence n’est pas significative : il est recommandé de définir une évaluation quantitative.
À vous de jouer maintenant !
Les besoins croissants en mémoire des LLMs limitent leur entraînement comme leur hébergement pour l’inférence, ce qui restreint l’accessibilité et l’adoption des applications basées sur des LLMs.
Dans cet article, nous avons présenté la quantification, qui consiste à réduire la précision des poids et activations pour diminuer l’empreinte mémoire et les besoins de calcul. Ce procédé rend les modèles plus efficaces et accessibles, notamment pour des déploiements sur des appareils contraints en ressources.
Nous avons abordé la technique par des exemples d’arrondi des poids, puis présenté un type simple de quantification, le downcasting. Lors du downcasting, les paramètres sont convertis vers un type plus compact, comme bfloat16, pour l’inférence. Si cela permet de calculer et d’activer dans ce type plus petit, les performances diminuent généralement à mesure que le type se rétrécit, rendant l’approche inefficace avec des entiers comme int8.
Pour y remédier, nous avons introduit la quantification linéaire, qui préserve mieux les performances en reconvertissant en float32 lors de l’inférence. Cela permet d’utiliser des types encore plus petits, comme int8.
Nous avons parcouru les étapes numériques de la quantification linéaire et mis en œuvre la quantification des poids avec la bibliothèque Quanto de Hugging Face. Notamment, avec Quanto, nous pouvons quantifier n’importe quel modèle PyTorch, y compris ceux disponibles sur Hugging Face.
Si vous souhaitez essayer des modèles plus lourds comme LLaMa 2 ou Mistral, pensez à passer à l’offre premium de DataCamp pour bénéficier de plus de puissance de calcul.

Pour des modèles plus volumineux, il se peut que des ressources supplémentaires soient nécessaires, accessibles dans l’offre DataCamp Premium.
En maîtrisant les techniques de quantification, vous pouvez tirer tout le potentiel des grands modèles de langage en mobilisant moins de ressources, rendant l’IA avancée plus efficace, accessible et polyvalente.
J’espère que cet article vous donnera envie de passer à l’action sur la quantification des LLMs !
Les meilleurs cours sur les LLMs
Cours
Cursus
Cours