
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.9K
Heb je er ooit van gedroomd om je eigen ChatGPT rechtstreeks op je laptop te draaien?
Met de snelle vooruitgang in Large Language Models (LLM’s) komt de mogelijkheid om deze krachtige modellen naar consumentenhardware te brengen steeds dichterbij.
De sleutel om dit potentieel te ontsluiten ligt in kwantificatie, een techniek waarmee je de omvang van deze steeds grotere modellen kunt verkleinen, zodat ze op alledaagse apparaten draaien met minimale prestatieverlies — mits goed geïmplementeerd!
In deze gids duiken we in het concept van kwantificatie, leggen we uit hoe het werkt en welke mogelijkheden er zijn om LLM’s te kwantificeren. Tot slot kwantificeren we ons model in twee eenvoudige stappen met de Quanto-bibliotheek van Hugging Face.
Laten we erin duiken! Je kunt meekijken in de DataCamp DataLab.
Naarmate LLM’s zijn geëvolueerd, is hun complexiteit exponentieel toegenomen, wat leidde tot een sterke groei in het aantal parameters. Zo had het eerste GPT-model, gelanceerd in 2018, 0,11 miljard parameters. Eind 2019 breidde GPT-2 dit uit naar 1,5 miljard, en GPT-3, uitgebracht eind 2020, schoot omhoog naar 175 miljard parameters.
Tegenwoordig heeft GPT-4 meer dan 1 biljoen parameters. Deze enorme toename zorgt voor een uitdaging: naarmate modellen groeien, nemen ook hun geheugenvereisten toe, vaak voorbij de capaciteit van geavanceerde hardwareversnellers zoals GPU’s.
Die groeiende geheugenvraag beperkt zowel het trainen als het hosten van modellen voor inferentie, en remt daardoor de toegankelijkheid en adoptie van LLM-gebaseerde oplossingen.
Deze groei creëert een dringende behoefte om deze modellen toegankelijker te maken door hun omvang te verkleinen. Door de precisie van sommige componenten van het model te wijzigen, vermindert kwantificatie de geheugenvraag van het model, terwijl vergelijkbare prestatieniveaus behouden blijven.
Kwantificatie is een compressietechniek voor modellen die de gewichten en activaties binnen een large language model omzet van hoge naar lagere precisie. Dat betekent: data veranderen van een type dat meer informatie kan bevatten naar een type dat minder kan bevatten. Een typisch voorbeeld is het converteren van een 32-bit drijvende-kommagetal naar een 8-bit geheel getal.
Het verminderen van het aantal bits dat nodig is voor elk gewicht of elke activatie van het model leidt tot een aanzienlijke verkleining van de totale omvang. Daardoor zorgt kwantificatie ervoor dat LLM’s minder geheugen verbruiken, minder opslagruimte nodig hebben en energiezuiniger zijn.
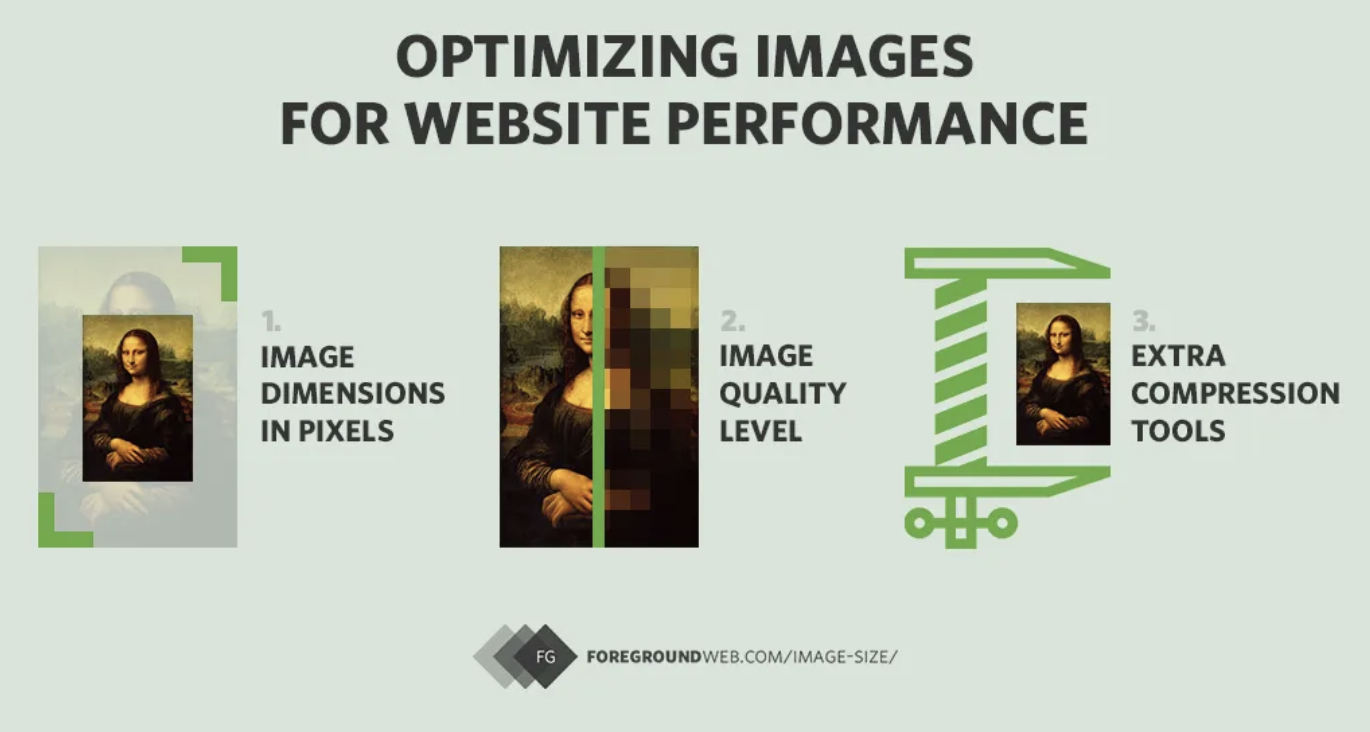
Een nuttige analogie om kwantificatie te begrijpen is beeldcompressie. Hoge-resolutieafbeeldingen worden vaak gecomprimeerd voor gebruik op websites. Dit houdt in dat de afbeeldingsgrootte wordt verkleind door wat data of bits informatie te verwijderen. Hoewel dit de beeldkwaliteit enigszins verlaagt, verkleint het ook de afmetingen en bestandsgrootte, waardoor webpagina’s sneller laden en toch een acceptabele visuele ervaring bieden.
Schema van beeldcompressie voor sneller laden in toepassingen zoals webpagina’s.
Op vergelijkbare wijze vermindert het kwantiseren van een LLM de rekeneisen, zodat het op minder krachtige hardware kan draaien en toch voldoende prestaties levert. Gecomprimeerde afbeeldingen zijn makkelijker te verwerken, net zoals gekwantiseerde modellen eenvoudiger op uiteenlopende platforms zijn uit te rollen—al is er wel een kleine trade-off in detail of precisie. Zoals we zullen zien, introduceert het kwantisatieproces ook wat ruis.
Kwantificatie wordt doorgaans toegepast op de gewichten van een large language model, al kan het ook op activaties worden toegepast. Modelgewichten zijn parameters in een neuraal netwerk die de sterkte van verbindingen tussen neuronen in verschillende lagen bepalen. Gewichten zijn in wezen de geleerde coëfficiënten die invoerdata transformeren terwijl die door het netwerk gaat.
Gewichten worden aanvankelijk ingesteld op willekeurige, betekenisloze waarden en tijdens het trainen aangepast op basis van de fout tussen de voorspelde output en de daadwerkelijke targets. Dit aanpassingsproces wordt gestuurd door optimalisatie-algoritmes zoals gradient descent.
Wil je meer weten over de interne werking van LLM’s? Dan is de cursus Developing Large Language Models iets voor jou!
Eén optie om een model te kwantiseren is de precisie van de modelgewichten te verlagen. Om dat te illustreren, focussen we op de matrix links in de onderstaande afbeelding, die een 3x3-matrix met gewichten met vier decimalen precisie weergeeft:
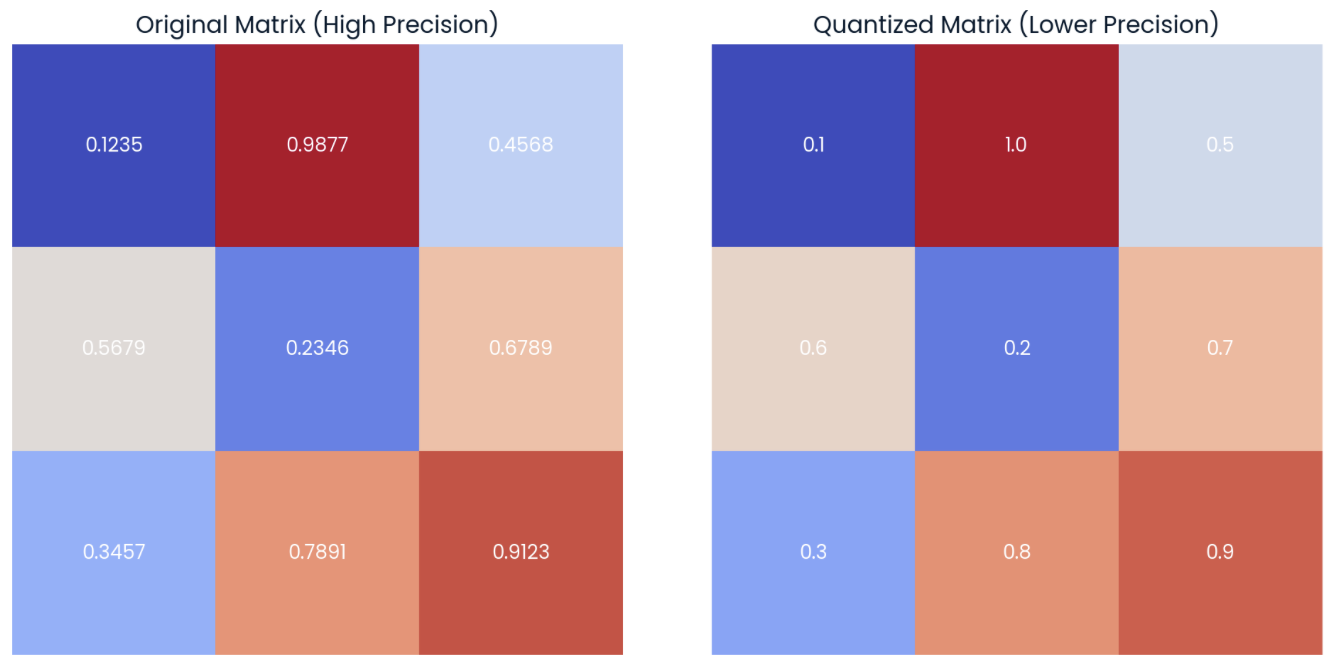
Voorbeeld van een willekeurige matrix met gewichten met vier decimalen precisie (links) en de gekwantiseerde vorm (rechts) door afronding naar één decimaal.
Op de matrix rechts zien we de gekwantiseerde versie van de oorspronkelijke matrix. Deze “gekwantiseerde” matrix is berekend door de elementen van de oorspronkelijke matrix af te ronden op één decimaal.
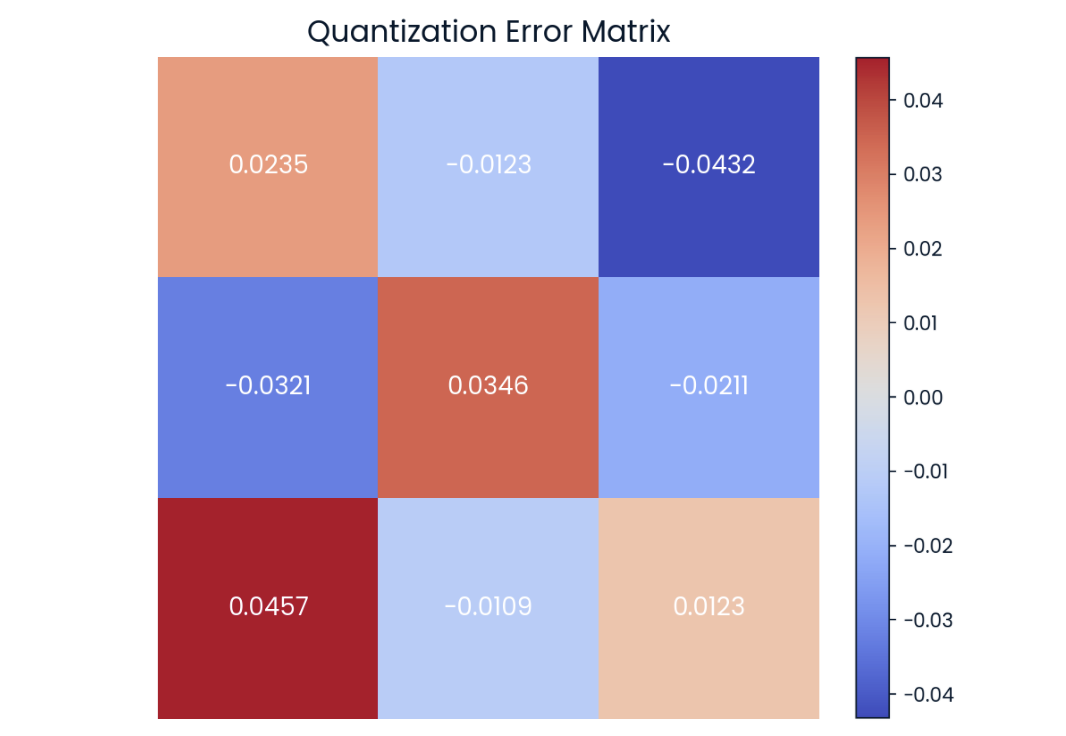
We zien dat de matrices hierboven niet volledig gelijk zijn, maar wel erg vergelijkbaar. Het verschil per waarde staat bekend als kwantisatiefout, die we ook in matrixvorm kunnen weergeven:
Kwantisatiefout in matrixvorm. Hoe donkerder de kleur, hoe groter de fout.
Huidig onderzoek naar kwantificatie richt zich erop dit verschil zo veel mogelijk te verkleinen om prestatieverlies te voorkomen.
In dit eenvoudige voorbeeld ronden we alleen de matrixelementen af. In de praktijk wordt kwantificatie uitgevoerd door numerieke waarden naar een ander datatype te converteren, bijvoorbeeld van een datatype met hogere naar lagere precisie. Het standaard datatype om data op te slaan in de meeste modellen is bijvoorbeeld float32.
In dat geval moeten we 4 bytes per parameter reserveren (4 keer 8-bit precisie). Voor een 3x3-matrix zoals in het voorbeeld bedraagt de totale geheugenvraag van deze matrix dus 36 bytes.
Door het datatype te wijzigen— ook wel downcasten genoemd— naar int8, hebben we nog maar één byte per parameter nodig. De totale geheugenvraag van de matrix wordt dan 9 bytes.
Het gekozen datatype voor de gewichten van het model bepaalt hoeveel we het model kunnen verkleinen. Traditionele drijvende-kommatypen, zoals float32 en float16, zijn de standaard in veel machinelearningtoepassingen en bieden een balans tussen nauwkeurigheid en rekenefficiëntie. Specifiek: terwijl float32 een hoge precisie en een groot dynamisch bereik biedt, vraagt het meer geheugen en rekenkracht. Daarentegen biedt float16 minder precisie en bereik, wat berekeningen aanzienlijk versnelt.
float32 en de efficiëntie van float16. Dit leidde tot de creatie van de zogeheten Brain Floating Point (bfloat16), dat het dynamisch bereik van float32 behoudt, maar met lagere precisie.
Downcasten is de formele term voor het omzetten van een datatype met hogere precisie naar een datatype met lagere precisie. Met downcasten verklein je de geheugenvraag en verhoog je de snelheid, omdat berekeningen met lagere precisie ook minder geheugen vereisen.
In deze sectie bekijken we hoe downcasten werkt van float32— het standaard opslagdatatype voor de meeste modellen— naar Google’s bfloat16, en we zien hoe dit doorgaans tot enig dataverlies leidt.
Laten we beginnen met het definiëren van een willekeurige tensor in PyTorch met elementen van het type float32 en de eerste vijf elementen weergeven:
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
We kunnen de tensor nu downcasten naar bfloat16 met de methode .to(dtype) en de eerste vijf nieuwe elementen bekijken:
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Zoals we zien liggen de waarden dicht bij elkaar, al zijn ze niet identiek. Het verschil wordt duidelijker wanneer we bewerkingen uitvoeren op de waarden. Bijvoorbeeld bij vermenigvuldiging van de oorspronkelijke tensor met zichzelf:
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Als we dezelfde berekening uitvoeren met de gekwantiseerde tensor, zien we dat het verschil groter is:
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
We zien een duidelijk verschil tussen de eindresultaten door foutpropagatie.
Datzelfde effect van foutpropagatie bij bewerkingen met gekwantiseerde tensors treedt op bij het downcasten van LLM’s en leidt tot informatieverlies. Zoals we zagen, impliceert minder geheugen gebruiken dat de berekening minder precies kan zijn. Het effect van vermenigvuldiging lijkt op de echte foutpropagatie, laag voor laag, die zich opstapelt en uiteindelijk sommige tokenvoorspellingen beïnvloedt.
Met downcasten blijven de prestaties acceptabel bij gebruik van het type bfloat16, maar dat geldt niet voor kleinere datatypes.
Downcasten wordt door deze beperking in datatypes niet vaak gebruikt als effectieve kwantisatietechniek. In plaats daarvan worden andere methoden gebruikt die prestaties dichter bij het oorspronkelijke model houden door tijdens inferentie terug te converteren naar float32.
Er zijn verschillende soorten kwantificatie, die we hieronder in detail beschrijven:
Lineaire kwantificatie is een van de populairste kwantisatieschema’s voor LLM’s. Simpel gezegd houdt het in dat het bereik van drijvende-kommawaarden van de oorspronkelijke gewichten gelijkmatig wordt afgebeeld op een bereik van fixed-point-waarden, terwijl voor inferentie het datatype met hoge precisie wordt gebruikt.
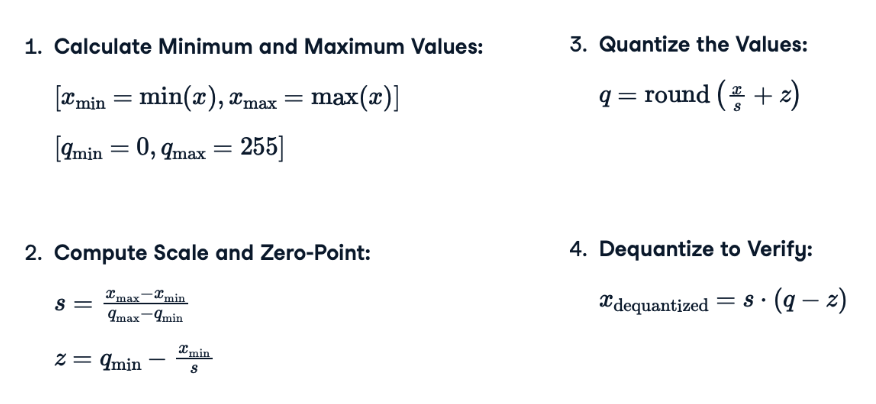
Om het zo eenvoudig mogelijk te maken, bekijken we de stappen om lineaire kwantificatie op een model toe te passen. Merk op dat de daadwerkelijke formules in de onderstaande afbeelding staan:
s) en de nul-offset (s): De schaal past het bereik van drijvende-kommawaarden aan zodat het in het integerbereik past. De nul-offset zorgt ervoor dat nul in het drijvende-kommabereik correct wordt weergegeven door een geheel getal, wat numerieke nauwkeurigheid en stabiliteit behoudt, vooral in de buurt van nul.q): Deze stap zet drijvende-kommawaarden om naar een integerbereik met lagere precisie met behulp van de in de vorige stap berekende schaal s en nul-offset s. De afronding zorgt ervoor dat het eindresultaat een discreet geheel getal is, geschikt voor opslag en berekening in formaten met lagere precisie.Laten we elke stap hierboven koppelen aan de bijbehorende formule:
Kwantisatieformules voor het toepassen van lineaire kwantificatie op elke gewichtsmatrix.
Vind je het lastig om je voor te stellen hoe je deze formules toepast? Aan de slag dan!
Als we deze formules toepassen op de 3x3 gewichtstensor links in de onderstaande afbeelding, krijgen we de gekwantiseerde matrix rechts. Ik raad je aan om een paar minuten te nemen om de maximum- en minimumwaarden van het gekwantiseerde bereik en enkele gekwantiseerde waarden te berekenen:
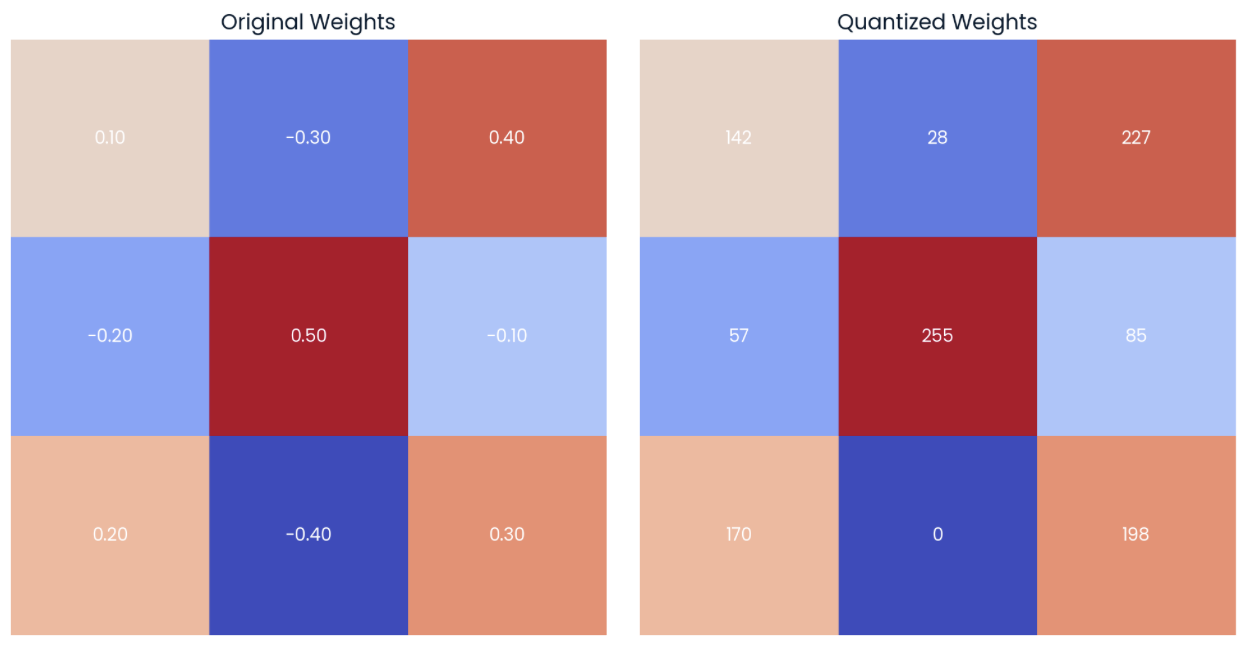
Voorbeeld van een willekeurige gewichtsmatrix met twee decimalen precisie (links) met de gekwantiseerde vorm (rechts) naar het int8-datatype.
We zien dat de ondergrens van de int8-waarde overeenkomt met de laagste waarde van de oorspronkelijke tensor (-0.40 → 0), terwijl de bovengrens overeenkomt met de hoogste waarde van de oorspronkelijke tensor (0.50 → 255).
Als we de waarden nu de-kwantiseren met formule (4), zien we dat de gede-kwantiseerde waarden dicht bij de oorspronkelijke waarden liggen (matrix links). We kunnen de kwantisatiefout berekenen door het punt-voor-puntverschil te bepalen (matrix rechts):
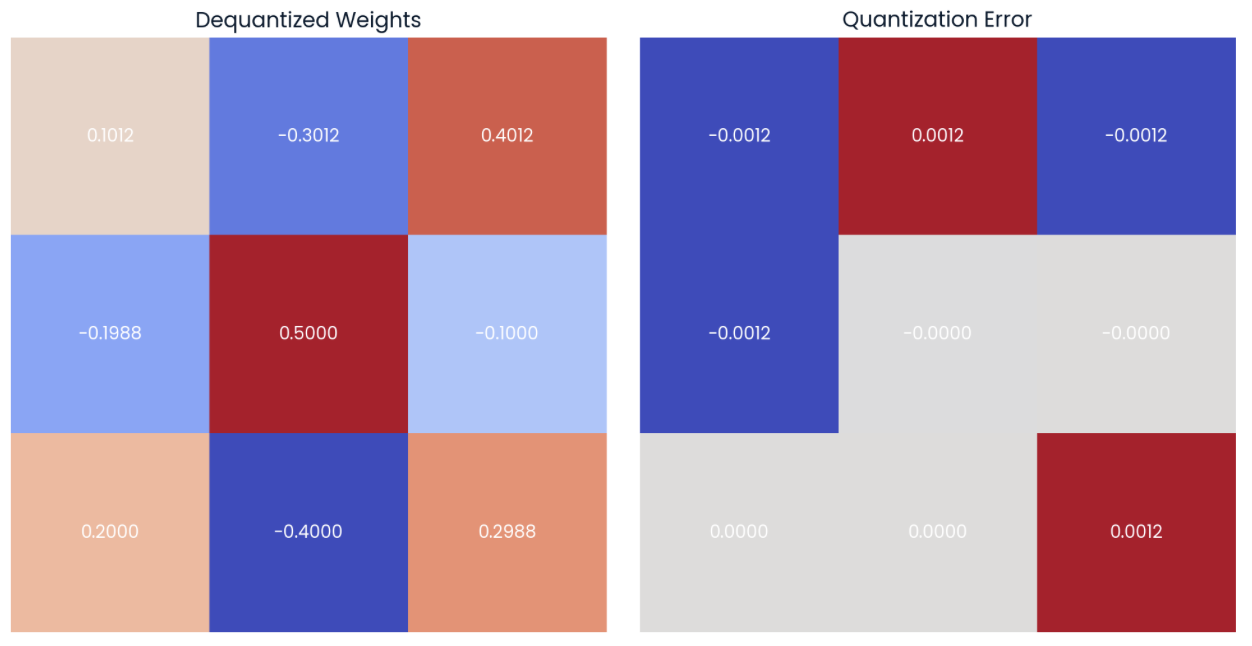
Waarden kunnen gede-kwantiseerd worden met de gekwantiseerde gewichten en de schaal- en nul-offsetwaarden (links). Het punt-voor-puntverschil of de kwantisatiefout kan worden berekend (rechts).
Lineaire kwantificatie verkleint de modelomvang door alleen de gekwantiseerde gewichten en de schaal- en nul-offsetwaarden in het geheugen op te slaan, terwijl deze worden gebruikt om de oorspronkelijke gewichten voor inferentie te berekenen en de prestaties te behouden.
Lineaire kwantificatie is populair vanwege de eenvoud, maar er zijn meerdere manieren om een mapping te bouwen. Een andere methode die tegenwoordig veel wordt gebruikt is blockwise-kwantificatie, die nauwkeuriger is dan lineaire kwantificatie voor modellen met niet-uniforme gewichtsverdelingen.
Blockwise-kwantificatie is een meer verfijnde methode waarbij gewichten in kleinere blokken worden gekwantiseerd in plaats van over het hele bereik. Deze methode steunt op twee kernconcepten:
In onze matrixvoorbeelden hebben we vooral gefocust op het kwantiseren van de gewichten van een model. Hoewel gewichtskwantificatie cruciaal is voor modeloptimalisatie, is het ook belangrijk te beseffen dat de activaties van een model eveneens gekwantiseerd kunnen worden.
Activatiekwantificatie verwijst naar het verlagen van de precisie van de tussenliggende outputs van elke laag in het netwerk. In tegenstelling tot gewichten, die statisch (constant) zijn zodra het model is getraind, zijn activaties dynamisch. Dat betekent dat activaties veranderen met elke invoer in het netwerk, waardoor hun bereik lastiger te voorspellen is.
In het algemeen is activatiekwantificatie lastiger te implementeren dan gewichtskwantificatie. Het vereist zorgvuldige calibratie om ervoor te zorgen dat het dynamisch bereik van activaties goed wordt vastgelegd.
Gewichtskwantificatie en activatiekwantificatie zijn complementaire technieken. Door beide toe te passen, kunnen we de modelomvang aanzienlijk verkleinen zonder de prestaties al te veel aan te tasten.
Kwantificatie kan ook op verschillende momenten plaatsvinden. Als we een voorgetraind model nemen en de modelparameters tijdens de inferentiefase kwantiseren, voeren we Post-Training Quantization (PTQ) uit.
Deze methode brengt geen wijzigingen aan in het trainingsproces zelf. Het dynamisch bereik van parameters wordt tijdens runtime opnieuw berekend, vergelijkbaar met hoe we met de voorbeeldmatrices hebben gewerkt.
Daarnaast kun je Quantization-Aware Training (QAT) toepassen. Deze aanpak wijzigt het trainingsproces om de effecten van kwantificatie tijdens het trainen te simuleren. Het model wordt getraind om robuust te zijn tegen kwantisatieruis, wat resulteert in een betere nauwkeurigheid.
Tijdens QAT houden de tussentoestanden van de training zowel een gekwantiseerde versie van de gewichten als de oorspronkelijke ongekwantiseerde gewichten vast (ook in het geheugen!). We gebruiken dus de gekwantiseerde versie van het model voor inferentie, maar de ongekwantiseerde versie van de gewichten wordt tijdens backpropagation bijgewerkt.
Zoals verwacht levert QAT over het algemeen hogere nauwkeurigheid op dan PTQ, al is het complexer en tijdrovender.
Sommige kwantisatiemethoden vereisen een calibratiestap. Zo moeten we vóór kwantificatie het oorspronkelijke activatiebereik van een model bepalen. Algemene calibratie houdt meestal in dat je inferentie draait op een representatieve dataset om de kwantisatieparameters te optimaliseren en de kwantisatiefout te minimaliseren.
Tijdens dit calibratieproces verzamelt het kwantisatie-algoritme statistieken over de verdeling en het bereik van de activaties en gewichten van het model. Deze statistieken helpen bij het bepalen van de beste kwantisatieparameters. Het berekenen van de schaal en de nul-offset bij het kwantiseren van de gewichten is ook een vorm van calibratie, maar er zijn andere typen:
Methoden zoals QLoRA kunnen echter zonder enige calibratiestap worden gebruikt.
Deze methoden vervangen doorgaans alle lineaire lagen in het model door gekwantiseerde lineaire lagen (QLinear). QLinear-lagen zijn zo ontworpen dat ze de kwantificatie intern afhandelen, waardoor een extra calibratiestap niet nodig is. Dit maakt het kwantisatieproces eenvoudiger te implementeren, terwijl de prestaties van het model behouden blijven.
Er zijn verschillende tools en bibliotheken in Python die kwantificatie ondersteunen, voor zowel PTQ als QAT. Zo bieden pytorch en tensorflow kwantisatiemethoden, al vereist een naadloze integratie in bestaande modellen een diep begrip van de bibliotheken en de interne werking van modellen. Zie kwantisatie-opties in de officiële PyTorch-documentatie.
Als je die krachtige frameworks wilt leren, raad ik de cursus Deep Learning in Python aan.
Mijn favoriete optie om kwantificatie in een paar eenvoudige stappen te implementeren is tot nu toe de Quanto-bibliotheek van Hugging Face, die het kwantisatieproces voor PyTorch-modellen vereenvoudigt.
Een typische kwantisatieworkflow met de Quanto-bibliotheek van Hugging Face bestaat uit de volgende stappen:
1. Kies en laad een voorgetraind model en de bijbehorende tokenizer. In dit geval gebruiken we het Pythia 410M-model van EuletherAI:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
De methode model.gpt_neox kan helpen om de verschillende lagen van het geladen model te visualiseren:
print(model.gpt_neox)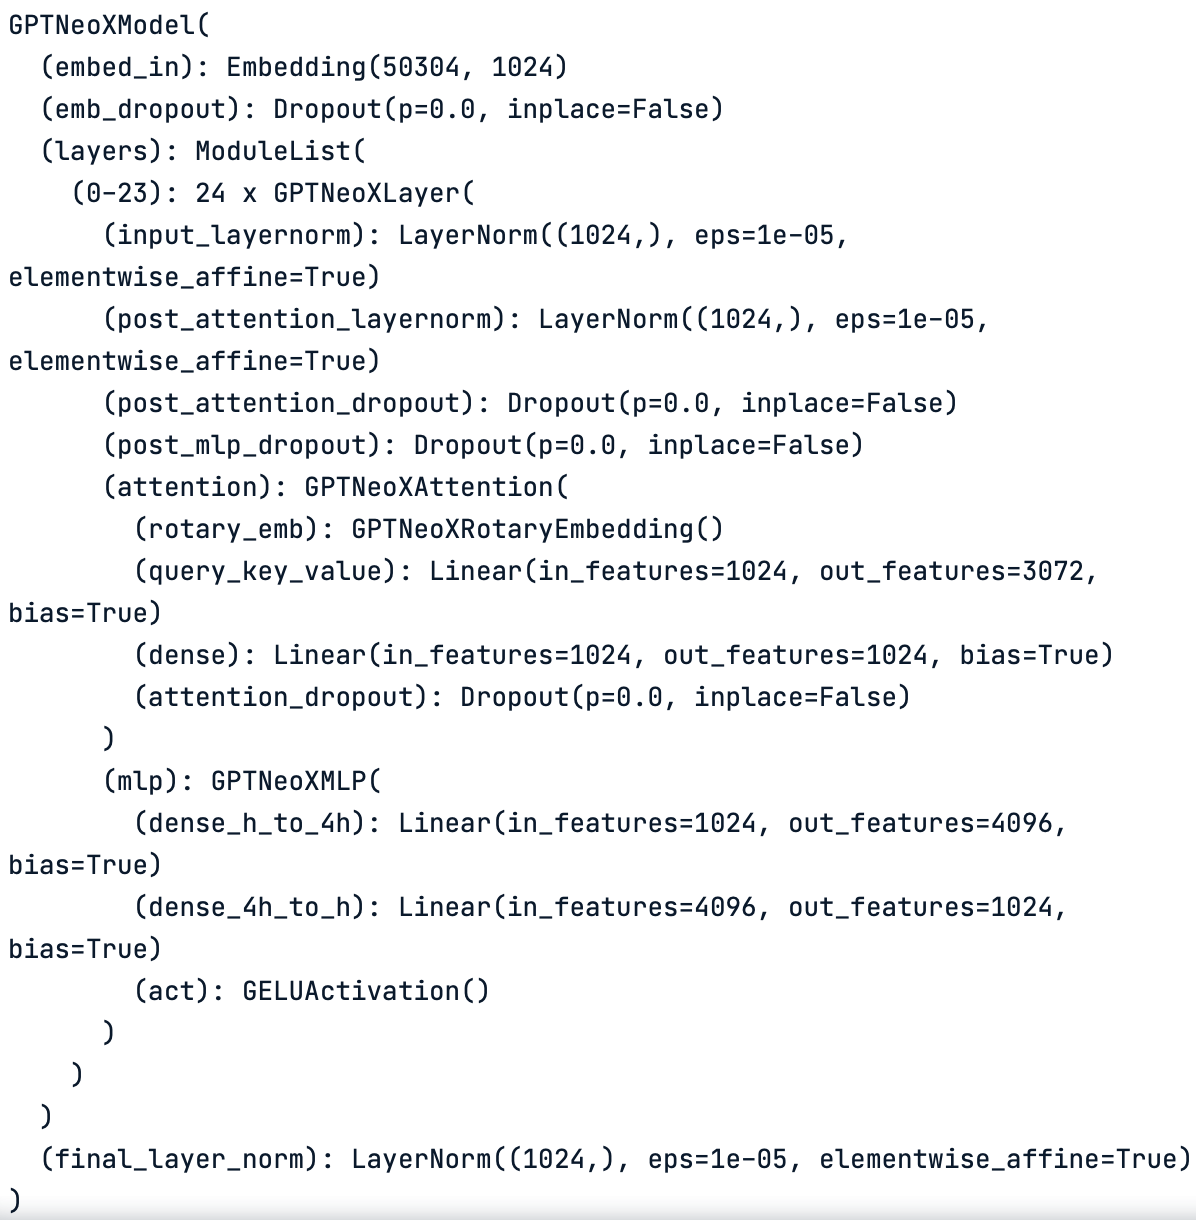
Laag-voor-laag-schema van het oorspronkelijke model. Het model bestaat uit verschillende soorten lagen, zoals lineaire lagen en normalisatielagen.
We kunnen controleren of het model correct werkt door enkele test-inferenties te draaien. Bijvoorbeeld,
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))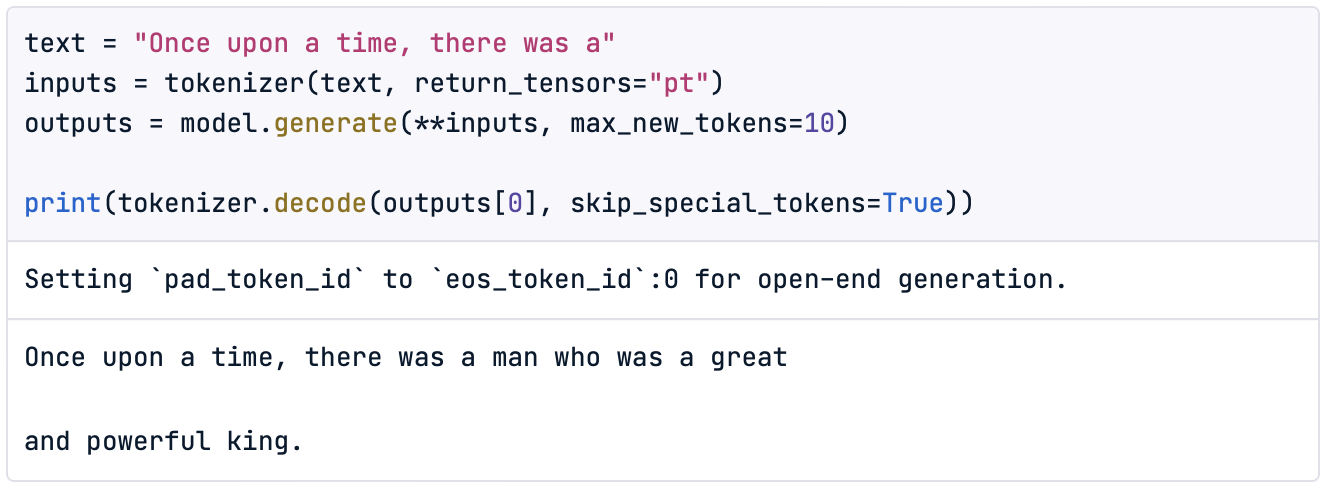
Daarnaast is het, omdat we het model gaan kwantiseren om de omvang te verkleinen, interessant om de oorspronkelijke modelgrootte te controleren voordat we beginnen:
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")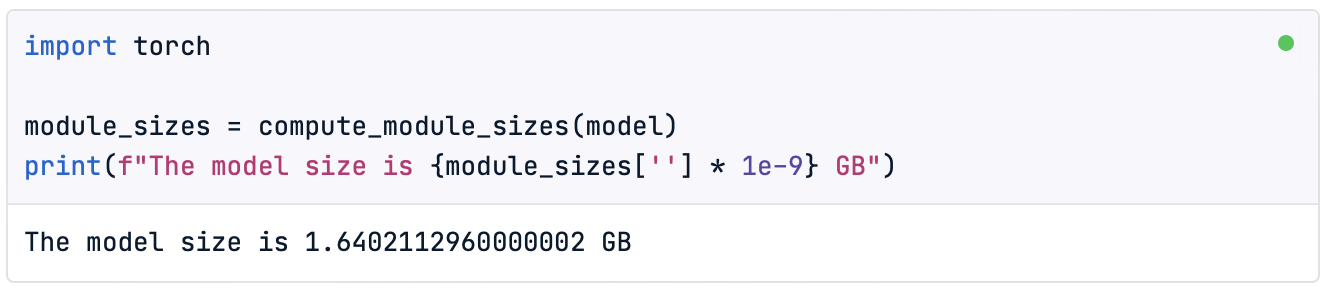
Let op: In de DataCamp DataLab vind je de geïmplementeerde methode compute_module_sizes().
Tot slot kunnen we de dichte tensors van het oorspronkelijke model als volgt visualiseren:
print(model.gpt_neox.layers[0].attention.dense.weight)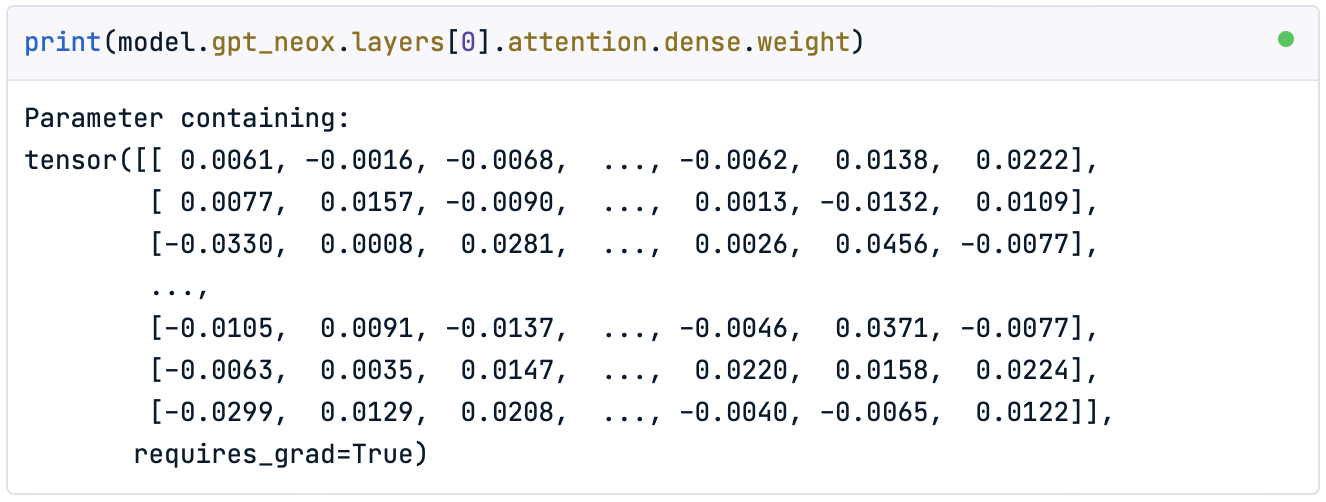
Zoals we zien, lijkt dit op de ongekwantiseerde matrix waar we in dit artikel mee hebben gewerkt.
2. Kwantiseren. Met de methode quantize() kun je het standaard model met floats direct omzetten naar een gekwantiseerd model.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
In dit geval kwantiseren we alleen de gewichten van het model naar een int8-datatype. Deze methode zet het model om naar rekenen met lagere precisie, inclusief de calibratiestap.
Als we nu de lagen van het model printen, zien we dat de oorspronkelijke lineaire lagen (Linear) zijn vervangen door gekwantiseerde lineaire lagen (QLinear):
print(model)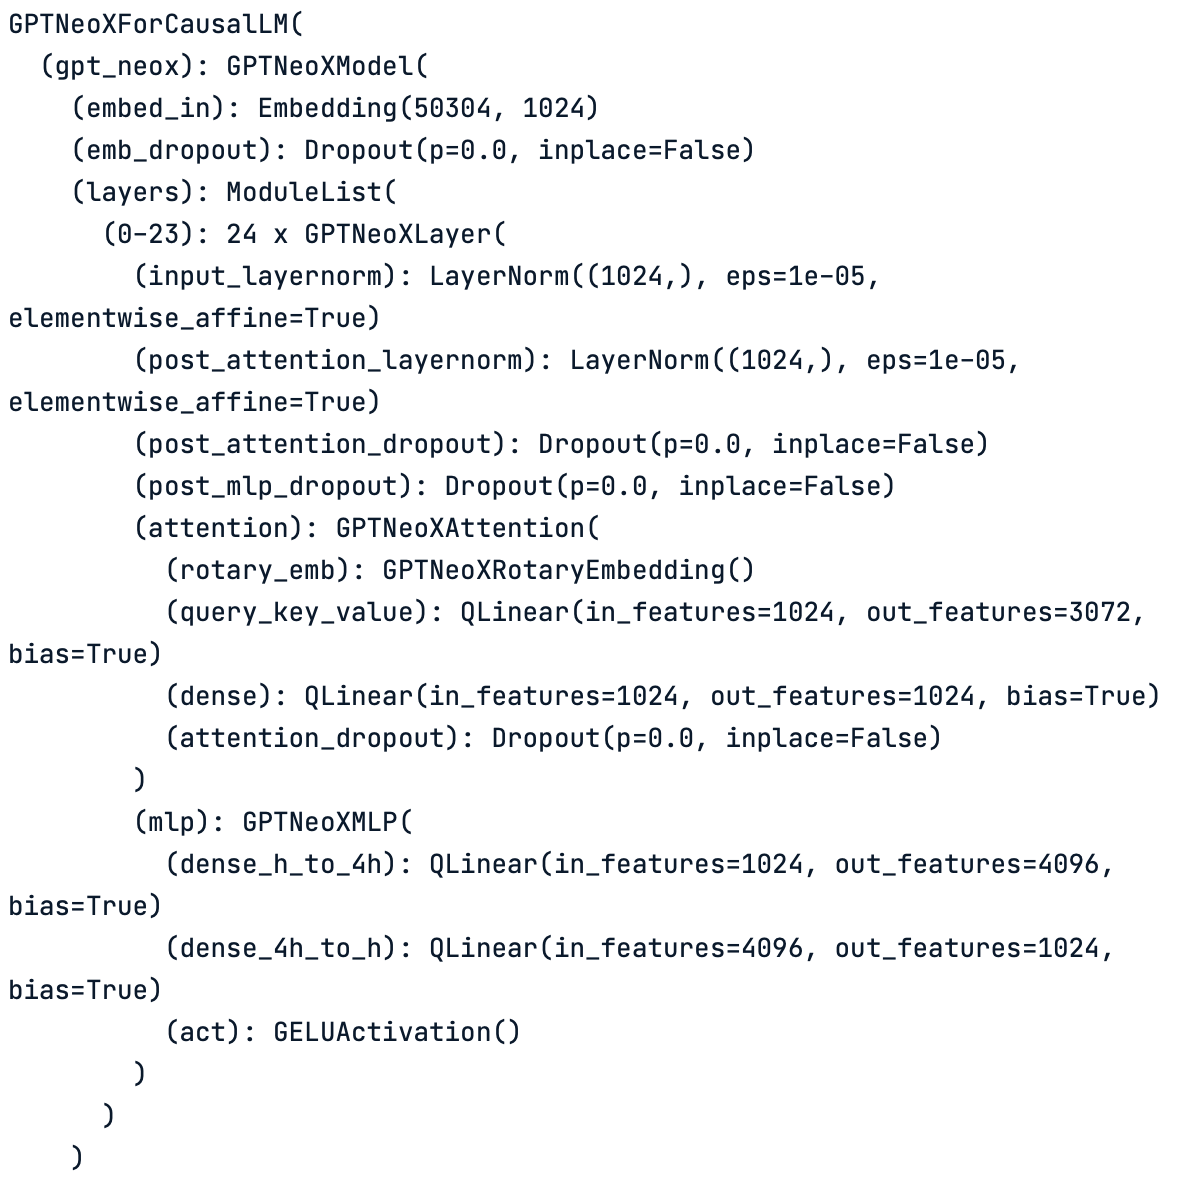
Laag-voor-laag-schema van het gekwantiseerde model. Let op hoe alle oorspronkelijke lineaire lagen zijn veranderd in gekwantiseerde lineaire lagen (QLinear).
Als we echter de gewichtsmatrix printen, zien we dat ze nog niet zijn omgezet:
print(model.gpt_neox.layers[0].attention.dense.weight)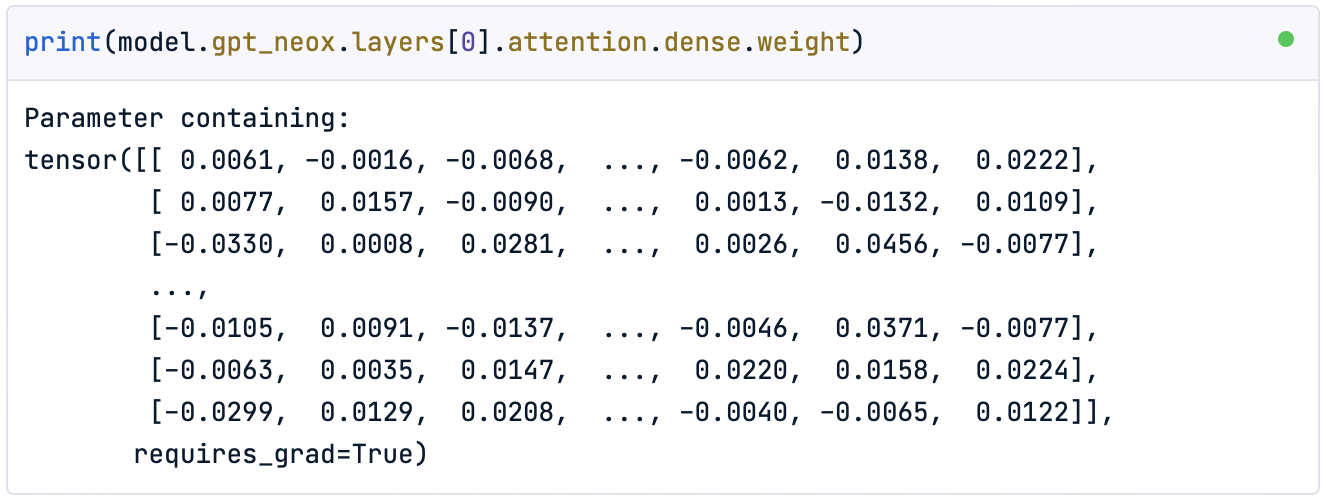
3. Bevriezen. Om het kwantisatie-effect op de gewichten toe te passen, gebruiken we de methode freeze().
freeze(model)Deze methode embedt de kwantisatieparameters in het model en zet de gewichten effectief om naar het doeldatatype. Laten we nu de gekwantiseerde modelparameters bekijken:
print(model.gpt_neox.layers[0].attention.dense.weight)
Zoals we zien, liggen de gewichten nu binnen het bereik van het PyTorch-int8-datatype.
4. Laatste controles. Zodra het model is gekwantiseerd, kunnen we de nieuwe, verkleinde modelgrootte controleren:
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")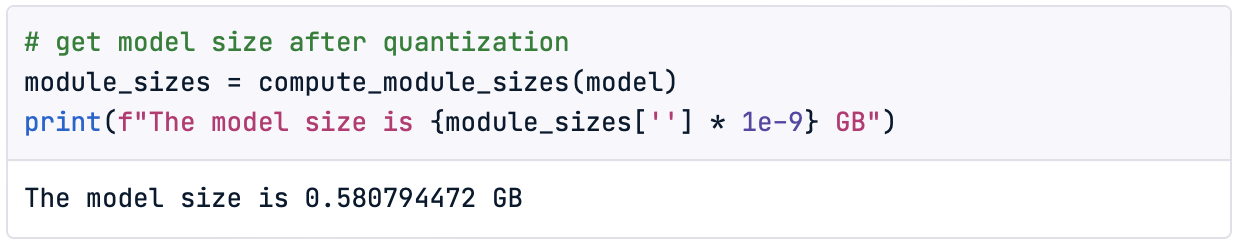
We hebben een model bereikt dat slechts 35% van de oorspronkelijke grootte is!
Controleer tot slot de nieuwe prestaties van het model met een eenvoudige inferentie:
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))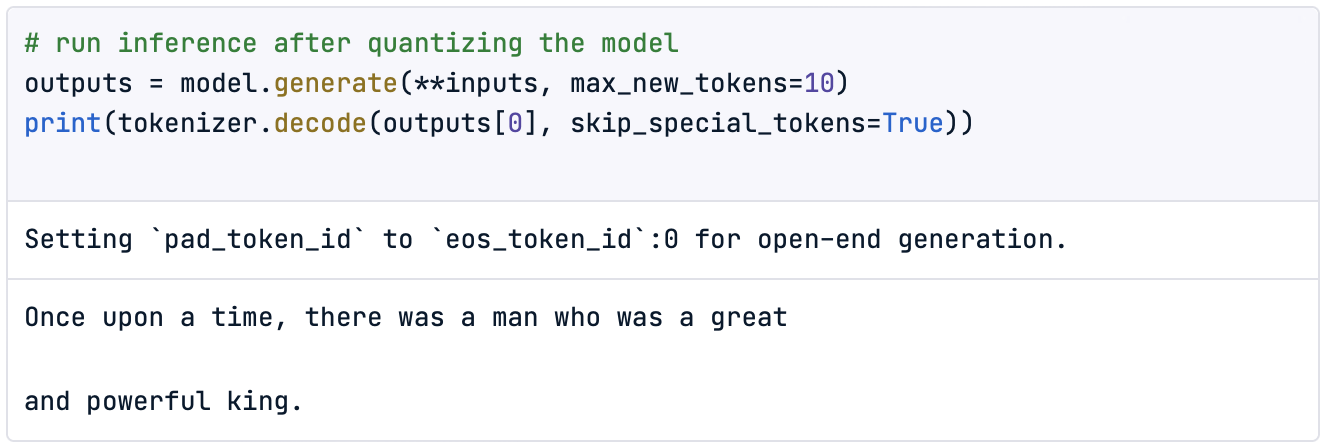
Natuurlijk zegt één enkele inferentie weinig; het is daarom goed om een kwantitatieve methode te definiëren om de prestaties te beoordelen.
Nu ben jij aan de beurt!
De toenemende geheugenvraag van LLM’s beperkt zowel hun training als hosting voor inferentie, en remt zo de toegankelijkheid en adoptie van LLM-gebaseerde applicaties.
In dit artikel hebben we het concept van kwantificatie geïntroduceerd, waarbij de precisie van de gewichten en activaties van het model wordt verlaagd om de geheugenvraag en rekeneisen te verminderen. Dit proces helpt modellen efficiënter en toegankelijker te maken, met name voor implementatie op apparaten met beperkte middelen.
We hebben deze techniek benaderd met enkele voorbeelden, door de numerieke waarden van de gewichten af te ronden. Vervolgens gingen we verder naar een eenvoudige vorm van kwantificatie, bekend als downcasten. Bij het downcasten van een model worden parameters geconverteerd naar een compacter datatype, zoals bfloat16, voor inferentie. Hoewel dit het model in staat stelt om berekeningen en activaties in dit kleinere datatype uit te voeren, verslechteren de prestaties doorgaans naarmate het datatype kleiner wordt; het is ineffectief met integer-typen zoals int8.
Om dit aan te pakken, hebben we lineaire kwantificatie geïntroduceerd, die de prestaties dichter bij het oorspronkelijke model houdt door tijdens inferentie terug te converteren naar float32. Dit maakt het mogelijk om nog kleinere datatypes te gebruiken, zoals int8.
We liepen de numerieke stappen door voor het toepassen van lineaire kwantificatie en implementeerden onze gewichtskwantificatie met de Quanto-bibliotheek van Hugging Face. Opvallend is dat we met de Quanto-bibliotheek elk PyTorch-model kunnen kwantiseren, inclusief de modellen die beschikbaar zijn op Hugging Face.
Voor wie zwaardere modellen zoals LLaMa 2 of Mistral willen proberen: overweeg je DataCamp-omgeving te upgraden naar premium voor meer rekenkracht.

Voor grotere modellen hebben we mogelijk extra resources nodig die beschikbaar zijn in het DataCamp Premium-abonnement.
Door kwantisatietechnieken te beheersen, kunnen we het volledige potentieel van Large Language Models ontgrendelen met minder middelen, waardoor geavanceerde AI efficiënter, toegankelijker en veelzijdiger wordt.
Ik hoop dat dit artikel je helpt om praktisch aan de slag te gaan met kwantificatie voor LLM’s!
Topcursussen over LLM’s
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

