
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.9K
Bạn đã từng mơ chạy một ChatGPT "của riêng bạn" trực tiếp trên laptop chưa?
Với tốc độ phát triển nhanh của các Mô hình Ngôn ngữ Lớn (LLM), khả năng đưa các mô hình mạnh mẽ đó lên phần cứng tiêu dùng đang dần trở thành hiện thực.
Chìa khóa để mở ra tiềm năng này nằm ở lượng tử hóa, một kỹ thuật cho phép giảm kích thước các mô hình ngày càng lớn để chạy trên thiết bị hằng ngày với suy giảm hiệu năng tối thiểu — nếu được triển khai đúng cách!
Trong hướng dẫn này, chúng ta sẽ đi sâu vào khái niệm lượng tử hóa, giải thích cách hoạt động và các khả năng khác nhau để lượng tử hóa LLM. Cuối cùng, chúng ta sẽ lượng tử hóa mô hình của mình trong hai bước đơn giản bằng thư viện Quanto của Hugging Face.
Cùng bắt đầu thôi! Bạn có thể làm theo bằng DataCamp DataLab.
Khi LLM phát triển, độ phức tạp của chúng tăng theo cấp số nhân, dẫn đến sự gia tăng đáng kể về số lượng tham số. Chẳng hạn, mô hình GPT đầu tiên ra mắt năm 2018 có 0,11 tỷ tham số. Cuối năm 2019, GPT-2 mở rộng lên 1,5 tỷ, và GPT-3 phát hành cuối 2020 vọt lên 175 tỷ tham số.
Ngày nay, GPT-4 có hơn 1 nghìn tỷ tham số. Mức tăng lớn này đặt ra thách thức: khi mô hình phình to, yêu cầu bộ nhớ cũng tăng theo, thường vượt quá khả năng của các bộ tăng tốc phần cứng tiên tiến như GPU.
Nhu cầu bộ nhớ tăng này hạn chế cả việc huấn luyện lẫn lưu trữ để suy luận, từ đó hạn chế khả năng tiếp cận và áp dụng các giải pháp dựa trên LLM.
Sự tăng trưởng này dẫn tới nhu cầu cấp bách phải làm cho các mô hình trở nên dễ tiếp cận hơn bằng cách giảm kích thước. Bằng cách thay đổi độ chính xác của một số thành phần trong mô hình, lượng tử hóa giảm dấu chân bộ nhớ của mô hình trong khi vẫn duy trì mức hiệu năng tương tự.
Lượng tử hóa là một kỹ thuật nén mô hình chuyển các trọng số và kích hoạt bên trong một mô hình ngôn ngữ lớn từ các giá trị độ chính xác cao sang độ chính xác thấp hơn. Điều này có nghĩa là chuyển kiểu dữ liệu có thể chứa nhiều thông tin sang kiểu chứa ít hơn. Ví dụ điển hình là chuyển dữ liệu từ số thực 32-bit sang số nguyên 8-bit.
Giảm số bit cần cho mỗi trọng số hoặc kích hoạt của mô hình dẫn đến giảm đáng kể kích thước tổng thể. Theo đó, lượng tử hóa làm mô hình LLM tiêu thụ ít bộ nhớ hơn, cần ít dung lượng lưu trữ hơn và tiết kiệm năng lượng hơn.
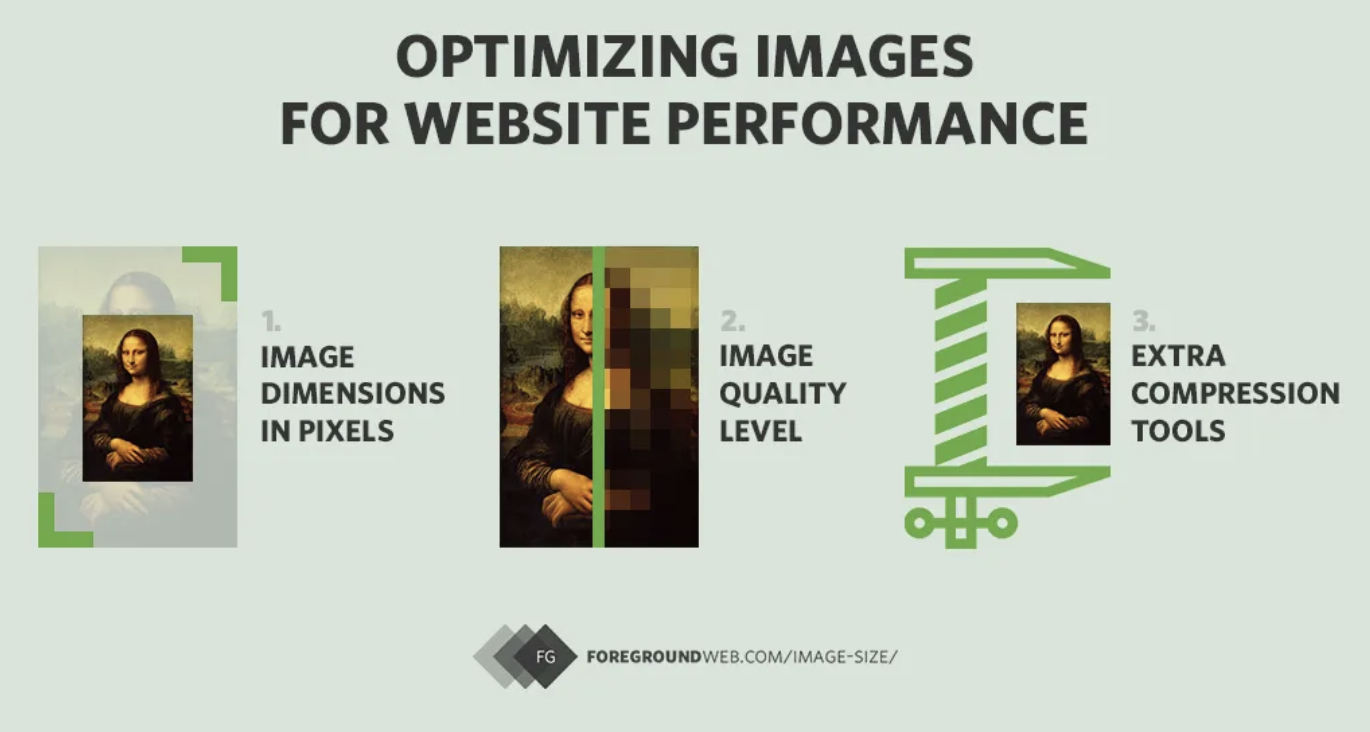
Một phép so sánh hiệu quả để hiểu lượng tử hóa là nén ảnh. Ảnh độ phân giải cao thường được nén khi dùng trên website. Điều này liên quan đến việc giảm kích thước ảnh bằng cách loại bỏ một số dữ liệu hay bit thông tin. Dù thường làm giảm chất lượng ảnh ở mức nào đó, nó cũng làm giảm kích thước và dung lượng tệp, giúp trang web tải nhanh hơn trong khi vẫn mang lại trải nghiệm thị giác chấp nhận được.
Sơ đồ nén ảnh để tải nhanh hơn trong các ứng dụng như trang web.
Tương tự, lượng tử hóa một LLM làm giảm yêu cầu tính toán, cho phép chạy trên phần cứng kém mạnh hơn trong khi vẫn mang lại hiệu năng đủ tốt. Ảnh nén dễ xử lý hơn, cũng như mô hình đã lượng tử hóa dễ triển khai hơn trên nhiều nền tảng, dù có đánh đổi nhẹ về chi tiết hay độ chính xác. Như chúng ta sẽ thấy, quá trình lượng tử hóa cũng đưa vào một chút nhiễu.
Lượng tử hóa thường được áp dụng lên trọng số của mô hình ngôn ngữ lớn, dù cũng có thể áp dụng cho kích hoạt. Trọng số là các tham số trong một mạng nơ-ron quyết định độ mạnh của kết nối giữa các nơ-ron ở các tầng khác nhau. Về bản chất, trọng số là các hệ số đã học, biến đổi dữ liệu đầu vào khi đi qua mạng.
Ban đầu trọng số được khởi tạo ngẫu nhiên, vô nghĩa và được điều chỉnh trong quá trình huấn luyện dựa trên sai số giữa đầu ra dự đoán và mục tiêu thực. Quá trình điều chỉnh này được dẫn dắt bởi các thuật toán tối ưu hóa như gradient descent.
Nếu bạn muốn tìm hiểu sâu hơn về nội bộ của LLM, khóa học Developing Large Language Models là dành cho bạn!
Một cách để lượng tử hóa mô hình là giảm độ chính xác của trọng số. Để minh họa, hãy tập trung vào ma trận bên trái trong hình dưới, biểu diễn ma trận trọng số 3x3 với độ chính xác bốn chữ số thập phân:
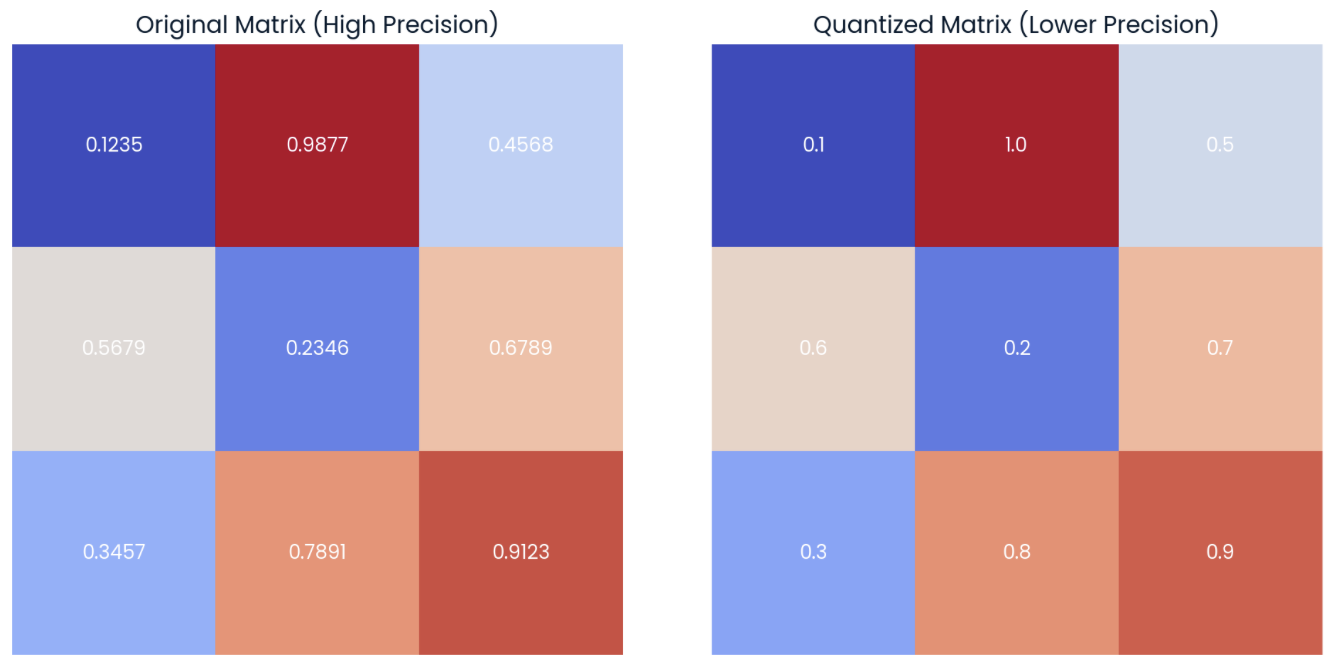
Ví dụ ma trận trọng số ngẫu nhiên có độ chính xác bốn chữ số thập phân (trái) và dạng đã lượng tử hóa (phải) bằng cách làm tròn đến một chữ số thập phân.
Ở ma trận bên phải, ta thấy phiên bản đã lượng tử hóa của ma trận gốc. Ma trận “đã lượng tử hóa” này được tính bằng cách làm tròn các phần tử của ma trận gốc đến một chữ số thập phân.
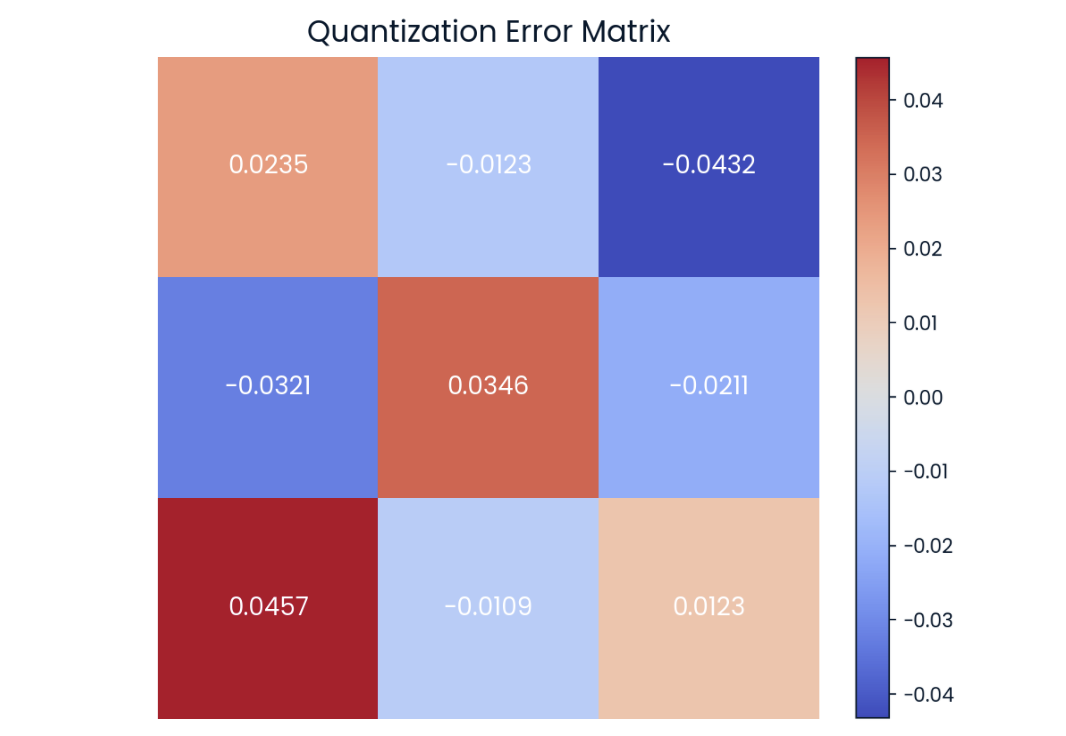
Ta có thể thấy hai ma trận không hoàn toàn giống hệt nhau nhưng rất tương tự. Sai khác theo từng giá trị được gọi là lỗi lượng tử hóa, có thể biểu diễn dưới dạng ma trận:
Lỗi lượng tử hóa ở dạng ma trận. Màu càng đậm, lỗi càng lớn.
Nghiên cứu hiện nay về lượng tử hóa tập trung vào việc cố gắng giảm sai khác này tối đa để tránh suy giảm hiệu năng.
Trong ví dụ đơn giản này, ta chỉ làm tròn phần tử ma trận. Trên thực tế, lượng tử hóa được thực hiện bằng cách chuyển đổi giá trị số sang kiểu dữ liệu khác, ví dụ từ kiểu độ chính xác cao sang thấp hơn. Chẳng hạn, kiểu lưu trữ mặc định cho hầu hết mô hình là float32.
Trong trường hợp này, ta cần cấp phát 4 byte cho mỗi tham số (4 lần độ chính xác 8-bit). Do đó, với ma trận 3x3 như ví dụ, tổng dung lượng bộ nhớ là 36 byte.
Bằng cách đổi kiểu dữ liệu — còn gọi là downcasting — sang int8, ta chỉ cần một byte cho mỗi tham số. Như vậy, tổng dung lượng của ma trận còn 9 byte.
Kiểu dữ liệu được chọn cho trọng số mô hình quyết định mức chúng ta có thể giảm mô hình. Các kiểu số thực truyền thống như float32 và float16 đã là tiêu chuẩn trong nhiều ứng dụng máy học, cân bằng giữa độ chính xác và hiệu quả tính toán. Cụ thể, float32 cung cấp độ chính xác và dải động rộng nhưng cần nhiều bộ nhớ và công suất tính toán hơn. Ngược lại, float16 có độ chính xác và dải nhỏ hơn, giúp tăng tốc tính toán đáng kể.
float32 và hiệu quả của float16. Điều này dẫn đến sự ra đời của định dạng Brain Floating Point (bfloat16), giữ nguyên dải động của float32 nhưng với độ chính xác giảm.
Downcasting là thuật ngữ chính thức chỉ việc chuyển kiểu dữ liệu độ chính xác cao sang kiểu có độ chính xác thấp hơn. Bằng cách downcast, ta giảm dấu chân bộ nhớ và tăng tốc độ vì phép tính với độ chính xác thấp hơn cũng cần ít bộ nhớ hơn.
Trong phần này, ta sẽ xem downcasting hoạt động như thế nào từ float32 — kiểu lưu trữ mặc định của đa số mô hình — sang bfloat16 của Google, và quan sát việc nó thường gây mất mát dữ liệu nhất định.
Hãy bắt đầu bằng cách định nghĩa một tensor ngẫu nhiên trong PyTorch với phần tử kiểu float32 và hiển thị 5 phần tử đầu tiên:
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
Giờ ta có thể downcast tensor sang bfloat16 bằng phương thức .to(dtype) và quan sát 5 phần tử đầu:
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Như ta thấy, các giá trị khá gần nhau, dù không trùng khít. Sai khác trở nên rõ hơn khi bắt đầu thực hiện phép toán. Ví dụ, khi nhân tensor gốc với chính nó:
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Nếu thực hiện cùng phép tính với tensor đã lượng tử hóa, ta thấy sai khác lớn hơn:
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
Ta có thể quan sát sự khác biệt rõ ràng giữa kết quả cuối cùng do lan truyền lỗi.
Hiệu ứng lan truyền lỗi tương tự khi thao tác với các tensor đã lượng tử hóa cũng xảy ra khi downcast LLM, dẫn đến mất mát thông tin. Như đã thấy, dùng ít bộ nhớ hơn đồng nghĩa phép tính có thể kém chính xác hơn. Hiệu ứng của phép nhân tương tự việc lỗi thực tế lan truyền qua từng tầng, tích lũy và cuối cùng ảnh hưởng đến một số dự đoán token.
Với downcasting, hiệu năng vẫn chấp nhận được khi sử dụng kiểu bfloat16, nhưng không còn đúng với các kiểu nhỏ hơn.
Downcasting không thường được dùng như một kỹ thuật lượng tử hóa hiệu quả do hạn chế về kiểu dữ liệu. Thay vào đó, người ta dùng các phương pháp khác giữ hiệu năng gần với mô hình gốc bằng cách chuyển về float32 trong lúc suy luận.
Có một số loại lượng tử hóa, chúng tôi mô tả chi tiết dưới đây:
Lượng tử hóa tuyến tính là một trong những lược đồ phổ biến nhất cho LLM. Nói đơn giản, nó ánh xạ đều dải giá trị số thực của trọng số gốc sang dải giá trị điểm cố định, và dùng kiểu dữ liệu độ chính xác cao cho suy luận.
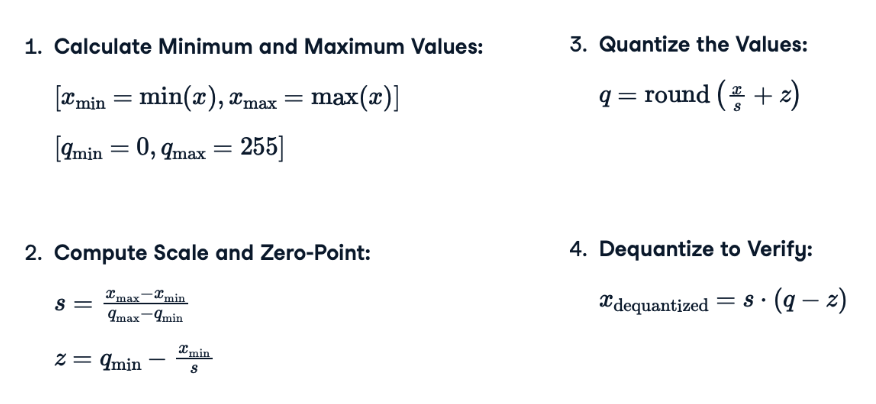
Để đơn giản nhất có thể, hãy điểm lại các bước cần để áp dụng lượng tử hóa tuyến tính cho một mô hình. Lưu ý công thức thực tế được hiển thị trong hình dưới:
s) và điểm không (s): Hệ số tỉ lệ điều chỉnh dải giá trị số thực để khớp trong dải số nguyên. Điểm không đảm bảo rằng số 0 trong dải số thực được biểu diễn chính xác bằng một số nguyên, duy trì độ chính xác và ổn định số, đặc biệt với các giá trị gần 0.q): Bước này ánh xạ giá trị số thực sang dải số nguyên có độ chính xác thấp hơn bằng hệ số tỉ lệ s và điểm không s đã tính ở bước trước. Phép làm tròn đảm bảo kết quả cuối là số nguyên rời rạc, phù hợp lưu trữ và tính toán ở định dạng độ chính xác thấp.Hãy gắn mỗi bước ở trên với công thức tương ứng:
Các phương trình lượng tử hóa dùng để áp dụng lượng tử hóa tuyến tính cho mọi ma trận trọng số.
Khó hình dung cách áp dụng các công thức này? Hãy thực hành!
Nếu áp dụng các công thức này cho tensor trọng số 3x3 ở bên trái hình dưới, ta sẽ nhận được ma trận đã lượng tử hóa ở bên phải. Tôi khuyến nghị dành vài phút để tính các giá trị cực đại và cực tiểu của dải đã lượng tử và một vài giá trị đã lượng tử:
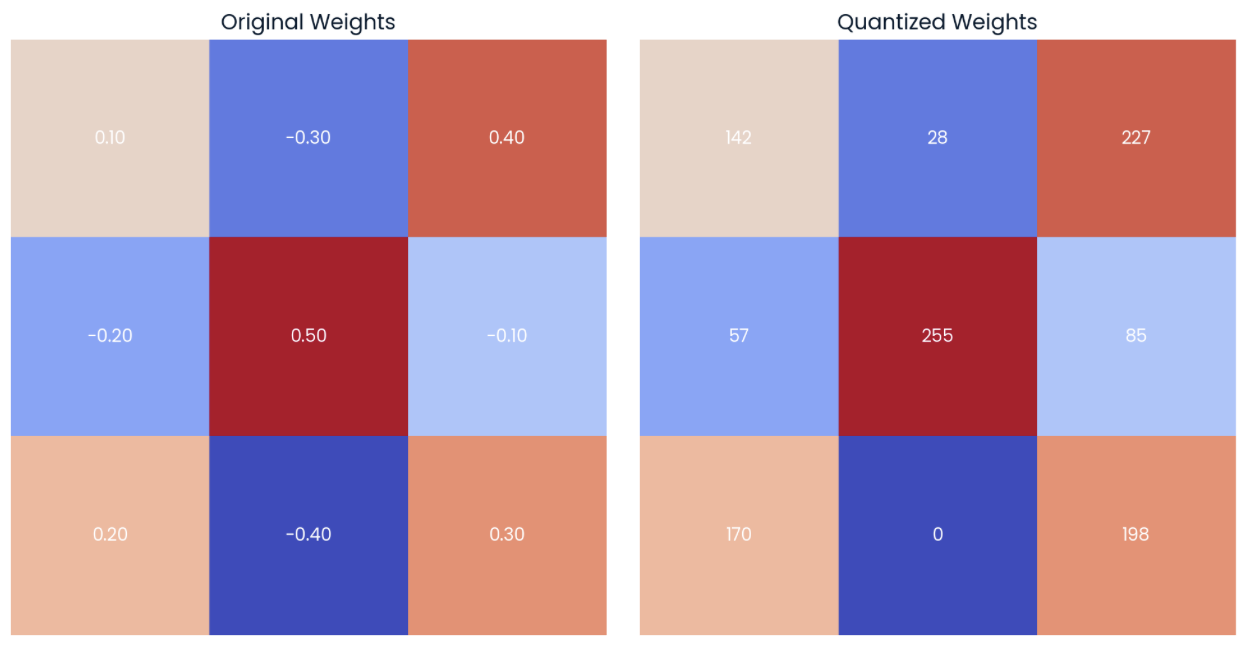
Ví dụ ma trận trọng số ngẫu nhiên có độ chính xác hai chữ số thập phân (trái) và dạng đã lượng tử hóa (phải) sang kiểu dữ liệu int8.
Ta thấy cận dưới của giá trị int8 tương ứng với giá trị thấp nhất của tensor gốc (-0.40 → 0), trong khi cận trên tương ứng với giá trị cao nhất của tensor gốc (0.50 → 255).
Nếu giờ ta giải lượng tử các giá trị bằng công thức (4), có thể thấy các giá trị đã giải lượng tử gần với giá trị gốc (ma trận bên trái). Ta có thể tính lỗi lượng tử hóa bằng cách lấy sai khác điểm-điểm (ma trận bên phải):
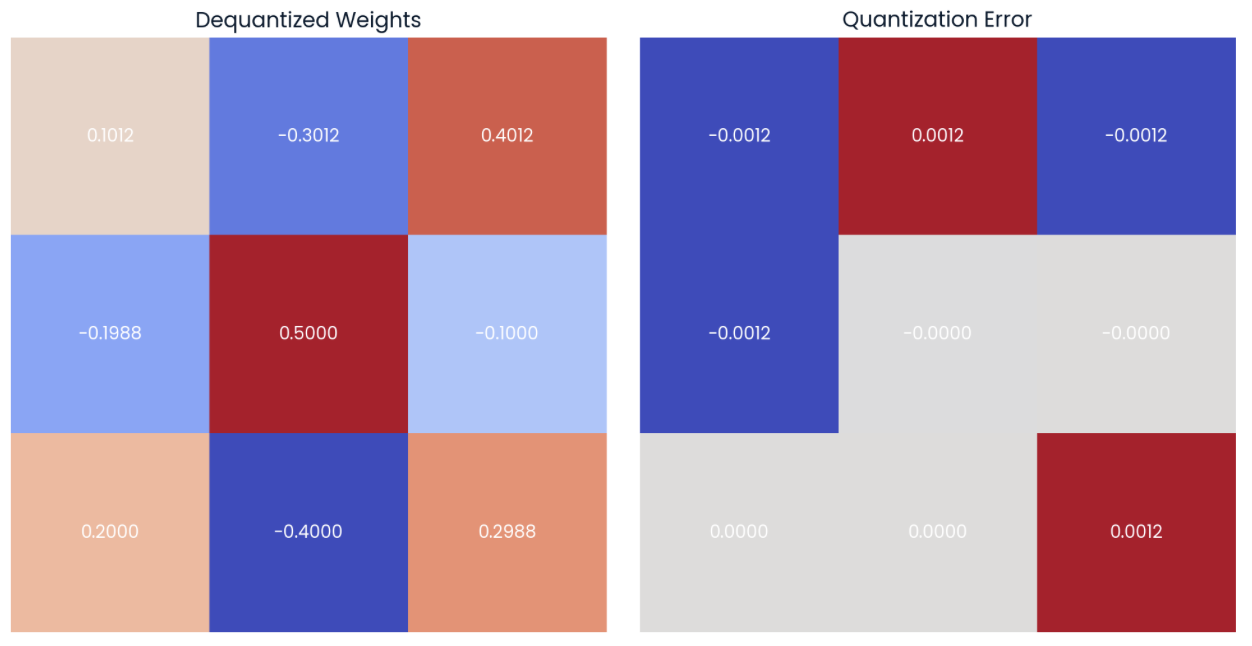
Có thể giải lượng tử các giá trị bằng trọng số đã lượng tử và hệ số tỉ lệ, điểm không (trái). Có thể tính sai khác điểm-điểm hay lỗi lượng tử hóa (phải).
Lượng tử hóa tuyến tính giảm kích thước mô hình bằng cách chỉ lưu trọng số đã lượng tử cùng các giá trị hệ số tỉ lệ và điểm không trong bộ nhớ, đồng thời dùng chúng để tính lại trọng số gốc khi suy luận nhằm duy trì hiệu năng.
Lượng tử hóa tuyến tính phổ biến nhờ sự đơn giản, nhưng có nhiều cách xây dựng ánh xạ. Một phương pháp khá phổ biến hiện nay là lượng tử hóa theo khối, chính xác hơn lượng tử hóa tuyến tính với các mô hình có phân bố trọng số không đồng nhất.
Lượng tử hóa theo khối là phương pháp tinh vi hơn, lượng tử hóa trọng số theo các khối nhỏ thay vì trên toàn dải. Phương pháp này dựa trên hai khái niệm then chốt:
Trong các ví dụ ma trận, chúng ta chủ yếu tập trung vào quá trình lượng tử hóa trọng số của mô hình. Dù lượng tử hóa trọng số là bước quan trọng để tối ưu mô hình, cũng cần lưu ý rằng kích hoạt của mô hình cũng có thể được lượng tử hóa.
Lượng tử hóa kích hoạt là quá trình giảm độ chính xác của đầu ra trung gian của mỗi tầng trong mạng. Khác với trọng số vốn tĩnh (cố định) sau khi huấn luyện, kích hoạt là động. Điều này có nghĩa là kích hoạt thay đổi theo từng đầu vào của mạng, khiến dải của chúng khó dự đoán.
Nhìn chung, lượng tử hóa kích hoạt khó triển khai hơn lượng tử hóa trọng số. Nó đòi hỏi hiệu chuẩn cẩn thận để đảm bảo dải động của kích hoạt được nắm bắt tốt.
Lượng tử hóa trọng số và lượng tử hóa kích hoạt là các kỹ thuật bổ trợ. Bằng cách áp dụng cả hai, ta có thể cải thiện đáng kể kích thước mô hình mà không làm giảm hiệu năng quá nhiều.
Lượng tử hóa cũng có thể thực hiện ở các thời điểm khác nhau. Nếu ta lấy một mô hình đã huấn luyện và lượng tử hóa tham số của nó trong giai đoạn suy luận, ta đang thực hiện Lượng tử hóa Sau Huấn luyện (PTQ).
Phương pháp này không liên quan đến bất kỳ thay đổi nào trong quá trình huấn luyện. Dải động của các tham số được tính lại lúc chạy, tương tự cách chúng ta làm với các ma trận ví dụ.
Mặt khác, cũng có lựa chọn áp dụng Huấn luyện Nhận biết Lượng tử (QAT). Cách tiếp cận này sửa đổi quá trình huấn luyện để mô phỏng hiệu ứng lượng tử hóa trong khi huấn luyện. Mô hình được huấn luyện để trở nên bền bỉ trước nhiễu lượng tử, từ đó đạt độ chính xác tốt hơn.
Trong QAT, các trạng thái trung gian của quá trình huấn luyện giữ cả phiên bản trọng số đã lượng tử và trọng số gốc chưa lượng tử (cũng ở trong bộ nhớ!). Vì vậy, ta dùng phiên bản đã lượng tử của mô hình để suy luận, nhưng phiên bản trọng số chưa lượng tử sẽ được cập nhật trong backpropagation.
Như mong đợi, dù phức tạp và tốn thời gian hơn, QAT thường mang lại độ chính xác cao hơn so với PTQ.
Một số phương pháp lượng tử hóa yêu cầu bước hiệu chuẩn. Ví dụ, ta phải xác định dải kích hoạt gốc của mô hình trước khi lượng tử hóa. Hiệu chuẩn tổng quát thường bao gồm chạy suy luận trên một tập dữ liệu đại diện để tối ưu tham số lượng tử hóa và giảm thiểu lỗi lượng tử hóa.
Trong quá trình hiệu chuẩn, thuật toán lượng tử hóa thu thập thống kê về phân bố và dải của kích hoạt và trọng số của mô hình. Các thống kê này giúp xác định tham số lượng tử hóa tốt nhất. Việc tính hệ số tỉ lệ và điểm không khi lượng tử hóa trọng số cũng là một dạng hiệu chuẩn, nhưng còn có các kiểu khác:
Tuy nhiên, các phương pháp lượng tử hóa như QLoRA có thể dùng mà không cần bước hiệu chuẩn nào.
Các phương pháp này thường thay thế tất cả các tầng tuyến tính trong mô hình bằng các tầng tuyến tính đã lượng tử (QLinear). Các tầng QLinear được thiết kế để xử lý lượng tử hóa nội bộ, nhờ đó không cần bước hiệu chuẩn bổ sung. Điều này làm cho quá trình lượng tử hóa dễ triển khai hơn trong khi vẫn duy trì hiệu năng của mô hình.
Nhiều công cụ và thư viện Python hỗ trợ lượng tử hóa, cung cấp công cụ cho cả PTQ và QAT. Ví dụ, pytorch và tensorflow cung cấp các phương pháp lượng tử hóa, dù tích hợp trơn tru lượng tử hóa vào mô hình hiện có đòi hỏi hiểu sâu về thư viện và nội tại mô hình. Xem các tùy chọn lượng tử hóa trong tài liệu chính thức của PyTorch.
Nếu bạn muốn học các framework mạnh mẽ đó, tôi gợi ý khóa học Deep Learning in Python.
Lựa chọn ưa thích của tôi để triển khai lượng tử hóa theo các bước dễ dàng hiện nay là thư viện Quanto của Hugging Face, được thiết kế để đơn giản hóa quá trình lượng tử hóa cho các mô hình PyTorch.
Một quy trình lượng tử hóa điển hình sử dụng thư viện Quanto của Hugging Face gồm các bước sau:
1. Chọn và tải một mô hình tiền huấn luyện và tokenizer tương ứng. Ở đây, chúng ta sẽ dùng mô hình Pythia 410M từ EuletherAI:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Phương thức model.gpt_neox có thể giúp trực quan hóa các tầng khác nhau của mô hình đã tải:
print(model.gpt_neox)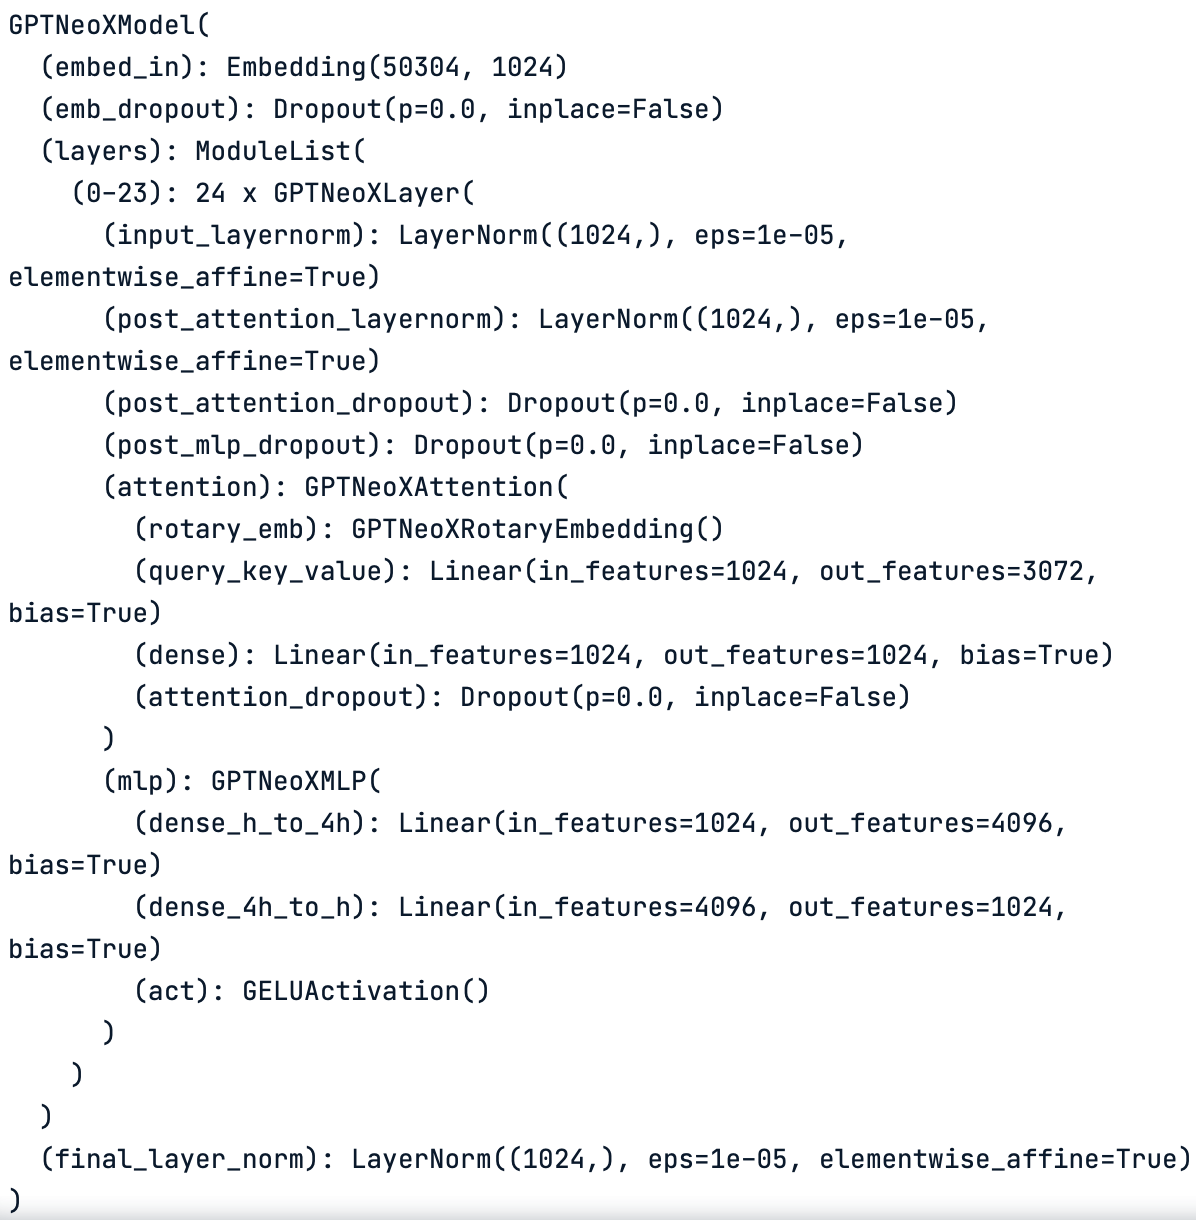
Sơ đồ theo tầng của mô hình gốc. Mô hình gồm nhiều loại tầng như tầng tuyến tính và tầng chuẩn hóa.
Chúng ta có thể kiểm tra mô hình hoạt động ổn bằng cách chạy một vài suy luận thử. Ví dụ,
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))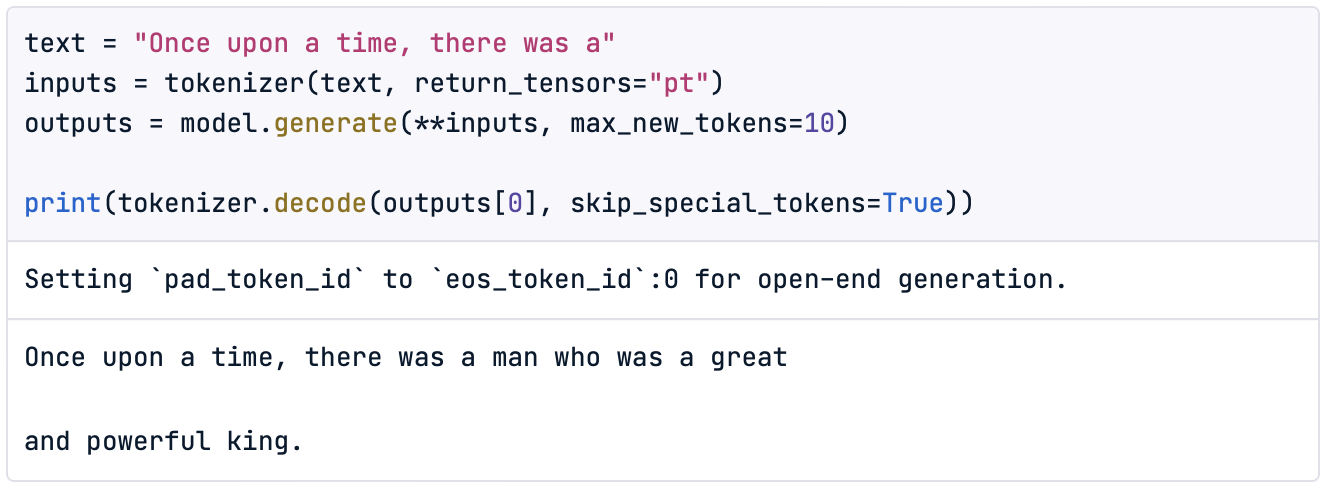
Ngoài ra, vì lượng tử hóa mô hình sẽ giúp giảm kích thước, cũng đáng để kiểm tra kích thước gốc trước khi bắt đầu:
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")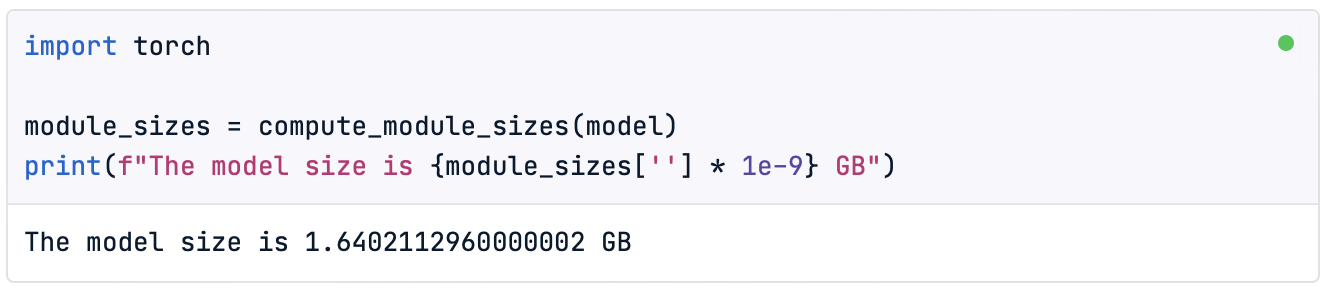
Lưu ý: Trên DataCamp DataLab ta có thể tìm thấy phương thức compute_module_sizes() đã được hiện thực.
Cuối cùng, ta cũng có thể trực quan hóa các tensor dày đặc của mô hình gốc như sau:
print(model.gpt_neox.layers[0].attention.dense.weight)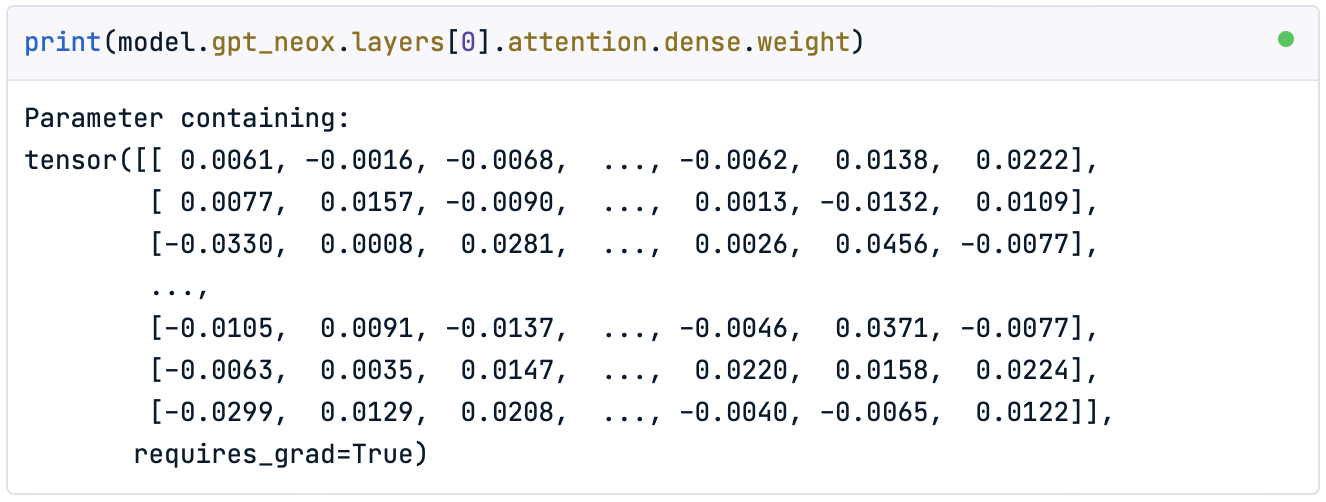
Như có thể quan sát, nó giống với ma trận chưa lượng tử mà ta đã làm việc trong bài viết này.
2. Lượng tử hóa. Phương thức quantize() cho phép chuyển mô hình float chuẩn mặc định sang mô hình đã lượng tử ngay lập tức.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
Trong trường hợp này, ta chỉ lượng tử hóa trọng số của mô hình sang kiểu dữ liệu int8. Phương thức này chuyển mô hình sang dùng số học độ chính xác thấp hơn, bao gồm cả bước hiệu chuẩn.
Nếu giờ in các tầng của mô hình, ta sẽ thấy các tầng tuyến tính gốc (Linear) đã được thay bằng các tầng tuyến tính đã lượng tử (QLinear):
print(model)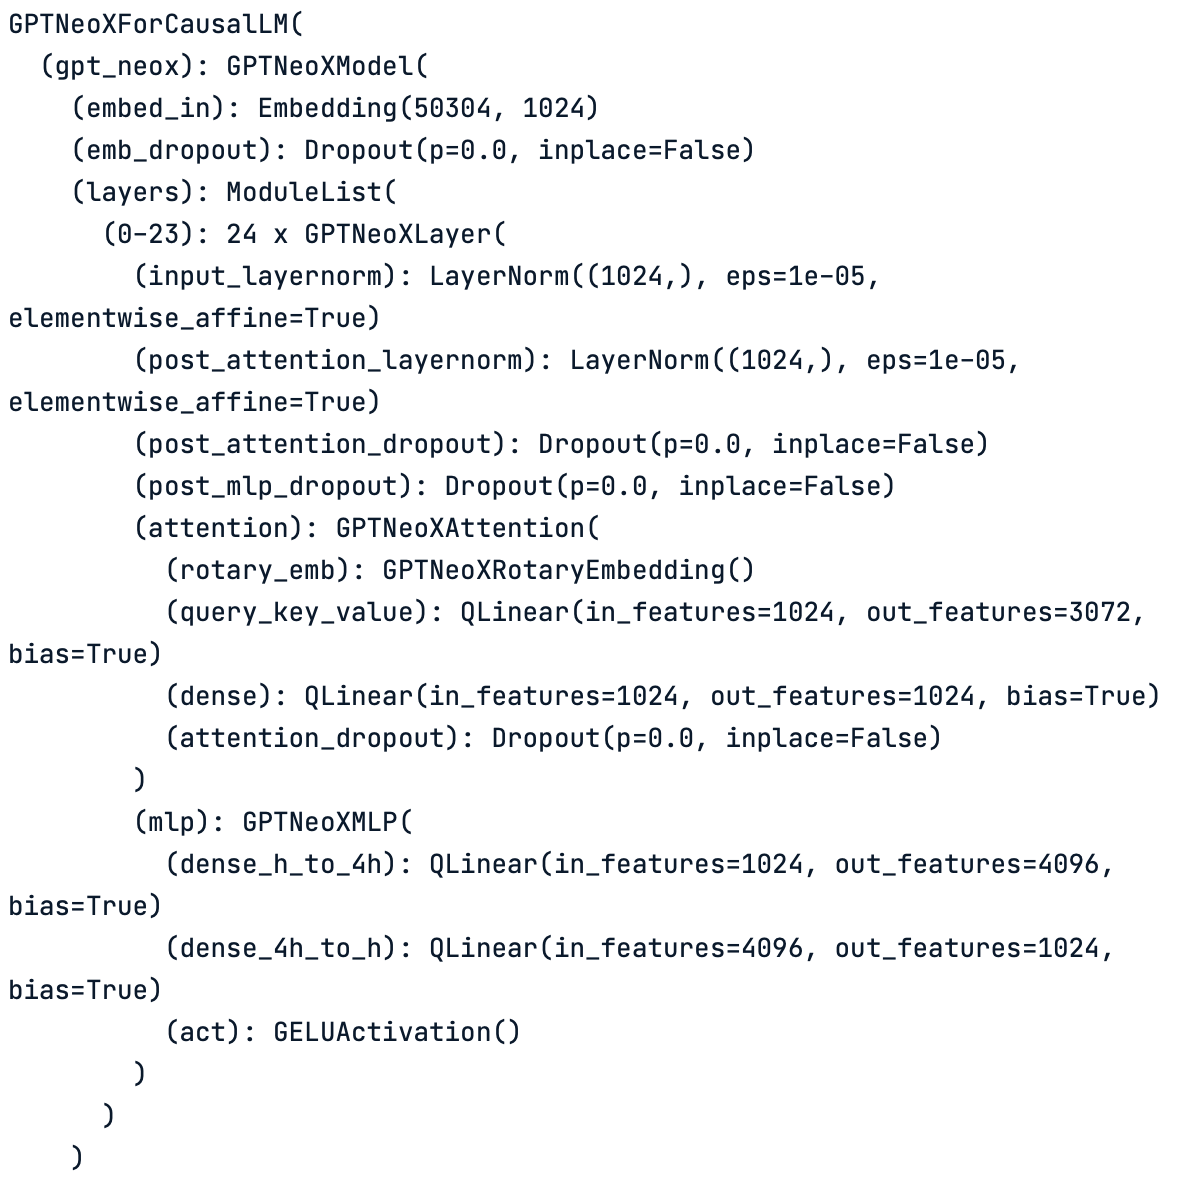
Sơ đồ theo tầng của mô hình đã lượng tử. Lưu ý tất cả tầng tuyến tính gốc đã chuyển thành tầng tuyến tính đã lượng tử (QLinear).
Tuy vậy, nếu in ma trận trọng số, ta sẽ thấy chúng chưa được biến đổi:
print(model.gpt_neox.layers[0].attention.dense.weight)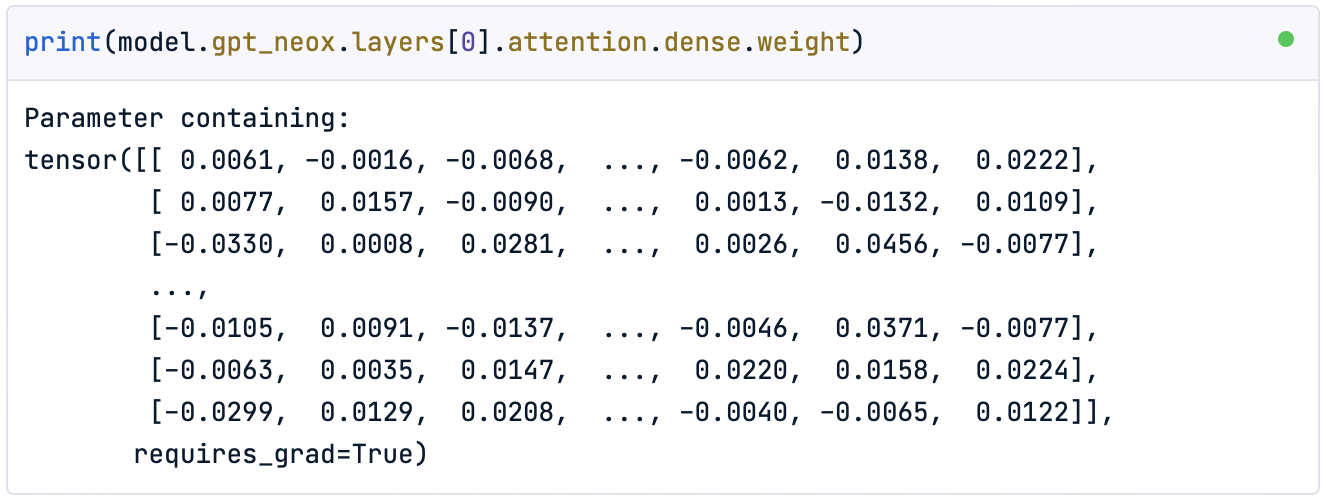
3. Đóng băng (Freeze). Để áp dụng hiệu ứng lượng tử hóa lên trọng số, ta cần dùng phương thức freeze().
freeze(model)Phương thức này nhúng các tham số lượng tử hóa vào mô hình, hiệu quả là chuyển trọng số sang kiểu dữ liệu mục tiêu. Hãy quan sát các tham số mô hình đã lượng tử:
print(model.gpt_neox.layers[0].attention.dense.weight)
Như ta thấy, trọng số giờ đã nằm trong dải của kiểu dữ liệu int8 của Pytorch.
4. Kiểm tra cuối. Khi mô hình đã lượng tử, ta có thể kiểm tra kích thước mới đã giảm:
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")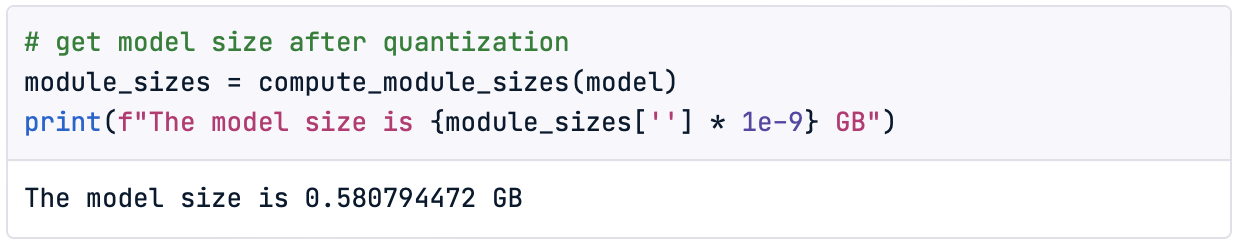
Chúng ta đã đạt một mô hình chỉ còn 35% kích thước ban đầu!
Cuối cùng, hãy kiểm tra hiệu năng mới của mô hình bằng một suy luận đơn giản:
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))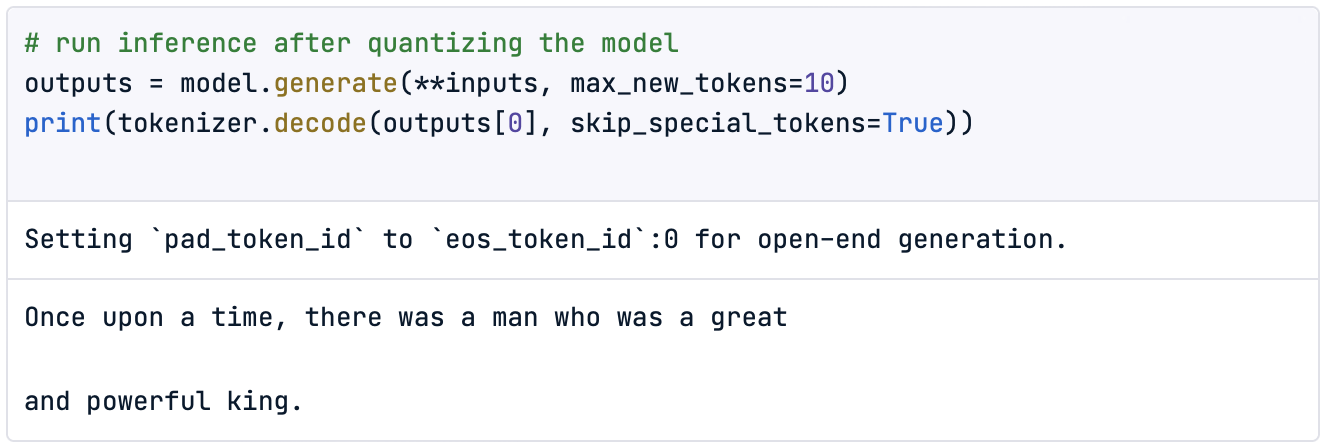
Tất nhiên, kiểm tra hiệu năng bằng một lần suy luận đơn lẻ là không ý nghĩa, nên thực hành tốt là định nghĩa một phương pháp định lượng để đánh giá.
Giờ là lúc bạn thử sức!
Nhu cầu bộ nhớ ngày càng tăng của LLM hạn chế cả huấn luyện và lưu trữ để suy luận, từ đó hạn chế khả năng tiếp cận và áp dụng các ứng dụng dựa trên LLM.
Trong bài viết này, chúng tôi đã giới thiệu khái niệm lượng tử hóa, bao gồm việc giảm độ chính xác của trọng số và kích hoạt của mô hình để giảm dấu chân bộ nhớ và yêu cầu tính toán. Quy trình này giúp mô hình hiệu quả và dễ tiếp cận hơn, đặc biệt khi triển khai trên các thiết bị hạn chế tài nguyên.
Chúng ta đã tiếp cận kỹ thuật này bằng các ví dụ, làm tròn các giá trị số của trọng số. Sau đó, chuyển sang một dạng lượng tử hóa đơn giản gọi là downcasting. Khi downcast một mô hình, các tham số được chuyển sang kiểu dữ liệu gọn hơn như bfloat16 để suy luận. Dù điều này cho phép mô hình tính toán và kích hoạt ở kiểu nhỏ hơn, hiệu năng thường suy giảm theo kích cỡ kiểu dữ liệu, kém hiệu quả với kiểu số nguyên như int8.
Để giải quyết điều này, chúng tôi giới thiệu lượng tử hóa tuyến tính, giúp giữ hiệu năng gần với mô hình gốc bằng cách chuyển về float32 trong lúc suy luận. Điều này cho phép dùng cả các kiểu nhỏ hơn nữa như int8.
Chúng ta đã đi qua các bước số học để áp dụng lượng tử hóa tuyến tính và triển khai lượng tử hóa trọng số bằng thư viện Quanto của Hugging Face. Đáng chú ý, với thư viện Quanto, ta có thể lượng tử hóa bất kỳ mô hình PyTorch nào, bao gồm các mô hình có sẵn trên Hugging Face.
Với những ai muốn thử các mô hình nặng hơn như LLaMa 2 hoặc Mistral, hãy cân nhắc nâng cấp không gian DataCamp của bạn lên gói cao cấp để có nhiều sức mạnh tính toán hơn.

Với các mô hình lớn hơn, chúng ta có thể cần thêm tài nguyên có trong DataCamp Premium Plan.
Bằng cách nắm vững các kỹ thuật lượng tử hóa, chúng ta có thể khai phóng toàn bộ tiềm năng của các Mô hình Ngôn ngữ Lớn với ít tài nguyên hơn, giúp AI tiên tiến trở nên hiệu quả, dễ tiếp cận và linh hoạt hơn.
Hy vọng bài viết này giúp bạn bắt tay vào lượng tử hóa cho LLM!
Các khóa học LLM hàng đầu
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
