
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
51.2K
Kendi ChatGPT’nizi doğrudan dizüstü bilgisayarınızda çalıştırmayı hiç hayal ettiniz mi?
Büyük Dil Modellerindeki (LLM) hızlı ilerlemelerle, bu güçlü modelleri tüketici donanımına taşıma olasılığı gerçeğe dönüşüyor.
Bu potansiyeli açığa çıkarmanın anahtarı kuantizasyonda yatıyor, giderek büyüyen bu modellerin boyutunu, doğru uygulanması halinde, performansı minimum düzeyde etkileyerek günlük cihazlarda çalışacak şekilde küçülten bir teknikte!
Bu rehberde kuantizasyon kavramına dalacak, nasıl çalıştığını ve LLM’ler için farklı kuantizasyon seçeneklerini açıklayacağız. Son olarak, Hugging Face’in Quanto kütüphanesini kullanarak modelimizi iki basit adımda kuantize edeceğiz.
Haydi derinlemesine inceleyelim! Aşamaları DataCamp DataLab üzerinden takip edebilirsiniz.
LLM’ler geliştikçe, karmaşıklıkları da katlanarak arttı ve bu da parametre sayılarında önemli bir artışa yol açtı. Örneğin, 2018’de piyasaya sürülen ilk GPT modelinin 0,11 milyar parametresi vardı. 2019’un sonunda GPT-2 bu sayıyı 1,5 milyara çıkardı ve 2020’nin sonunda yayımlanan GPT-3 ise 175 milyar parametreye fırladı.
Bugün, GPT-4’ün 1 trilyondan fazla parametresi var. Bu büyük artış bir zorluk getiriyor: modeller büyüdükçe bellek gereksinimleri de artıyor ve çoğu zaman GPU’lar gibi gelişmiş donanım hızlandırıcılarının kapasitesini aşıyor.
Belleğe yönelik bu artan talep, hem eğitim hem de çıkarım için barındırmayı sınırlandırarak LLM tabanlı çözümlerin erişilebilirliğini ve benimsenmesini kısıtlıyor.
Bu büyüme, modellerin boyutlarını azaltarak daha erişilebilir hale getirilmesi yönünde acil bir ihtiyaç doğuruyor. Modelin bazı bileşenlerinin hassasiyetini değiştirerek, kuantizasyon modelin bellek ayak izini benzer performans düzeylerini korurken azaltır.
Kuantizasyon, büyük bir dil modelindeki ağırlık ve aktivasyonları yüksek hassasiyetli değerlerden daha düşük hassasiyetli değerlere dönüştüren bir model sıkıştırma tekniğidir. Bu, daha fazla bilgi tutabilen bir veri türünden daha az bilgi tutan bir türe geçmek anlamına gelir. Tipik bir örnek, 32 bit kayan noktalı bir sayıdan 8 bit tamsayıya dönüştürmektir.
Modelin her bir ağırlığı veya aktivasyonu için gereken bit sayısını azaltmak, toplam boyutunda önemli bir düşüşe yol açar. Sonuç olarak kuantizasyon, LLM’leri daha az bellek tüketen, daha az depolama alanı gerektiren ve daha enerji verimli hale getirir.
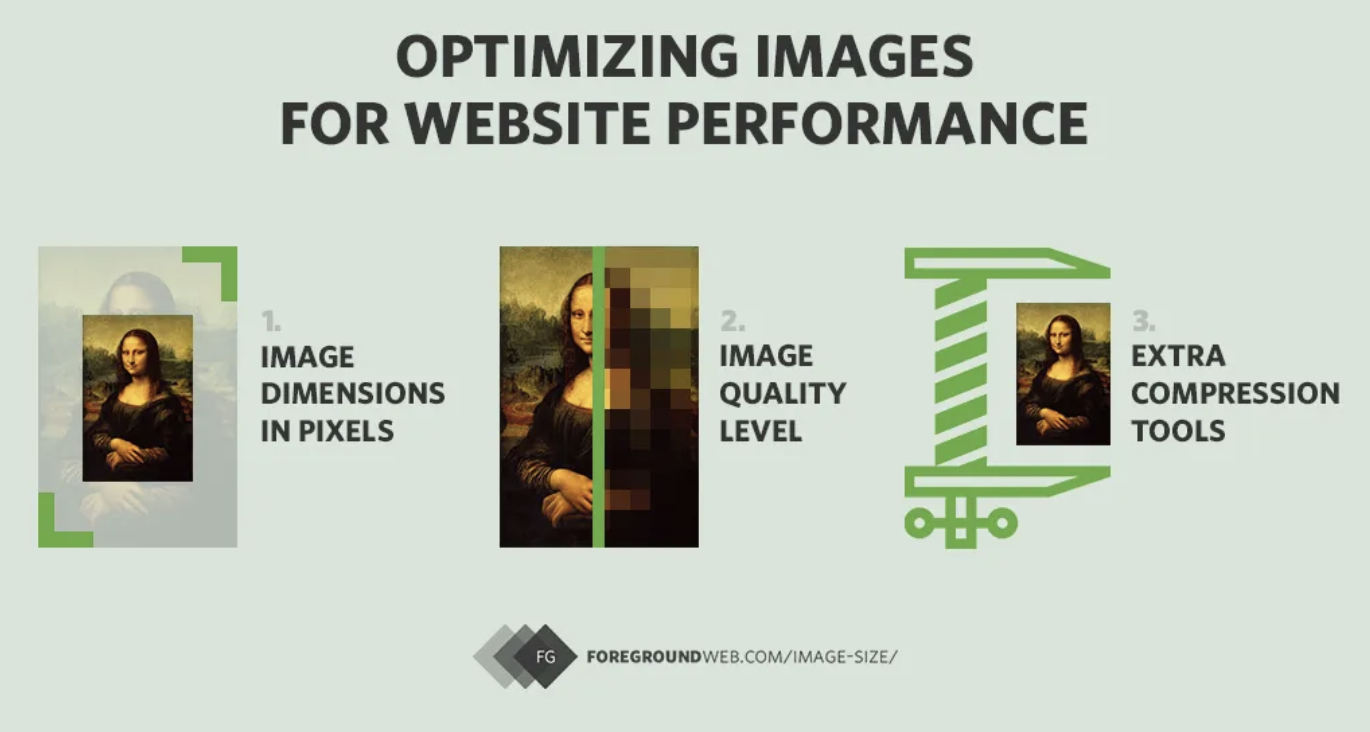
Kuantizasyonu anlamak için etkili bir benzetme, görüntü sıkıştırmadır. Yüksek çözünürlüklü görseller web sitelerinde kullanılmak üzere sık sık sıkıştırılır. Bu, bazı veri veya bilgi bitlerini kaldırarak görüntü boyutunu küçültmeyi içerir. Bu genellikle görüntü kalitesini bir miktar düşürse de, görüntü boyutlarını ve dosya boyutunu azaltır; böylece web sayfaları daha hızlı yüklenirken tatmin edici bir görsel deneyim sunulur.
Web sayfaları gibi uygulamalarda daha hızlı yükleme için görüntü sıkıştırması şeması.
Benzer şekilde, bir LLM’in kuantize edilmesi hesaplama gereksinimlerini azaltarak onu daha düşük güçlü donanımlarda da yeterli performansla çalıştırmayı mümkün kılar. Sıkıştırılmış görsellerin işlenmesi daha kolay olduğu gibi, kuantize edilmiş modeller de küçük bir ayrıntı veya hassasiyet kaybı pahasına farklı platformlarda daha kolay dağıtılabilir. Göreceğimiz gibi, kuantizasyon süreci bir miktar gürültü de ekler.
Kuantizasyon genellikle bir büyük dil modelinin ağırlıklarına uygulanır, ancak aktivasyonlara da uygulanabilir. Model ağırlıkları, bir sinir ağındaki farklı katmanlardaki nöronlar arasındaki bağlantıların gücünü belirleyen parametrelerdir. Ağırlıklar, girdiler ağdan geçerken veriyi dönüştüren öğrenilmiş katsayılardır.
Ağırlıklar başlangıçta rastgele, anlamsız değerlere ayarlanır ve tahmin edilen çıktı ile gerçek hedefler arasındaki hataya göre eğitim sırasında ayarlanır. Bu ayarlama süreci, gradyan inişi gibi optimizasyon algoritmaları tarafından yönlendirilir.
LLM’lerin iç yapıları hakkında daha fazla bilgi edinmek istiyorsanız Developing Large Language Models kursu size göre!
Bir modeli kuantize etmenin seçeneklerinden biri, model ağırlıklarının hassasiyetini düşürmektir. Bunu göstermek için, aşağıdaki görselde soldaki, dört ondalık hassasiyetli 3x3 ağırlık matrisini ele alalım:
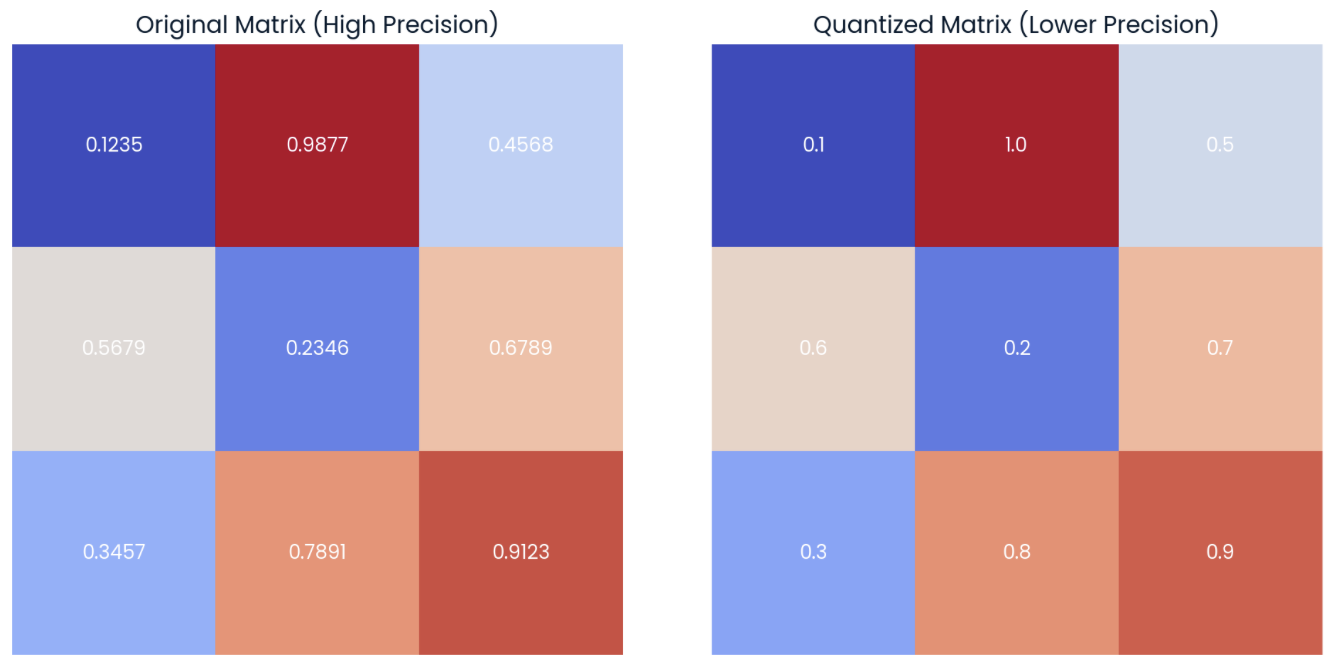
Dört ondalık hassasiyetli rastgele ağırlık matrisi örneği (sol) ve bir ondalık hassasiyete yuvarlama uygulanarak elde edilen kuantize hâli (sağ).
Sağdaki matriste, orijinal matrisin kuantize edilmiş sürümünü görüyoruz. Bu “kuantize” matris, orijinal matrisin elemanlarının bir ondalığa yuvarlanmasıyla hesaplanır.
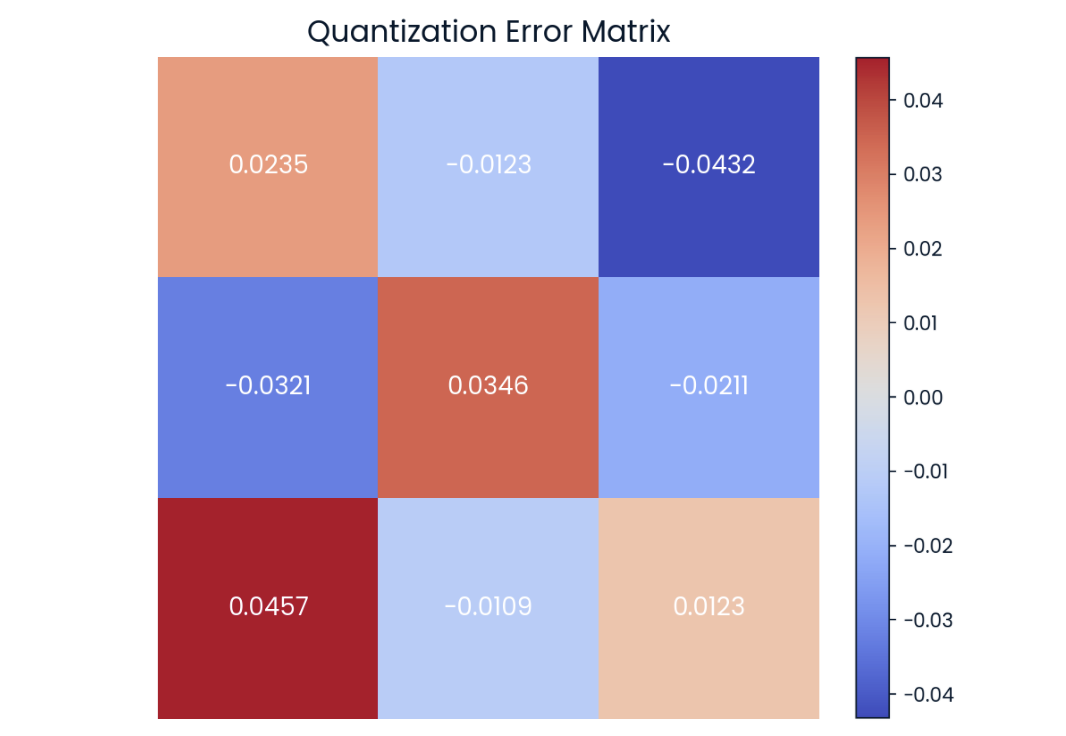
Yukarıdaki matrislerin tamamen eşit olmadığını ancak oldukça benzer olduğunu gözlemleyebiliriz. Değer bazında fark, kuantizasyon hatası olarak bilinir ve matris biçiminde de gösterilebilir:
Matris biçiminde kuantizasyon hatası. Renk koyulaştıkça hata artar.
Güncel kuantizasyon araştırmaları, herhangi bir performans düşüşünü önlemek için bu farkı mümkün olduğunca azaltmaya odaklanır.
Bu basit örnekte yalnızca matris elemanlarını yuvarlıyoruz. Pratikte kuantizasyon, sayısal değerlerin daha yüksek hassasiyetli bir veri türünden daha düşük hassasiyetli olana dönüştürülmesiyle yapılır. Örneğin, çoğu modelin varsayılan depolama veri türü float32’dir.
Bu durumda, parametre başına 4 bayt (8 bitlik hassasiyetin 4 katı) ayırmamız gerekir. Dolayısıyla, örnekteki gibi 3x3 bir matris için toplam bellek ayak izi 36 bayttır.
Veri türünü değiştirerek — downcasting olarak da bilinir — int8’e geçtiğimizde parametre başına yalnızca bir bayta ihtiyaç duyarız. Böylece matrisin toplam bellek ayak izi 9 bayta düşer.
Model ağırlıkları için seçilen veri türü, modeli ne ölçüde küçültebileceğimizi belirler. float32 ve float16 gibi geleneksel kayan noktalı türler, doğruluk ile hesaplama verimliliği arasında denge sunarak birçok makine öğrenimi uygulamasında standart olmuştur. Özellikle, float32 yüksek hassasiyet ve geniş dinamik aralık sunarken daha fazla bellek ve hesaplama gücü gerektirir. Buna karşın, float16 daha düşük hassasiyet ve aralık sunarak hesaplamaları önemli ölçüde hızlandırır.
float32’nin geniş dinamik aralığı ile float16’nın verimliliği arasında bir orta yol sunan bir kayan nokta biçimine ihtiyaç duyulduğunu fark etti. Bu, dinamik aralığı float32 ile aynı kalan ancak hassasiyeti düşürülmüş Beyin Kayan Nokta (bfloat16) türünün oluşturulmasına yol açtı.
Downcasting, daha yüksek hassasiyetli bir veri türünü daha düşük hassasiyetli bir veri türüne dönüştürmenin resmî adıdır. Downcasting kullanarak bellek ayak izini azaltır ve hız kazanırız; çünkü daha düşük hassasiyetle yapılan hesaplamalar daha az bellek gerektirir.
Bu bölümde, çoğu model için varsayılan depolama veri türü olan float32’den Google’ın bfloat16 türüne downcasting’in nasıl çalıştığını inceleyecek ve bunun genellikle bazı veri kayıplarıyla sonuçlandığını göreceğiz.
PyTorch’ta float32 türünde elemanlara sahip rastgele bir tensör tanımlayarak başlayalım ve ilk beş elemanı gösterelim:
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
Tensörü şimdi bfloat16’ya .to(dtype) yöntemiyle downcast edebilir ve yeni ilk 5 elemanı gözlemleyebiliriz:
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Görüldüğü gibi değerler oldukça yakın, ancak aynı değil. Değerler üzerinde işlemler yapmaya başladığımızda fark daha belirginleşir. Örneğin, orijinal tensörü kendisiyle çarptığımızda:
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Aynı hesabı kuantize tensörle yaptığımızda farkın daha büyük olduğunu görürüz:
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
Hata yayılımı nedeniyle nihai sonuçlar arasında belirgin bir fark gözlemleriz.
Kuantize tensörlerle işlem yapılırken görülen aynı hata yayılımı etkisi, LLM’lerde downcasting uygulandığında da ortaya çıkar ve bilgi kaybına yol açar. Gördüğümüz gibi daha az bellek kullanmak, hesaplamanın daha az hassas olabileceği anlamına gelir. Çarpmanın etkisi, katman katman biriken ve sonunda bazı token tahminlerini etkileyen gerçek hata yayılımına benzer.
Downcasting ile, bfloat16 türü kullanıldığında performans kabul edilebilir düzeyde kalır, ancak daha küçük veri türleri için bu geçerli değildir.
Bu veri türü kısıtı nedeniyle downcasting, etkili bir kuantizasyon tekniği olarak yaygın kullanılmaz. Bunun yerine, çıkarım sırasında tekrar float32’ye dönüştürerek performansı orijinal modele daha yakın tutan diğer yöntemler tercih edilir.
Birden fazla kuantizasyon türü vardır ve her birini aşağıda ayrıntılı olarak açıkladık:
Doğrusal kuantizasyon, LLM’ler için en popüler kuantizasyon şemalarından biridir. Basitçe, orijinal ağırlıkların kayan noktalı değer aralığının, çıkarım için yüksek hassasiyetli veri türü kullanılarak eşit olarak sabit noktalı değer aralığına eşlenmesini içerir.
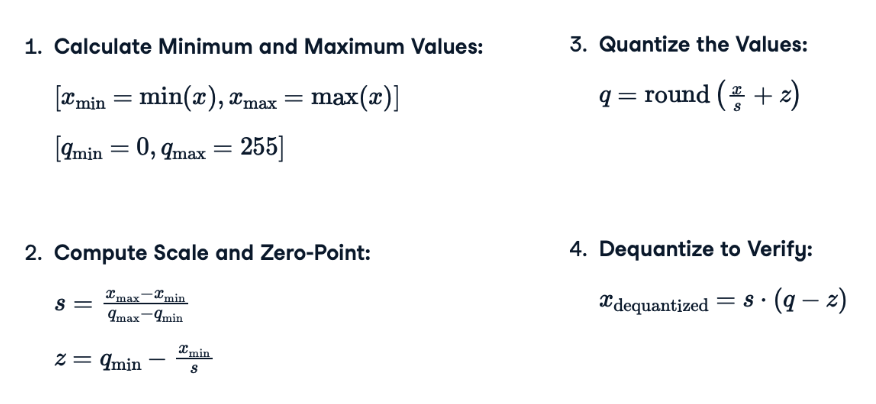
Mümkün olduğunca basit hâle getirmek için, bir modele doğrusal kuantizasyon uygulamak için gereken adımları gözden geçirelim. Gerçek formüllerin aşağıdaki görselde verildiğini unutmayın:
s) ve sıfır noktası (s) değerlerini hesaplayın: Ölçek, kayan noktalı değer aralığını tamsayı aralığına sığdırır. Sıfır noktası ise kayan noktalı aralıkta sıfırın doğru şekilde bir tamsayıyla temsil edilmesini sağlayarak özellikle sıfıra yakın değerlerde sayısal doğruluğu ve kararlılığı korur.q): Bu adım, önceki adımda hesaplanan s ölçek faktörü ve s sıfır noktası kullanılarak kayan noktalı değerlerin daha düşük hassasiyetli tamsayı aralığına eşlenmesini içerir. Yuvarlama işlemi, nihai sonucun düşük hassasiyetli formatlarda depolama ve hesaplama için uygun, ayrık bir tamsayı olmasını sağlar.Yukarıda tanımlanan her adımı ilgili formülle eşleştirelim:
Herhangi bir ağırlık matrisine doğrusal kuantizasyon uygulamak için kullanılan kuantizasyon denklemleri.
Bu formülleri uygulamayı gözünüzde canlandırmak zor mu? Hadi pratiğe dökelim!
Aşağıdaki görselde soldaki 3x3 ağırlık tensörüne bu formülleri uygularsak, sağda görülen kuantize matrisi elde ederiz. Kuantize aralığın maksimum ve minimum değerlerini ve bazı kuantize değerleri hesaplamak için birkaç dakikanızı ayırmanızı öneririm:
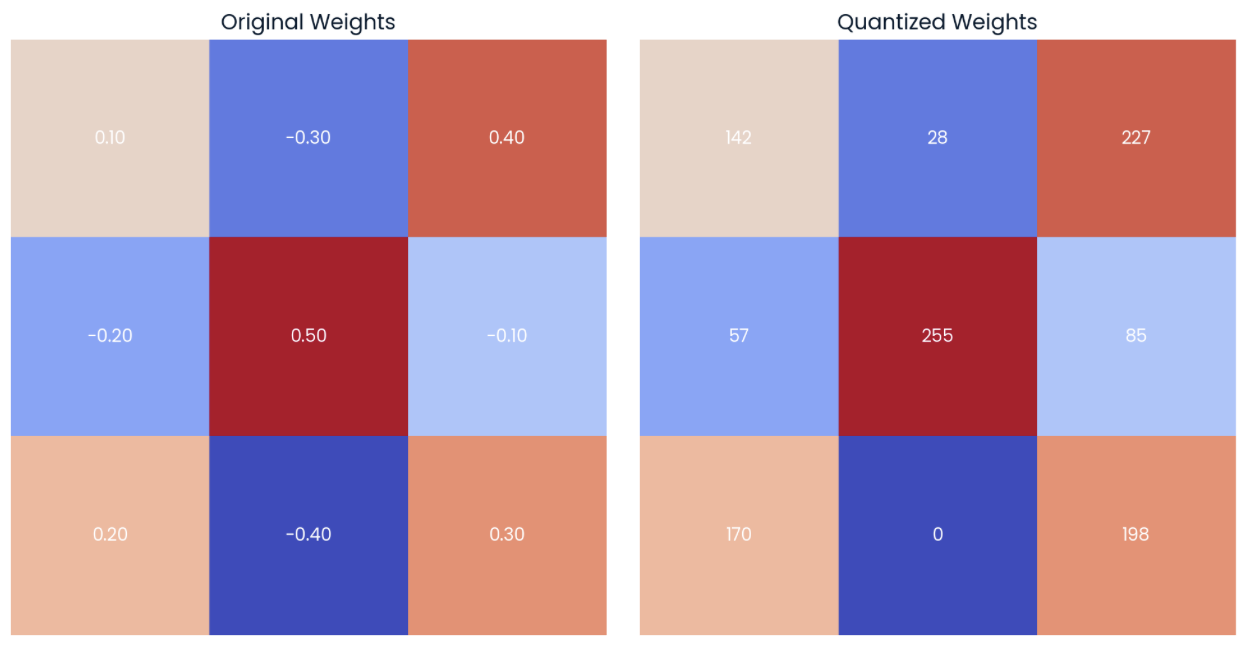
İki ondalık hassasiyetli rastgele ağırlık matrisi örneği (sol) ve int8 veri türüne kuantize edilmiş hâli (sağ).
Görüyoruz ki int8 değerinin alt sınırı, orijinal tensörün alt değerine (-0.40 → 0), üst sınır ise orijinal tensörün üst değerine (0.50 → 255) karşılık gelir.
Şimdi (4) numaralı formülle değerleri de-kuantize edersek, de-kuantize değerlerin orijinal değerlere (soldaki matris) yakın olduğunu görebiliriz. Noktadan noktaya farkı (sağdaki matris) hesaplayarak kuantizasyon hatasını bulabiliriz:
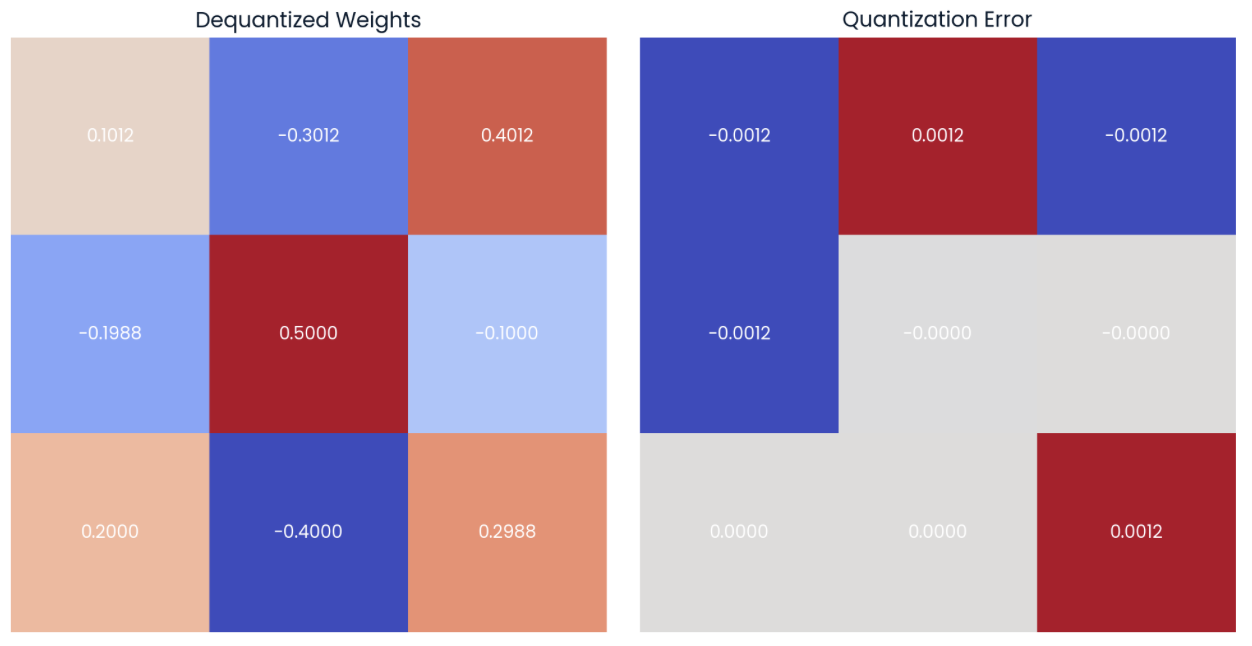
De-kuantizasyon, kuantize ağırlıklar ile ölçek ve sıfır noktası değerleri kullanılarak yapılabilir (sol). Noktadan noktaya fark ya da kuantizasyon hatası hesaplanabilir (sağ).
Doğrusal kuantizasyon, yalnızca kuantize ağırlıkları ve ölçek ile sıfır noktası değerlerini bellekte tutarak model boyutunu azaltır; çıkarımda ise bu değerler kullanılarak orijinal ağırlıklar hesaplanır ve performans korunur.
Doğrusal kuantizasyon sadeliği nedeniyle popülerdir, ancak eşleme kurmanın birden fazla yolu vardır. Günümüzde oldukça popüler bir diğer yöntem de blok bazlı kuantizasyondur; bu yöntem, ağırlık dağılımı uniform olmayan modeller için doğrusal kuantizasyondan daha doğrudur.
Blok bazlı kuantizasyon, ağırlıkların tüm aralık yerine daha küçük bloklar hâlinde kuantize edilmesini içeren daha gelişmiş bir yöntemdir. Bu yöntem iki kilit kavrama dayanır:
Matris örneklerimiz boyunca ağırlıkların kuantize edilmesi sürecine odaklandık. Ağırlık kuantizasyonu model optimizasyonu için kritik bir adım olsa da, modelin aktivasyonlarının da kuantize edilebileceğini göz önünde bulundurmak önemlidir.
Aktivasyon kuantizasyonu, ağdaki her katmanın ara çıktılarının hassasiyetini düşürme işlemidir. Eğitim tamamlandıktan sonra durağan (sabit) olan ağırlıkların aksine aktivasyonlar dinamiktir. Bu da aktivasyonların ağa her girişte değiştiği ve aralıklarının öngörülmesini zorlaştırdığı anlamına gelir.
Genel olarak aktivasyon kuantizasyonu, ağırlık kuantizasyonuna göre daha zor uygulanır. Aktivasyonların dinamik aralığının iyi yakalanması için dikkatli bir kalibrasyon gerekir.
Ağırlık kuantizasyonu ve aktivasyon kuantizasyonu birbirini tamamlayıcı tekniklerdir. Her iki tekniği uygulayarak, performansı çok fazla düşürmeden model boyutunda önemli iyileştirmeler sağlayabiliriz.
Kuantizasyon farklı zamanlarda da gerçekleştirilebilir. Önceden eğitilmiş bir modeli alıp çıkarım aşamasında model parametrelerini kuantize edersek, Eğitim Sonrası Kuantizasyon (PTQ) uygulamış oluruz.
Bu yöntem eğitim sürecinin kendisinde herhangi bir değişiklik gerektirmez. Parametrelerin dinamik aralığı, örnek matrislerle çalıştığımız duruma benzer şekilde çalışma zamanında yeniden hesaplanır.
Diğer yandan Kuantizasyon Farkındalıklı Eğitim (QAT) uygulama seçeneği de vardır. Bu yaklaşım, eğitim sırasında kuantizasyon etkilerini simüle etmek için eğitim sürecinin değiştirilmesini içerir. Model, kuantizasyon gürültüsüne dayanıklı olacak şekilde eğitilir ve daha iyi doğruluk sağlar.
QAT sırasında, eğitimdeki ara durumlar hem kuantize ağırlıkları hem de orijinal kuantize edilmemiş ağırlıkları (bellekte!) tutar. Dolayısıyla, çıkarım için modelin kuantize sürümünü kullanırız; ancak geri yayılım sırasında modelin kuantize edilmemiş ağırlıkları güncellenir.
Bekleneceği üzere, daha karmaşık ve zaman alıcı olmasına rağmen QAT genellikle PTQ’ya kıyasla daha yüksek doğruluk sağlar.
Bazı kuantizasyon yöntemleri bir kalibrasyon adımı gerektirir. Örneğin, kuantizasyondan önce bir modelin orijinal aktivasyon aralığını belirlememiz gerekir. Genel kalibrasyon genellikle temsili bir veri kümesi üzerinde çıkarım çalıştırarak kuantizasyon parametrelerini optimize etmeyi ve kuantizasyon hatasını en aza indirmeyi içerir.
Bu kalibrasyon sürecinde, kuantizasyon algoritması modelin aktivasyon ve ağırlıklarının dağılımı ve aralığı hakkında istatistikler toplar. Bu istatistikler en uygun kuantizasyon parametrelerinin belirlenmesine yardımcı olur. Ağırlıkları kuantize ederken ölçek ve sıfır noktasını hesaplamak da bir tür kalibrasyondur; ancak başka türler de vardır:
Bununla birlikte, QLoRA gibi yöntemler herhangi bir kalibrasyon adımı olmadan da kullanılabilir.
Bu yöntemler tipik olarak modeldeki tüm lineer katmanları kuantize lineer katmanlarla (QLinear) değiştirir. QLinear katmanları kuantizasyonu dahili olarak yönetmek üzere tasarlanmıştır; böylece ilave bir kalibrasyon adımına ihtiyaç ortadan kalkar. Bu da kuantizasyon sürecini uygulamayı daha basit hâle getirirken modelin performansını korur.
Python’da kuantizasyonu destekleyen, PTQ ve QAT için imkânlar sunan çeşitli araçlar ve kütüphaneler vardır. Örneğin pytorch ve tensorflow kuantizasyon yöntemleri sağlar; ancak kuantizasyonun mevcut modellere sorunsuz entegre edilmesi, kütüphanelere ve model içyapısına dair derin bir anlayış gerektirir. Resmî PyTorch dokümantasyonundaki kuantizasyon seçeneklerine bakın.
Bu güçlü çerçeveleri öğrenmekle ilgileniyorsanız Deep Learning in Python kursunu öneririm.
Şimdiye dek kuantizasyonu kolay adımlarla uygulamak için en sevdiğim seçenek, PyTorch modelleri için kuantizasyon sürecini basitleştirmek üzere tasarlanmış Hugging Face’in Quanto kütüphanesidir.
Hugging Face’in Quanto kütüphanesini kullanarak tipik bir kuantizasyon iş akışı aşağıdaki adımlardan oluşur:
1. Önceden eğitilmiş bir modeli ve karşılık gelen belirteçleyicisini (tokenizer) seçip yükleyin. Bu durumda, EuletherAI’nin Pythia 410M modelini kullanacağız:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Yüklenen modelin farklı katmanlarını görselleştirmeye model.gpt_neox yöntemi yardımcı olabilir:
print(model.gpt_neox)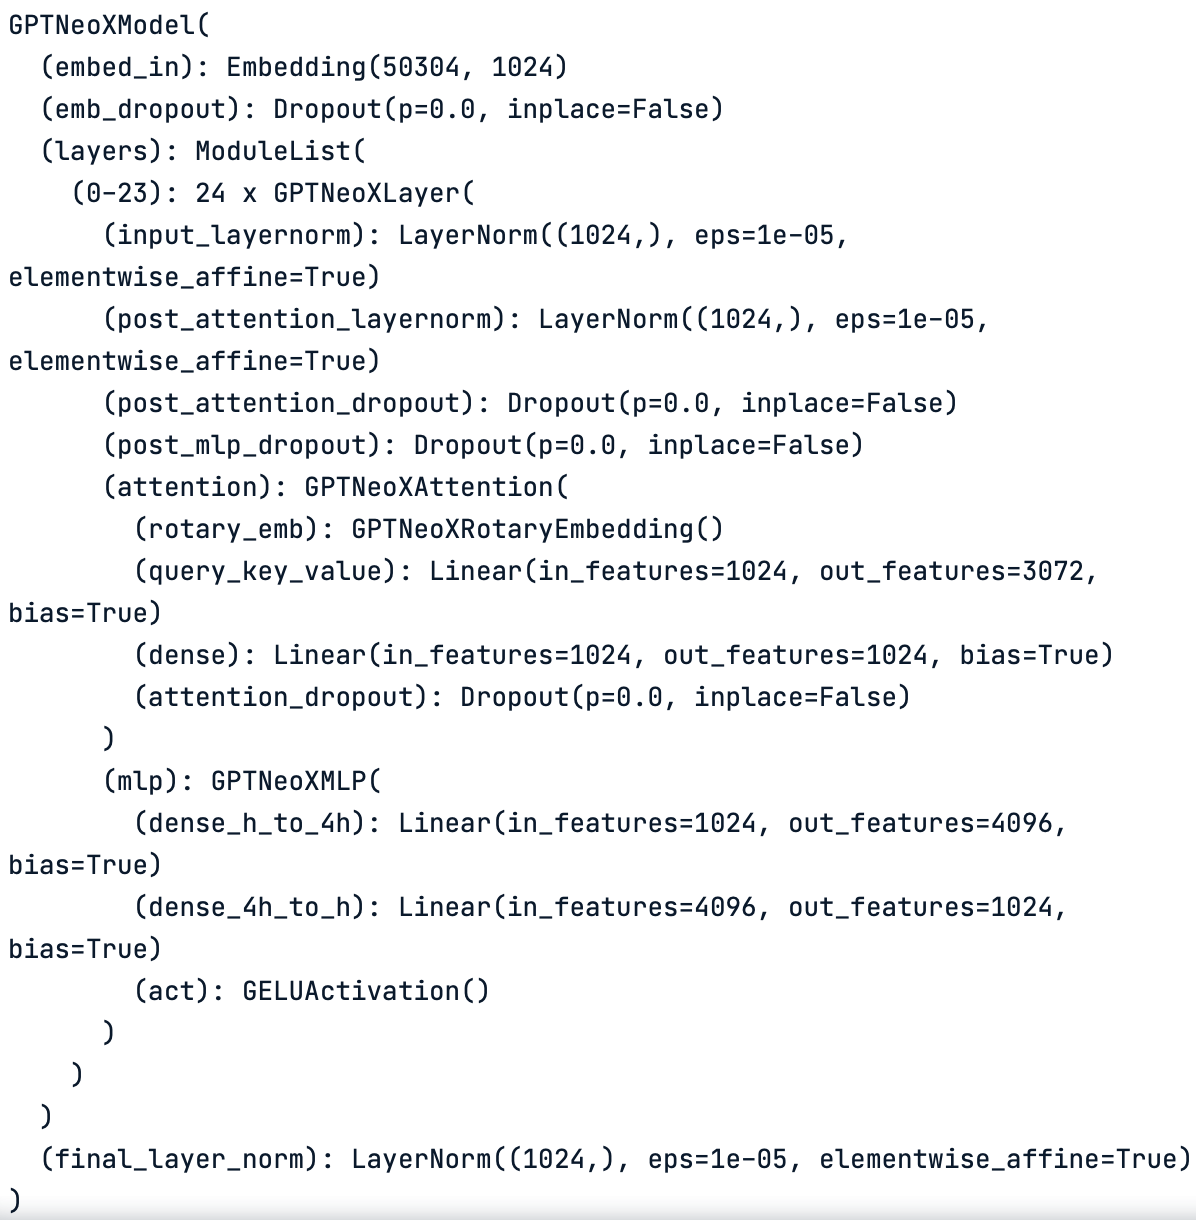
Orijinal modelin katman katman şeması. Model, lineer katmanlar ve normalizasyon katmanları gibi farklı türde katmanlardan oluşur.
Bazı test çıkarımları çalıştırarak modelin düzgün çalıştığını kontrol edebiliriz. Örneğin,
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))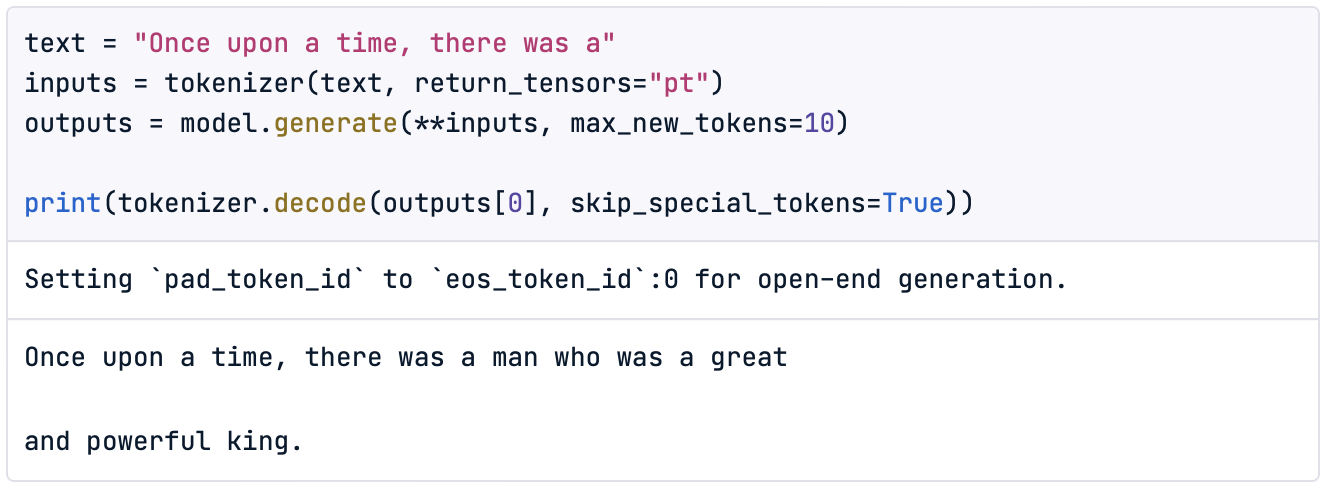
Ayrıca, modeli kuantize edeceğimiz için boyutunu küçültebileceğiz; bu nedenle sürece başlamadan önce orijinal model boyutunu kontrol etmek de ilginç olacaktır:
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")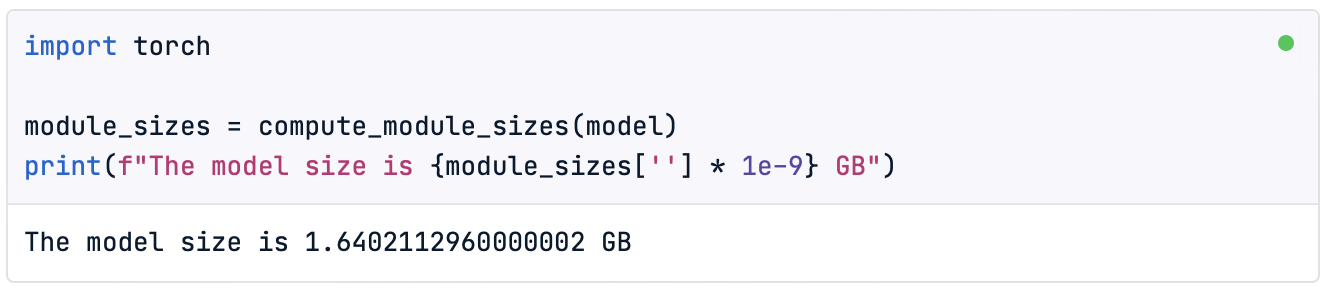
Not: DataCamp DataLab’de compute_module_sizes() yönteminin uygulanmış hâlini bulabilirsiniz.
Son olarak, orijinal modelin yoğun tensörlerini de aşağıdaki gibi görselleştirebiliriz:
print(model.gpt_neox.layers[0].attention.dense.weight)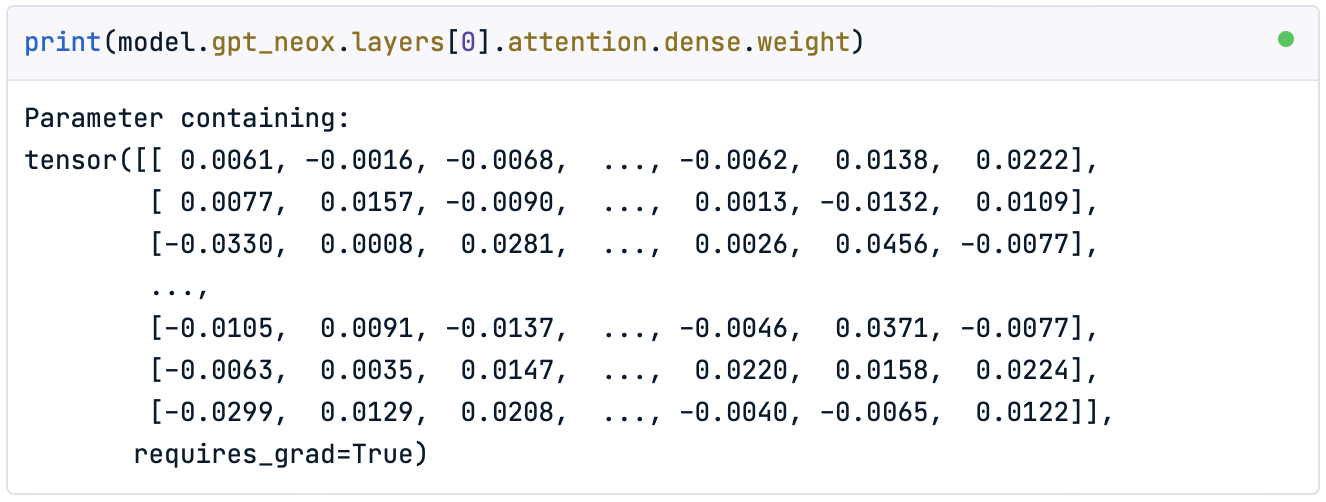
Gözlemlediğimiz üzere, bu makale boyunca üzerinde çalıştığımız kuantize edilmemiş matrise benziyor.
2. Kuantize edin. quantize() yöntemi, varsayılan standart kayan noktalı modeli doğrudan kuantize bir modele dönüştürmeye imkân tanır.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
Bu durumda, yalnızca modelin ağırlıklarını int8 veri türüne kuantize ediyoruz. Bu yöntem, kalibrasyon adımı dahil olmak üzere modeli daha düşük hassasiyetli aritmetik kullanacak şekilde dönüştürür.
Şimdi modelin katmanlarını yazdırırsak, orijinal lineer katmanların (Linear) yerini kuantize lineer katmanların (QLinear) aldığını görürüz:
print(model)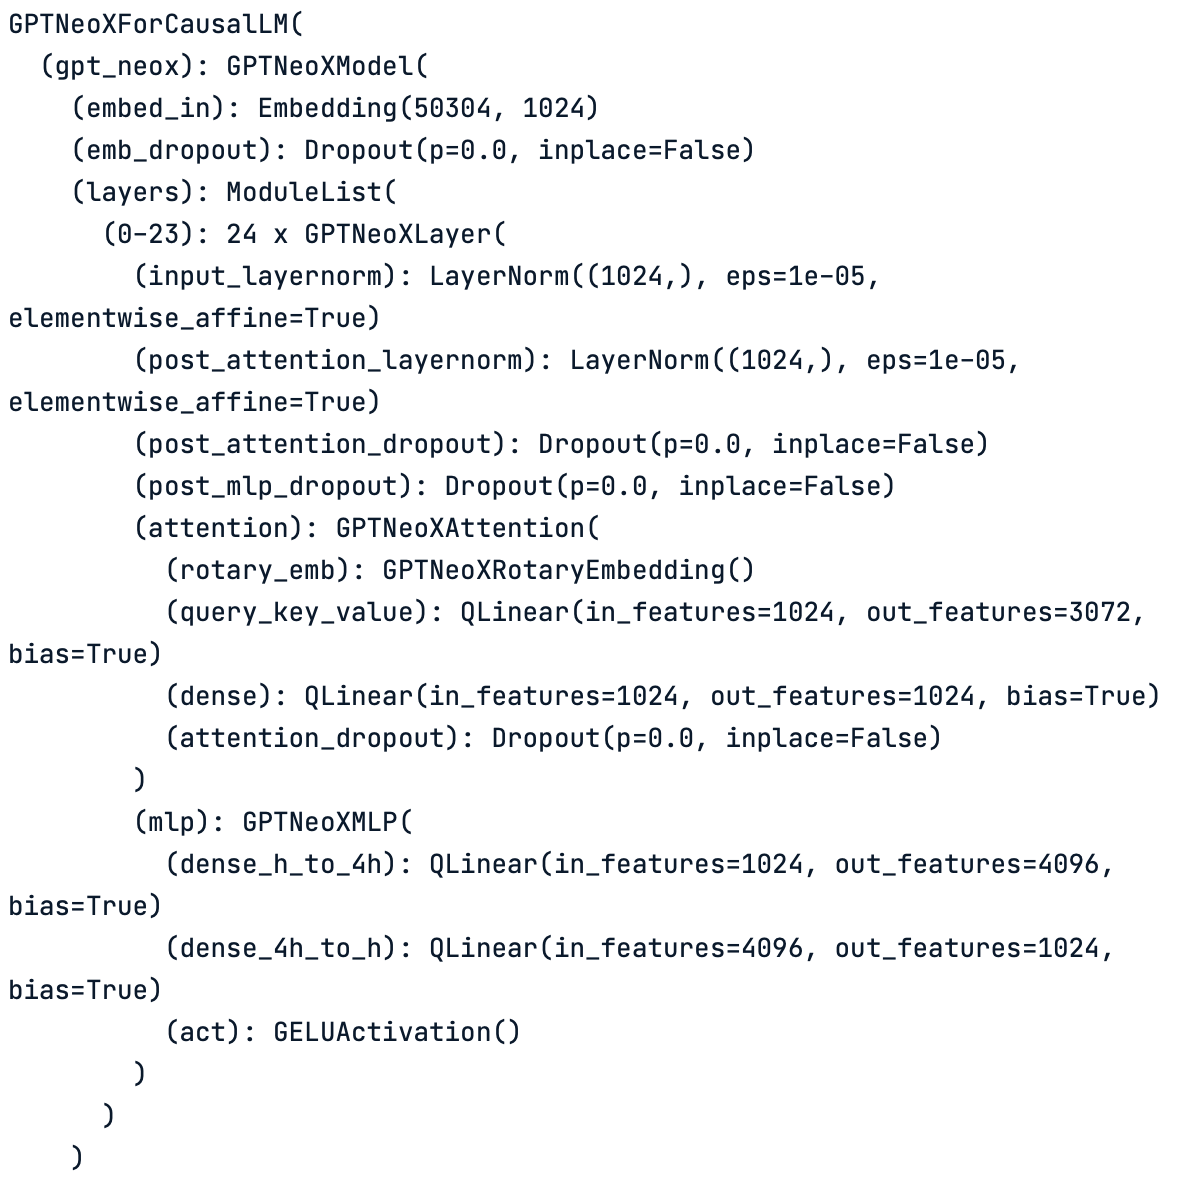
Kuantize modelin katman katman şeması. Tüm orijinal lineer katmanların (QLinear) kuantize lineer katmanlara dönüştüğüne dikkat edin.
Buna rağmen, ağırlıklar matrisini yazdırırsak dönüşmediklerini görürüz:
print(model.gpt_neox.layers[0].attention.dense.weight)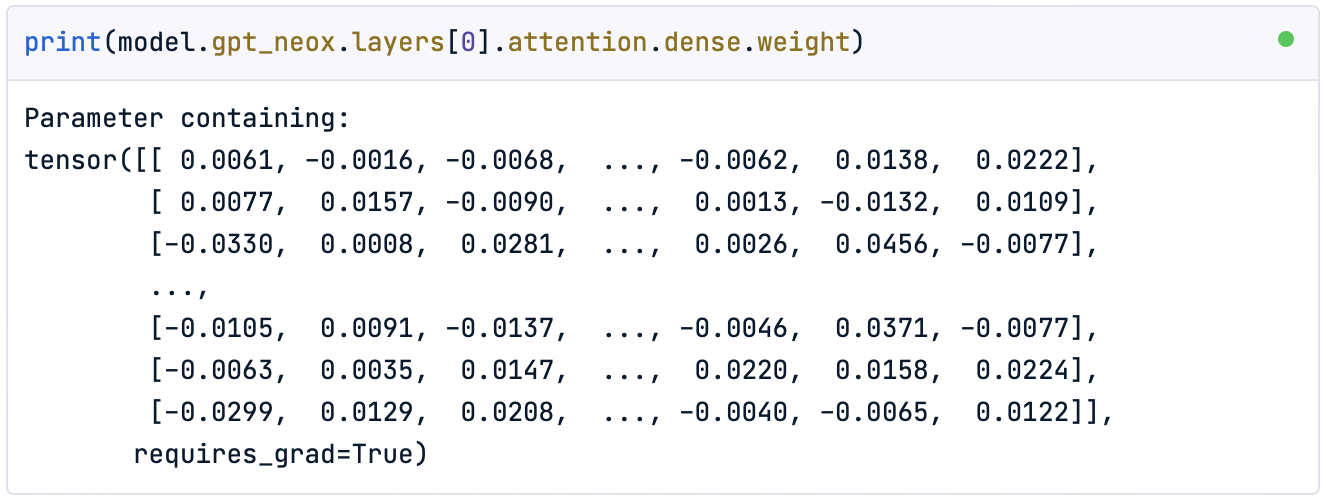
3. Dondurun. Ağırlıklara kuantizasyon etkisini uygulamak için freeze() yöntemini kullanmamız gerekir.
freeze(model)Bu yöntem, kuantizasyon parametrelerini modele gömerek ağırlıkları hedef veri türüne etkin biçimde dönüştürür. Şimdi kuantize model parametrelerine bakalım:
print(model.gpt_neox.layers[0].attention.dense.weight)
Gördüğümüz gibi, ağırlıklar artık PyTorch int8 veri türünün aralığında.
4. Son kontroller. Model kuantize edildikten sonra yeni, küçülmüş model boyutunu kontrol edebiliriz:
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")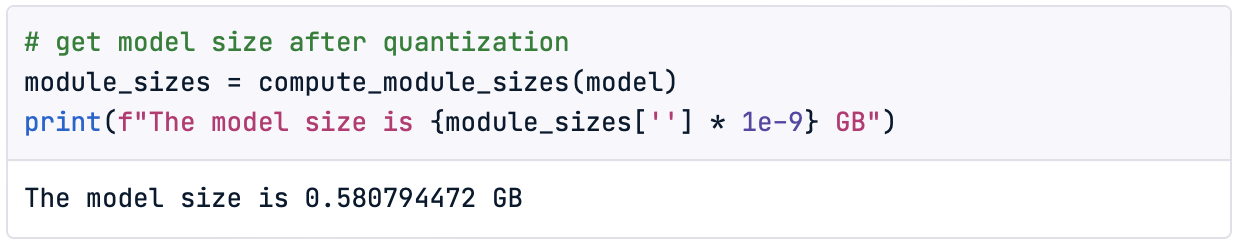
Orijinal boyutun yalnızca %35’i kadar bir model elde ettik!
Son olarak, basit bir çıkarımla modelin yeni performansını kontrol edelim:
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))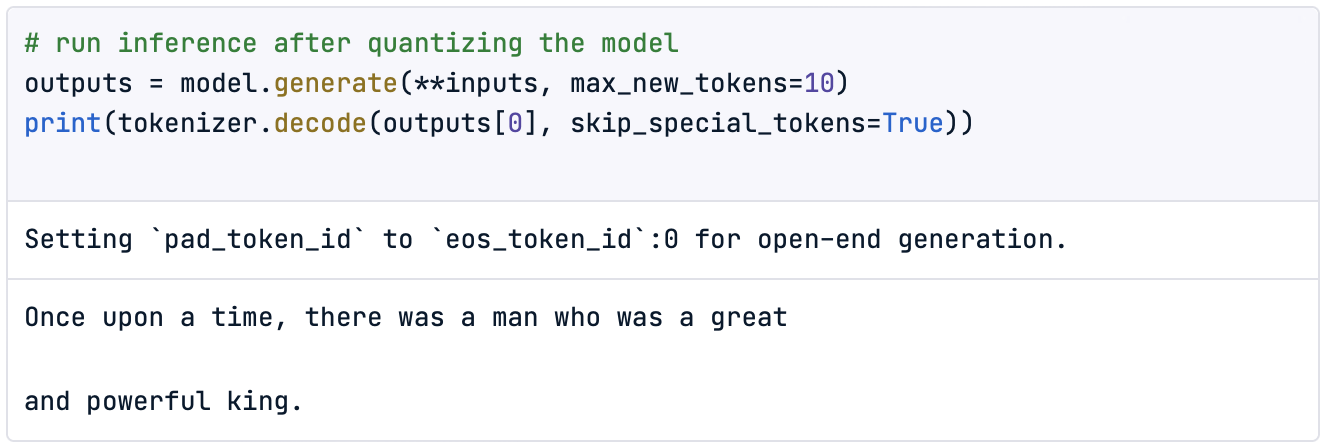
Elbette, tek bir çıkarımla performansı kontrol etmek anlamlı değildir; bu nedenle nicel bir değerlendirme yöntemi tanımlamak iyi bir uygulama olacaktır.
Şimdi deneme sırası sizde!
LLM’lerin artan bellek talepleri, hem eğitimlerini hem de çıkarım için barındırılmalarını sınırlandırarak LLM tabanlı uygulamaların erişilebilirliğini ve benimsenmesini kısıtlar.
Bu yazıda, modelin bellek ayak izini ve hesaplama gereksinimlerini düşürmek için ağırlık ve aktivasyonlarının hassasiyetini azaltmayı içeren kuantizasyon kavramını tanıttık. Bu süreç, özellikle kaynak kısıtlı cihazlara dağıtım için modelleri daha verimli ve erişilebilir hale getirmeye yardımcı olur.
Bu tekniğe, ağırlıkların sayısal değerlerini yuvarladığımız bazı örneklerle yaklaştık. Ardından, downcasting olarak bilinen basit bir kuantizasyon türüne geçtik. Bir model downcast edildiğinde, parametreler çıkarım için bfloat16 gibi daha kompakt bir veri türüne dönüştürülür. Bu, modelin hesaplamaları ve aktivasyonları daha küçük bir veri türünde gerçekleştirmesini sağlasa da, veri türü boyutu küçüldükçe performans tipik olarak düşer ve int8 gibi tamsayı türlerinde etkisiz hale gelir.
Bunu ele almak için, çıkarım sırasında tekrar float32’ye dönerek performansı orijinal modele daha yakın tutan doğrusal kuantizasyonu tanıttık. Bu, int8 gibi daha da küçük veri türlerinin kullanılmasını mümkün kılar.
Doğrusal kuantizasyonun sayısal adımlarını yürüttük ve Hugging Face’in Quanto kütüphanesini kullanarak ağırlık kuantizasyonumuzu uyguladık. Özellikle, Quanto kütüphanesiyle Hugging Face’te bulunanlar da dahil olmak üzere herhangi bir PyTorch modelini kuantize edebiliriz.
LLaMa 2 veya Mistral gibi daha ağır modelleri denemek isteyenler için, daha fazla hesaplama gücü için DataCamp alanınızı premium’a yükseltmeyi düşünün.

Daha büyük modeller için, DataCamp Premium Plan kapsamında erişilebilenlerden daha fazla kaynağa ihtiyaç duyabiliriz.
Kuantizasyon tekniklerinde ustalaşarak, daha az kaynakla Büyük Dil Modellerinin tüm potansiyelini açığa çıkarabilir, gelişmiş yapay zekâyı daha verimli, erişilebilir ve çok yönlü hâle getirebiliriz.
Umarım bu makale, LLM’ler için kuantizasyonu uygulamaya başlamanıza yardımcı olur!
En İyi LLM Kursları
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




