
Corso
Reinforcement Learning con Gymnasium in Python
4 ore
14K
I modelli di reinforcement learning (RL), sia di base sia profondi, a volte possono sembrare intelligenze artificiali da fantascienza più di qualunque large language model attuale. Vediamo come l'RL permette a questo agente di completare un livello molto difficile in Super Mario:
All'inizio, l'agente non ha idea di come si giochi. Non conosce i comandi, come progredire, quali siano gli ostacoli o cosa faccia finire la partita. Deve imparare tutto questo senza alcun intervento umano, solo grazie alla potenza degli algoritmi di reinforcement learning.
Gli agenti RL possono risolvere problemi senza soluzioni predefinite o azioni programmate esplicitamente e, cosa fondamentale, senza grandi quantità di dati. Ecco perché l'RL sta avendo un impatto significativo in molti settori. Per esempio, viene usato in:
Il reinforcement learning è un campo in rapida evoluzione con un enorme potenziale. Con il progredire della ricerca, possiamo aspettarci applicazioni ancora più rivoluzionarie in aree come la gestione delle risorse, la sanità e l'apprendimento personalizzato.
Per questo, ora è un ottimo momento per scoprire questo affascinante ambito del machine learning. In questo tutorial, ti aiuteremo a capire i fondamenti del reinforcement learning e spiegheremo passo dopo passo concetti come agente, ambiente, azione, stato, ricompense e altro.
Diciamo che vuoi insegnare al tuo gatto, Bob, a usare più tiragraffi in una stanza invece dei tuoi costosi mobili. In termini di reinforcement learning, Bob è l'agente, cioè colui che impara e prende decisioni. Deve imparare cosa è consentito graffiare (tappeti e tiragraffi) e cosa no (divani e tende).
La stanza è l'ambiente con cui il nostro agente interagisce. Fornisce sfide (mobili invitanti) e l'obiettivo desiderato (un tiragraffi soddisfacente).
In RL esistono due tipi principali di ambienti:
La nostra stanza è anche un ambiente statico. I mobili non si muovono e i tiragraffi restano al loro posto.
Ma se sposti a caso mobili e tiragraffi ogni poche ore (come i diversi livelli del gioco Super Mario), la stanza diventerebbe un ambiente dinamico, più difficile da imparare per un agente perché le cose continuano a cambiare.
Due aspetti importanti di tutti i problemi di reinforcement learning sono lo spazio degli stati e lo spazio delle azioni.
Lo spazio degli stati rappresenta tutti i possibili stati (situazioni) in cui si trovano l'agente e l'ambiente in un dato momento. La dimensione dello spazio degli stati dipende dal tipo di ambiente:
Lo spazio delle azioni è l'insieme di tutte le cose che Bob può fare nell'ambiente. Nel nostro esempio del tiragraffi, le azioni di Bob potrebbero essere graffiare il tiragraffi, schiacciare un pisolino sul divano o persino rincorrersi la coda.
Analogamente allo spazio degli stati, il numero di azioni che Bob può compiere dipende dall'ambiente:
Quando Bob inizia la sua avventura con il tiragraffi, l'ambiente si trova in uno stato predefinito, chiamiamolo stato zero. Nel nostro caso, potrebbe essere la stanza con il tiragraffi già posizionato. Ogni azione che compie porta l'ambiente in nuovi stati successivi.
Per raggiungere il suo obiettivo complessivo, Bob ha bisogno di incentivi o ricompense.
La maggior parte dei problemi di RL ha ricompense predefinite. Per esempio, negli scacchi, catturare un pezzo è una ricompensa positiva, mentre subire uno scacco è una ricompensa negativa.
Nel nostro caso, potremmo dare a Bob dei premietti se osserviamo un'azione positiva, come non graffiare i mobili per un po' o se trova effettivamente uno dei tiragraffi. Potremmo anche punirlo con qualche spruzzo d'acqua in faccia se rovina le tende con le unghie.
Per misurare i progressi del percorso di apprendimento di Bob, possiamo pensare alle sue azioni in termini di passi temporali. Per esempio, al passo temporale t1 Bob esegue l'azione a1, che porta a un nuovo stato s1 (s0 era lo stato predefinito). Potrebbe anche ricevere una ricompensa r1.
Una collezione di passi temporali è detta episodio. Un episodio inizia sempre in uno stato predefinito (mobili e tiragraffi sono sistemati) e termina quando si raggiunge l'obiettivo (si trova un tiragraffi) o quando l'agente fallisce (graffia i mobili). A volte un episodio può anche terminare in base al tempo trascorso (come negli scacchi).
Come un abile giocatore di scacchi, Bob non dovrebbe cercare un tiragraffi qualsiasi. Dovrebbe puntare a quello che rende i premietti più abbondanti. Questo mette in luce un dilemma classico nel reinforcement learning: esplorazione vs. sfruttamento.
Anche se un tiragraffi invitante può offrire una gratificazione immediata, un'esplorazione più strategica potrebbe portare a un premio da jackpot più avanti. Proprio come un giocatore di scacchi potrebbe rinunciare a una cattura per ottenere una posizione superiore, Bob potrebbe inizialmente graffiare un tiragraffi subottimale (esplorazione) per scoprire il paradiso definitivo dei graffi (sfruttamento). Questa strategia di lungo periodo è cruciale per massimizzare le ricompense in ambienti complessi.
In altre parole, Bob deve bilanciare lo sfruttamento (restare su ciò che funziona meglio) con l'esplorazione (avventurarsi di tanto in tanto alla ricerca di nuovi tiragraffi). Esplorare troppo può far perdere tempo, soprattutto in ambienti continui, mentre sfruttare troppo può far perdere opportunità migliori.
Per fortuna, ci sono strategie intelligenti che Bob può adottare:
Usando queste strategie (o altre fuori dall'ambito di questo tutorial), Bob può trovare un equilibrio tra esplorare l'ignoto e restare su ciò che funziona.
Bob non può capire da solo come massimizzare il numero di premietti. Ha bisogno di metodi e strumenti che guidino le sue decisioni in ogni stato dell'ambiente. Qui entrano in gioco gli algoritmi di reinforcement learning.
In un'ottica più ampia, gli algoritmi di reinforcement learning possono essere classificati in base a come fanno interagire gli agenti con l'ambiente e imparare dall'esperienza. Le due categorie principali sono model-based e model-free.
Negli algoritmi model-based, l'agente (come Bob) costruisce un modello interno dell'ambiente. Questo modello rappresenta le dinamiche dell'ambiente, incluse le transizioni di stato e le probabilità di ricompensa. L'agente può quindi usare questo modello per pianificare e valutare diverse azioni prima di eseguirle nell'ambiente reale.
Questo approccio ha il vantaggio di essere più efficiente in termini di campioni, soprattutto in ambienti complessi. Significa che Bob potrebbe richiedere meno tentativi di graffio per identificare il tiragraffi ottimale rispetto a metodi puramente per tentativi ed errori. E questo perché Bob può pianificare e valutare prima di agire.
Lo svantaggio è che costruire un modello accurato può essere difficile, specialmente per ambienti complessi. Il modello potrebbe non riflettere fedelmente l'ambiente reale, portando a comportamenti subottimali.
Un comune algoritmo RL model-based è Dyna-Q, che in realtà combina apprendimento model-based e model-free. Costruisce un modello dell'ambiente e lo utilizza per pianificare le azioni, imparando contemporaneamente direttamente dall'esperienza tramite il Q-learning model-free (che spiegheremo tra poco).
Questo approccio punta a imparare direttamente dall'interazione con l'ambiente senza costruire esplicitamente un modello interno. L'agente (Bob) impara il valore degli stati e delle azioni o la strategia ottimale tramite tentativi ed errori.
Il RL model-free offre un approccio più semplice negli ambienti in cui è difficile costruire un modello accurato. Per Bob, ciò significa che non deve creare una mappa mentale complessa della stanza: può imparare graffiando e sperimentando le conseguenze.
Il RL model-free eccelle in ambienti dinamici in cui le regole possono cambiare. Se cambia la disposizione dei mobili della stanza, Bob può adattare l'esplorazione e imparare i nuovi punti ottimali per graffiare.
Tuttavia, imparare solo tramite tentativi ed errori può essere meno efficiente in termini di campioni. Bob potrebbe dover graffiare molti mobili prima di trovare costantemente il tiragraffi più gratificante.
Alcuni comuni algoritmi RL model-free includono:
La scelta dell'algoritmo dipende da vari fattori: la complessità dell'ambiente, la disponibilità di risorse o il livello di interpretabilità desiderato.
Gli approcci model-based possono essere preferibili per ambienti più semplici in cui è fattibile costruire un modello accurato. Gli approcci model-free, invece, sono spesso più pratici per scenari reali complessi.
Inoltre, con l'ascesa del deep learning, i Deep Q-Networks (DQN) e altri algoritmi di deep RL stanno diventando sempre più popolari per affrontare compiti complessi con spazi degli stati ad alta dimensionalità.
Concentriamoci ora su un singolo algoritmo e approfondiamo il Q-learning.
Il Q-learning è un algoritmo model-free che insegna agli agenti la strategia vincente ottimale attraverso interazioni intelligenti con l'ambiente.
Torniamo al nostro esempio del gatto e immaginiamo di risolvere una versione arcade del problema con un ambiente discreto e un insieme finito di azioni.
Diciamo di fornire a Bob una tabella. Le colonne rappresentano le azioni disponibili, mentre ogni riga associa l'azione a uno specifico stato dello spazio degli stati.
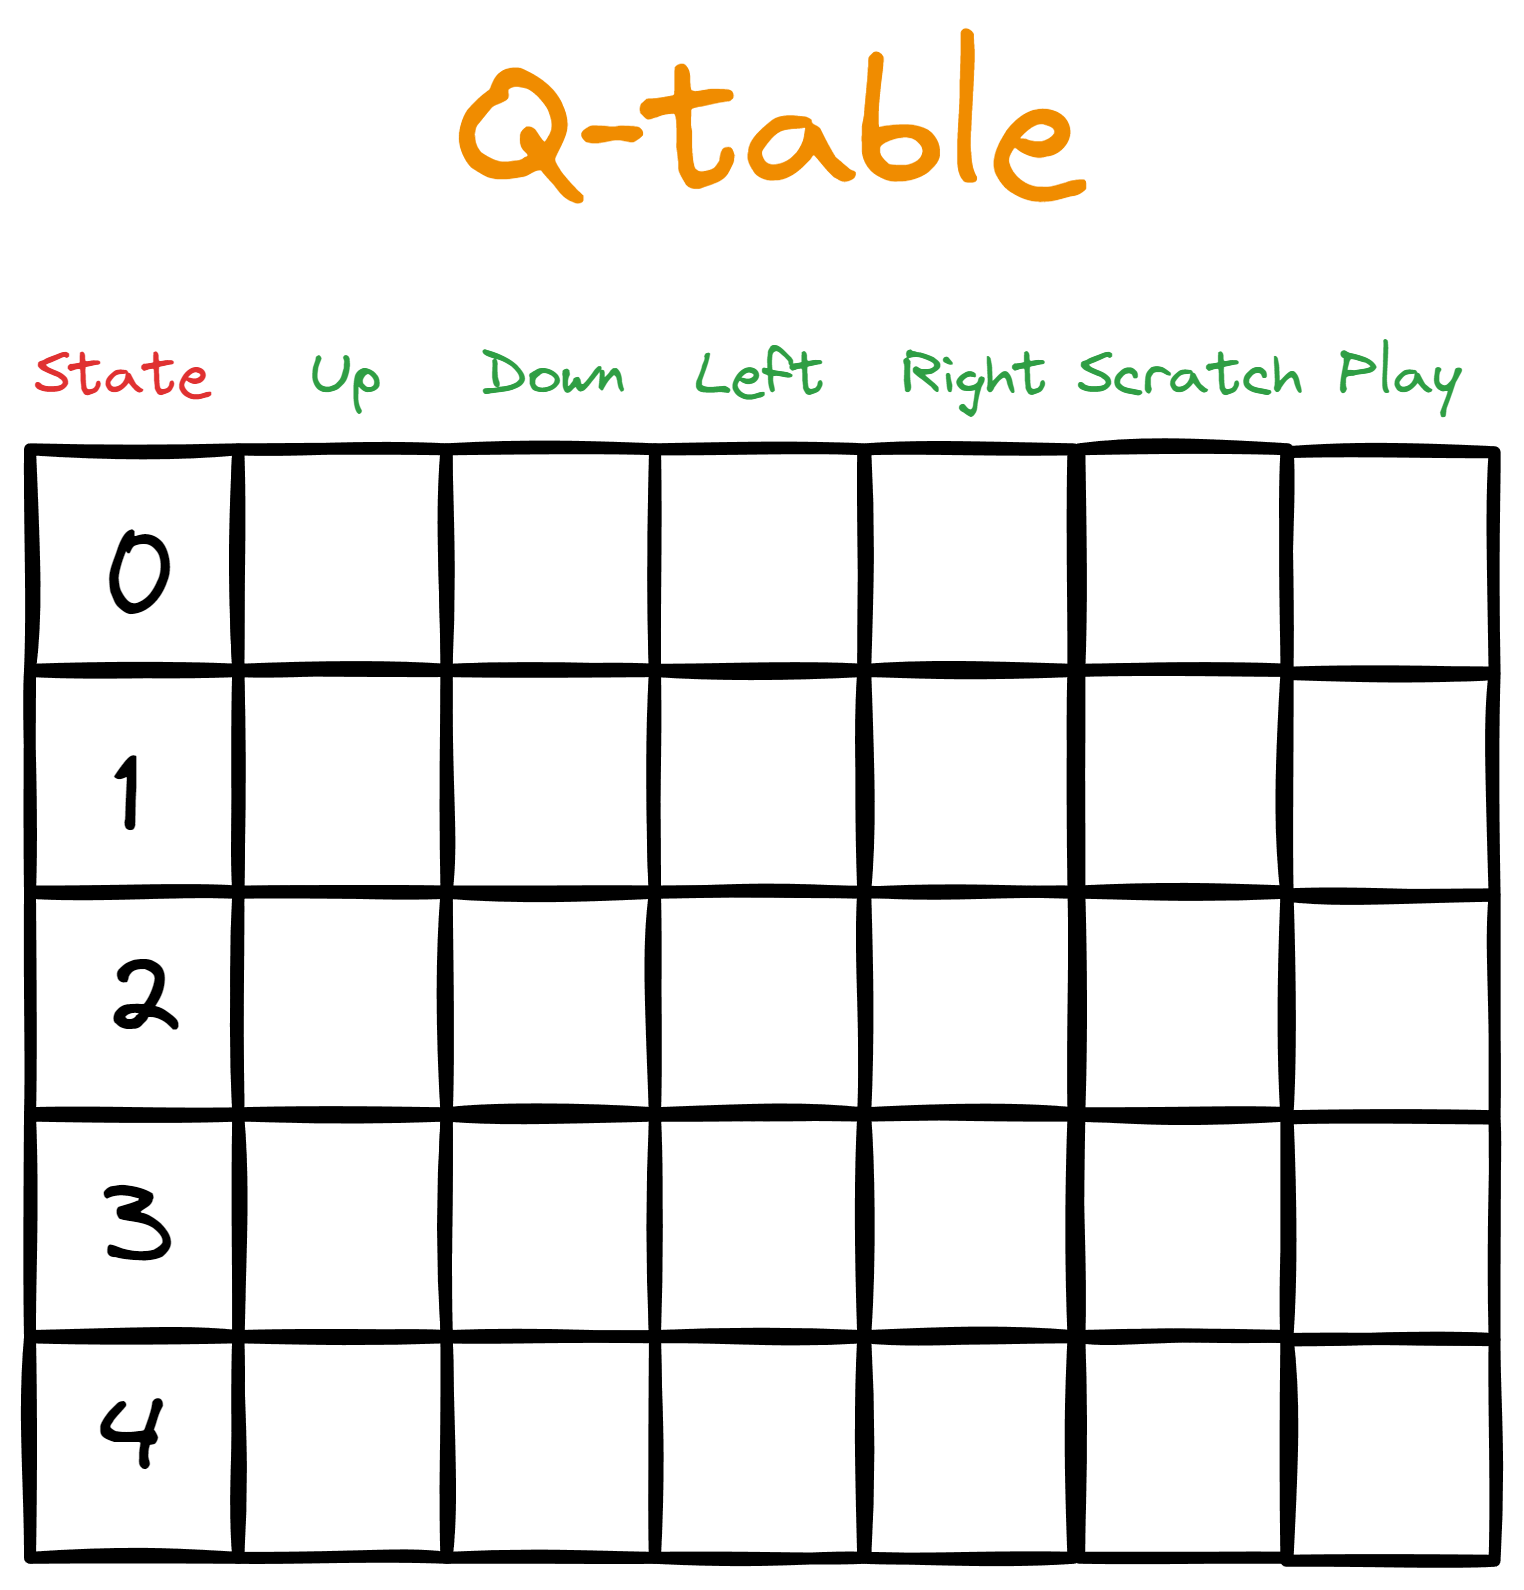
All'inizio riempiamo la tabella di zeri, che rappresentano i valori Q iniziali: per questo la chiamiamo Q-table.
Poi avviamo un ciclo di interazione dallo stato predefinito (l'inizio di un episodio. Nel ciclo, Bob compie l'azione con il valore Q più alto per lo stato dato. Tuttavia, al primo passaggio nel ciclo non ci sarà alcun valore Q più alto a guidare l'azione di Bob, dato che inizialmente tutti i valori Q sono zero.
Qui entrano in gioco le strategie di esplorazione (come l'esplorazione casuale o epsilon-greedy). Queste strategie aiutano Bob a raccogliere informazioni quando la Q-table è vuota.
Una volta aggiornata la Q-table, Bob avvia di nuovo un ciclo di interazione. L'azione che compie produce una ricompensa e un nuovo stato. Quindi calcoliamo nuovi valori Q per ciascuna azione che Bob può compiere nel nuovo stato (tra poco mostreremo come calcolare i valori Q).
L'episodio continua fino alla terminazione (Bob può compiere un numero qualsiasi di passi in ogni episodio), e poi si ricomincia. Ogni episodio successivo avrà una Q-table più ricca, rendendo Bob più intelligente.
Ecco una panoramica ad alto livello dei passaggi coinvolti:
Passaggi come uno e due possono essere immediati, ma gli altri richiedono più spiegazioni.
Al passo temporale 1, quando Bob compie la sua prima azione, sarà casuale, dato che tutti i valori Q sono zero. Nei passi successivi, Bob deve considerare l'equilibrio tra esplorazione e sfruttamento.
Per aiutarlo, diamo a Bob un iperparametro chiamato epsilon con un valore piccolo, in genere 0,1. Poi diciamo a Bob di generare un numero casuale tra 0 e 1 e, se il numero è inferiore a epsilon, di scegliere un'azione casuale indipendentemente dal suo valore Q.
Se è maggiore di epsilon, Bob sceglierà l'azione con il valore Q più alto. In questo modo, Bob esplorerà per una frazione epsilon (0,1 o 10%) del tempo e sfrutterà per (1 - epsilon, ovvero 0,9 o 90%) del tempo.
Quanto appena descritto si chiama politica epsilon-greedy. Le politiche definiscono come l'agente compie azioni e come si calcolano i valori Q.
Le regole per calcolare la ricompensa sono di solito definite da chi crea l'ambiente. Per esempio, potresti decidere di dare a Bob un premietto per usare un tappeto da graffiare e cinque premietti per saltare abbastanza in alto da graffiare quello sul muro. Potresti anche punire Bob se graffia oggetti di valore.
Ma la maggior parte del tempo non ci sarà alcuna ricompensa, perché Bob dormirà, camminerà o giocherà.
La formula per calcolare il valore Q può incutere timore, quindi vediamola prima per intero e poi spieghiamola passo dopo passo:
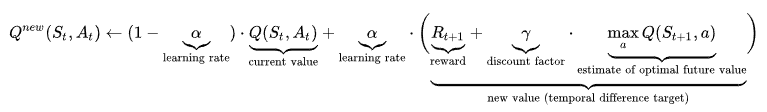
Consideriamo l'inizio della formula:
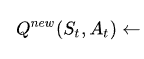
Questa parte dice: "Dato lo stato e l'azione precedenti, il nuovo valore Q è calcolato come (...)".
La parte sotto è il valore Q attuale (che sta per diventare quello vecchio) che l'agente ha usato per compiere l'azione.

Ora consideriamo la parte finale:

St+1 è il nuovo stato risultante dall'esecuzione dell'azione At. Quindi, questa parte trova il valore Q più grande tra tutte le azioni (a) in quel nuovo stato. Moltiplichiamo tale valore per un parametro γ chiamato gamma (fattore di sconto) e sommiamo il risultato alla ricompensa ricevuta.
Se impostiamo gamma vicino a 1, diamo un peso maggiore alle ricompense future. Se lo abbassiamo verso zero, enfatizziamo di più la ricompensa corrente Rt+1. Ciò significa che gamma è un altro parametro che possiamo usare per bilanciare esplorazione e sfruttamento.
Infine, abbiamo alfa (α), che controlla la velocità di addestramento e varia da 0 a 1. Valori vicini a 1 rendono gli aggiornamenti dei valori Q più ampi, quindi l'agente impara più rapidamente, rendendo più pesante il lato destro del segno più. Al contrario, valori vicini a 0 rendono più pesante il lato sinistro, che contiene il valore Q attuale.
Usare il learning rate per controllare la velocità di addestramento assicura che l'agente non progredisca troppo rapidamente dimenticando informazioni vecchie. Garantisce anche che non impari troppo lentamente, rischiando di perdere informazioni importanti.
Questa è la parte più impegnativa per capire il Q-learning, e spero che tu abbia colto a grandi linee come funziona.
Come per tutto, in Python esistono framework per risolvere problemi di reinforcement learning. Il più popolare è Gymnasium, che include oltre 2000 ambienti preconfigurati (tutti ben documentati).
$ pip install "gymnasium[atari]"
$ pip install autorom[accept-rom-license]
$ AutoROM --accept-license

import gymnasium as gym
env = gym.make("ALE/Breakout-v5")
L'ambiente che abbiamo appena caricato si chiama Breakout. Ecco come appare:
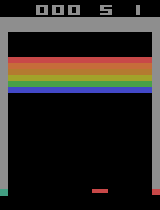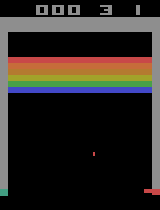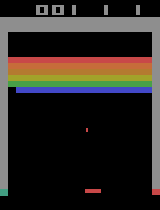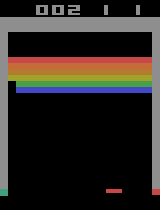
L'obiettivo qui è che la barretta (l'agente) impari a eliminare tutti i mattoncini tramite tentativi ed errori. Le regole del gioco determinano penalità e ricompense.
Concluderemo l'articolo mostrando come eseguire episodi di interazione e visualizzare i progressi dell'agente con una GIF come quella sopra.
Ecco il codice per il ciclo di interazione:
epochs = 0

frames = []  # for animation
done = False

env = gym.make("ALE/Breakout-v5", render_mode="rgb_array")
observation, info = env.reset()

while not done:
    action = env.action_space.sample()
    observation, reward, terminated, truncated, info = env.step(action)

    # Put each rendered frame into dict for animation
    frames.append(
        {
            "frame": env.render(),
            "state": observation,
            "action": action,
            "reward": reward,
        }
    )

    epochs += 1
    if epochs == 1000:
        break
Abbiamo appena eseguito mille passi temporali, in altre parole, l'agente ha compiuto 1000 azioni. Tuttavia, tutte queste azioni sono puramente casuali: non sta imparando dagli errori passati. Per verificarlo, possiamo usare la variabile frames per creare una GIF:
from moviepy.editor import ImageSequenceClip
# !pip install moviepy - if you don’t have moviepy

def create_gif(frames: dict, filename, fps=100):
    """
    Creates a GIF animation from a list of RGBA NumPy arrays.

    Args:
        frames: A list of RGBA NumPy arrays representing the animation frames.
        filename: The output filename for the GIF animation.
        fps: The frames per second of the animation (default: 10).
    """
    rgba_frames = [frame["frame"] for frame in frames]

    clip = ImageSequenceClip(rgba_frames, fps=fps)
    clip.write_gif(filename, fps=fps)

# Example usage
create_gif(frames, "animation.gif") #saves the GIF locally
Nota: se compare l'errore "RuntimeError: No ffmpeg exe could be found", prova ad aggiungere le due righe di codice seguenti prima di importare moviepy:
from moviepy.config import change_settings
change_settings({"FFMPEG_BINARY": "/usr/bin/ffmpeg"})
Il nostro primo snippet ha restituito lo stato dell'ambiente come array RGBA per ogni passo temporale, e sono memorizzati in frames. Mettendo insieme tutti i frame con la libreria moviepy, possiamo creare la GIF che hai visto prima:

Come nota a margine, puoi regolare il parametro fps per rendere la GIF più veloce se esegui molti passi temporali.
Ora che vediamo che l'agente sta semplicemente eseguendo azioni casuali, è il momento di provare qualche algoritmo. Puoi farlo passo dopo passo in questo corso su Reinforcement Learning with Gymnasium in Python, dove esplorerai molti algoritmi, tra cui Q-learning, SARSA e altro.
Assicurati di usare la funzione che abbiamo appena creato per animare i progressi dei tuoi agenti e divertiti!
Il reinforcement learning è una delle cose più intriganti dell'informatica e del machine learning. In questo tutorial, abbiamo visto i concetti fondamentali dell'RL, dagli agenti e ambienti fino agli algoritmi model-free come il Q-learning.
Tuttavia, creare agenti di livello mondiale capaci di risolvere problemi complessi come scacchi o videogiochi richiederà tempo e pratica. Ecco quindi alcune risorse che possono aiutarti lungo il percorso:
Grazie per la lettura!
Scopri di più su IA e reinforcement learning!
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



