
Last chance! 50% off DataCamp Premium
Sale ends in
Basale en deep reinforcement learning (RL)-modellen doen vaak meer denken aan sciencefiction-AI dan aan huidige large language models. Laten we kijken hoe RL deze agent in staat stelt een heel moeilijk level in Super Mario uit te spelen:
In het begin heeft de agent geen idee hoe dit spel werkt. Hij kent de besturing niet, weet niet hoe hij vooruitgang boekt, wat de obstakels zijn of wanneer het spel is afgelopen. De agent moet dit allemaal leren zonder menselijke tussenkomst—puur dankzij reinforcement learning-algoritmen.
RL-agents kunnen problemen oplossen zonder vooraf gedefinieerde oplossingen of expliciet geprogrammeerde acties en, vooral, zonder grote hoeveelheden data. Daarom heeft RL een grote impact op veel vakgebieden. Het wordt bijvoorbeeld gebruikt in:
Reinforcement learning is een snel evoluerend vakgebied met enorme potentie. Naarmate het onderzoek vordert, mogen we nog meer baanbrekende toepassingen verwachten op gebieden als resourcebeheer, gezondheidszorg en gepersonaliseerd leren.
Daarom is dit een uitstekend moment om meer te leren over dit fascinerende deelgebied van machine learning. In deze tutorial helpen we je de basis van reinforcement learning te begrijpen en leggen we stap voor stap concepten uit zoals agent, omgeving, actie, toestand, beloning en meer.
Stel, je wilt je kat Bob leren om meerdere krabpalen in een kamer te gebruiken in plaats van je dure meubels. In termen van reinforcement learning is Bob de agent, de lerende en de beslisser. Hij moet leren welke dingen oké zijn om aan te krabben (kleden en palen) en welke niet (banken en gordijnen).
De kamer is de omgeving waarmee onze agent interageert. Die biedt uitdagingen (verleidelijke meubels) en het gewenste doel (een bevredigende krabpaal).
Er zijn twee hoofdtypen omgevingen in RL:
Onze kamer is ook een statische omgeving. De meubels bewegen niet en de krabpalen blijven staan.
Maar als je de meubels en krabpalen elke paar uur willekeurig verplaatst (zoals verschillende levels in Super Mario), wordt de kamer een dynamische omgeving, wat lastiger is voor een agent om te leren omdat dingen blijven veranderen.
Twee belangrijke aspecten van alle reinforcement learning-problemen zijn de toestandsruimte en de actieruimte.
De toestandsruimte vertegenwoordigt alle mogelijke toestanden (situaties) waarin de agent en de omgeving zich op elk moment kunnen bevinden. De grootte van de toestandsruimte hangt af van het type omgeving:
De actieruimte omvat alles wat Bob in de omgeving kan doen. In ons krabpaalvoorbeeld kunnen Bobs acties zijn: aan de paal krabben, op de bank dutten of zelfs zijn staart achternazitten.
Net als bij de toestandsruimte hangt het aantal acties dat Bob kan ondernemen af van de omgeving:
Wanneer Bob aan zijn krabpaalavontuur begint, bevindt de omgeving zich in een standaardtoestand, laten we die toestand nul noemen. In ons geval is dat de kamer met de krabpaal klaar voor gebruik. Elke actie die hij neemt, brengt de omgeving in nieuwe, opeenvolgende toestanden.
Om zijn overkoepelende doel te bereiken, heeft Bob prikkels of beloningen nodig.
De meeste RL-problemen hebben vooraf gedefinieerde beloningen. In schaken is bijvoorbeeld het slaan van een stuk een positieve beloning, terwijl schaak gezet worden een negatieve beloning is.
In ons geval kunnen we Bob traktaties geven als we een positieve actie zien, zoals een tijdje geen meubels krabben, of als hij daadwerkelijk een van de krabpalen vindt. We kunnen hem ook bestraffen met een paar waterstraaltjes in zijn gezicht als hij aan de gordijnen krabt.
Om de voortgang van Bobs leertraject te meten, kunnen we zijn acties zien als tijdstappen. Bijvoorbeeld: op tijdstap t1 neemt Bob actie a1, wat resulteert in een nieuwe toestand s1 (s0 was de standaardtoestand). Hij kan ook een beloning r1 krijgen.
Een verzameling tijdstappen heet een episode. Een episode begint altijd in een standaardtoestand (de meubels en palen staan klaar) en eindigt wanneer het doel is bereikt (een paal is gevonden) of de agent faalt (krabt aan meubels). Soms kan een episode ook eindigen op basis van de verstreken tijd (zoals in schaken).
Net als een goede schaker moet Bob niet zomaar een willekeurige krabpaal zoeken. Bob wil juist die paal die de meeste traktaties oplevert. Dit illustreert een klassiek dilemma in reinforcement learning: exploratie vs. exploitatie.
Hoewel een verleidelijke paal directe voldoening kan geven, kan strategischer verkennen later tot een jackpot aan traktaties leiden. Net zoals een schaker een slag kan laten schieten om een betere positie te krijgen, kan Bob in eerste instantie een suboptimale paal krabben (exploratie) om uiteindelijk de ultieme krabplek te ontdekken (exploitatie). Deze langetermijnstrategie is cruciaal voor agents om beloningen te maximaliseren in complexe omgevingen.
Met andere woorden, Bob moet exploitatie (vasthouden aan wat het beste werkt) in balans brengen met exploratie (af en toe op zoek gaan naar nieuwe krabpalen). Te veel exploreren kan tijdverspilling zijn, zeker in continue omgevingen, terwijl te veel exploiteren ervoor kan zorgen dat Bob iets beters misloopt.
Gelukkig zijn er slimme strategieën die Bob kan gebruiken:
Door deze strategieën te gebruiken (of andere die buiten het bestek van onze tutorial vallen) kan Bob een balans vinden tussen het onbekende verkennen en vasthouden aan wat werkt.
Bob kan niet in z’n eentje uitvinden hoe hij het aantal traktaties maximaliseert. Hij heeft methoden en tools nodig om zijn beslissingen te sturen in elke toestand van de omgeving. Hier schieten reinforcement learning-algoritmen Bob te hulp.
In bredere zin kun je reinforcement learning-algoritmen indelen op basis van hoe ze agents met de omgeving laten interageren en van ervaring laten leren. De twee belangrijkste categorieën zijn model-based en model-free.
In model-based algoritmen bouwt de agent (zoals Bob) een intern model van de omgeving. Dit model beschrijft de dynamiek van de omgeving, inclusief toestandsovergangen en beloningskansen. De agent kan dit model vervolgens gebruiken om acties te plannen en te evalueren voordat hij ze in de echte omgeving uitvoert.
Dit heeft als voordeel dat het efficiënter met samples omgaat, vooral in complexe omgevingen. Dat betekent dat Bob mogelijk minder krabpogingen nodig heeft om de optimale paal te vinden dan bij pure trial-and-error. En dat komt doordat Bob kan plannen en evalueren vóórdat hij handelt.
Het nadeel is dat het bouwen van een nauwkeurig model lastig kan zijn, zeker in complexe omgevingen. Het model weerspiegelt mogelijk niet exact de echte omgeving, wat kan leiden tot suboptimaal gedrag.
Een bekend model-based RL-algoritme is Dyna-Q, dat eigenlijk model-based en model-free leren combineert. Het construeert een model van de omgeving en gebruikt dat voor actieplanning, terwijl het tegelijkertijd direct van ervaring leert via model-free Q-learning (dat we zo uitleggen).
Deze aanpak richt zich op leren door direct te interageren met de omgeving, zonder expliciet een intern model te bouwen. De agent (Bob) leert de waarde van toestanden en acties of de optimale strategie via trial-and-error.
Model-free RL biedt een simpelere aanpak in omgevingen waar een nauwkeurig model bouwen lastig is. Voor Bob betekent dit dat hij geen complex mentaal kaartje van de kamer hoeft te maken – hij kan leren door te krabben en de consequenties te ervaren.
Model-free RL blinkt uit in dynamische omgevingen waar de regels kunnen veranderen. Als de indeling van de kamer verandert, kan Bob zijn exploratie aanpassen en de nieuwe optimale krapplekken leren.
Alleen leren via trial-and-error kan echter minder sample-efficiënt zijn. Bob moet misschien veel meubels krabben voordat hij consequent de meest belonende paal vindt.
Enkele gangbare model-free RL-algoritmen zijn:
Welk algoritme je kiest, hangt af van diverse factoren: de complexiteit van de omgeving, de beschikbare resources of het gewenste niveau van uitlegbaarheid.
Model-based benaderingen kunnen de voorkeur hebben voor simpelere omgevingen waar een nauwkeurig model haalbaar is. Model-free benaderingen zijn daarentegen vaak praktischer voor complexe, realistische scenario’s.
Bovendien, met de opkomst van deep learning, worden Deep Q-Networks (DQN) en andere deep RL-algoritmen steeds populairder voor het aanpakken van complexe taken met hoge-dimensionale toestandsruimten.
Laten we nu inzoomen op één algoritme en meer leren over Q-learning.
Q-learning is een model-free algoritme dat agents de optimale winnende strategie leert via slimme interacties met de omgeving.
Laten we teruggaan naar ons kattenvoorbeeld en ons voorstellen dat we een arcadeversie van het probleem oplossen met een discrete omgeving en een eindige set acties.
Stel dat we Bob een tabel geven. De kolommen vertegenwoordigen de beschikbare acties, terwijl elke rij de actie koppelt aan een specifieke toestand uit de toestandsruimte.
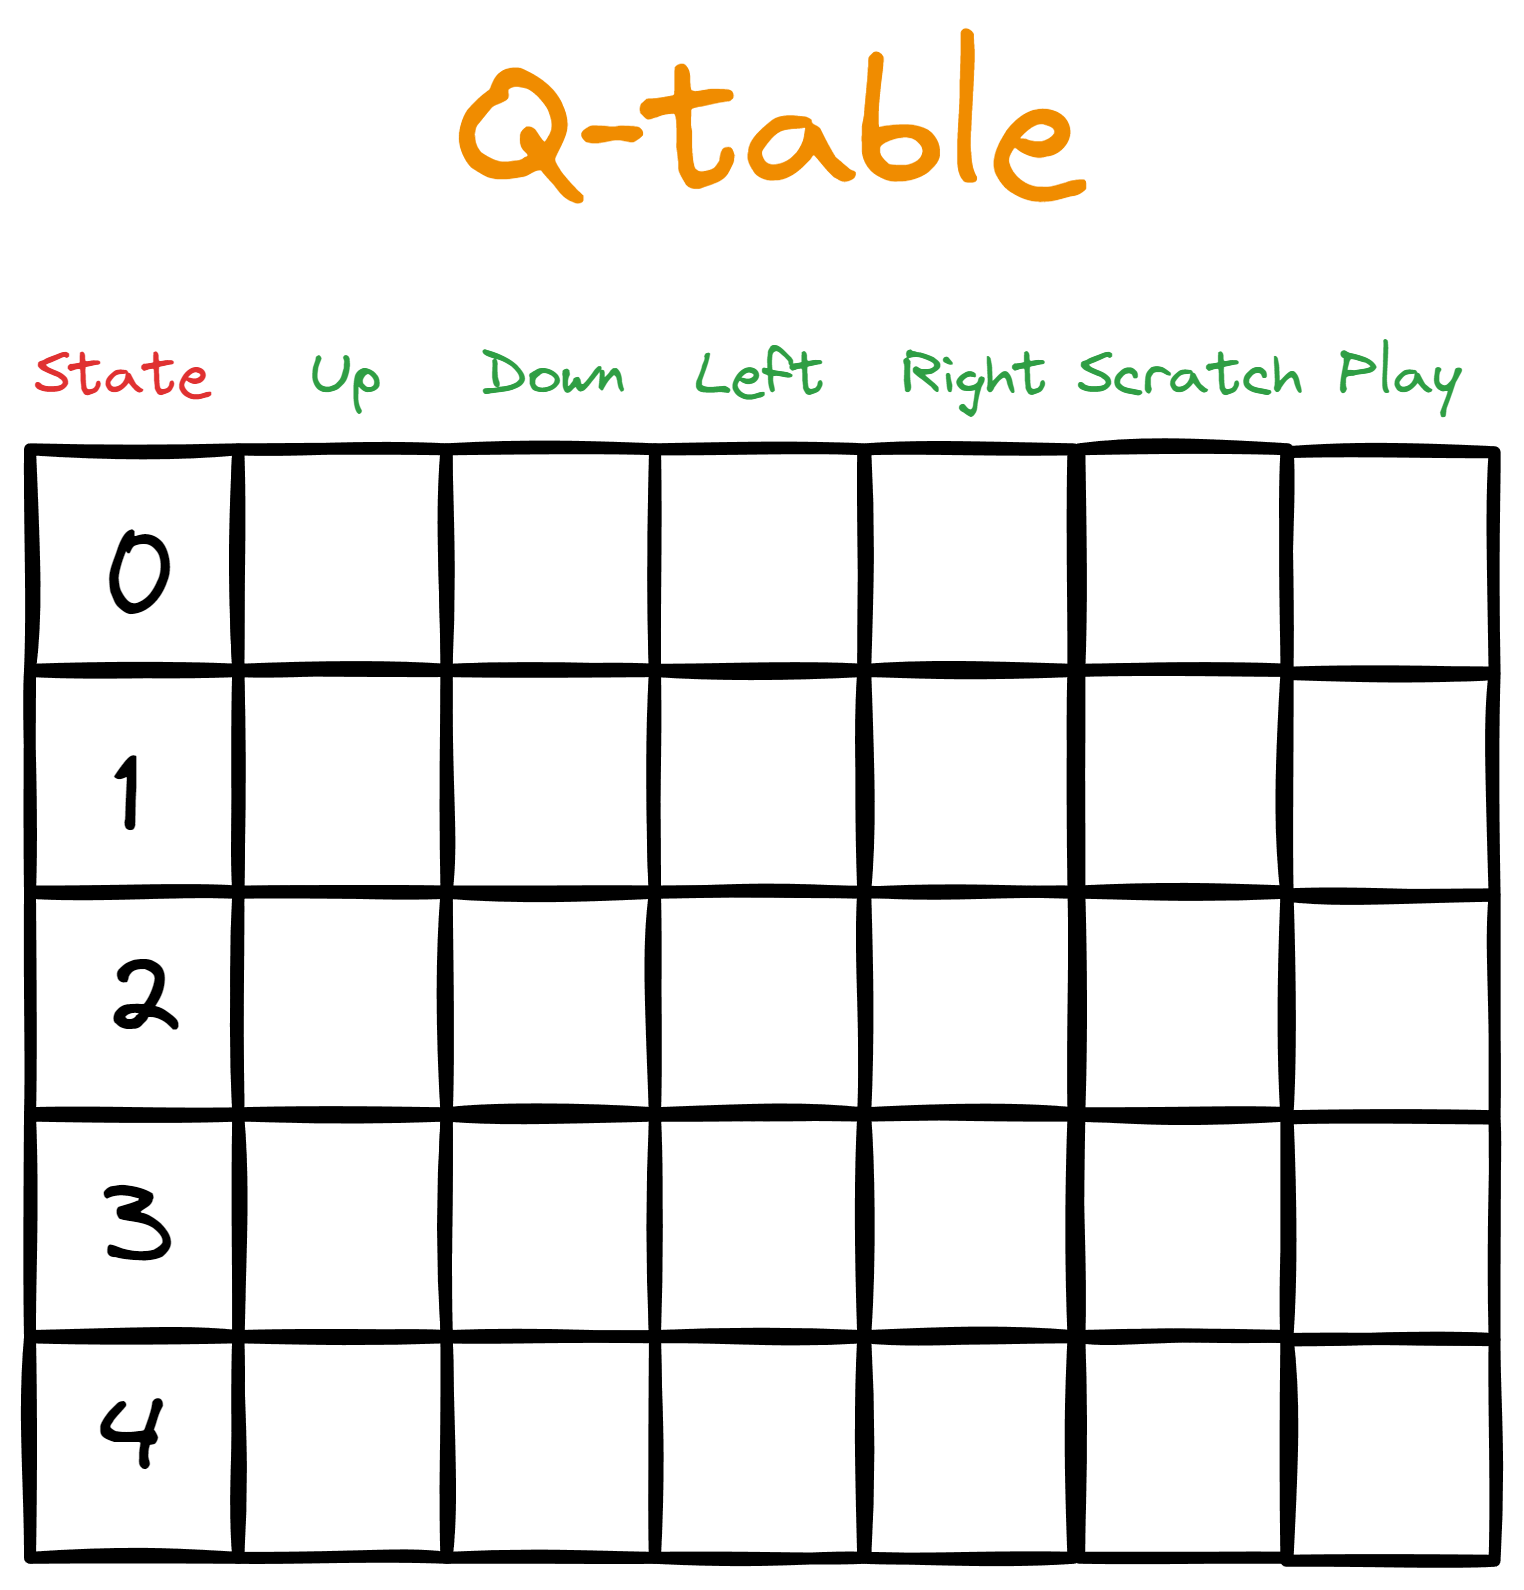
In eerste instantie vullen we de tabel met nullen, die de initiële Q-waarden voorstellen—daarom noemen we dit een Q-tabel.
Vervolgens starten we een interactielus vanuit de standaardtoestand (het begin van een episode). In de lus neemt Bob de actie met de hoogste Q-waarde voor de gegeven toestand. Maar tijdens de eerste ronde door de lus is er geen hoogste Q-waarde om Bobs actie te sturen, omdat alle Q-waarden aanvankelijk nul zijn.
Hier komen exploratiestrategieën (zoals willekeurige exploratie of epsilon-greedy) in beeld. Deze strategieën helpen Bob informatie te verzamelen wanneer de Q-tabel leeg is.
Zodra de Q-tabel is bijgewerkt, start Bob opnieuw een interactielus. De actie die hij neemt, resulteert in een beloning en een nieuwe toestand. Vervolgens berekenen we nieuwe Q-waarden voor elke actie die Bob in de nieuwe toestand kan nemen (zo meteen laten we zien hoe je Q-waarden berekent).
De episode gaat door tot beëindiging (Bob kan een willekeurig aantal stappen nemen in een episode) en dan beginnen we opnieuw. Elke volgende episode heeft een rijkere Q-tabel, waardoor Bob slimmer wordt.
Hier is een overzicht op hoog niveau van de stappen:
Stappen één en twee zijn misschien eenvoudig, maar de rest vergt meer uitleg.
Op tijdstap 1, wanneer Bob zijn eerste actie neemt, is die willekeurig, omdat alle Q-waarden nul zijn. In latere tijdstappen moet Bob de balans tussen exploratie en exploitatie bewaken.
Om daarbij te helpen, geven we Bob een hyperparameter genaamd epsilon met een kleine waarde—meestal 0,1. Dan vertellen we Bob een willekeurig getal tussen 0 en 1 te genereren en als dat getal kleiner is dan epsilon, kiest hij een willekeurige actie ongeacht de Q-waarde.
Is het hoger dan epsilon, dan kiest Bob de actie met de hoogste Q-waarde. Zo verkent Bob epsilon (0,1 of 10%) van de tijd en exploiteert hij (1 - epsilon, dus 0,9 of 90%) van de tijd.
Wat we net beschreven, heet het epsilon-greedy beleid. Beleiden definiëren hoe de agent actie onderneemt en hoe de Q-waarden worden berekend.
De regels voor het berekenen van de beloning worden meestal bepaald door de maker van de omgeving. Je kunt Bob bijvoorbeeld één traktatie geven voor het gebruiken van een krabkleed en vijf traktaties voor hoog genoeg springen om die aan de muur te krabben. Er is ook een kans dat je Bob straft voor het krabben aan waardevolle objecten.
Maar meestal is er geen beloning, omdat Bob dan slaapt, loopt of speelt.
De formule voor het berekenen van de Q-waarde kan intimiderend zijn, dus laten we hem eerst volledig zien en dan stap voor stap uitleggen:
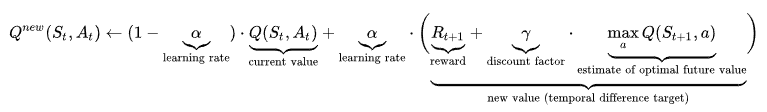
Laten we het begin van de formule bekijken:
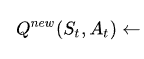
Dit deel zegt: “Gegeven de vorige toestand en actie wordt de nieuwe Q-waarde berekend als (...).”
Het onderstaande deel is de huidige (straks oude) Q-waarde die de agent gebruikte om de actie te nemen.

Laten we nu het laatste deel bekijken:

St+1 is de nieuwe toestand die ontstaat na het nemen van actie At. Dit deel zoekt dus de grootste Q-waarde over alle acties (a) in die nieuwe toestand. We vermenigvuldigen die waarde met een parameter γ, gamma (discount factor), en tellen het resultaat op bij de ontvangen beloning.
Als we gamma dicht bij 1 instellen, leggen we meer gewicht op toekomstige beloningen. Als we gamma richting nul draaien, leggen we meer nadruk op de huidige beloning Rt+1. Dit betekent dat gamma nog een parameter is waarmee we exploratie en exploitatie kunnen balanceren.
Tot slot hebben we alpha (α), dat de trainingssnelheid bepaalt en varieert van 0 tot 1. Waarden dicht bij 1 maken Q-waarde-updates groter, zodat de agent sneller leert en de rechterkant van het plusteken zwaarder weegt. Waarden dicht bij 0 maken de linkerkant zwaarder, die de huidige Q-waarde bevat.
Met de learning rate de trainingssnelheid regelen zorgt ervoor dat de agent niet te snel vooruitgaat en oude informatie vergeet. Het voorkomt ook dat hij te langzaam leert en mogelijk belangrijke informatie mist.
Dit is het lastigste deel van Q-learning begrijpen, en hopelijk heb je er een globaal gevoel voor gekregen hoe het werkt.
Zoals altijd zijn er in Python frameworks om reinforcement learning-problemen op te lossen. De populairste is Gymnasium, dat kant-en-klaar meer dan 2000 omgevingen bevat (allemaal grondig gedocumenteerd).
$ pip install "gymnasium[atari]"
$ pip install autorom[accept-rom-license]
$ AutoROM --accept-license

import gymnasium as gym
env = gym.make("ALE/Breakout-v5")
De omgeving die we zojuist hebben geladen heet Breakout. Zo ziet het eruit:
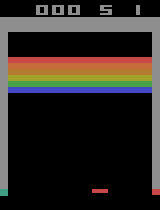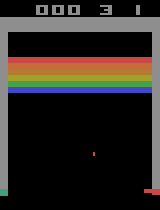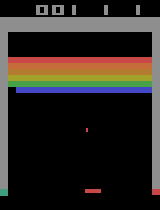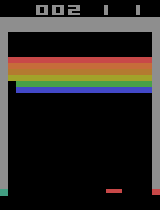
Het doel hier is dat het plankje (de agent) via trial-and-error leert hoe alle blokjes te verwijderen. De spelregels bepalen de straffen en beloningen.
We sluiten het artikel af door te laten zien hoe je je eigen interactie-episodes kunt draaien en de voortgang van de agent kunt visualiseren met een GIF zoals hierboven.
Hier is de code voor de interactielus:
epochs = 0

frames = []  # for animation
done = False

env = gym.make("ALE/Breakout-v5", render_mode="rgb_array")
observation, info = env.reset()

while not done:
    action = env.action_space.sample()
    observation, reward, terminated, truncated, info = env.step(action)

    # Put each rendered frame into dict for animation
    frames.append(
        {
            "frame": env.render(),
            "state": observation,
            "action": action,
            "reward": reward,
        }
    )

    epochs += 1
    if epochs == 1000:
        break
We hebben zojuist duizend tijdstappen uitgevoerd, of met andere woorden: de agent heeft 1000 acties uitgevoerd. Al deze acties zijn echter puur willekeurig—hij leert niet van eerdere fouten. Om dit te verifiëren, kunnen we de variabele frames gebruiken om een GIF te maken:
from moviepy.editor import ImageSequenceClip
# !pip install moviepy - if you don’t have moviepy

def create_gif(frames: dict, filename, fps=100):
    """
    Creates a GIF animation from a list of RGBA NumPy arrays.

    Args:
        frames: A list of RGBA NumPy arrays representing the animation frames.
        filename: The output filename for the GIF animation.
        fps: The frames per second of the animation (default: 10).
    """
    rgba_frames = [frame["frame"] for frame in frames]

    clip = ImageSequenceClip(rgba_frames, fps=fps)
    clip.write_gif(filename, fps=fps)

# Example usage
create_gif(frames, "animation.gif") #saves the GIF locally
Opmerking: Als je de foutmelding “RuntimeError: No ffmpeg exe could be found” krijgt, probeer dan de volgende twee regels code toe te voegen vóór het importeren van moviepy:
from moviepy.config import change_settings
change_settings({"FFMPEG_BINARY": "/usr/bin/ffmpeg"})
Ons eerste fragment gaf de toestand van de omgeving terug als RGBA-arrays voor elke tijdstap, en die zijn opgeslagen in frames. Door alle frames samen te voegen met de moviepy-bibliotheek kunnen we de GIF maken die je eerder zag:

Terzijde: je kunt de fps-parameter aanpassen om de GIF sneller te maken als je veel tijdstappen draait.
Nu we zien dat de agent simpelweg willekeurige acties uitvoert, is het tijd om wat algoritmen te proberen. Dat kun je stap voor stap doen in deze cursus Reinforcement Learning with Gymnasium in Python, waarin je veel algoritmen verkent, waaronder Q-learning, SARSA en meer.
Gebruik zeker de functie die we zojuist hebben gemaakt om de voortgang van je agents te animeren, en veel plezier!
Reinforcement learning is een van de meest intrigerende onderwerpen in de informatica en machine learning. In deze tutorial hebben we de fundamentele concepten van RL behandeld—van agents en omgevingen tot model-free algoritmen zoals Q-learning.
Het bouwen van wereldklasse agents die complexe problemen zoals schaken of videogames kunnen oplossen, kost echter tijd en oefening. Hier zijn enkele bronnen die je onderweg kunnen helpen:
Bedankt voor het lezen!
Leer meer over AI en reinforcement learning!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min


