
{count, plural, one {Khóa học} other {Khóa học}}
Reinforcement Learning với Gymnasium trong Python
{hours} giờ
13.8K
Các mô hình học tăng cường (RL) cơ bản và sâu thường có vẻ giống AI trong khoa học viễn tưởng hơn là bất kỳ mô hình ngôn ngữ lớn nào hiện nay. Hãy xem RL giúp tác tử này vượt qua một màn rất khó trong Super Mario như thế nào:
Ban đầu, tác tử chẳng biết gì về cách chơi. Nó không biết điều khiển, cách tiến bộ, đâu là chướng ngại, hay điều gì kết thúc màn chơi. Tác tử phải tự học tất cả những điều này mà không có sự can thiệp của con người — hoàn toàn nhờ sức mạnh của các thuật toán học tăng cường.
Tác tử RL có thể giải quyết bài toán mà không cần lời giải định trước hay hành động được lập trình tường minh, và quan trọng nhất là không cần lượng dữ liệu lớn. Đó là lý do RL đang tạo tác động đáng kể trong nhiều lĩnh vực. Chẳng hạn, RL được dùng trong:
Học tăng cường là một lĩnh vực phát triển nhanh với tiềm năng lớn. Khi nghiên cứu tiến triển, chúng ta có thể kỳ vọng thêm nhiều ứng dụng đột phá trong quản lý tài nguyên, chăm sóc sức khỏe và học tập cá nhân hóa.
Vì vậy, đây là thời điểm tuyệt vời để tìm hiểu lĩnh vực học máy thú vị này. Trong hướng dẫn này, chúng tôi sẽ giúp bạn nắm các nền tảng của học tăng cường và giải thích lần lượt các khái niệm như tác tử, môi trường, hành động, trạng thái, phần thưởng, và nhiều hơn nữa.
Giả sử bạn muốn dạy con mèo Bob của mình sử dụng nhiều cột cào trong một căn phòng thay vì làm hỏng bộ nội thất đắt tiền. Trong thuật ngữ học tăng cường, Bob là tác tử, người học và là bên ra quyết định. Nó cần học thứ gì có thể cào (thảm và cột) và thứ gì không (sofa và rèm cửa).
Căn phòng được gọi là môi trường mà tác tử của chúng ta tương tác. Nó mang lại thách thức (đồ nội thất hấp dẫn) và mục tiêu mong muốn (một cột cào thỏa mãn).
Có hai loại môi trường chính trong RL:
Căn phòng của chúng ta cũng là môi trường tĩnh. Đồ đạc không di chuyển, và các cột cào ở nguyên vị trí.
Nhưng nếu bạn ngẫu nhiên di chuyển đồ đạc và cột cào vài giờ một lần (như các màn khác nhau trong trò Super Mario), căn phòng sẽ trở thành môi trường động, khó hơn cho tác tử học vì mọi thứ cứ thay đổi.
Hai khía cạnh quan trọng của mọi bài toán học tăng cường là không gian trạng thái và không gian hành động.
Không gian trạng thái biểu diễn tất cả các trạng thái (tình huống) có thể có mà tác tử và môi trường rơi vào tại bất kỳ thời điểm nào. Kích thước không gian trạng thái phụ thuộc vào loại môi trường:
Không gian hành động là tất cả những gì Bob có thể làm trong môi trường. Trong ví dụ cột cào, hành động của Bob có thể là cào cột, ngủ trưa trên ghế sofa, hoặc thậm chí đuổi theo cái đuôi của mình.
Tương tự không gian trạng thái, số hành động Bob có thể thực hiện phụ thuộc vào môi trường:
Khi Bob bắt đầu hành trình chinh phục cột cào, môi trường ở trạng thái mặc định, hãy gọi là trạng thái không. Trong trường hợp này, đó có thể là căn phòng với cột cào đã được đặt sẵn. Mỗi hành động nó thực hiện sẽ đưa môi trường sang các trạng thái kế tiếp mới.
Để Bob đạt mục tiêu tổng thể, nó cần các động lực hay phần thưởng.
Hầu hết bài toán RL có phần thưởng được định nghĩa trước. Ví dụ, trong cờ vua, ăn quân là phần thưởng dương, còn bị chiếu là phần thưởng âm.
Trong trường hợp của chúng ta, ta có thể thưởng bánh khi quan sát hành động tích cực, như không cào đồ đạc trong một khoảng thời gian, hoặc khi nó thực sự tìm được một cột cào. Ta cũng có thể phạt bằng cách xịt chút nước vào mặt nếu nó cào rách rèm.
Để đo tiến độ học tập của Bob, ta có thể nghĩ các hành động của nó theo bước thời gian. Chẳng hạn, tại bước t1, Bob thực hiện hành động a1, dẫn tới trạng thái mới s1 (s0 là trạng thái mặc định). Nó cũng có thể nhận phần thưởng r1.
Một tập hợp các bước thời gian được gọi là một tập (episode). Một tập luôn bắt đầu ở trạng thái mặc định (đồ đạc và cột cào đã sắp sẵn) và kết thúc khi đạt mục tiêu (tìm được cột) hoặc tác tử thất bại (cào đồ đạc). Đôi khi, một tập cũng có thể kết thúc dựa trên lượng thời gian đã trôi qua (như trong cờ vua).
Giống một kỳ thủ giỏi, Bob không nên chỉ tìm bất kỳ cột cào nào. Bob nên muốn cái mang lại nhiều phần thưởng nhất. Điều này nêu bật thế lưỡng nan kinh điển trong học tăng cường: thăm dò vs. khai thác.
Dù một cột hấp dẫn có thể đem lại thỏa mãn tức thì, một chiến lược thăm dò bài bản có thể dẫn tới phần thưởng lớn hơn về sau. Cũng như kỳ thủ có thể bỏ qua một nước ăn để giành thế hơn, Bob có thể ban đầu cào một cột chưa tối ưu (thăm dò) để khám phá “thiên đường cào” cuối cùng (khai thác). Chiến lược dài hạn này rất quan trọng để tối đa hóa phần thưởng trong môi trường phức tạp.
Nói cách khác, Bob phải cân bằng giữa khai thác (bám vào điều hiệu quả nhất) và thăm dò (đôi khi thử tìm cột cào mới). Thăm dò quá nhiều có thể lãng phí thời gian, đặc biệt trong môi trường liên tục, trong khi khai thác quá mức có thể khiến Bob bỏ lỡ lựa chọn tốt hơn.
May mắn thay, có vài chiến lược thông minh Bob có thể dùng:
Bằng cách dùng các chiến lược này (hoặc những chiến lược khác vượt ngoài phạm vi hướng dẫn của chúng ta), Bob có thể cân bằng giữa khám phá điều chưa biết và gắn bó với điều hiệu quả.
Bob không thể tự mình tìm ra cách tối đa hóa số bánh thưởng. Nó cần phương pháp và công cụ để dẫn dắt quyết định ở mọi trạng thái của môi trường. Đây là lúc các thuật toán học tăng cường “giải cứu” Bob.
Ở góc nhìn rộng hơn, các thuật toán học tăng cường có thể được phân loại dựa trên cách chúng giúp tác tử tương tác với môi trường và học từ trải nghiệm. Hai nhóm chính là dựa trên mô hình và không dựa trên mô hình.
Trong các thuật toán dựa trên mô hình, tác tử (như Bob) xây dựng một mô hình nội tại của môi trường. Mô hình này biểu diễn động lực của môi trường, gồm chuyển trạng thái và xác suất phần thưởng. Tác tử có thể dùng mô hình để lập kế hoạch và đánh giá các hành động khác nhau trước khi thực hiện trong môi trường thật.
Cách tiếp cận này có lợi thế là hiệu quả mẫu cao hơn, đặc biệt trong môi trường phức tạp. Điều này có nghĩa Bob có thể cần ít lần thử cào hơn để xác định cột tối ưu so với cách hoàn toàn thử-sai. Đó là vì Bob có thể lập kế hoạch và đánh giá trước khi ra tay.
Nhược điểm là xây dựng mô hình chính xác có thể khó, nhất là với môi trường phức tạp. Mô hình có thể không phản ánh đúng môi trường thật, dẫn đến hành vi chưa tối ưu.
Một thuật toán RL dựa trên mô hình thường gặp là Dyna-Q, thực ra kết hợp cả học dựa trên mô hình và không dựa trên mô hình. Nó xây dựng một mô hình môi trường và dùng nó để lập kế hoạch hành động, đồng thời học trực tiếp từ trải nghiệm qua Q-learning không dựa trên mô hình (chúng ta sẽ giải thích ngay sau).
Cách này tập trung học trực tiếp từ tương tác với môi trường mà không xây mô hình nội tại tường minh. Tác tử (Bob) học giá trị của trạng thái và hành động hoặc chiến lược tối ưu thông qua thử-sai.
RL không dựa trên mô hình mang lại cách tiếp cận đơn giản hơn trong môi trường mà việc xây mô hình chính xác là thách thức. Với Bob, nghĩa là nó không cần tạo bản đồ tinh vi của căn phòng – nó có thể học bằng cách cào và trải nghiệm hệ quả.
RL không dựa trên mô hình tỏ ra xuất sắc trong môi trường động nơi quy tắc có thể thay đổi. Nếu cách bố trí nội thất thay đổi, Bob có thể thích ứng việc thăm dò và học những điểm cào tối ưu mới.
Tuy nhiên, chỉ học qua thử-sai có thể kém hiệu quả về mẫu. Bob có thể phải cào khá nhiều đồ đạc trước khi ổn định tìm được cột thưởng hậu hĩnh nhất.
Một số thuật toán RL không dựa trên mô hình phổ biến gồm:
Thuật toán nên chọn phụ thuộc nhiều yếu tố: độ phức tạp môi trường, tài nguyên sẵn có, hay mức độ dễ diễn giải mong muốn.
Cách tiếp cận dựa trên mô hình có thể phù hợp hơn cho môi trường đơn giản, nơi xây mô hình chính xác là khả thi. Mặt khác, cách không dựa trên mô hình thường thực tế hơn cho bối cảnh phức tạp, đời thực.
Ngoài ra, với sự trỗi dậy của học sâu, Deep Q-Networks (DQN) và các thuật toán RL sâu khác ngày càng phổ biến để giải quyết tác vụ phức tạp với không gian trạng thái có chiều cao.
Giờ hãy tập trung vào một thuật toán và tìm hiểu sâu hơn về Q-learning.
Q-learning là thuật toán không dựa trên mô hình giúp dạy tác tử chiến lược tối ưu thông qua tương tác thông minh với môi trường.
Hãy quay lại ví dụ con mèo và tưởng tượng chúng ta đang giải một phiên bản arcade của bài toán với môi trường rời rạc và tập hành động hữu hạn.
Giả sử chúng ta đưa cho Bob một bảng. Các cột đại diện các hành động sẵn có, còn mỗi hàng ánh xạ hành động tới một trạng thái cụ thể trong không gian trạng thái.
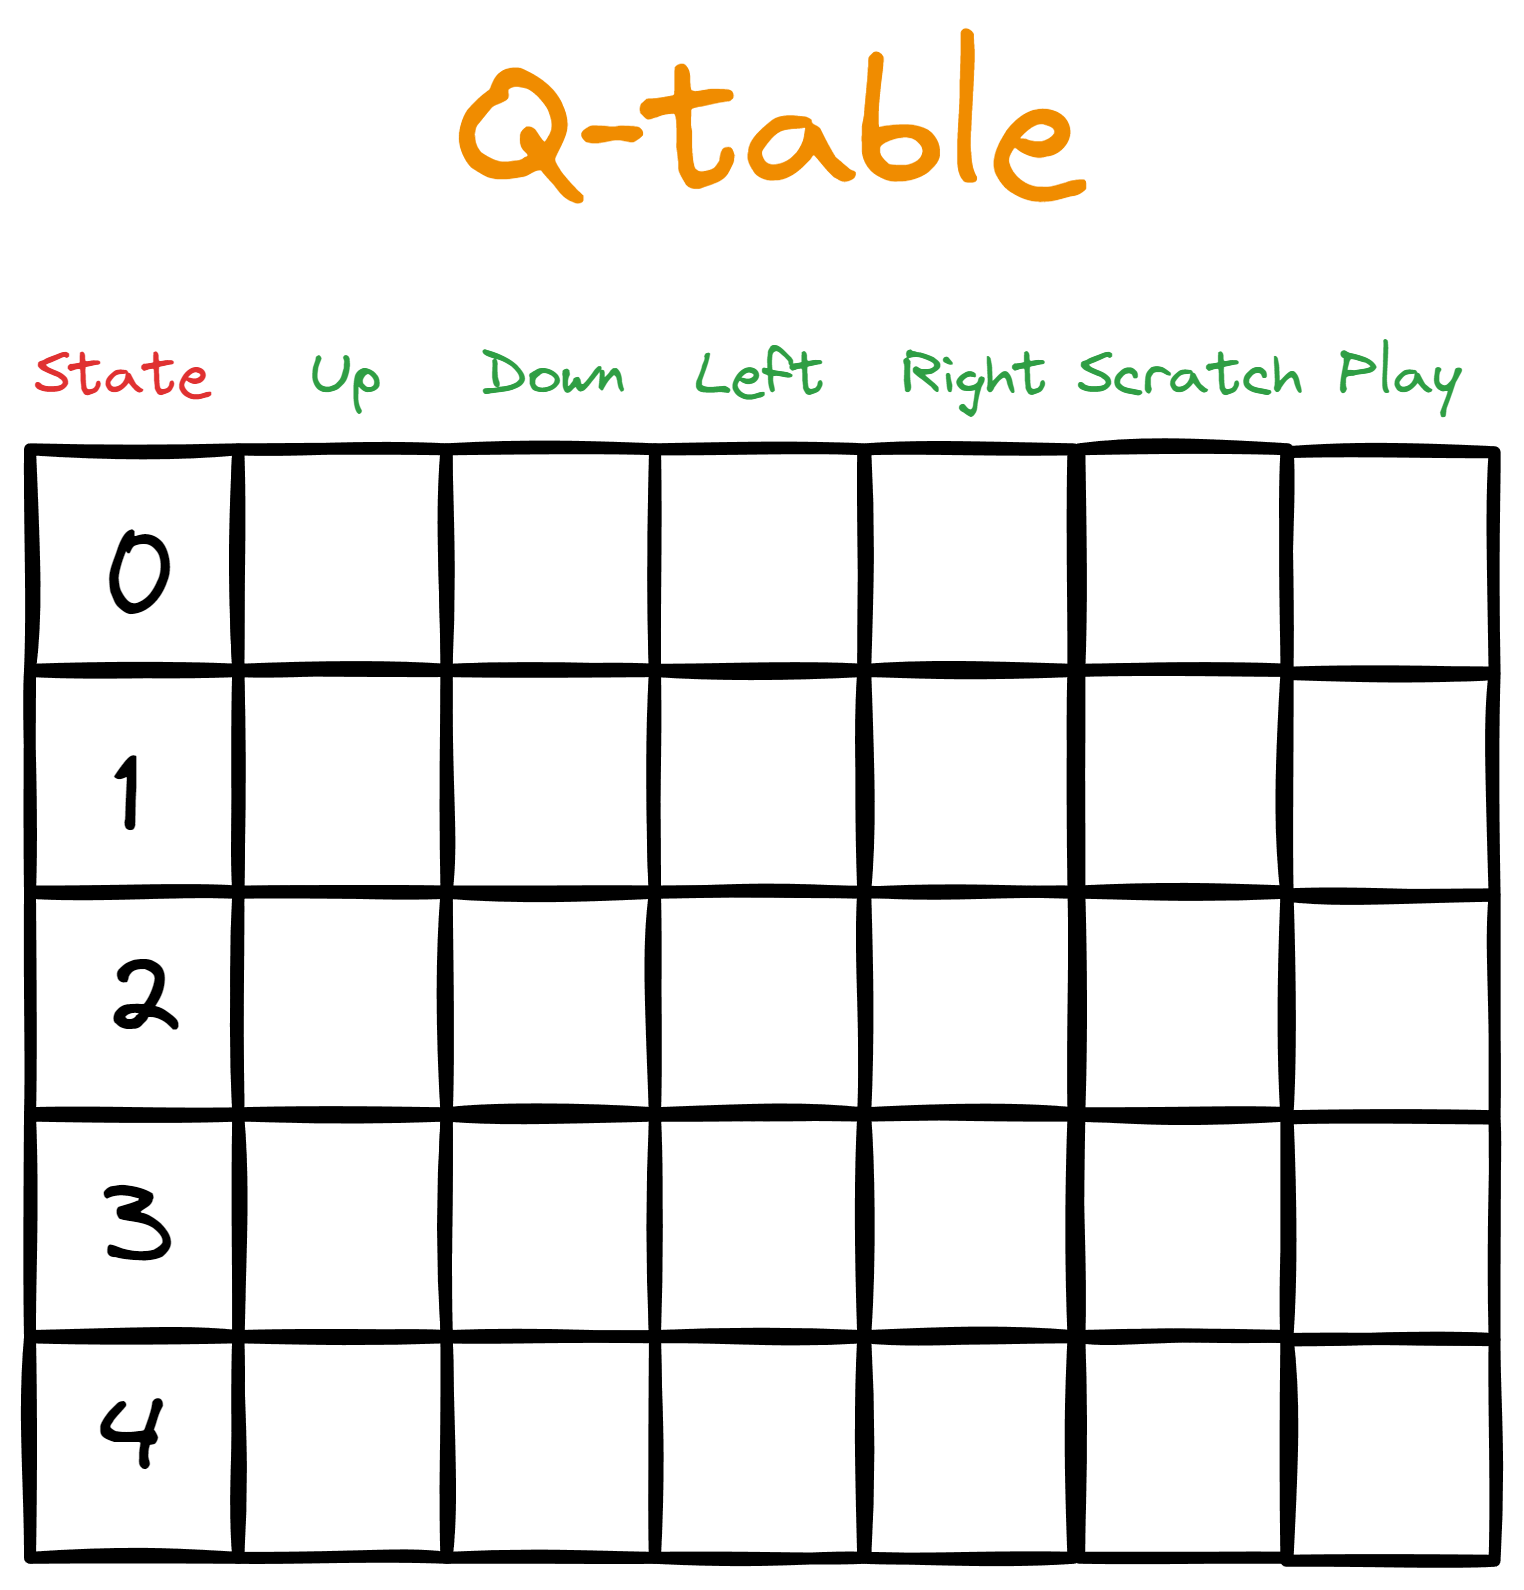
Ban đầu, chúng ta điền toàn số 0 vào bảng, biểu diễn các giá trị Q khởi tạo — vì lý do này, chúng ta gọi đây là bảng Q (Q-table).
Sau đó, chúng ta bắt đầu vòng lặp tương tác từ trạng thái mặc định (đầu tập). Trong vòng lặp, Bob thực hiện hành động có giá trị Q cao nhất cho trạng thái đã cho. Tuy nhiên, ở lượt đầu tiên qua vòng lặp, sẽ không có giá trị Q cao nhất nào để dẫn dắt hành động của Bob vì tất cả Q ban đầu đều bằng 0.
Đây là lúc các chiến lược thăm dò (như thăm dò ngẫu nhiên hoặc epsilon-greedy) phát huy tác dụng. Chúng giúp Bob thu thập thông tin khi bảng Q còn trống.
Khi bảng Q đã được cập nhật, Bob bắt đầu vòng lặp tương tác lại. Hành động nó thực hiện tạo ra một phần thưởng và một trạng thái mới. Sau đó, chúng ta tính các giá trị Q mới cho mỗi hành động Bob có thể thực hiện ở trạng thái mới (chúng ta sẽ sớm cho thấy cách tính giá trị Q).
Tập tiếp tục cho đến khi kết thúc (Bob có thể thực hiện bất kỳ số bước nào trong mỗi tập), rồi chúng ta lại bắt đầu. Mỗi tập tiếp theo sẽ có bảng Q phong phú hơn, khiến Bob thông minh hơn.
Dưới đây là tổng quan các bước:
Các bước như một và hai có thể đơn giản, nhưng phần còn lại cần giải thích thêm.
Ở bước thời gian 1, khi Bob thực hiện hành động đầu tiên, nó sẽ là ngẫu nhiên vì tất cả Q đều bằng 0. Ở các bước tiếp theo, Bob phải cân nhắc cân bằng giữa thăm dò và khai thác.
Để hỗ trợ, chúng ta cho Bob một siêu tham số gọi là epsilon với giá trị nhỏ — thường là 0,1. Sau đó, ta bảo Bob sinh một số ngẫu nhiên trong khoảng 0 đến 1 và nếu số nhỏ hơn epsilon, nó sẽ chọn hành động ngẫu nhiên bất kể giá trị Q.
Nếu số lớn hơn epsilon, Bob sẽ chọn hành động có giá trị Q cao nhất. Bằng cách này, Bob sẽ thăm dò epsilon (0,1 hay 10%) thời gian và khai thác (1 - epsilon hay 0,9 hay 90%) thời gian.
Những gì chúng ta vừa mô tả được gọi là chính sách epsilon-greedy. Chính sách định nghĩa cách tác tử thực hiện hành động và cách các giá trị Q được tính.
Quy tắc tính phần thưởng thường do người tạo môi trường đặt ra. Ví dụ, bạn có thể quyết định thưởng một chiếc bánh khi Bob dùng thảm cào và năm chiếc bánh khi nó nhảy cao đủ để cào cái gắn trên tường. Cũng có khả năng bạn sẽ phạt khi Bob cào vào đồ vật giá trị.
Nhưng phần lớn thời gian sẽ không có phần thưởng vì Bob sẽ ngủ, đi dạo, hoặc chơi đùa.
Công thức tính giá trị Q có thể đáng ngại, nên hãy xem đầy đủ trước rồi giải thích từng bước:
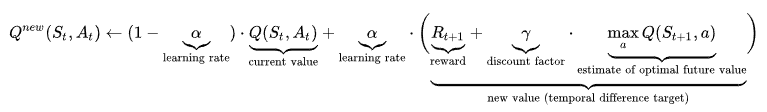
Hãy xét phần đầu của công thức:
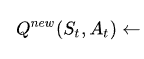
Phần này nói rằng: “Với trạng thái và hành động trước đó, giá trị Q mới được tính là (...).”
Phần dưới đây là giá trị Q hiện tại (sắp thành cũ) mà tác tử dùng để thực hiện hành động.

Giờ hãy xét phần cuối:

St+1 là trạng thái mới sau khi thực hiện hành động At. Vậy nên phần này tìm giá trị Q lớn nhất trong tất cả các hành động (a) ở trạng thái mới đó. Chúng ta nhân giá trị đó với tham số γ gọi là gamma (hệ số chiết khấu) và cộng kết quả với phần thưởng nhận được.
Nếu đặt gamma gần 1, chúng ta đặt trọng số lớn hơn cho phần thưởng tương lai. Nếu hạ gần 0, chúng ta nhấn mạnh phần thưởng hiện tại Rt+1 hơn. Điều này có nghĩa gamma là tham số khác để cân bằng thăm dò và khai thác.
Cuối cùng là alpha (α), kiểm soát tốc độ huấn luyện và nằm trong khoảng 0 đến 1. Giá trị gần 1 khiến cập nhật Q lớn hơn, tác tử học nhanh hơn, làm phía bên phải dấu cộng “nặng” hơn. Ngược lại, giá trị gần 0 làm bên trái nặng hơn, vốn chứa giá trị Q hiện tại.
Dùng tốc độ học để điều khiển tốc độ huấn luyện đảm bảo tác tử không tiến quá nhanh và quên thông tin cũ. Nó cũng đảm bảo không học quá chậm, có thể bỏ lỡ thông tin quan trọng.
Đây là phần thách thức nhất khi hiểu Q-learning, và hy vọng bạn đã nắm được cảm nhận tổng quát về cách nó vận hành.
Như mọi thứ khác, Python có các framework để giải bài toán học tăng cường. Phổ biến nhất là Gymnasium, đi kèm sẵn hơn 2000 môi trường (đều được tài liệu hóa kỹ).
$ pip install "gymnasium[atari]"
$ pip install autorom[accept-rom-license]
$ AutoROM --accept-license

import gymnasium as gym
env = gym.make("ALE/Breakout-v5")
Môi trường chúng ta vừa nạp có tên Breakout. Trông nó như thế này:
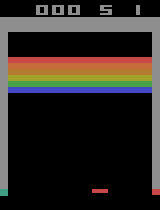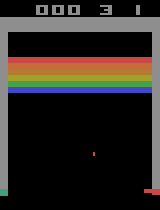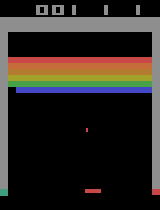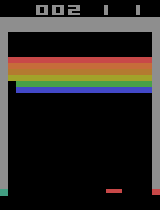
Mục tiêu ở đây là để bàn trượt (tác tử) học cách loại bỏ tất cả gạch thông qua thử-sai. Luật chơi quy định hình phạt và phần thưởng.
Chúng ta sẽ kết thúc bài viết bằng cách cho thấy cách bạn có thể tự chạy các tập tương tác và trực quan hóa tiến bộ của tác tử bằng một GIF như trên.
Đây là mã cho vòng lặp tương tác:
epochs = 0

frames = []  # for animation
done = False

env = gym.make("ALE/Breakout-v5", render_mode="rgb_array")
observation, info = env.reset()

while not done:
    action = env.action_space.sample()
    observation, reward, terminated, truncated, info = env.step(action)

    # Put each rendered frame into dict for animation
    frames.append(
        {
            "frame": env.render(),
            "state": observation,
            "action": action,
            "reward": reward,
        }
    )

    epochs += 1
    if epochs == 1000:
        break
Chúng ta vừa chạy một nghìn bước thời gian, hay nói cách khác, tác tử đã thực hiện 1000 hành động. Tuy nhiên, tất cả các hành động này hoàn toàn ngẫu nhiên — nó không học từ sai lầm trước đó. Để kiểm chứng, ta có thể dùng biến frames để tạo một GIF:
from moviepy.editor import ImageSequenceClip
# !pip install moviepy - if you don’t have moviepy

def create_gif(frames: dict, filename, fps=100):
    """
    Creates a GIF animation from a list of RGBA NumPy arrays.

    Args:
        frames: A list of RGBA NumPy arrays representing the animation frames.
        filename: The output filename for the GIF animation.
        fps: The frames per second of the animation (default: 10).
    """
    rgba_frames = [frame["frame"] for frame in frames]

    clip = ImageSequenceClip(rgba_frames, fps=fps)
    clip.write_gif(filename, fps=fps)

# Example usage
create_gif(frames, "animation.gif") #saves the GIF locally
Lưu ý: Nếu bạn gặp lỗi “RuntimeError: No ffmpeg exe could be found”, hãy thử thêm hai dòng mã sau trước khi import moviepy:
from moviepy.config import change_settings
change_settings({"FFMPEG_BINARY": "/usr/bin/ffmpeg"})
Đoạn mã đầu tiên của chúng ta trả về trạng thái của môi trường dưới dạng mảng RGBA cho mỗi bước thời gian, và chúng được lưu trong frames. Bằng cách ghép tất cả khung hình bằng thư viện moviepy, chúng ta có thể tạo GIF như bạn đã thấy ở trên:

Ngoài lề, bạn có thể điều chỉnh tham số fps để khiến GIF chạy nhanh hơn nếu bạn chạy nhiều bước thời gian.
Giờ khi thấy tác tử chỉ đang thực hiện hành động ngẫu nhiên, đã đến lúc thử vài thuật toán. Bạn có thể làm điều đó từng bước trong khóa học Reinforcement Learning with Gymnasium in Python, nơi bạn sẽ khám phá nhiều thuật toán gồm Q-learning, SARSA, và hơn thế nữa.
Hãy nhớ dùng hàm chúng ta vừa tạo để hoạt họa tiến bộ của tác tử, và tận hưởng quá trình học!
Học tăng cường là một trong những lĩnh vực hấp dẫn nhất của khoa học máy tính và học máy. Trong hướng dẫn này, chúng ta đã học các khái niệm nền tảng của RL — từ tác tử và môi trường tới các thuật toán không dựa trên mô hình như Q-learning.
Tuy nhiên, để tạo ra các tác tử đẳng cấp thế giới có thể giải quyết các bài toán phức tạp như cờ vua hay trò chơi điện tử sẽ cần thời gian và luyện tập. Dưới đây là một số tài nguyên có thể giúp bạn trên hành trình:
Cảm ơn bạn đã đọc!
Tìm hiểu thêm về AI và học tăng cường!
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Lộ trình} other {Lộ trình}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
