
Kursus
Bekerja dengan OpenAI API
3 jam
179.8K
GLM-4.7 adalah rekan coding baru Anda, dirancang untuk tampil lebih baik dalam alur kerja pengembangan yang nyata. Dibandingkan GLM-4.6, model ini menunjukkan peningkatan jelas pada coding multibahasa dan berbasis agen, tugas berbasis terminal, serta penggunaan tool, dengan hasil kuat di SWE-bench, SWE-bench Multilingual, dan Terminal Bench 2.0. Model ini juga mendukung berpikir sebelum bertindak, sehingga lebih andal untuk tugas kompleks dalam kerangka kerja agen modern.
Dalam tutorial ini, kita langsung menyiapkan lingkungan Runpod, menginstal semua dependensi yang diperlukan, dan mengkloning llama.cpp dengan dukungan CUDA penuh. Lalu kita mengunduh model GLM-4.7 2-bit dari Hugging Face, menjalankannya menggunakan mode CLI dan server, dan akhirnya menguji server yang berjalan menggunakan OpenAI SDK.
Anda juga dapat melihat panduan kami untuk menjalankan GLM 4.7 Flash secara lokal.
Sebelum menjalankan GLM-4.7 secara lokal, pastikan sistem Anda memenuhi persyaratan di bawah ini.
Diperlukan GPU NVIDIA untuk performa yang dapat digunakan.
Instal driver NVIDIA terbaru dan verifikasi instalasi dengan:
nvidia-smiJika perintah ini berjalan dan menampilkan GPU Anda, setelan driver sudah benar.
CUDA diperlukan untuk akselerasi GPU saat menjalankan GLM-4.7. Jika Anda membangun llama.cpp dari sumber, CUDA harus terdeteksi dengan benar saat build.
Saat menggunakan biner pra-bangun yang mendukung CUDA, runtime CUDA yang berfungsi harus sudah terinstal di sistem. Tanpa dukungan CUDA, GLM-4.7 akan kembali menggunakan eksekusi CPU, yang terlalu lambat untuk penggunaan nyata.
GLM-4.7 sangat besar, bahkan saat dikwantisasi. Apakah model dapat berjalan dan seberapa cepat, bergantung pada total memori gabungan Anda, bukan hanya VRAM GPU.
Pikirkan dalam kerangka VRAM GPU + RAM sistem secara bersamaan.
Untuk GLM-4.7, ukuran GPU H100 saja tidak cukup. Inferensi yang stabil dan cepat bergantung pada total memori yang tersedia, menggabungkan VRAM GPU dan RAM sistem.
Untuk tutorial ini, kami akan menggunakan RunPod karena cepat disiapkan dan menyediakan berbagai GPU yang tersedia sesuai permintaan.
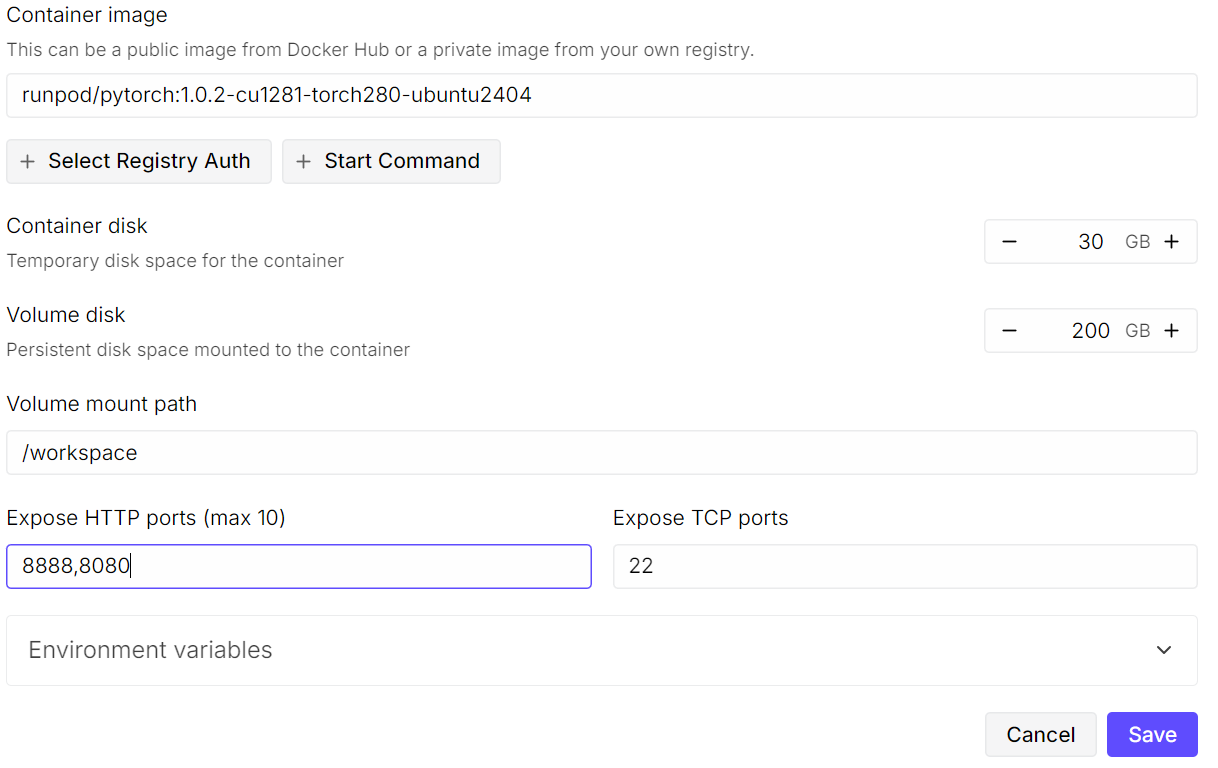
Mulailah dengan membuat pod baru. Pilih image PyTorch terbaru, lalu klik Edit pada pengaturan template. Tingkatkan ukuran disk volume menjadi 200 GB, karena model GLM-4.7 sangat besar, bahkan dalam bentuk kwantisasi 2-bit.
Selanjutnya, buka port yang diperlukan. Pertahankan port 8080 default untuk JupyterLab, dan tambahkan port tambahan yang nantinya akan digunakan oleh server llama.cpp.
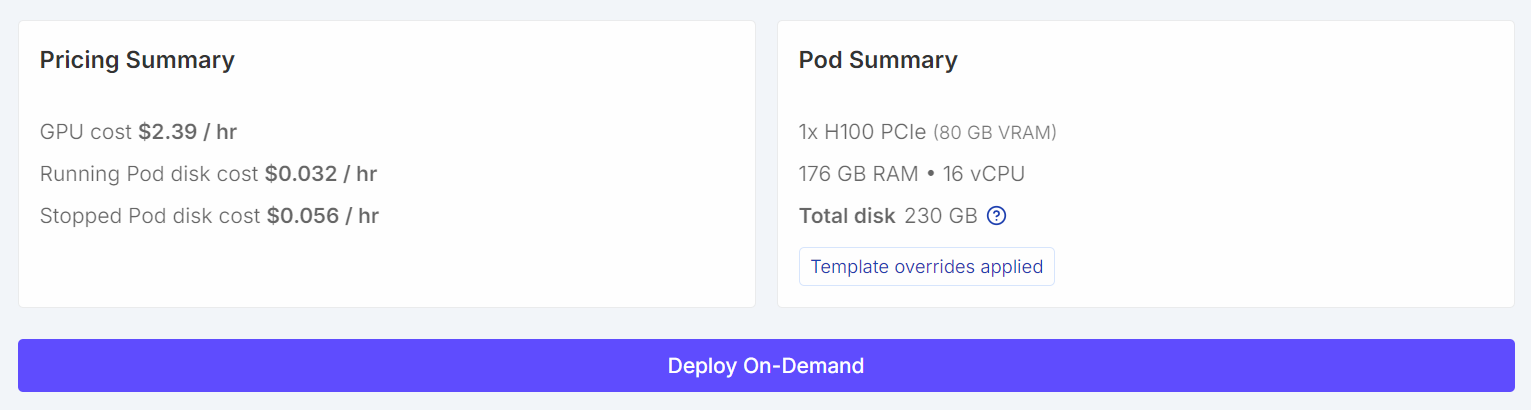
 Setelah dikonfigurasi, ringkasan harga dan ringkasan pod Anda seharusnya menampilkan dengan jelas bahwa template default telah diganti dengan ukuran volume yang lebih besar.
Setelah pod berjalan, klik tautan Jupyter Notebook untuk meluncurkan JupyterLab. Buat notebook baru dan jalankan kode setup berikut.
import os

WORKDIR = "/workspace"
LLAMA_DIR = f"{WORKDIR}/llama.cpp"
MODEL_DIR = f"{WORKDIR}/models/unsloth/GLM-4.7-GGUF"

os.makedirs(MODEL_DIR, exist_ok=True)

# Put Hugging Face cache on /workspace (big speed win on RunPod)
os.environ["HF_HOME"] = f"{WORKDIR}/.cache/huggingface"
os.environ["HUGGINGFACE_HUB_CACHE"] = f"{WORKDIR}/.cache/huggingface/hub"
os.environ["HF_HUB_CACHE"] = f"{WORKDIR}/.cache/huggingface/hub"
os.environ["HF_HUB_DISABLE_SYMLINKS_WARNING"] = "1"

# Enable HF Xet high performance (Xet backend)
os.environ["HF_XET_HIGH_PERFORMANCE"] = "1"

print("WORKDIR:", WORKDIR)
print("LLAMA_DIR:", LLAMA_DIR)
print("MODEL_DIR:", MODEL_DIR)
print("HF_HOME:", os.environ["HF_HOME"])
print("HF_HUB_CACHE:", os.environ["HF_HUB_CACHE"])
print("HF_XET_HIGH_PERFORMANCE:", os.environ["HF_XET_HIGH_PERFORMANCE"])
Kode ini akan:
/workspace sebagai direktori kerja utama di RunPod.llama.cpp akan dikloning dan dibangun./workspace untuk unduhan yang lebih cepat dan ruang disk lebih lega.Anda akan melihat output serupa ini:
WORKDIR: /workspace
LLAMA_DIR: /workspace/llama.cpp
MODEL_DIR: /workspace/models/unsloth/GLM-4.7-GGUF
HF_HOME: /workspace/.cache/huggingface
HF_HUB_CACHE: /workspace/.cache/huggingface/hub
HF_XET_HIGH_PERFORMANCE: 1
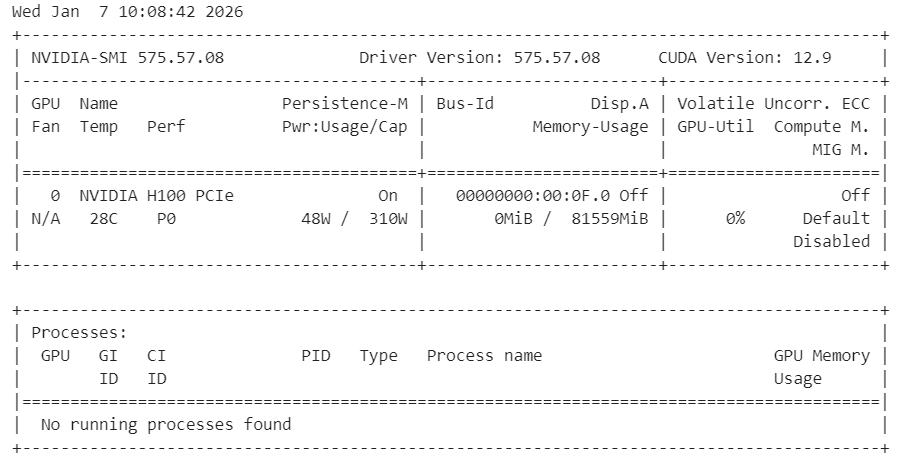
Selanjutnya, verifikasi bahwa driver NVIDIA telah terpasang dengan benar dan GPU terlihat.
!nvidia-smiAnda seharusnya melihat GPU H100 dengan 80 GB VRAM tersedia, mengonfirmasi lingkungan siap untuk akselerasi GPU.
Terakhir, instal dependensi sistem yang diperlukan untuk membangun llama.cpp dari sumber.
%%capture
!apt-get update -y
!apt-get install -y build-essential cmake curl libcurl4-openssl-dev git pciutils
Catatan: Kami menggunakan %%capture untuk menyembunyikan log instalasi yang verbose di Jupyter sambil tetap menjalankan perintah.
Pada langkah ini, kita mengkloning dan membangun llama.cpp dari sumber dengan CUDA diaktifkan untuk memastikan performa GPU optimal.
Pertama, klon repositori resmi ke dalam workspace.
!git clone https://github.com/ggml-org/llama.cpp /workspace/llama.cppSelanjutnya, konfigurasikan build dengan dukungan CUDA diaktifkan dan shared library dinonaktifkan.
%%capture
!cmake /workspace/llama.cpp -B /workspace/llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
Lalu bangun biner yang diperlukan dalam mode rilis.
%%capture
!cmake --build /workspace/llama.cpp/build --config Release -j --clean-first --target llama-cli llama-server
Setelah build selesai, salin biner ke direktori utama dan verifikasi output.
%%capture
!cp /workspace/llama.cpp/build/bin/llama-* /workspace/llama.cpp/
!ls -la /workspace/llama.cpp | sed -n '1,60p'
Pada titik ini, llama.cpp siap dengan dukungan CUDA penuh dan dapat digunakan untuk menjalankan GLM-4.7 melalui CLI atau server.
Pada langkah ini, kita menginstal library Hugging Face dengan dukungan Xet dan HF Transfer untuk mempercepat unduhan model besar secara signifikan. Xet memberikan performa jauh lebih cepat dibanding Git LFS, yang penting untuk mengunduh GLM-4.7 secara efisien.
Pertama, instal dependensi Hugging Face yang dibutuhkan dan aktifkan HF Transfer.
!pip -q install -U "huggingface_hub[hf_xet]" hf-xet
!pip -q install -U hf_transfer
Aktifkan HF Transfer dengan menyetel variabel lingkungan.
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
Setelah menginstal paket ini, mulai ulang kernel Jupyter agar setelan baru diterapkan.
Selanjutnya, unduh model GLM-4.7 GGUF dari Hugging Face menggunakan snapshot_download. Kita batasi unduhan pada kwantisasi dinamis 2-bit yang direkomendasikan untuk mengurangi penggunaan penyimpanan dan memori.
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="unsloth/GLM-4.7-GGUF",
    local_dir=MODEL_DIR,
    allow_patterns=["*UD-Q2_K_XL*"],  # recommended dynamic 2-bit
)
print("Downloaded into:", MODEL_DIR)
Dengan Xet dan HF Transfer diaktifkan, kecepatan unduh dapat mencapai 726 MB per detik dan kemudian meningkat hingga 1,2 GB per detik. Tanpa setup ini, kecepatan unduh biasanya sekitar 50 MB per detik, yang bisa memakan waktu hampir sehari penuh untuk mengunduh model sebesar ini.
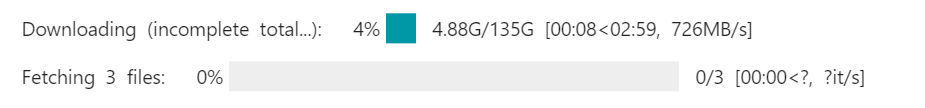
Setelah unduhan selesai, model GLM-4.7 akan tersedia secara lokal di direktori model workspace, siap untuk inferensi dengan llama.cpp.
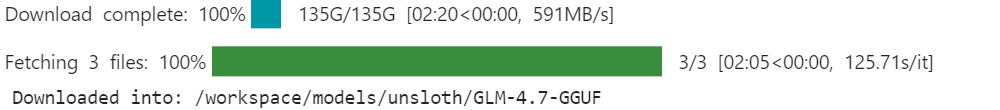
Kini kita akan menjalankan GLM-4.7 dalam mode interaktif menggunakan CLI llama.cpp.
Mulailah dengan membuka terminal di dalam JupyterLab. Klik tombol Plus (+) di JupyterLab, gulir ke bawah, dan pilih Terminal. Ini akan membuka sesi shell baru di lingkungan RunPod.
Di terminal, jalankan perintah berikut untuk meluncurkan CLI interaktif.
 /workspace/llama.cpp/llama-cli \
  --model "/workspace/models/unsloth/GLM-4.7-GGUF/UD-Q2_K_XL/GLM-4.7-UD-Q2_K_XL-00001-of-00003.gguf" \
  --jinja \
  --threads -1 \
  --ctx-size 16384 \
  --temp 1.0 \
  --top-p 0.95 \
  --seed 3407 \
  --fit on
Perintah ini memuat model GLM-4.7 2-bit dinamis dan memulai sesi chat interaktif. Flag --fit on memungkinkan llama.cpp secara otomatis meng-offload sebanyak mungkin layer dan blok cache KV ke GPU, sambil menumpahkan komponen yang tersisa ke RAM sistem dengan aman. Ini menghilangkan kebutuhan penalaan layer manual dan membantu menghindari error kehabisan memori.
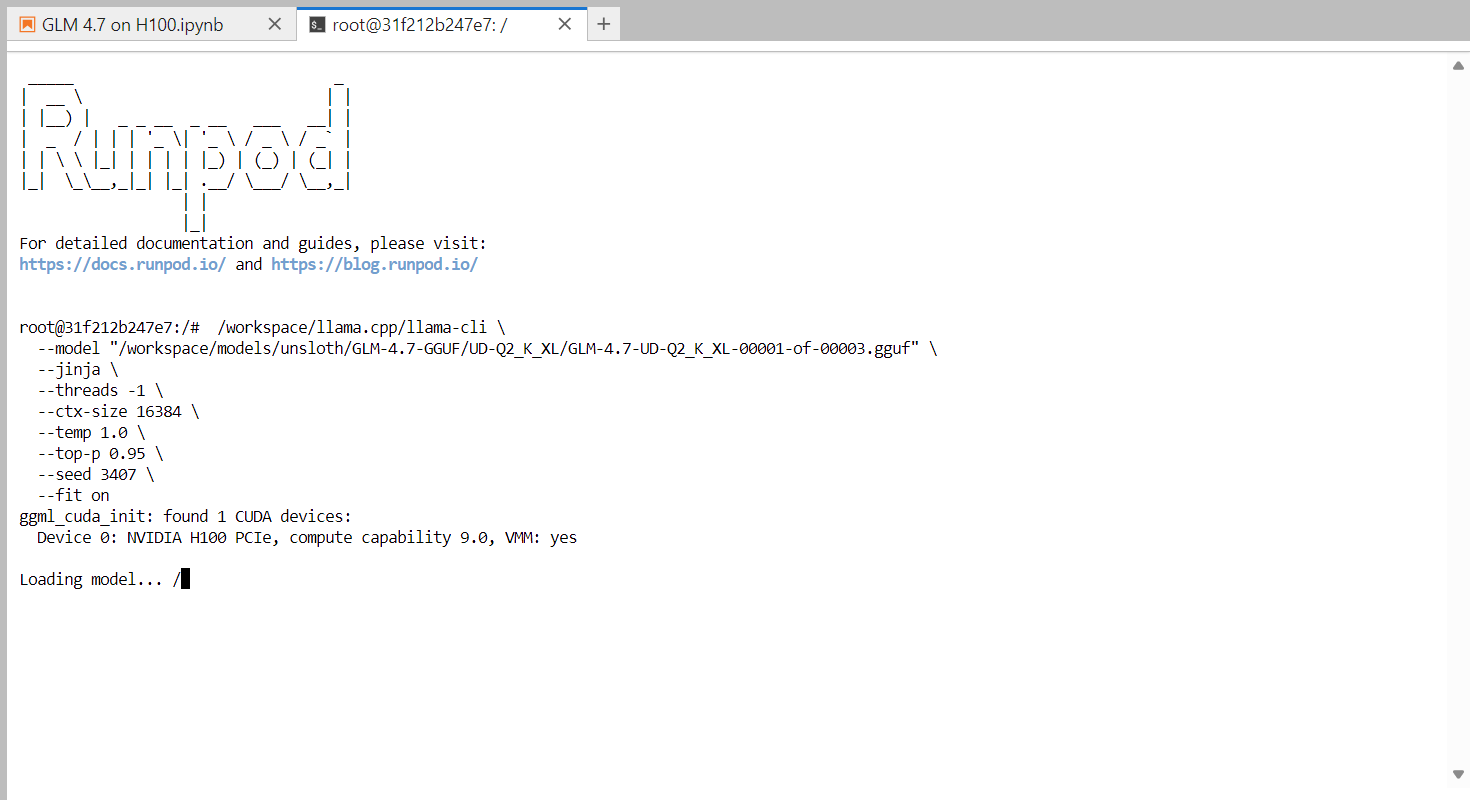
Setelah model selesai dimuat, Anda akan melihat banner llama.cpp diikuti prompt interaktif. Anda kini dapat mengetik pesan, seperti sapaan sederhana, dan model akan mulai menghasilkan respons.
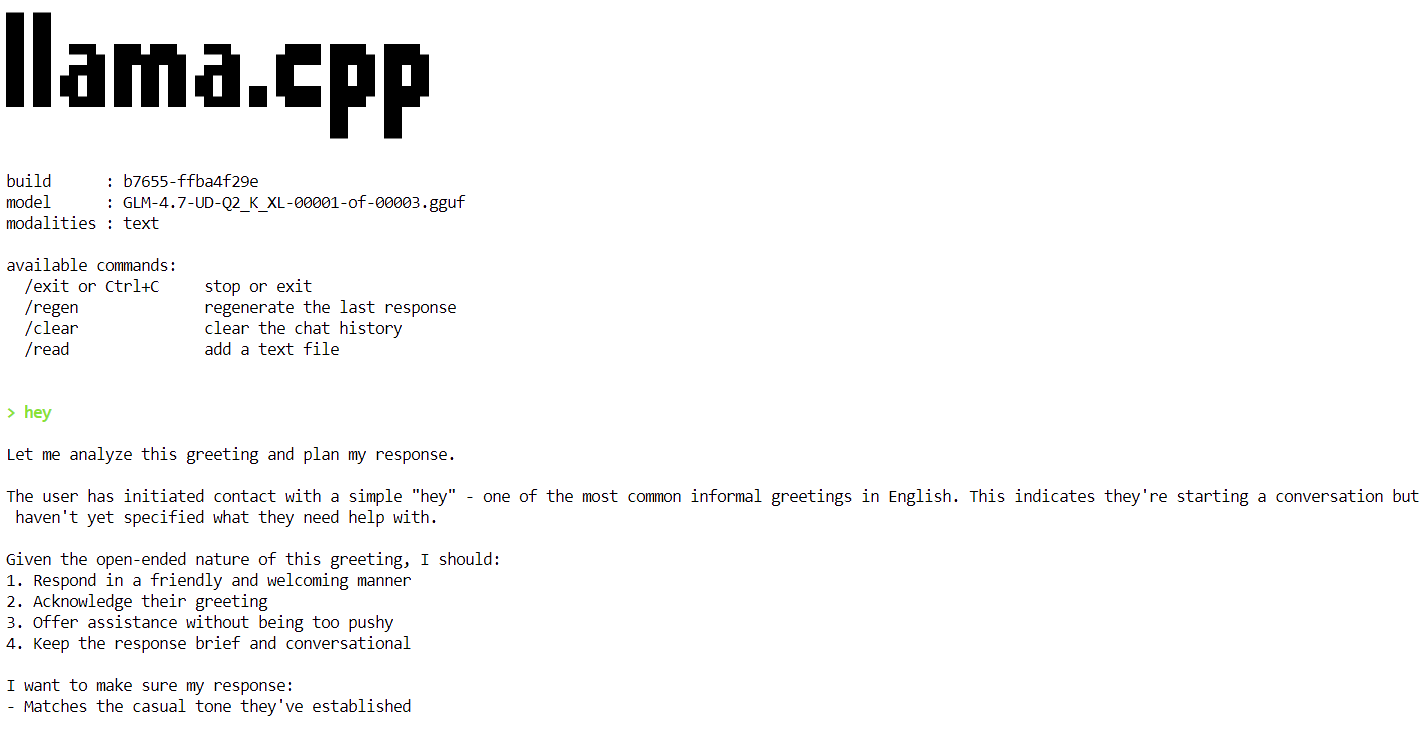
Di akhir setiap respons, llama.cpp mencetak statistik performa, termasuk kecepatan generasi token. Pada tahap ini, model berjalan sekitar 2,2 token per detik, yang menegaskan bahwa model bekerja dengan benar pada satu GPU H100.
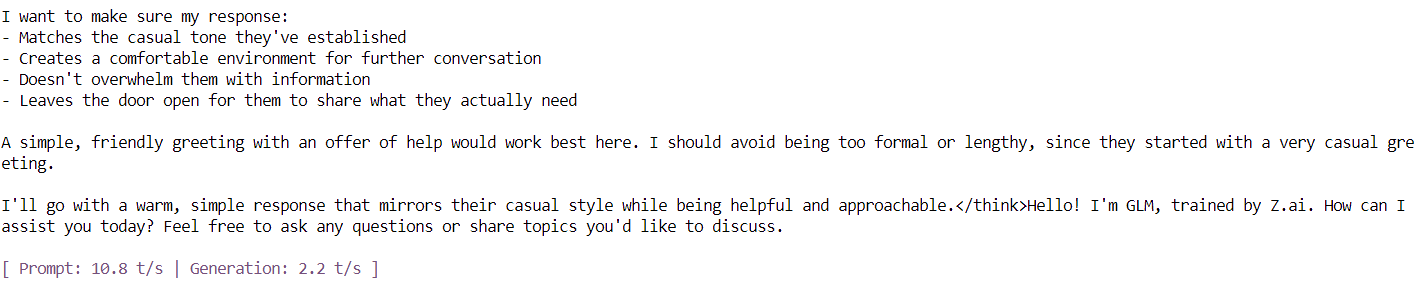
Pada langkah berikutnya, kita akan menerapkan optimasi tambahan untuk meningkatkan throughput dan mendekati target 20 token per detik.
Pada langkah ini, kita menjalankan GLM-4.7 sebagai server inferensi yang persisten menggunakan llama.cpp, dioptimalkan untuk satu GPU H100 PCIe. Pengaturan ini disetel untuk meningkatkan throughput, stabilitas, dan efisiensi memori saat melayani permintaan.
Untuk mencapai performa yang stabil dan efisien, digunakan optimasi berikut:
--fit on): Secara otomatis meng-offload sebanyak mungkin model dan cache KV ke memori GPU, dengan aman menumpahkan sisanya ke RAM sistem. Ini menghindari penalaan layer manual dan mencegah error kehabisan memori.--flash-attn auto): Mengaktifkan kernel attention yang dioptimalkan pada GPU yang didukung seperti H100, secara signifikan meningkatkan kecepatan generasi token dan mengurangi beban memori.--ctx-size 8192): Jendela konteks besar memperlambat decoding seiring waktu. Mengurangi ukuran konteks dari 16k ke 8k memberikan throughput token yang lebih konsisten untuk sebagian besar beban kerja.--batch-size, --ubatch-size): Meningkatkan utilisasi GPU dan throughput keseluruhan dengan memroses token dalam batch yang lebih besar dan efisien.--threads 32): Mencegah oversubscription CPU dan mengurangi overhead penjadwalan di lingkungan cloud seperti RunPod.Jalankan perintah berikut di terminal untuk memulai server inferensi GLM-4.7.
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/unsloth/GLM-4.7-GGUF/UD-Q2_K_XL/GLM-4.7-UD-Q2_K_XL-00001-of-00003.gguf" \
  --alias "GLM-4.7" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 8192 \
  --temp 1.0 \
  --top-p 0.95 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
  --ubatch-size 256
Setelah model selesai dimuat, server mulai mendengarkan pada port 8080 dan siap menerima permintaan inferensi. Pada titik ini, GLM-4.7 berjalan sebagai layanan inferensi berperforma tinggi pada satu GPU H100.
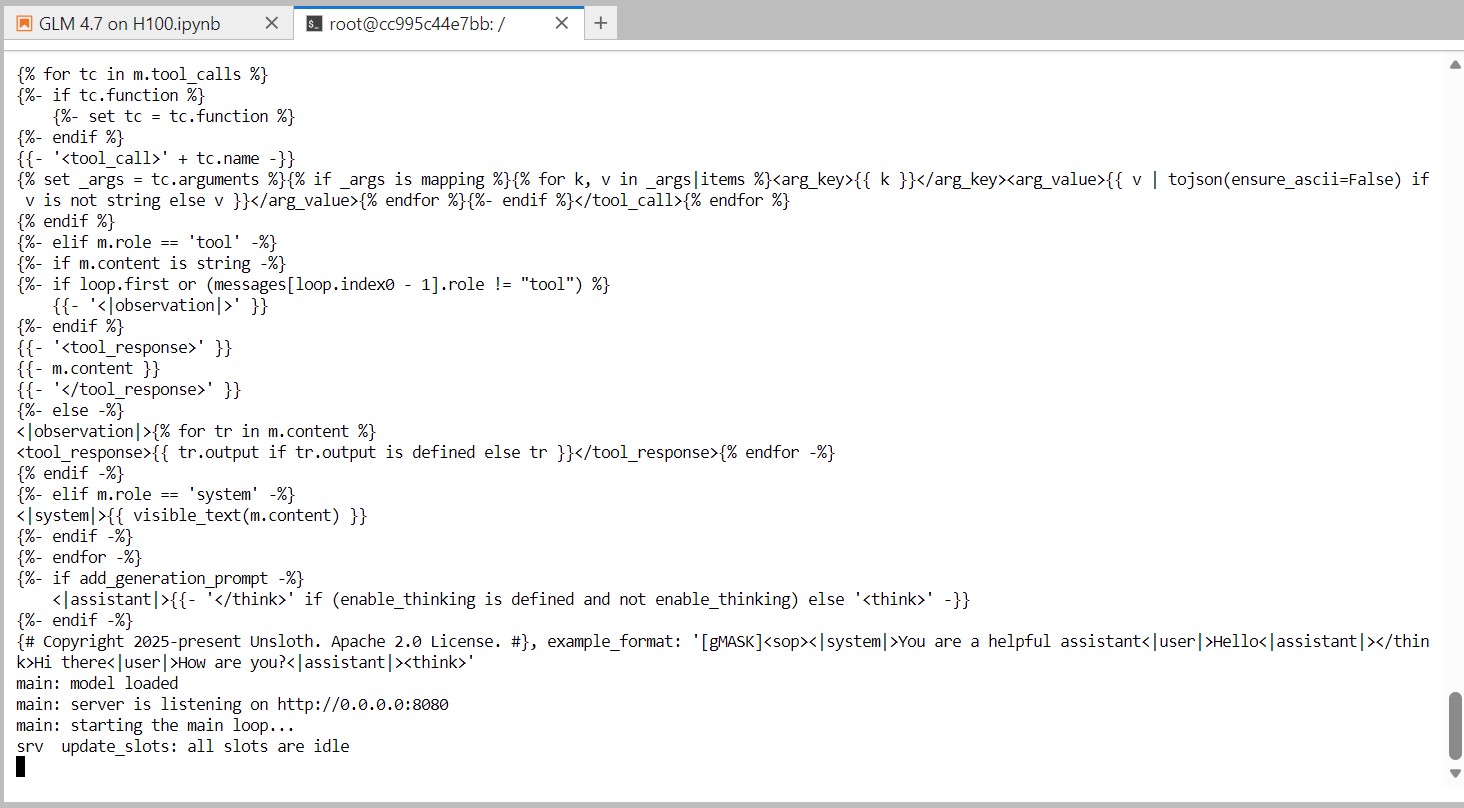
Pada langkah berikutnya, kita akan menguji server menggunakan web UI bawaan yang disertakan dengan server llama.cpp.
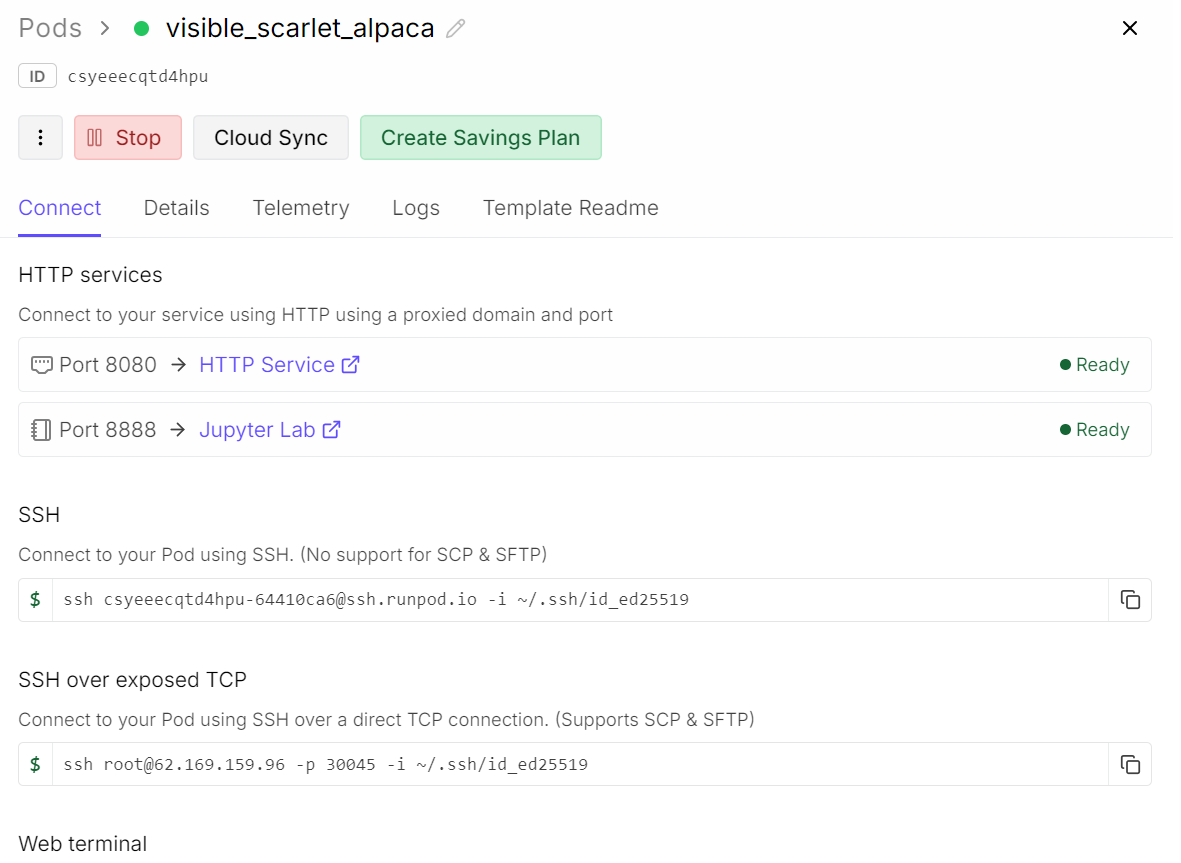
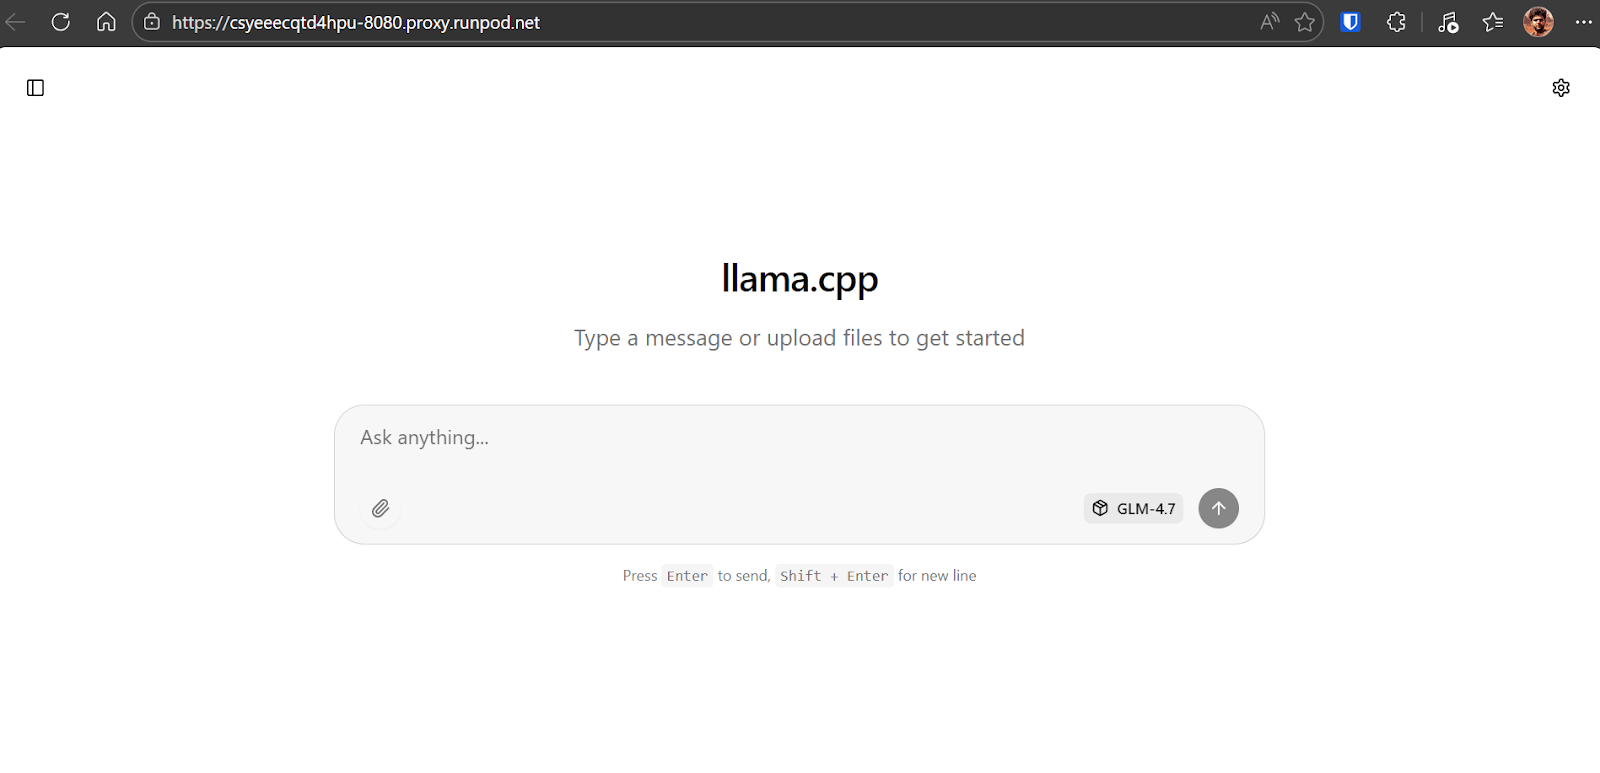
Untuk menguji server inferensi yang berjalan, buka dashboard RunPod Anda dan temukan layanan HTTP terbuka pada port 8080. Klik tautannya, dan itu akan meluncurkan web UI llama.cpp di browser Anda.
Web UI llama.cpp mirip dengan ChatGPT. Anda dapat memasukkan prompt, melampirkan file, menyesuaikan pengaturan, dan memilih model yang tersedia dari antarmuka.
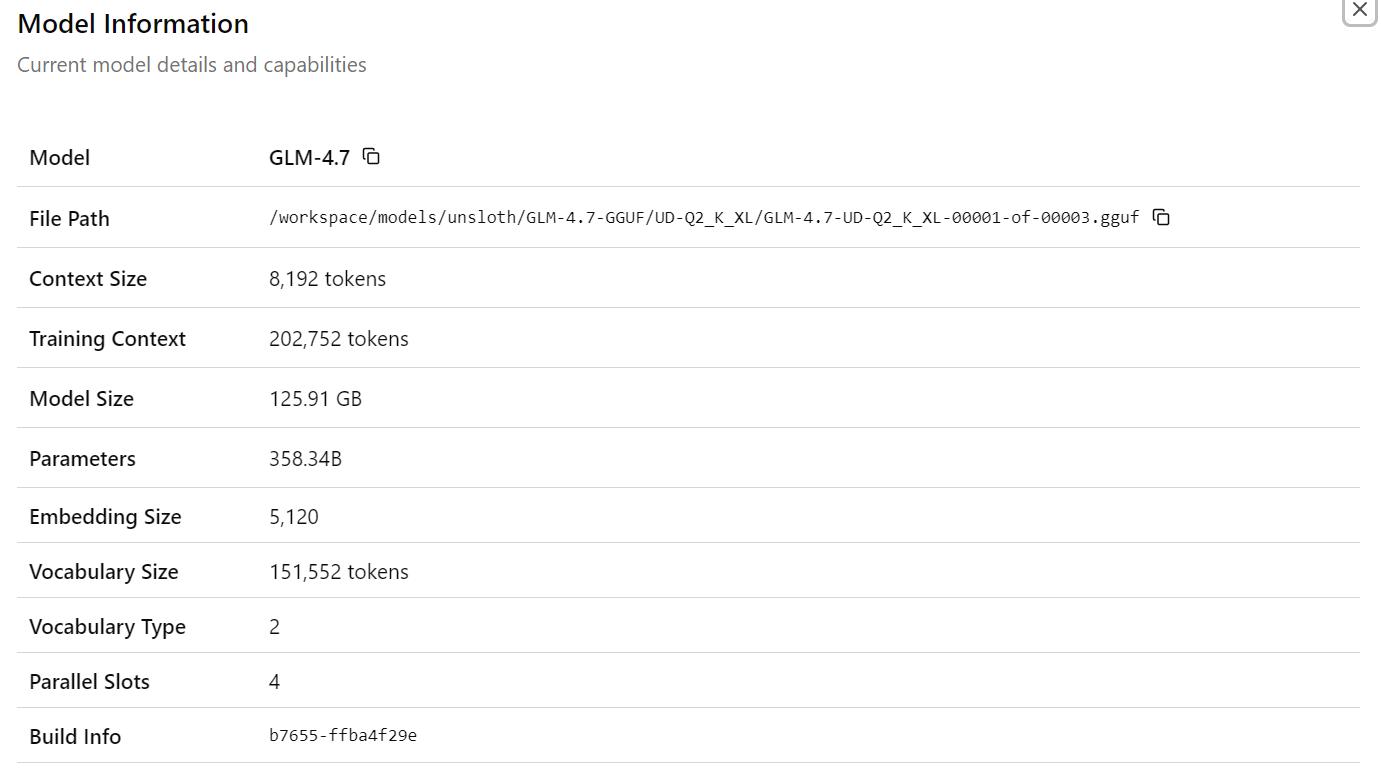
Setelah memilih model GLM-4.7, Anda akan melihat informasi terperinci tentang model yang dimuat, termasuk path file, ukuran konteks, ukuran model, jumlah parameter, dimensi embedding, dan detail runtime lainnya. Ini menegaskan bahwa model dan konfigurasi yang benar aktif.
Sekarang masukkan prompt pertama Anda. Dalam hitungan detik, model akan mulai menghasilkan respons langsung di web UI.
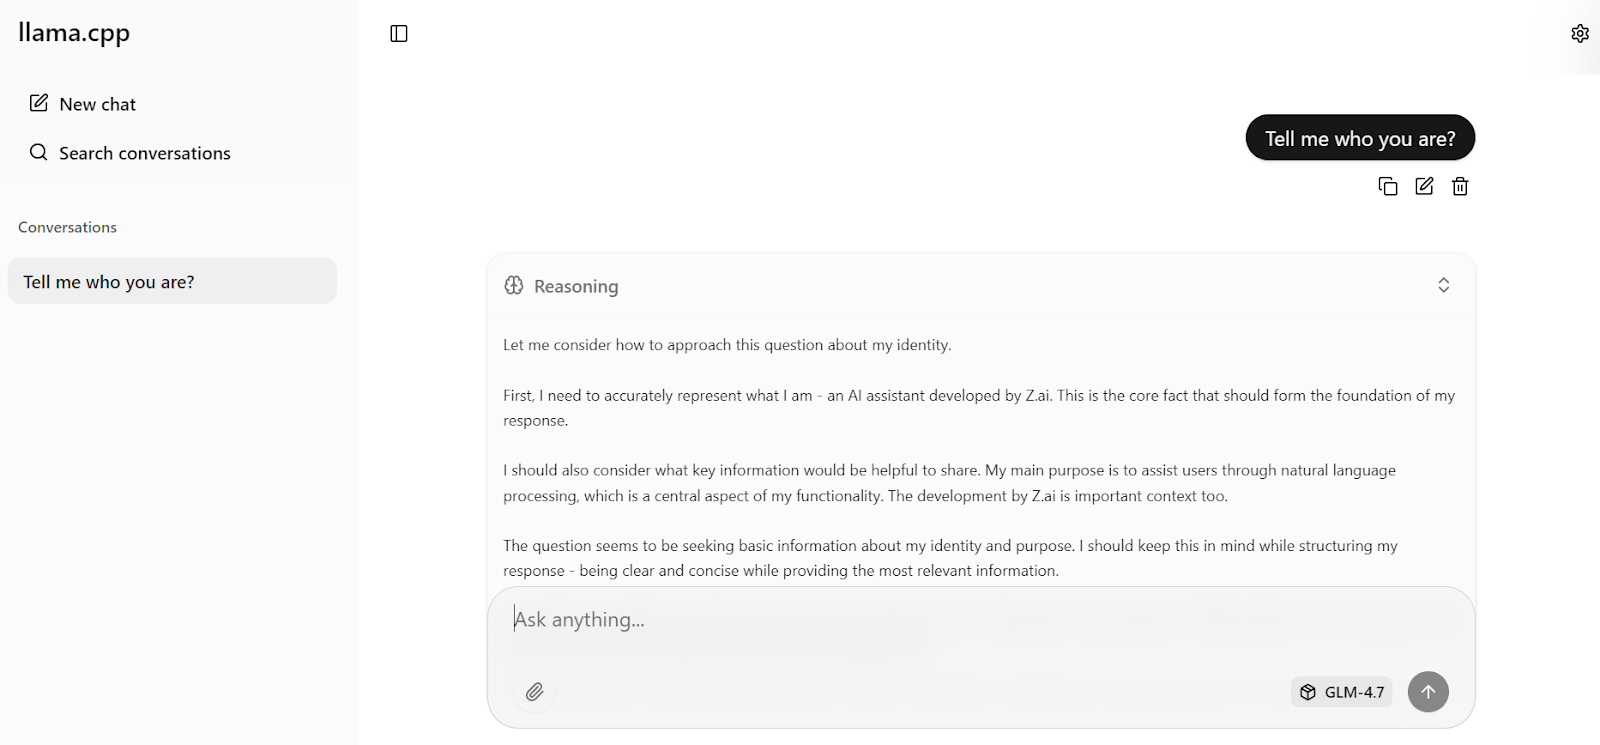
Dengan setelan server yang dioptimalkan sebelumnya, model mencapai sekitar 19 token per detik, yang menegaskan bahwa pipeline inferensi berfungsi efisien. Responsnya akurat dan koheren.
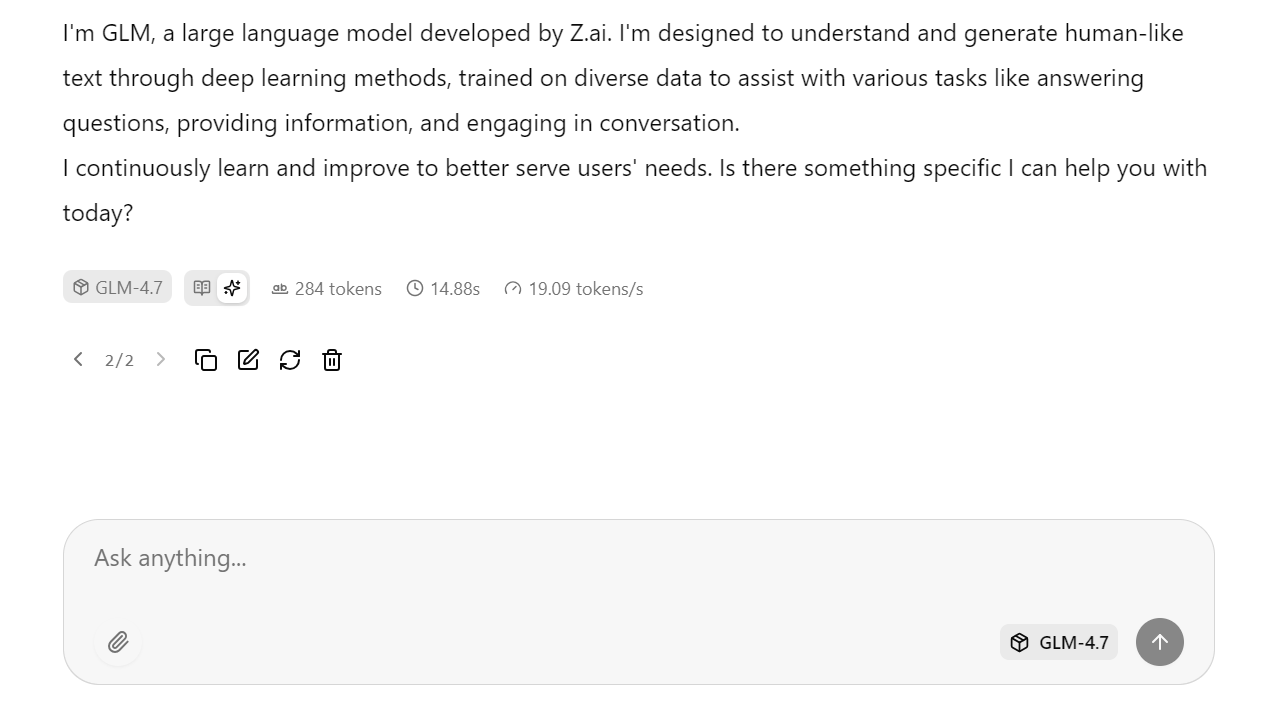
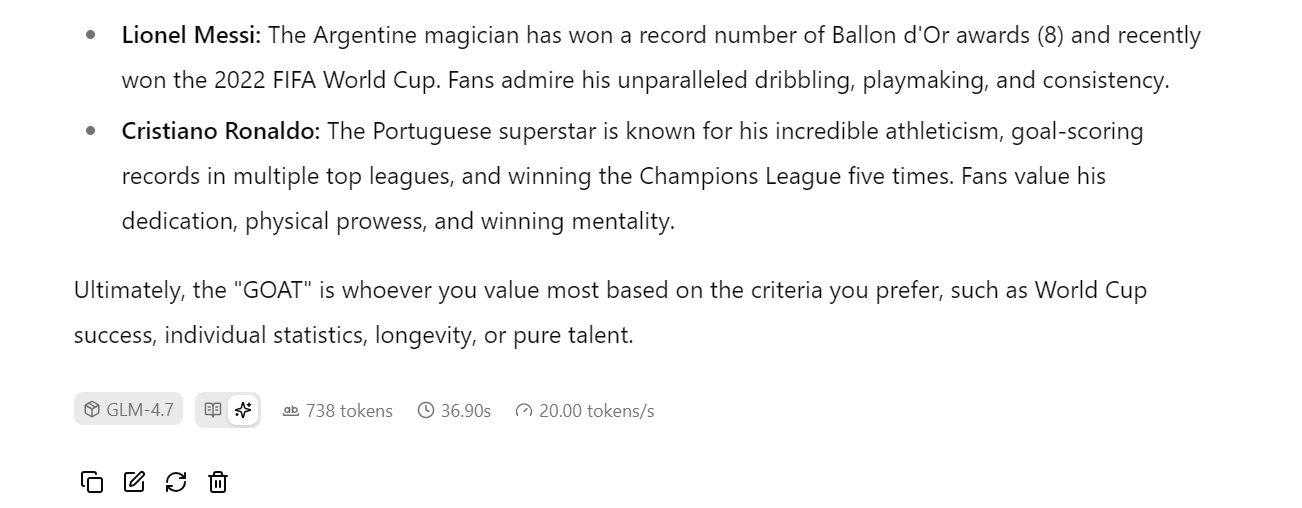
Anda kemudian dapat mengajukan pertanyaan lanjutan, seperti kueri pengetahuan umum. Dalam pengujian, GLM-4.7 secara konsisten mencapai sekitar 20 token per detik, termasuk token penalaran dan respons, menunjukkan performa tinggi yang stabil pada satu GPU H100.
Di bagian ini, kita akan menguji server inferensi llama.cpp yang berjalan menggunakan Python SDK yang kompatibel dengan OpenAI Python SDK. Ini menegaskan bahwa server bekerja dengan benar untuk akses terprogram dan dapat diintegrasikan ke aplikasi nyata.
Pertama, kembali ke Jupyter Notebook. Pastikan proses llama-server masih berjalan di terminal dan jangan hentikan atau mulai ulang.
Untuk memverifikasi server aktif dan mendengarkan pada port 8080, jalankan perintah berikut:
!ss -lntp | grep 8080 || trueAnda seharusnya melihat output serupa ini, mengonfirmasi bahwa llama-server sedang mendengarkan:
LISTEN 0 512 0.0.0.0:8080 0.0.0.0:* users:(("llama-server",pid=1108,fd=15))Selanjutnya, instal OpenAI Python SDK, yang akan kita gunakan untuk mengirim permintaan ke server lokal.
!pip -q install openaiSekarang, buat klien OpenAI yang mengarah ke server llama.cpp lokal. Nilai kunci API tidak diperlukan, namun harus disertakan demi kompatibilitas.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required",
)
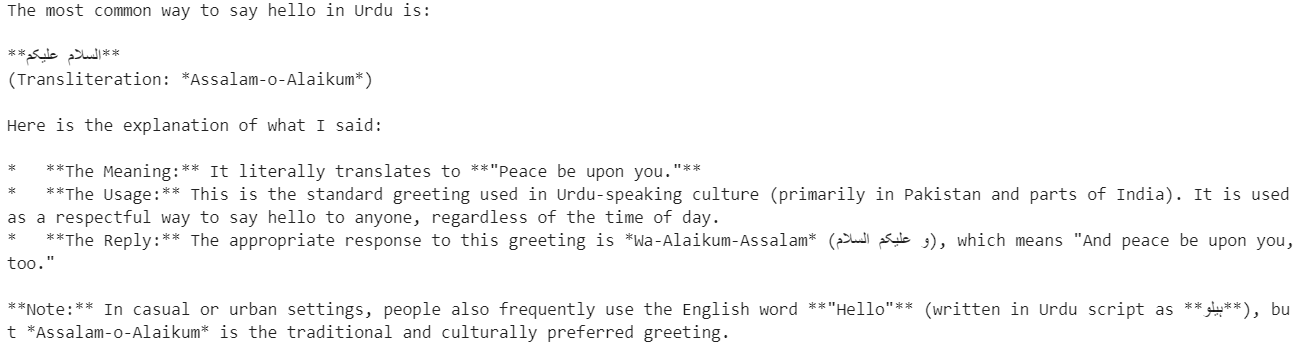
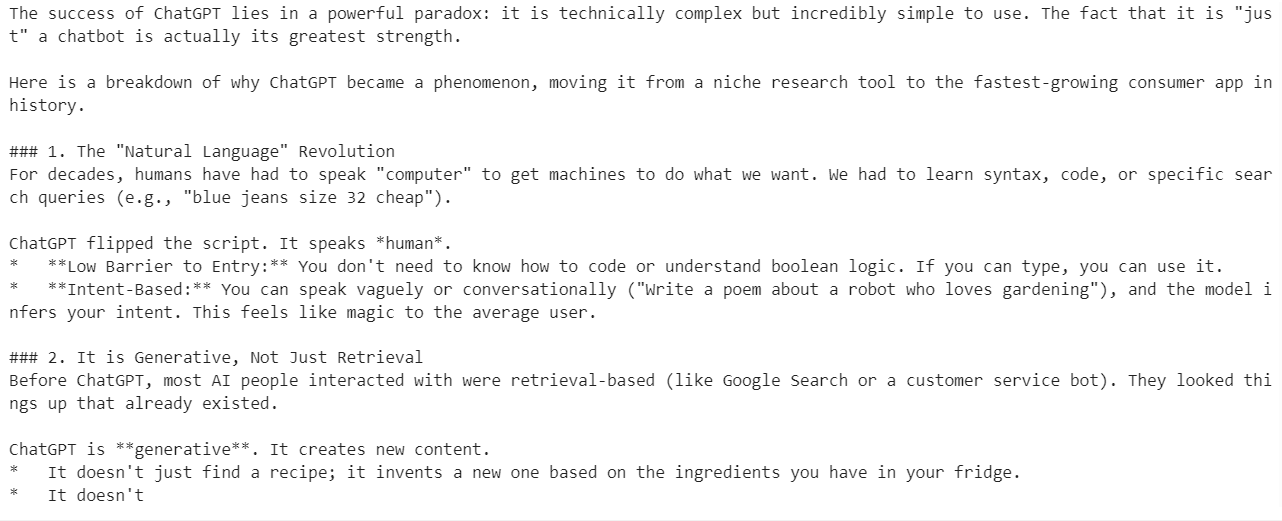
Kirim permintaan chat completion sederhana untuk menguji kemampuan multibahasa.
resp = client.chat.completions.create(
    model="GLM-4.7",
    messages=[{"role": "user", "content": "Say hello in Urdu and explain what you said."}],
    temperature=0.7,
)

print(resp.choices[0].message.content)
Model merespons dalam bahasa Urdu dan memberikan penjelasan jelas atas setiap kata, menunjukkan pemahaman multibahasa dan kemampuan penalaran.
Selanjutnya, uji inferensi streaming, yang krusial untuk aplikasi waktu nyata seperti antarmuka chat.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required",
)

stream = client.chat.completions.create(
    model="GLM-4.7",
    messages=[
        {
            "role": "user",
            "content": "What makes ChatGPT so successful and popular, given that it's "just" a chatbot?"
        }
    ],
    temperature=0.7,
    stream=True,
)

for event in stream:
    choice = event.choices[0]
    if getattr(choice, "delta", None) and getattr(choice.delta, "content", None):
        text = choice.delta.content
        print(text, end="", flush=True)
        full_text.append(text)
Respons mengalir mulus, token demi token, mengonfirmasi bahwa streaming llama.cpp berfungsi andal dengan GLM-4.7. Jawaban yang dihasilkan koheren, terstruktur baik, dan akurat, menjadikan setup ini cocok untuk beban kerja bergaya produksi.
Pada titik ini, GLM-4.7 sepenuhnya operasional melalui web UI dan API yang kompatibel dengan OpenAI, berjalan efisien pada satu GPU H100 dengan setelan yang dioptimalkan.
llama.cpp telah berkembang pesat dalam beberapa bulan terakhir, hingga pada titik dapat sepenuhnya menggantikan tool seperti Ollama dan aplikasi chat lokal lainnya untuk menjalankan model bahasa besar.
Ia menawarkan mesin inferensi yang sangat dapat dikonfigurasi dan cepat, CLI berbasis terminal untuk penggunaan interaktif, dan web UI bawaan yang sangat mirip dengan pengalaman ChatGPT.
Anda juga mendapatkan kontrol terperinci atas perilaku model melalui flag runtime dan pengaturan UI, memungkinkan Anda menyetel performa dan kualitas berdasarkan perangkat keras Anda.
Satu hal penting adalah bahwa Anda tidak memerlukan perangkat keras kelas enterprise untuk menjalankan GLM-4.7. Dengan RAM sistem yang memadai dan GPU seperti RTX 3090, model GLM-4.7 2-bit dapat berjalan secara lokal dengan menggunakan --fit on dan menerapkan optimasi llama.cpp yang tepat.
Ekosistem llama.cpp memiliki komunitas besar dan aktif, sehingga mudah menemukan konfigurasi yang dioptimalkan dan bantuan saat menyetel untuk GPU atau beban kerja tertentu.
Dalam tutorial ini, kita menyiapkan lingkungan RunPod, membangun llama.cpp dengan dukungan CUDA, mengunduh model GLM-4.7 menggunakan transfer berkecepatan tinggi dari Hugging Face, dan menjalankan model dalam mode interaktif. Lalu kita meluncurkan server inferensi yang dioptimalkan, mengujinya melalui web UI, dan memvalidasinya secara terprogram menggunakan API yang kompatibel dengan OpenAI.
Hasilnya adalah deployment GLM-4.7 lokal berperforma tinggi yang menyajikan akurasi kuat dan inferensi nyaris real-time pada satu GPU. Setup ini sangat cocok untuk eksperimen, riset, dan bahkan beban kerja bergaya produksi di mana kontrol, performa, dan transparansi penting.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




