
Last chance! 50% off DataCamp Premium
Sale ends in
GLM-4.7 आपका नया कोडिंग पार्टनर है, जिसे असली डेवलपमेंट वर्कफ़्लोज़ में बेहतर प्रदर्शन के लिए डिज़ाइन किया गया है। GLM-4.6 की तुलना में, यह बहुभाषी और एजेंटिक कोडिंग, टर्मिनल-आधारित कार्यों, और टूल उपयोग में स्पष्ट बढ़त दिखाता है, और SWE-bench, SWE-bench Multilingual, तथा Terminal Bench 2.0 पर मजबूत परिणाम देता है। यह कार्रवाई से पहले सोचने का समर्थन भी करता है, जिससे आधुनिक एजेंट फ्रेमवर्क में जटिल कार्यों के लिए यह अधिक विश्वसनीय बनता है।
इस ट्यूटोरियल में, हम सीधे Runpod वातावरण सेट करने, सभी आवश्यक डिपेंडेंसी इंस्टॉल करने, और पूर्ण CUDA सपोर्ट के साथ llama.cpp क्लोन करने पर आते हैं। फिर हम Hugging Face से GLM-4.7 2-bit मॉडल डाउनलोड करेंगे, उसे CLI और सर्वर—दोनों मोड में चलाएँगे, और अंत में OpenAI SDK का उपयोग करके रनिंग सर्वर का परीक्षण करेंगे।
आप हमारा GLM 4.7 Flash को लोकली चलाने वाला मार्गदर्शक भी देख सकते हैं।
लोकली GLM-4.7 चलाने से पहले, सुनिश्चित करें कि आपका सिस्टम नीचे दी गई आवश्यकताओं को पूरा करता है।
उपयोगी प्रदर्शन के लिए NVIDIA GPU आवश्यक है।
नवीनतम NVIDIA ड्राइवर इंस्टॉल करें और निम्न कमांड से इंस्टॉलेशन सत्यापित करें:
nvidia-smiयदि यह कमांड काम करती है और आपका GPU दिखाती है, तो ड्राइवर सेटअप सही है।
GLM-4.7 चलाते समय GPU एक्सेलेरेशन के लिए CUDA आवश्यक है। यदि आप llama.cpp को स्रोत से बना रहे हैं, तो बिल्ड समय पर CUDA का सही तरह से डिटेक्ट होना ज़रूरी है।
यदि आप प्रीबिल्ट CUDA-सक्षम बाइनरी का उपयोग कर रहे हैं, तो सिस्टम पर पहले से एक कार्यशील CUDA रनटाइम इंस्टॉल होना चाहिए। CUDA सपोर्ट के बिना, GLM-4.7 CPU पर चलेगा, जो वास्तविक उपयोग के लिए अव्यावहारिक रूप से धीमा है।
GLM-4.7 अत्यधिक बड़ा है, क्वांटाइज़ होने पर भी। मॉडल चलेगा या नहीं, और कितनी तेज़ी से चलेगा—यह केवल GPU VRAM पर नहीं, बल्कि आपकी कुल सम्मिलित मेमोरी पर निर्भर करता है।
इसे इस तरह सोचें: GPU VRAM + सिस्टम RAM मिलाकर।
GLM-4.7 के लिए, केवल H100 GPU का आकार पर्याप्त नहीं है। स्थिर और तेज़ इन्फ़रेंस कुल उपलब्ध मेमोरी पर निर्भर करता है, जिसमें GPU VRAM और सिस्टम RAM—दोनों शामिल हैं।
इस ट्यूटोरियल के लिए, हम RunPod का उपयोग करेंगे क्योंकि इसे सेट करना तेज़ है और यह ऑन-डिमांड उपलब्ध कई तरह के GPUs प्रदान करता है।
नई pod बनाकर शुरू करें। नवीनतम PyTorch इमेज चुनें, फिर टेम्पलेट सेटिंग्स पर Edit पर क्लिक करें। वॉल्यूम डिस्क साइज 200 GB तक बढ़ाएँ, क्योंकि GLM-4.7 मॉडल 2-bit क्वांटाइज़्ड रूप में भी बहुत बड़ा है।
इसके बाद, आवश्यक पोर्ट एक्सपोज़ करें। JupyterLab के लिए डिफ़ॉल्ट 8080 पोर्ट रखें, और एक अतिरिक्त पोर्ट जोड़ें जिसे आगे चलकर llama.cpp सर्वर द्वारा उपयोग किया जाएगा।
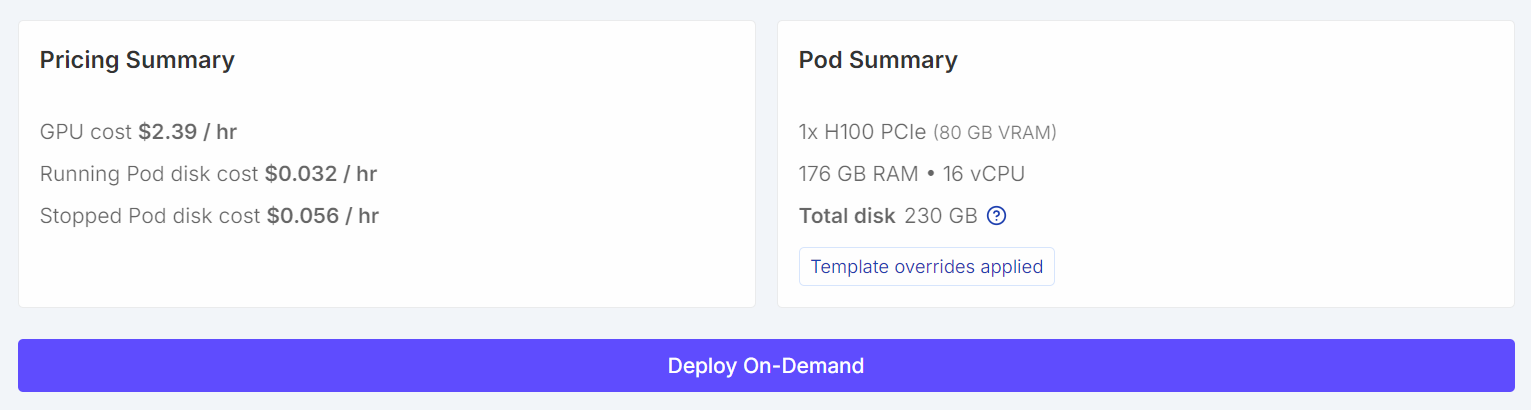
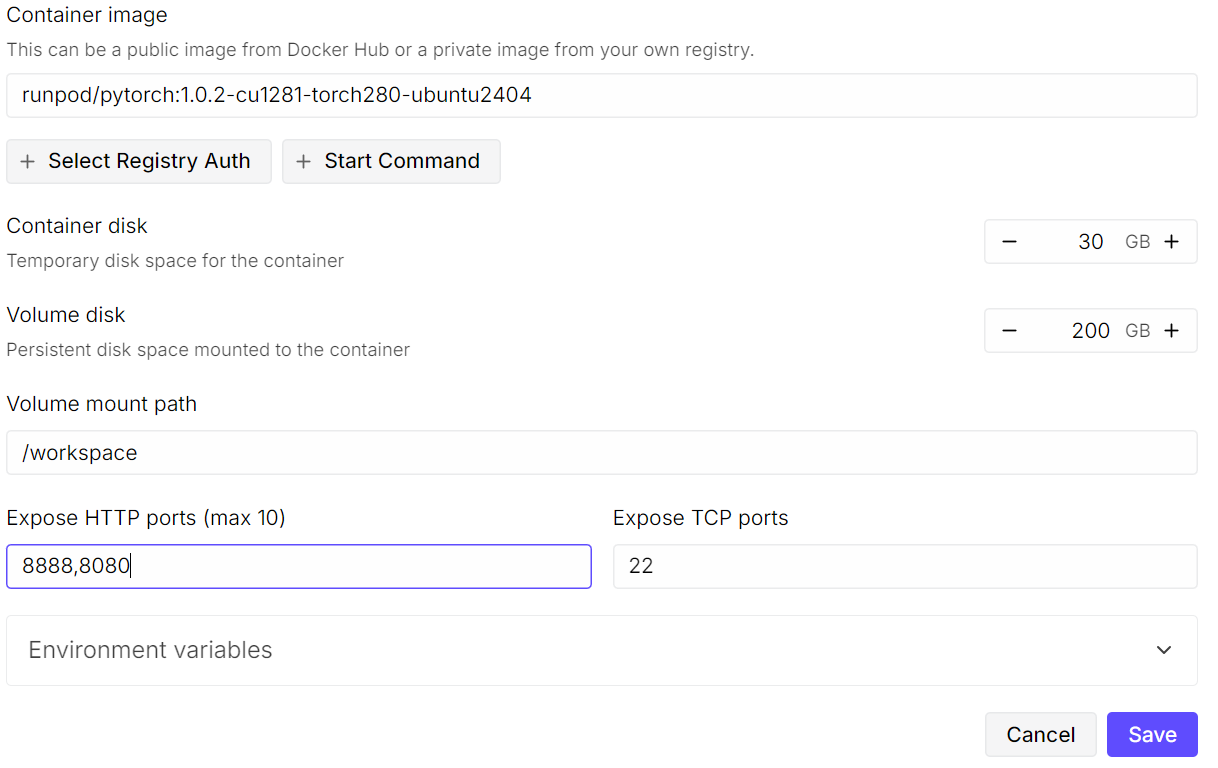 कॉन्फ़िगर होने के बाद, आपकी प्राइसिंग समरी और pod समरी स्पष्ट रूप से दिखाएगी कि डिफ़ॉल्ट टेम्पलेट को बड़े वॉल्यूम साइज के साथ ओवरराइड किया गया है।
pod शुरू होने के बाद, JupyterLab लॉन्च करने के लिए Jupyter Notebook लिंक पर क्लिक करें। एक नया नोटबुक बनाएँ और निम्न सेटअप कोड चलाएँ।
import os

WORKDIR = "/workspace"
LLAMA_DIR = f"{WORKDIR}/llama.cpp"
MODEL_DIR = f"{WORKDIR}/models/unsloth/GLM-4.7-GGUF"

os.makedirs(MODEL_DIR, exist_ok=True)

# Put Hugging Face cache on /workspace (big speed win on RunPod)
os.environ["HF_HOME"] = f"{WORKDIR}/.cache/huggingface"
os.environ["HUGGINGFACE_HUB_CACHE"] = f"{WORKDIR}/.cache/huggingface/hub"
os.environ["HF_HUB_CACHE"] = f"{WORKDIR}/.cache/huggingface/hub"
os.environ["HF_HUB_DISABLE_SYMLINKS_WARNING"] = "1"

# Enable HF Xet high performance (Xet backend)
os.environ["HF_XET_HIGH_PERFORMANCE"] = "1"

print("WORKDIR:", WORKDIR)
print("LLAMA_DIR:", LLAMA_DIR)
print("MODEL_DIR:", MODEL_DIR)
print("HF_HOME:", os.environ["HF_HOME"])
print("HF_HUB_CACHE:", os.environ["HF_HUB_CACHE"])
print("HF_XET_HIGH_PERFORMANCE:", os.environ["HF_XET_HIGH_PERFORMANCE"])
यह कोड करेगा:
/workspace सेट करता है।llama.cpp को कहाँ क्लोन और बिल्ड किया जाएगा, यह परिभाषित करता है।/workspace पर ले जाता है।आपको इससे मिलता-जुलता आउटपुट दिखाई देना चाहिए:
WORKDIR: /workspace
LLAMA_DIR: /workspace/llama.cpp
MODEL_DIR: /workspace/models/unsloth/GLM-4.7-GGUF
HF_HOME: /workspace/.cache/huggingface
HF_HUB_CACHE: /workspace/.cache/huggingface/hub
HF_XET_HIGH_PERFORMANCE: 1
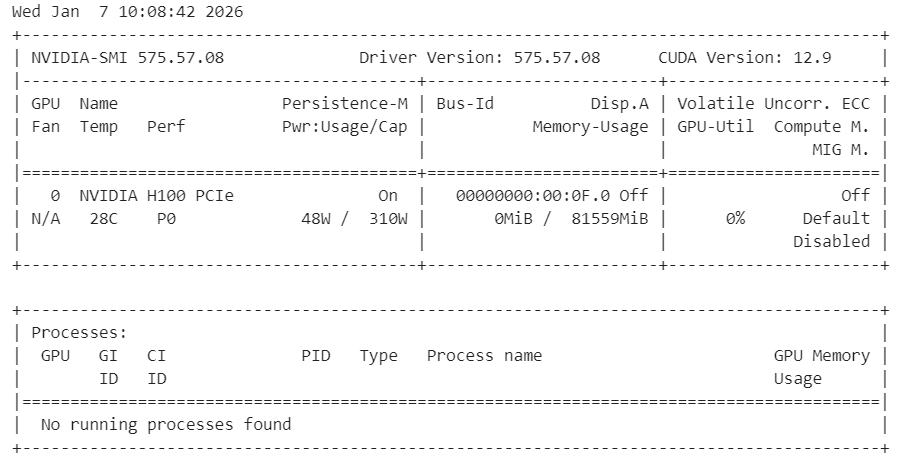
अब सत्यापित करें कि NVIDIA ड्राइवर सही तरीके से इंस्टॉल हैं और GPU दिखाई दे रहा है।
!nvidia-smiआपको 80 GB उपलब्ध VRAM के साथ H100 GPU दिखना चाहिए, जो पुष्टि करता है कि वातावरण GPU एक्सेलेरेशन के लिए तैयार है।
अंत में, स्रोत से llama.cpp बिल्ड करने के लिए आवश्यक सिस्टम डिपेंडेंसी इंस्टॉल करें।
%%capture
!apt-get update -y
!apt-get install -y build-essential cmake curl libcurl4-openssl-dev git pciutils
नोट: हमने Jupyter में विस्तृत इंस्टॉलेशन लॉग छिपाने, पर कमांड चलती रहने के लिए %%capture का उपयोग किया है।
इस चरण में, हम llama.cpp को स्रोत से CUDA सक्षम करके क्लोन और बिल्ड करेंगे ताकि इष्टतम GPU प्रदर्शन सुनिश्चित हो।
पहले, आधिकारिक रिपॉज़िटरी को वर्कस्पेस में क्लोन करें।
!git clone https://github.com/ggml-org/llama.cpp /workspace/llama.cppइसके बाद, CUDA सपोर्ट सक्षम और शेयरड लाइब्रेरीज़ अक्षम करके बिल्ड कॉन्फ़िगर करें।
%%capture
!cmake /workspace/llama.cpp -B /workspace/llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
फिर आवश्यक बाइनरीज़ को रिलीज़ मोड में बिल्ड करें।
%%capture
!cmake --build /workspace/llama.cpp/build --config Release -j --clean-first --target llama-cli llama-server
बिल्ड पूरा होने के बाद, बाइनरीज़ को मुख्य डायरेक्टरी में कॉपी करें और आउटपुट सत्यापित करें।
%%capture
!cp /workspace/llama.cpp/build/bin/llama-* /workspace/llama.cpp/
!ls -la /workspace/llama.cpp | sed -n '1,60p'
इस बिंदु पर, llama.cpp पूर्ण CUDA सपोर्ट के साथ तैयार है और CLI या सर्वर के माध्यम से GLM-4.7 चलाने के लिए उपयोग किया जा सकता है।
इस चरण में, हम बड़ी मॉडल फ़ाइलों के डाउनलोड को काफ़ी तेज़ करने के लिए Xet और HF Transfer सपोर्ट के साथ Hugging Face लाइब्रेरीज़ इंस्टॉल करेंगे। Xet, Git LFS की तुलना में कहीं तेज़ परफ़ॉर्मेंस देता है, जो GLM-4.7 को कुशलतापूर्वक डाउनलोड करने के लिए आवश्यक है।
पहले, आवश्यक Hugging Face डिपेंडेंसी इंस्टॉल करें और HF Transfer सक्षम करें।
!pip -q install -U "huggingface_hub[hf_xet]" hf-xet
!pip -q install -U hf_transfer
एनवायरनमेंट वेरिएबल सेट करके HF Transfer सक्षम करें।
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
इन पैकेजों को इंस्टॉल करने के बाद, नए सेटिंग्स के प्रभावी होने के लिए Jupyter कर्नेल को पुनः आरंभ करें।
इसके बाद, Hugging Face से snapshot_download का उपयोग करके GLM-4.7 GGUF मॉडल डाउनलोड करें। हम स्टोरेज और मेमोरी उपयोग घटाने के लिए डाउनलोड को अनुशंसित डायनेमिक 2-bit क्वांटाइज़ेशन तक सीमित रखते हैं।
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="unsloth/GLM-4.7-GGUF",
    local_dir=MODEL_DIR,
    allow_patterns=["*UD-Q2_K_XL*"],  # recommended dynamic 2-bit
)
print("Downloaded into:", MODEL_DIR)
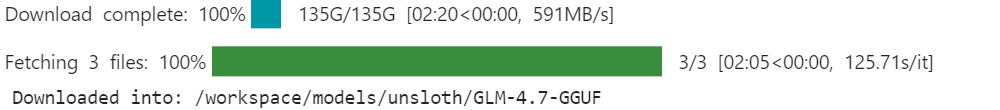
Xet और HF Transfer सक्षम होने पर, डाउनलोड स्पीड 726 MB प्रति सेकंड तक पहुँच सकती है और बाद में 1.2 GB प्रति सेकंड तक स्केल हो सकती है। इस सेटअप के बिना, डाउनलोड स्पीड आमतौर पर लगभग 50 MB प्रति सेकंड रहती है, जिससे इस आकार के मॉडल को डाउनलोड करने में लगभग पूरा दिन लग सकता है।
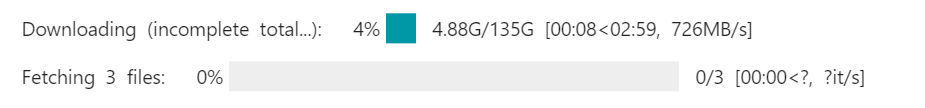
डाउनलोड पूरा होने पर, GLM-4.7 मॉडल वर्कस्पेस की मॉडल डायरेक्टरी में लोकली उपलब्ध होगा, और llama.cpp के साथ इन्फ़रेंस के लिए तैयार होगा।
अब हम llama.cpp CLI का उपयोग करके GLM-4.7 को इंटरएक्टिव मोड में चलाएँगे।
JupyterLab के अंदर एक टर्मिनल खोलकर शुरू करें। JupyterLab में प्लस (+) बटन पर क्लिक करें, नीचे स्क्रॉल करें, और Terminal चुनें। इससे RunPod वातावरण के अंदर एक नया शेल सेशन खुलेगा।
टर्मिनल में, इंटरएक्टिव CLI लॉन्च करने के लिए निम्न कमांड चलाएँ।
 /workspace/llama.cpp/llama-cli \
  --model "/workspace/models/unsloth/GLM-4.7-GGUF/UD-Q2_K_XL/GLM-4.7-UD-Q2_K_XL-00001-of-00003.gguf" \
  --jinja \
  --threads -1 \
  --ctx-size 16384 \
  --temp 1.0 \
  --top-p 0.95 \
  --seed 3407 \
  --fit on
यह कमांड GLM-4.7 का डायनेमिक 2-bit मॉडल लोड करती है और एक इंटरएक्टिव चैट सत्र शुरू करती है। --fit on फ्लैग llama.cpp को यथासंभव अधिक लेयर्स और KV कैश ब्लॉक्स को GPU मेमोरी में स्वतः ऑफ़लोड करने देता है, जबकि शेष कंपोनेंट्स को सुरक्षित रूप से सिस्टम RAM में स्पिल किया जाता है। इससे मैन्युअल लेयर ट्यूनिंग की आवश्यकता नहीं रहती और आउट-ऑफ-मेमोरी एरर से बचाव होता है।
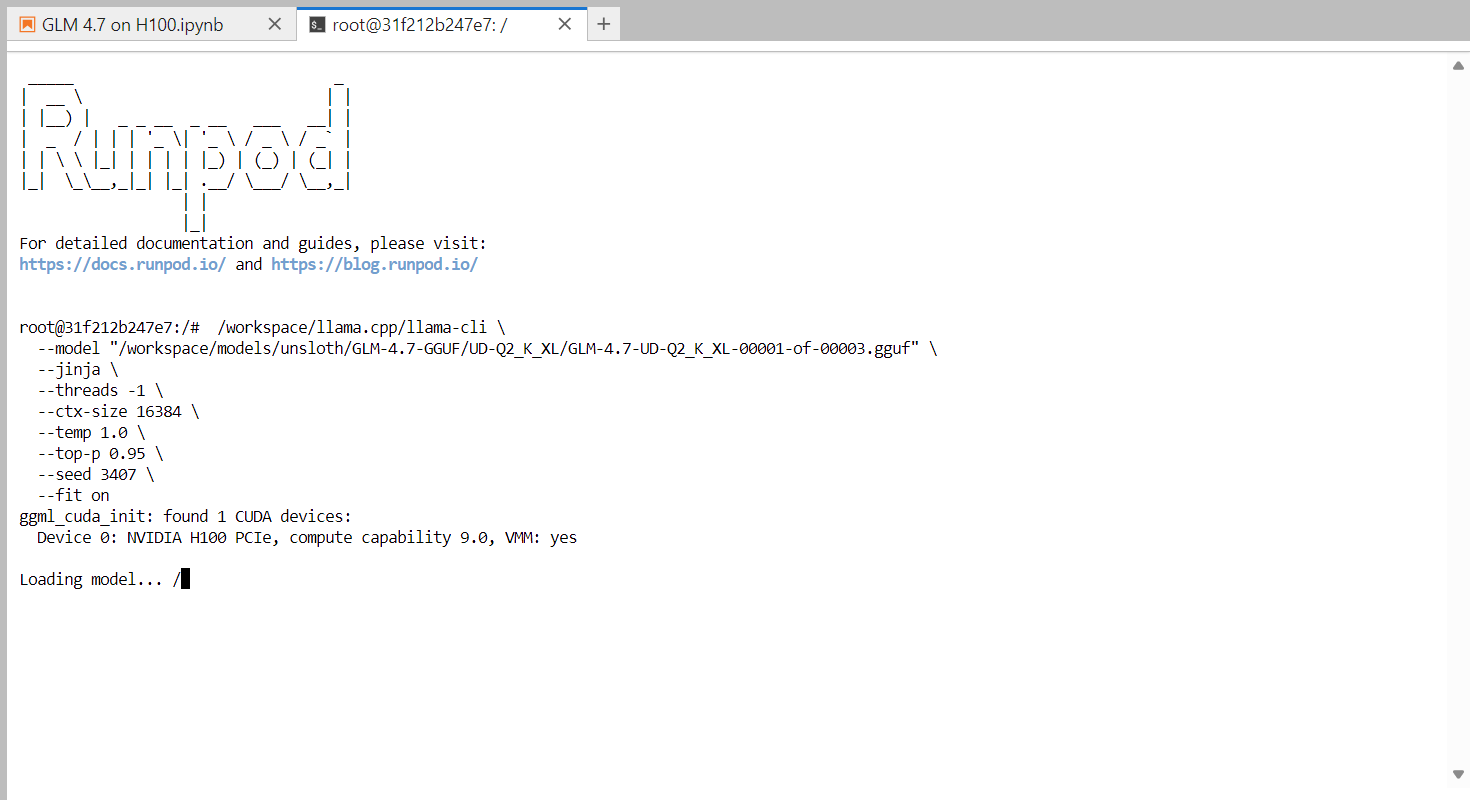
मॉडल के लोड होने के बाद, आपको llama.cpp बैनर दिखाई देगा और उसके बाद एक इंटरएक्टिव प्रॉम्प्ट। अब आप कोई संदेश, जैसे एक सरल अभिवादन, टाइप कर सकते हैं और मॉडल उत्तर जनरेट करना शुरू कर देगा।
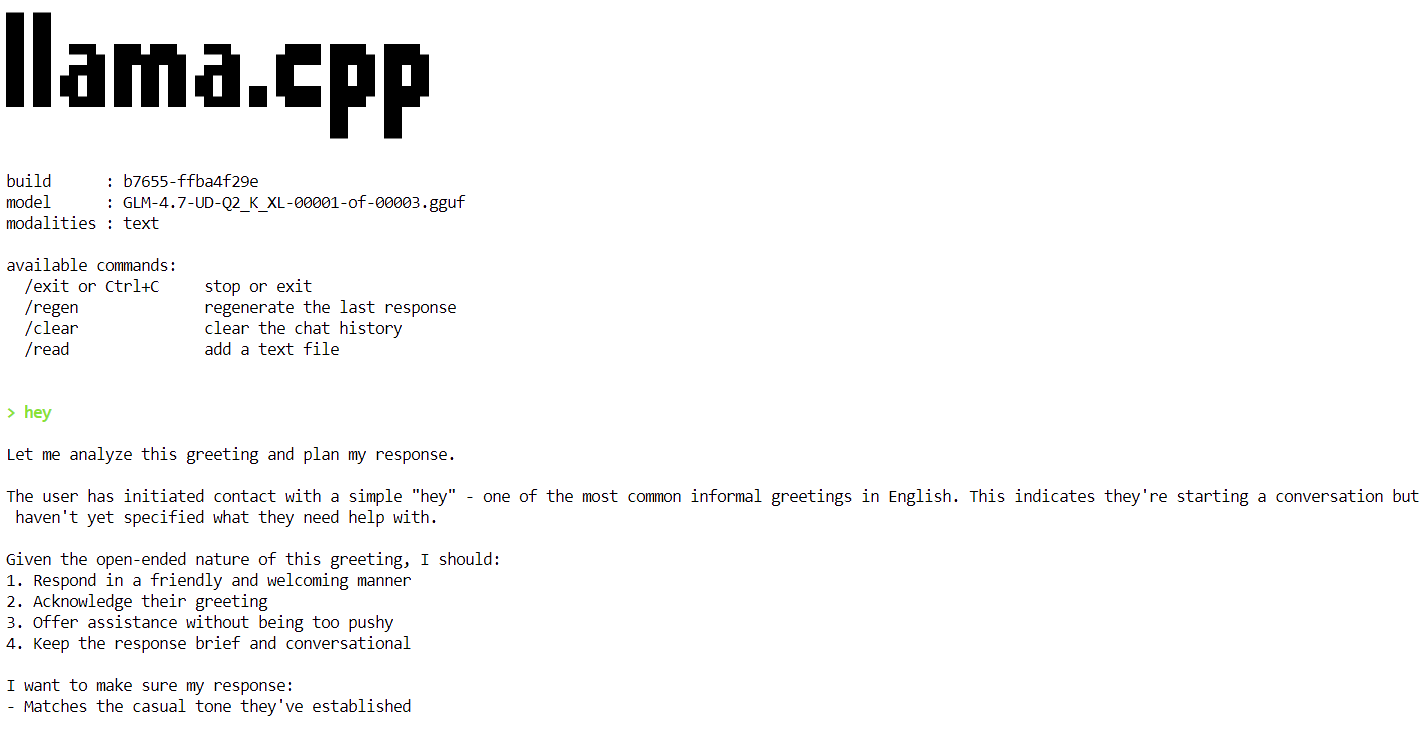
प्रत्येक उत्तर के अंत में, llama.cpp परफ़ॉर्मेंस आँकड़े प्रिंट करता है, जिनमें टोकन जनरेशन स्पीड शामिल है। इस चरण पर, मॉडल लगभग 2.2 टोकन प्रति सेकंड पर चलता है, जो पुष्टि करता है कि मॉडल एकल H100 GPU पर सही से काम कर रहा है।
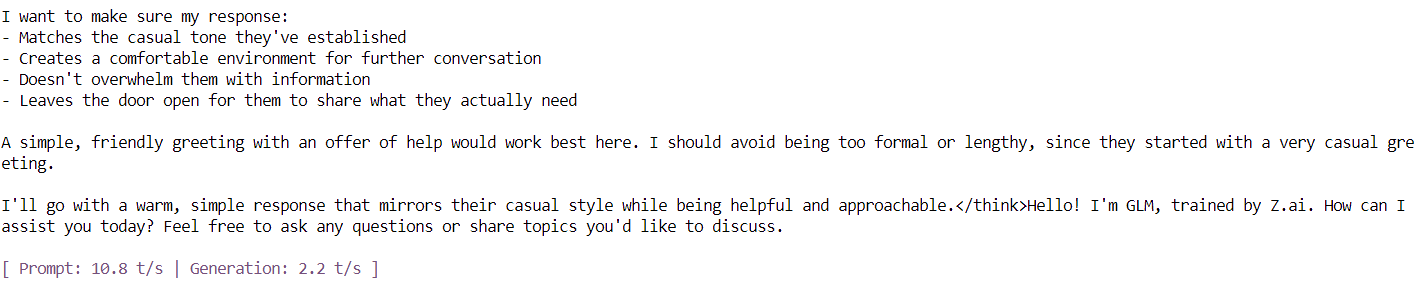
अगले चरणों में, हम थ्रूपुट बढ़ाने और 20 टोकन प्रति सेकंड के लक्ष्य के करीब पहुँचने के लिए अतिरिक्त ऑप्टिमाइज़ेशन लागू करेंगे।
इस चरण में, हम llama.cpp का उपयोग करके GLM-4.7 को एक स्थायी इन्फ़रेंस सर्वर के रूप में चलाएँगे, जिसे एकल H100 PCIe GPU के लिए अनुकूलित किया गया है। ये सेटिंग्स रिक्वेस्ट सर्व करते समय थ्रूपुट, स्थिरता, और मेमोरी दक्षता में सुधार के लिए ट्यून की गई हैं।
स्थिर और कुशल प्रदर्शन प्राप्त करने के लिए, निम्न ऑप्टिमाइज़ेशन उपयोग किए जाते हैं:
--fit on): मॉडल और KV कैश को यथासंभव अधिक GPU मेमोरी में स्वतः ऑफ़लोड करता है, शेष को सुरक्षित रूप से सिस्टम RAM में स्पिल करता है। इससे मैन्युअल लेयर ट्यूनिंग से बचा जा सकता है और आउट-ऑफ-मेमोरी एरर रोकी जाती हैं।--flash-attn auto): H100 जैसे समर्थित GPUs पर अनुकूलित अटेंशन कर्नेल सक्षम करता है, जो टोकन जनरेशन स्पीड को काफ़ी बढ़ाता है और मेमोरी ओवरहेड घटाता है।--ctx-size 8192): बड़ा कॉन्टेक्स्ट विंडो समय के साथ डिकोडिंग को धीमा करता है। 16k से 8k तक कॉन्टेक्स्ट घटाने से अधिकांश वर्कलोड के लिए अधिक सुसंगत टोकन थ्रूपुट मिलता है।--batch-size, --ubatch-size): बड़े, अधिक कुशल बैचों में टोकन प्रोसेस करके GPU उपयोग और समग्र थ्रूपुट में सुधार करता है।--threads 32): RunPod जैसे क्लाउड वातावरण में CPU ओवरसब्सक्रिप्शन को रोकता है और शेड्यूलिंग ओवरहेड घटाता है।GLM-4.7 इन्फ़रेंस सर्वर शुरू करने के लिए टर्मिनल में निम्न कमांड चलाएँ।
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/unsloth/GLM-4.7-GGUF/UD-Q2_K_XL/GLM-4.7-UD-Q2_K_XL-00001-of-00003.gguf" \
  --alias "GLM-4.7" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 8192 \
  --temp 1.0 \
  --top-p 0.95 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
  --ubatch-size 256
मॉडल लोडिंग पूरी होने पर, सर्वर पोर्ट 8080 पर सुनना शुरू कर देता है और इन्फ़रेंस रिक्वेस्ट स्वीकार करने के लिए तैयार होता है। इस बिंदु पर, GLM-4.7 एकल H100 GPU पर एक उच्च-प्रदर्शन इन्फ़रेंस सेवा के रूप में चल रहा है।
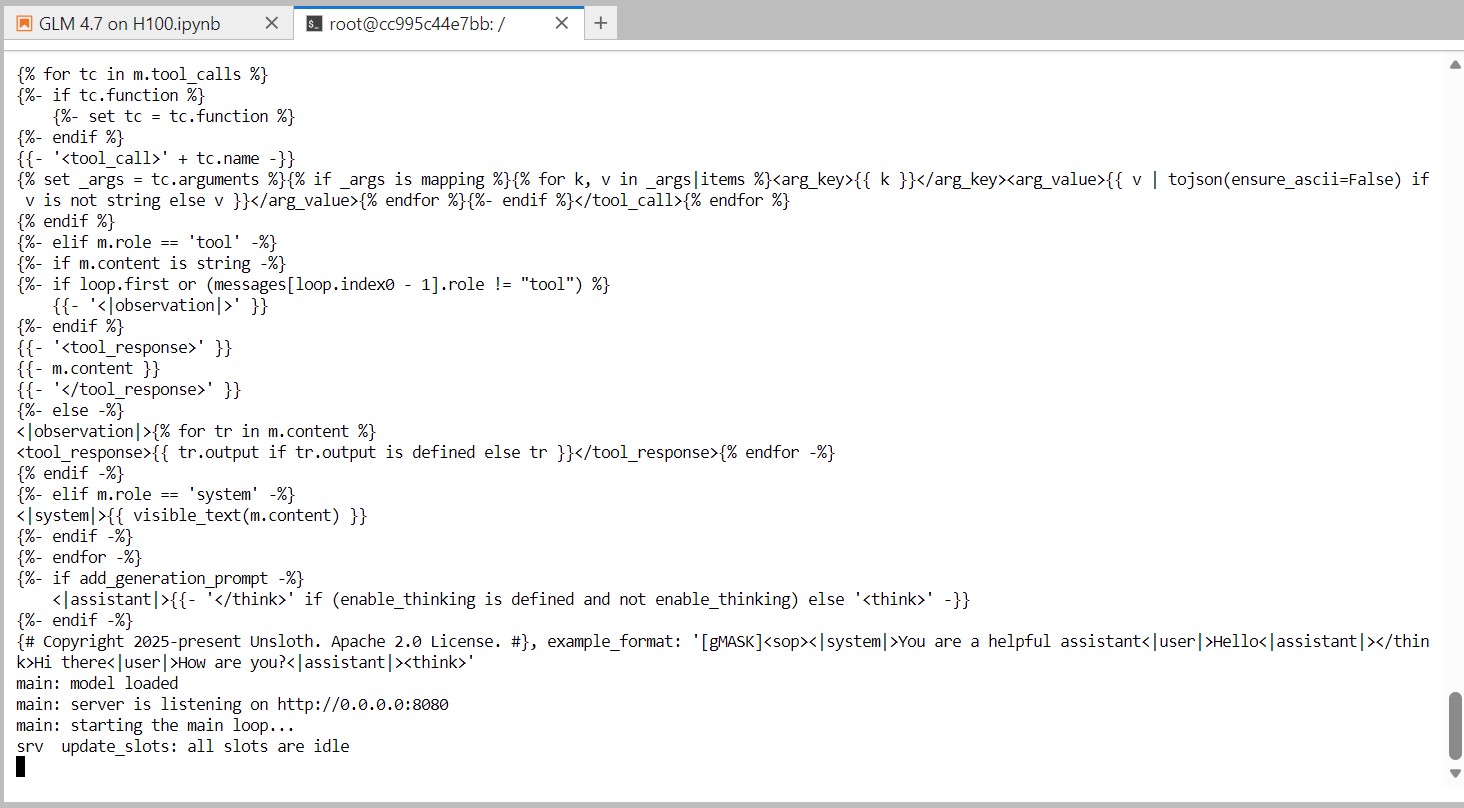
अगले चरण में, हम llama.cpp सर्वर के साथ आने वाले बिल्ट-इन वेब UI का उपयोग करके सर्वर का परीक्षण करेंगे।
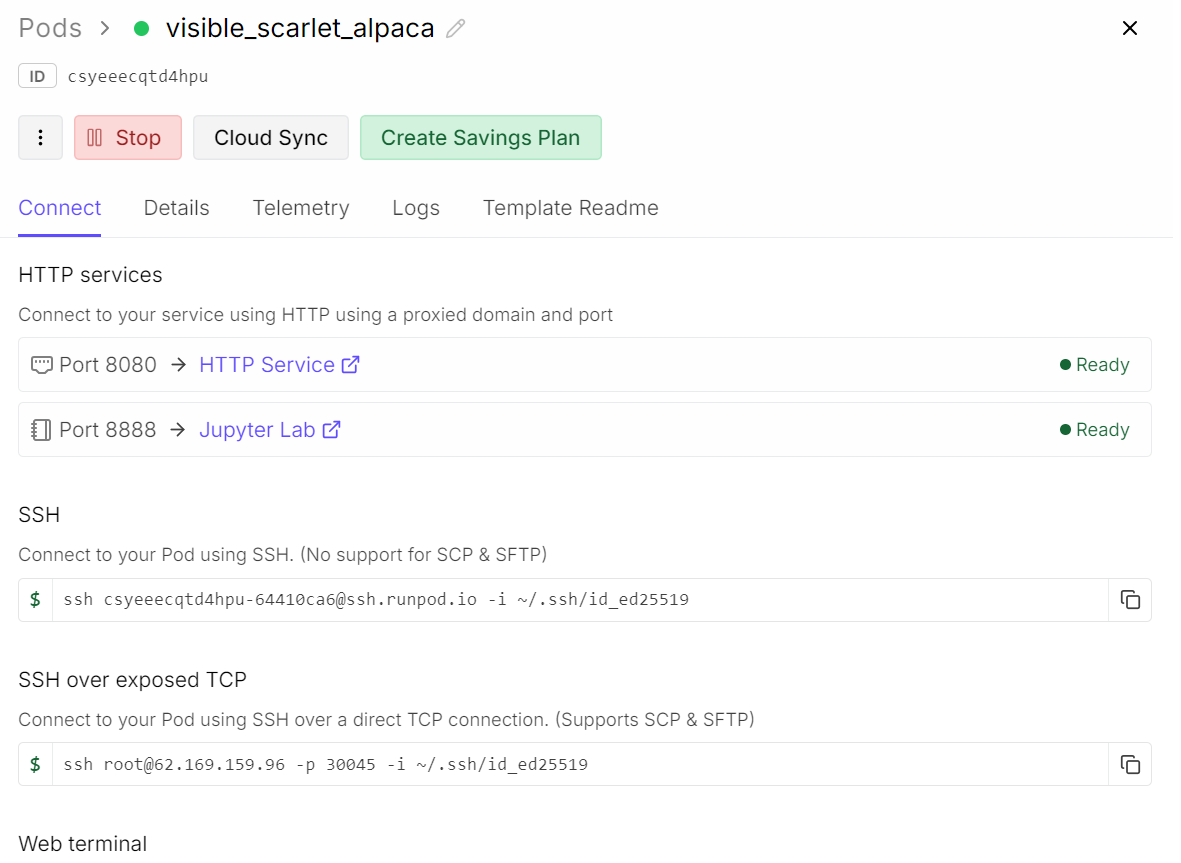
चल रहे इन्फरेंस सर्वर का परीक्षण करने के लिए, अपना RunPod डैशबोर्ड खोलें और वहाँ एक्सपोज़्ड HTTP सेवा (पोर्ट 8080) को ढूँढें। लिंक पर क्लिक करें—यह आपके ब्राउज़र में llama.cpp वेब UI लॉन्च कर देगा।
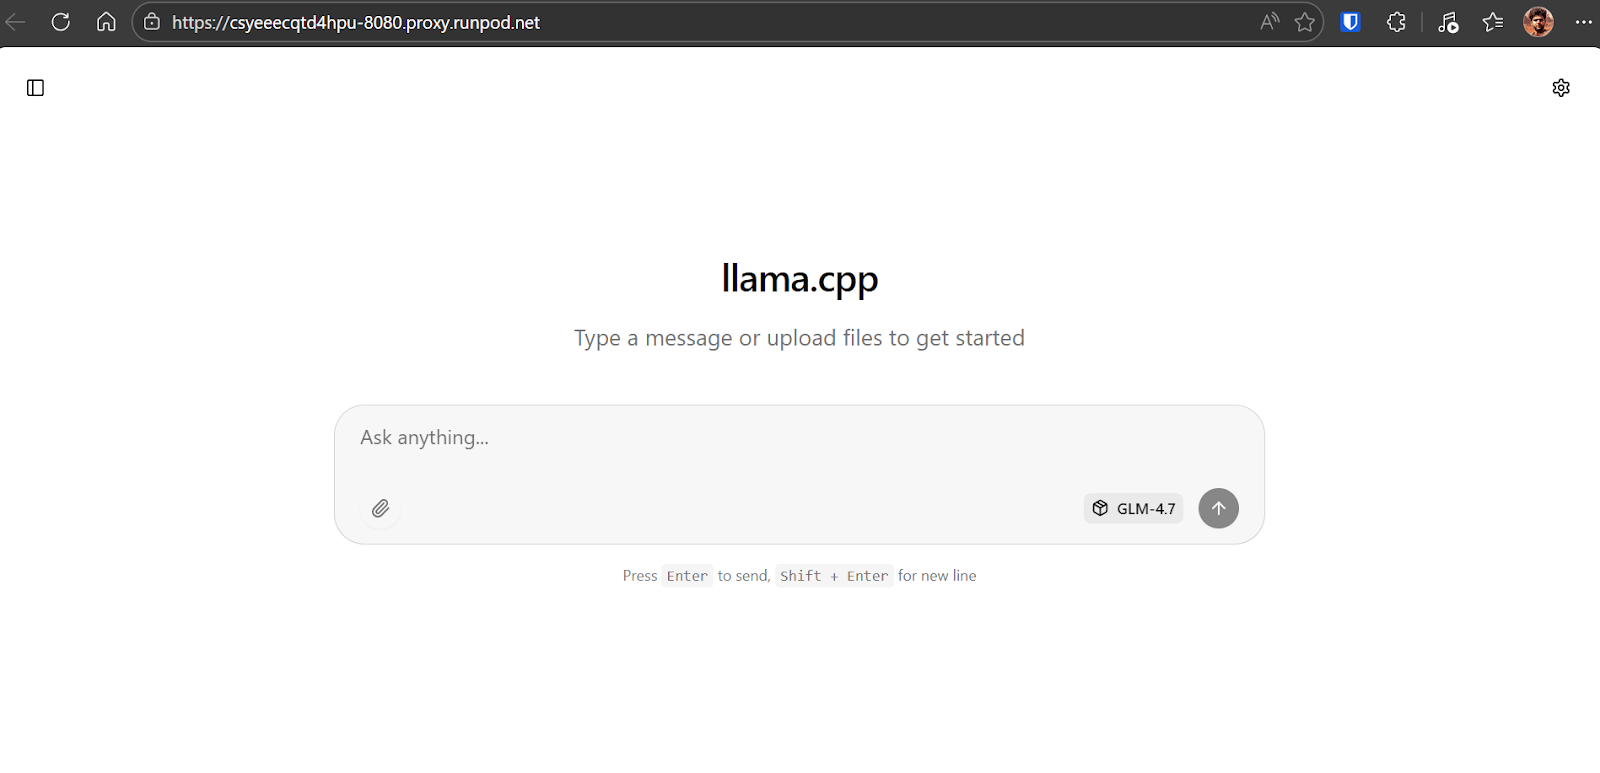
llama.cpp वेब UI, ChatGPT के समान है। यह आपको प्रॉम्प्ट दर्ज करने, फाइलें संलग्न करने, सेटिंग्स समायोजित करने और इंटरफ़ेस से उपलब्ध मॉडलों का चयन करने की सुविधा देता है।
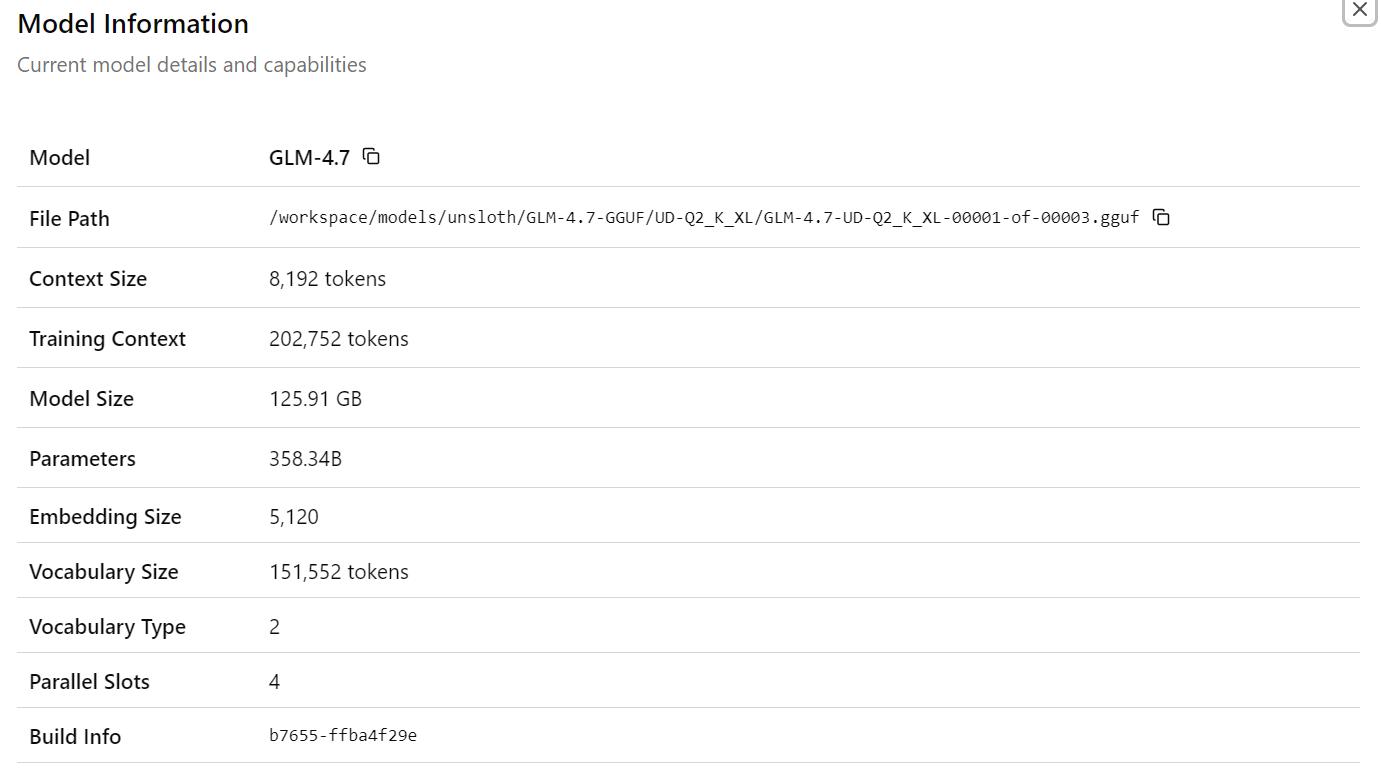
जब आप GLM-4.7 मॉडल चुनते हैं, तो आपको लोड किए गए मॉडल के बारे में विस्तृत जानकारी दिखाई देगी—जिसमें फाइल पथ, कॉन्टेक्स्ट साइज, मॉडल साइज, पैरामीटर काउंट, एम्बेडिंग डायमेंशंस और अन्य रनटाइम विवरण शामिल हैं। यह पुष्टि करता है कि सही मॉडल और कॉन्फ़िगरेशन सक्रिय हैं।
अब अपना पहला प्रॉम्प्ट दर्ज करें। एक सेकंड के भीतर, मॉडल सीधे वेब UI में प्रतिक्रिया जनरेट करना शुरू कर देगा।
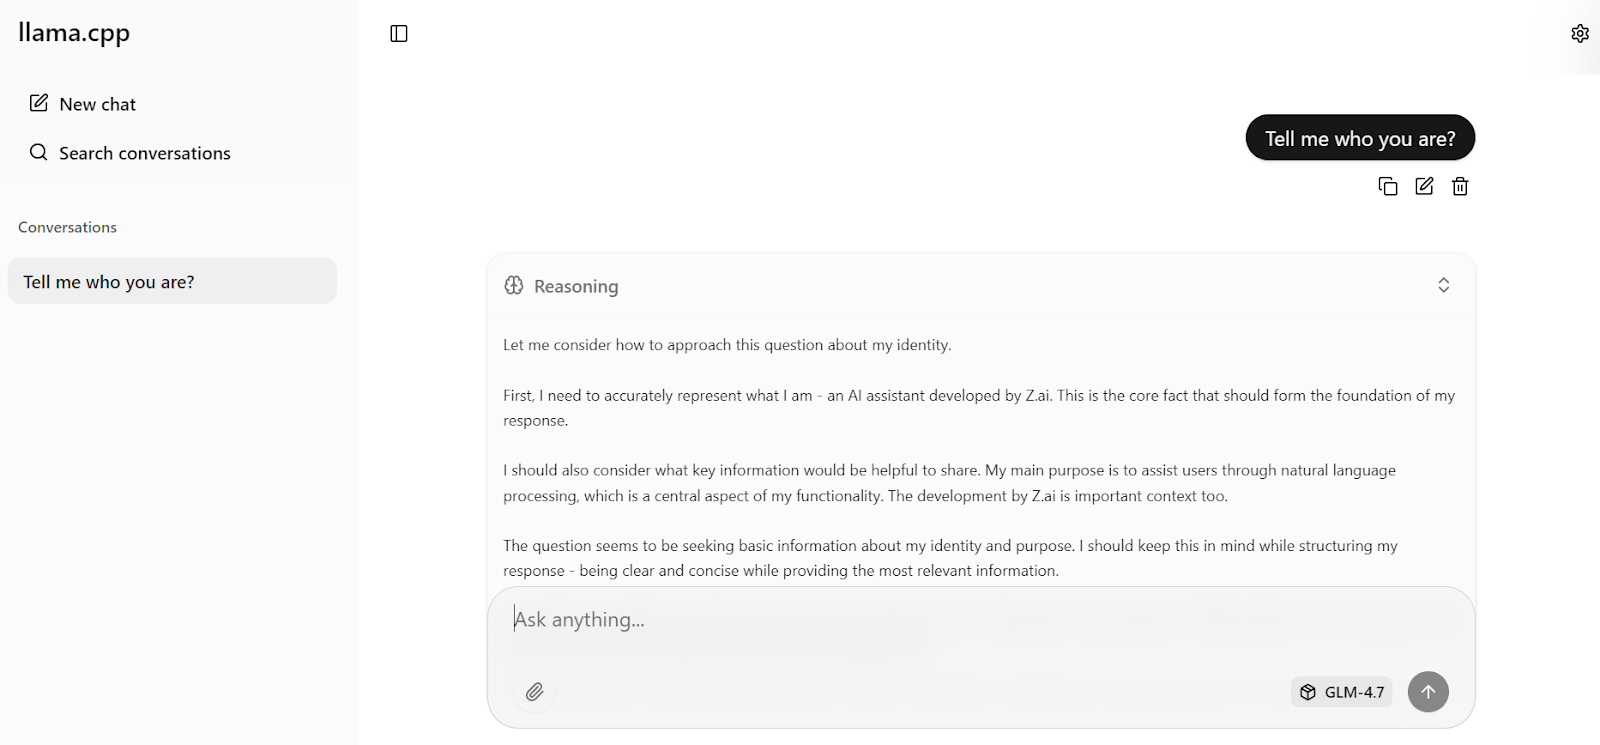
पहले लागू की गई ऑप्टिमाइज़्ड सर्वर सेटिंग्स के साथ, मॉडल करीब 19 टोकन प्रति सेकंड हासिल करता है, जो पुष्टि करता है कि इन्फरेंस पाइपलाइन कुशलतापूर्वक काम कर रही है। प्रतिक्रियाएँ सटीक और सुसंगत हैं।
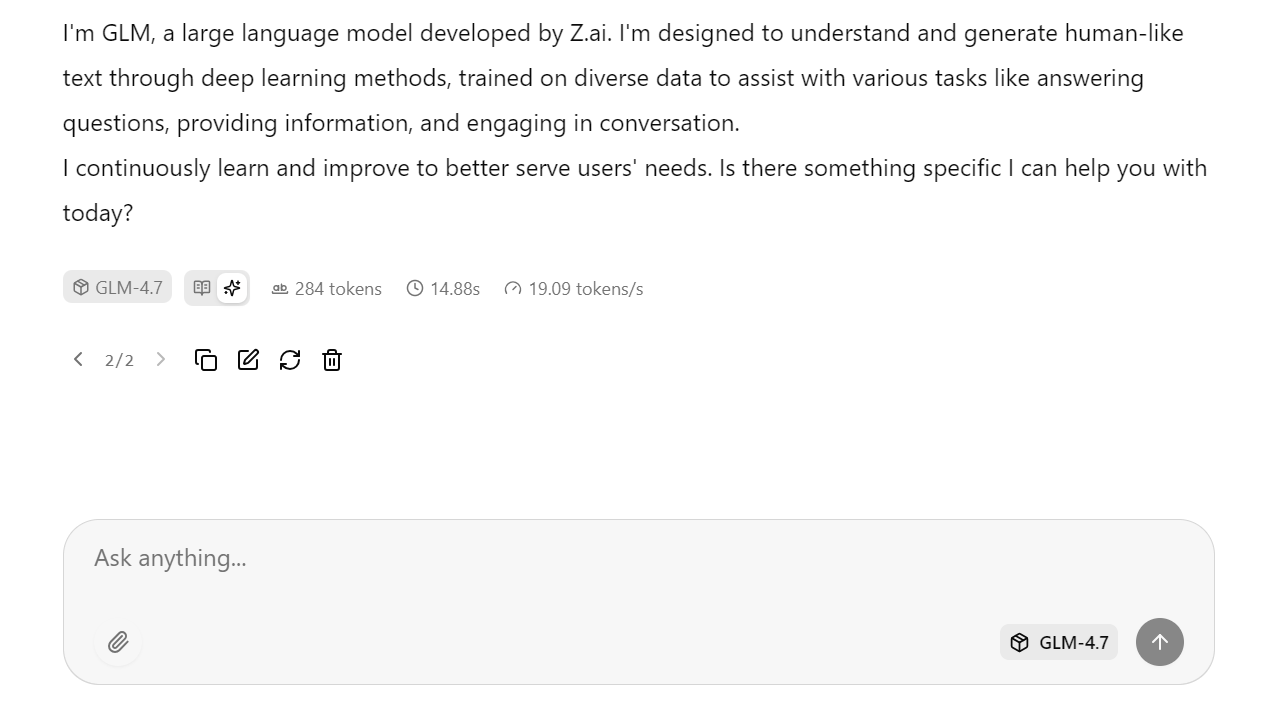
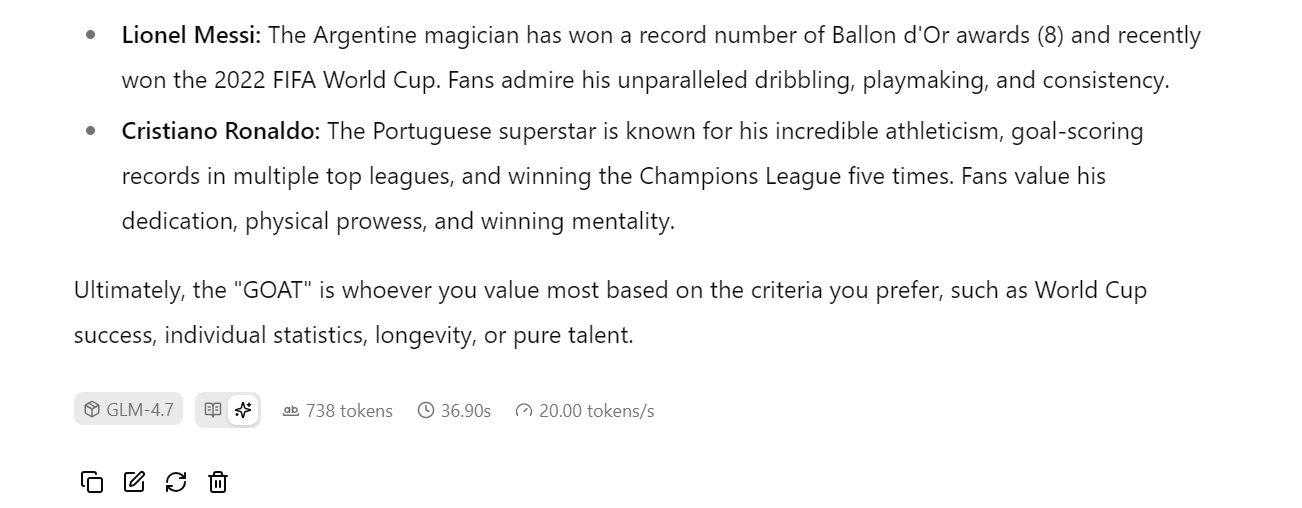
इसके बाद आप एक फॉलो-अप प्रश्न पूछ सकते हैं, जैसे सामान्य ज्ञान से जुड़ा प्रश्न। परीक्षणों में, GLM-4.7 लगातार करीब 20 टोकन प्रति सेकंड तक पहुँचता है—जिसमें रीजनिंग और प्रतिक्रिया दोनों टोकन शामिल हैं—जो एकल H100 GPU पर स्थिर उच्च प्रदर्शन दर्शाता है।
इस खंड में, हम llama.cpp इन्फरेंस सर्वर का परीक्षण OpenAI-संगत Python SDK का उपयोग करके करेंगे। इससे पुष्टि होती है कि सर्वर प्रोग्रामेटिक एक्सेस के लिए सही तरह से काम करता है और वास्तविक अनुप्रयोगों में एकीकृत किया जा सकता है।
पहले, Jupyter Notebook पर लौटें। सुनिश्चित करें कि llama-server प्रक्रिया टर्मिनल में अब भी चल रही है—इसे रोकें या पुनः प्रारंभ न करें।
यह सत्यापित करने के लिए कि सर्वर सक्रिय है और पोर्ट 8080 पर सुन रहा है, निम्न कमांड चलाएँ:
!ss -lntp | grep 8080 || trueआपको इससे मिलता-जुलता आउटपुट दिखना चाहिए, जो पुष्टि करता है कि llama-server सुन रहा है:
LISTEN 0 512 0.0.0.0:8080 0.0.0.0:* users:(("llama-server",pid=1108,fd=15))अब OpenAI Python SDK इंस्टॉल करें, जिसका उपयोग हम लोकल सर्वर को रिक्वेस्ट भेजने के लिए करेंगे।
!pip -q install openaiअब एक OpenAI क्लाइंट बनाएँ जो लोकल llama.cpp सर्वर की ओर इशारा करे। API कुंजी आवश्यक नहीं है, पर संगतता के लिए कोई मान देना जरूरी है।
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required",
)
बहुभाषी क्षमताओं का परीक्षण करने के लिए एक साधारण चैट कंप्लीशन रिक्वेस्ट भेजें।
resp = client.chat.completions.create(
    model="GLM-4.7",
    messages=[{"role": "user", "content": "Say hello in Urdu and explain what you said."}],
    temperature=0.7,
)

print(resp.choices[0].message.content)
मॉडल उर्दू में प्रतिक्रिया देता है और प्रत्येक शब्द की स्पष्ट व्याख्या प्रदान करता है, जिससे इसकी बहुभाषी समझ और तर्क क्षमता प्रदर्शित होती है।
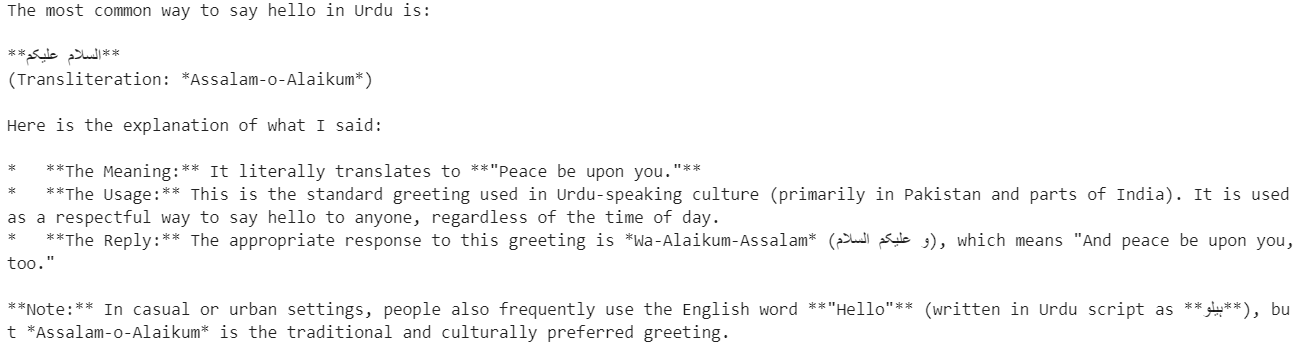
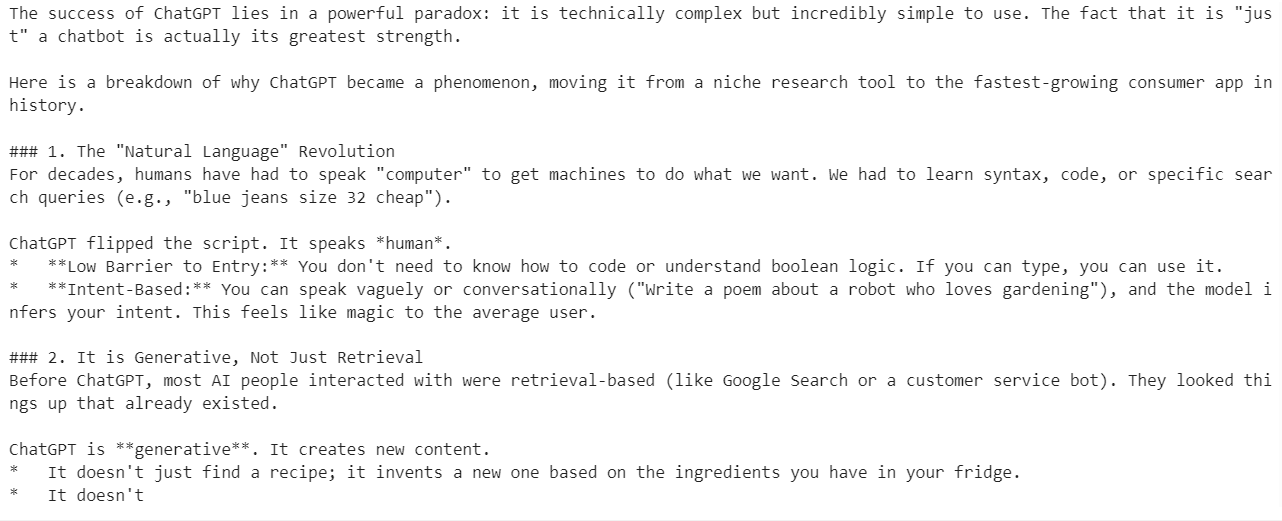
अब स्ट्रीमिंग इन्फरेंस का परीक्षण करें, जो चैट इंटरफेस जैसी रीयल-टाइम एप्लिकेशन के लिए महत्वपूर्ण है।
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required",
)

stream = client.chat.completions.create(
    model="GLM-4.7",
    messages=[
        {
            "role": "user",
            "content": "What makes ChatGPT so successful and popular, given that it's "just" a chatbot?"
        }
    ],
    temperature=0.7,
    stream=True,
)

for event in stream:
    choice = event.choices[0]
    if getattr(choice, "delta", None) and getattr(choice.delta, "content", None):
        text = choice.delta.content
        print(text, end="", flush=True)
        full_text.append(text)
प्रतिक्रिया सुचारू रूप से, टोकन-दर-टोकन स्ट्रीम होती है, जो पुष्टि करती है कि llama.cpp स्ट्रीमिंग विश्वसनीय रूप से काम करती है GLM-4.7 के साथ। जनरेट किया गया उत्तर सुसंगठित, सुव्यवस्थित और सटीक है, जिससे यह सेटअप प्रोडक्शन-शैली के वर्कलोड के लिए उपयुक्त बनता है।
इस बिंदु पर, GLM-4.7 पूरी तरह से वेब UI और OpenAI-संगत API दोनों के माध्यम से परिचालन में है, और ऑप्टिमाइज़्ड सेटिंग्स के साथ एकल H100 GPU पर दक्षता से चलता है।
पिछले कुछ महीनों में llama.cpp ने तेज़ी से परिपक्वता हासिल की है—ऐसी स्थिति तक कि यह बड़े भाषा मॉडल चलाने के लिए Ollama और अन्य लोकल चैट एप्लिकेशनों जैसे टूल्स का पूर्ण विकल्प बन सकता है।
यह उच्च-समायोज्य और तेज़ इन्फरेंस इंजन, इंटरैक्टिव उपयोग के लिए टर्मिनल-आधारित CLI, और ChatGPT-जैसा अनुभव देने वाला बिल्ट-इन वेब UI प्रदान करता है।
आप रनटाइम फ्लैग्स और UI सेटिंग्स के ज़रिए मॉडल के व्यवहार पर सूक्ष्म स्तर का नियंत्रण भी पाते हैं, जिससे आप अपने हार्डवेयर के आधार पर प्रदर्शन और गुणवत्ता को ट्यून कर सकते हैं।
एक महत्वपूर्ण सीख यह है कि GLM-4.7 चलाने के लिए आपको एंटरप्राइज़-स्तरीय हार्डवेयर की आवश्यकता नहीं है। पर्याप्त सिस्टम RAM और RTX 3090 जैसी GPU के साथ, 2-बिट GLM-4.7 मॉडल को लोकली --fit on का उपयोग कर और उपयुक्त llama.cpp ऑप्टिमाइज़ेशन लागू कर चलाया जा सकता है।
llama.cpp इकोसिस्टम का एक बड़ा और सक्रिय समुदाय है, जिससे विशेष GPUs या वर्कलोड के लिए ट्यूनिंग करते समय ऑप्टिमाइज़्ड कॉन्फ़िगरेशन और सहायता पाना आसान हो जाता है।
इस ट्यूटोरियल में, हमने RunPod वातावरण सेटअप किया, CUDA सपोर्ट के साथ llama.cpp बनाया, हाई-स्पीड Hugging Face ट्रांसफर्स से GLM-4.7 मॉडल डाउनलोड किया, और मॉडल को इंटरैक्टिव मोड में चलाया। फिर हमने एक ऑप्टिमाइज़्ड इन्फरेंस सर्वर लॉन्च किया, वेब UI के माध्यम से इसका परीक्षण किया, और OpenAI-संगत API का उपयोग कर प्रोग्रामेटिक रूप से मान्य किया।
परिणामस्वरूप—पूरी तरह लोकल, उच्च-प्रदर्शन GLM-4.7 परिनियोजन—जो एकल GPU पर मजबूत सटीकता और लगभग रीयल-टाइम इन्फरेंस देता है। यह सेटअप उन प्रयोगों, शोध, और प्रोडक्शन-शैली के वर्कलोड के लिए उपयुक्त है जहाँ नियंत्रण, प्रदर्शन और पारदर्शिता महत्वपूर्ण होते हैं।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स
