
Corso
Lavorare con l'API di OpenAI
3 ore
179.5K
GLM-4.7 è il tuo nuovo partner di coding, progettato per rendere meglio nei flussi di lavoro di sviluppo reali. Rispetto a GLM-4.6, mostra progressi evidenti nel coding multilingue e agentico, nei task da terminale e nell’uso di strumenti, con ottimi risultati su SWE-bench, SWE-bench Multilingual e Terminal Bench 2.0. Supporta anche il pensare prima di agire, risultando più affidabile per compiti complessi nei moderni framework per agenti.
In questo tutorial, passiamo subito alla configurazione di un ambiente Runpod, all’installazione di tutte le dipendenze necessarie e al clone di llama.cpp con pieno supporto CUDA. Poi scarichiamo il modello GLM-4.7 a 2 bit da Hugging Face, lo eseguiamo sia in modalità CLI sia server e infine testiamo il server in esecuzione usando l’SDK OpenAI.
Puoi anche consultare la nostra guida per eseguire GLM 4.7 Flash in locale.
Prima di eseguire GLM-4.7 in locale, assicurati che il tuo sistema soddisfi i requisiti seguenti.
Per prestazioni utilizzabili è necessaria una GPU NVIDIA.
Installa gli ultimi driver NVIDIA e verifica l’installazione con:
nvidia-smiSe questo comando funziona e mostra la tua GPU, la configurazione dei driver è corretta.
CUDA è necessaria per l’accelerazione GPU quando si esegue GLM-4.7. Se stai compilando llama.cpp dai sorgenti, CUDA deve essere rilevata correttamente in fase di build.
Usando binari precompilati con supporto CUDA, un runtime CUDA funzionante deve essere già installato sul sistema. Senza supporto CUDA, GLM-4.7 ricadrà sull’esecuzione su CPU, troppo lenta per un uso reale.
GLM-4.7 è estremamente grande, anche quando quantizzato. Che il modello si avvii e la sua velocità dipendono dalla memoria complessiva, non solo dalla VRAM della GPU.
Pensa in termini di VRAM GPU + RAM di sistema insieme.
Per GLM-4.7, la sola dimensione della H100 non basta. Un’inferenza stabile e veloce dipende dalla memoria totale disponibile, combinando VRAM della GPU e RAM di sistema.
Per questo tutorial useremo RunPod perché si configura rapidamente e offre una vasta gamma di GPU disponibili on demand.
Inizia creando un nuovo pod. Seleziona l’ultima immagine PyTorch, poi clicca su Edit nelle impostazioni del template. Aumenta la dimensione del volume a 200 GB, dato che il modello GLM-4.7 è molto grande, anche nella forma quantizzata a 2 bit.
Successivamente, esponi le porte necessarie. Mantieni la porta predefinita 8080 per JupyterLab e aggiungi un’ulteriore porta che verrà poi usata dal server di llama.cpp.
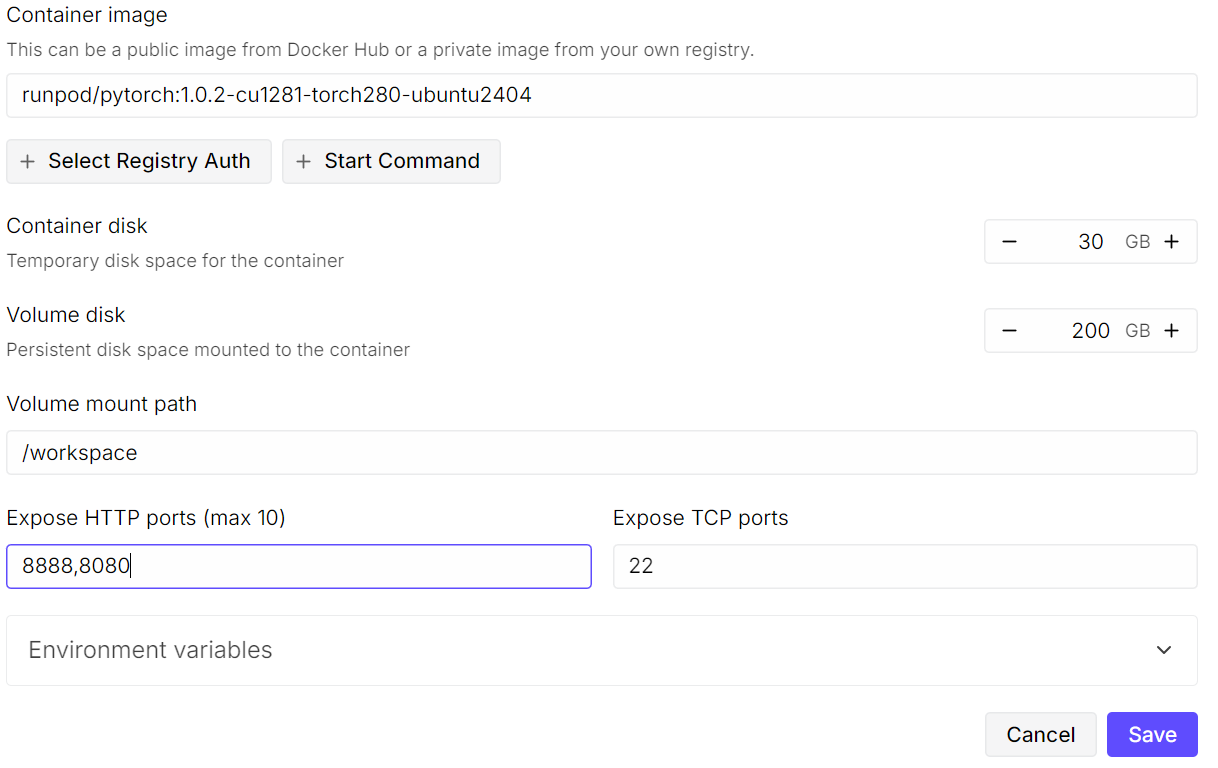 Una volta configurato, il riepilogo dei prezzi e del pod dovrebbe mostrare chiaramente che il template predefinito è stato sovrascritto con un volume più grande.
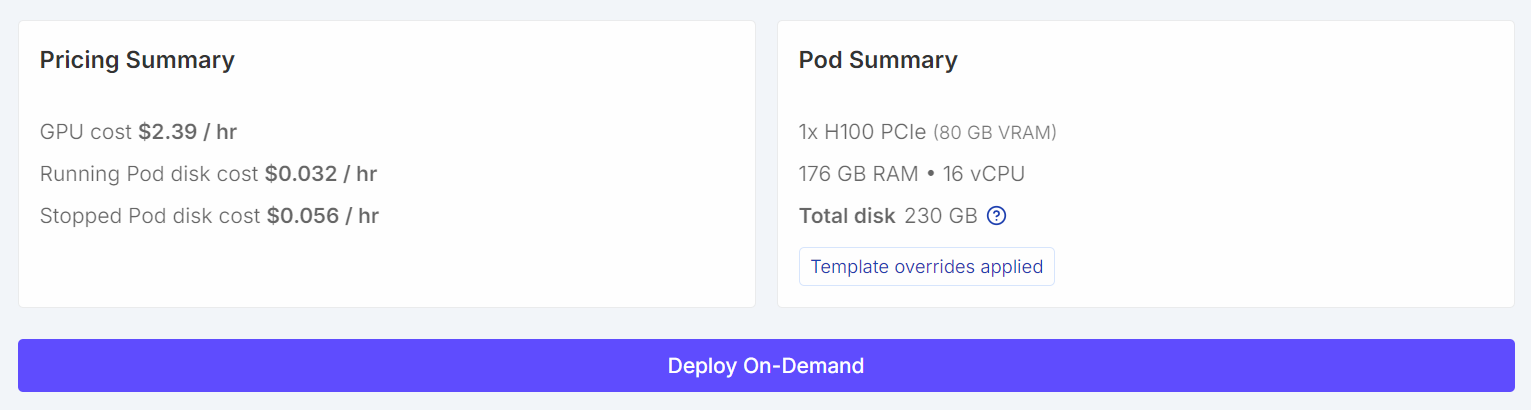
Dopo l’avvio del pod, clicca sul link Jupyter Notebook per lanciare JupyterLab. Crea un nuovo notebook ed esegui il seguente codice di setup.
import os

WORKDIR = "/workspace"
LLAMA_DIR = f"{WORKDIR}/llama.cpp"
MODEL_DIR = f"{WORKDIR}/models/unsloth/GLM-4.7-GGUF"

os.makedirs(MODEL_DIR, exist_ok=True)

# Put Hugging Face cache on /workspace (big speed win on RunPod)
os.environ["HF_HOME"] = f"{WORKDIR}/.cache/huggingface"
os.environ["HUGGINGFACE_HUB_CACHE"] = f"{WORKDIR}/.cache/huggingface/hub"
os.environ["HF_HUB_CACHE"] = f"{WORKDIR}/.cache/huggingface/hub"
os.environ["HF_HUB_DISABLE_SYMLINKS_WARNING"] = "1"

# Enable HF Xet high performance (Xet backend)
os.environ["HF_XET_HIGH_PERFORMANCE"] = "1"

print("WORKDIR:", WORKDIR)
print("LLAMA_DIR:", LLAMA_DIR)
print("MODEL_DIR:", MODEL_DIR)
print("HF_HOME:", os.environ["HF_HOME"])
print("HF_HUB_CACHE:", os.environ["HF_HUB_CACHE"])
print("HF_XET_HIGH_PERFORMANCE:", os.environ["HF_XET_HIGH_PERFORMANCE"])
Questo codice:
/workspace come directory di lavoro principale su RunPod.llama.cpp verrà clonato e compilato./workspace per download più rapidi e più spazio su disco.Dovresti vedere un output simile a questo:
WORKDIR: /workspace
LLAMA_DIR: /workspace/llama.cpp
MODEL_DIR: /workspace/models/unsloth/GLM-4.7-GGUF
HF_HOME: /workspace/.cache/huggingface
HF_HUB_CACHE: /workspace/.cache/huggingface/hub
HF_XET_HIGH_PERFORMANCE: 1
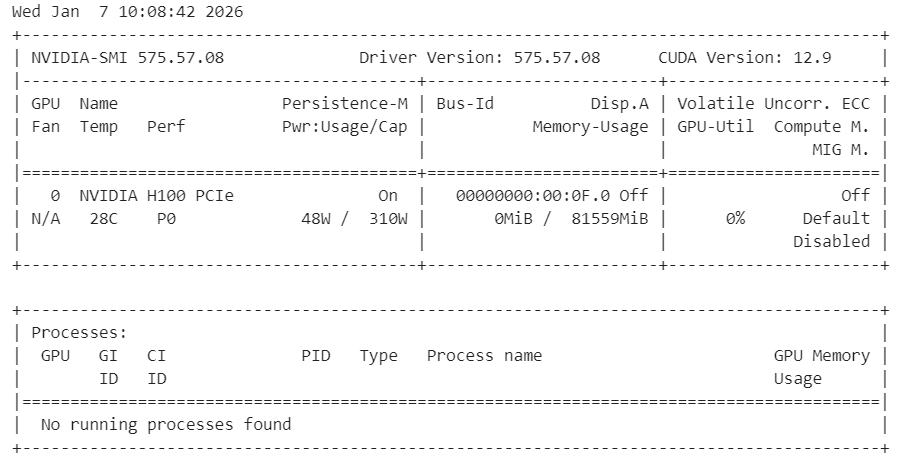
Poi, verifica che i driver NVIDIA siano installati correttamente e che la GPU sia visibile.
!nvidia-smiDovresti vedere una GPU H100 con 80 GB di VRAM disponibile, a conferma che l’ambiente è pronto per l’accelerazione GPU.
Infine, installa le dipendenze di sistema necessarie per compilare llama.cpp dai sorgenti.
%%capture
!apt-get update -y
!apt-get install -y build-essential cmake curl libcurl4-openssl-dev git pciutils
Nota: Abbiamo usato %%capture per nascondere i log verbosi dell’installazione in Jupyter pur eseguendo i comandi.
In questo passaggio cloneremo e compileremo llama.cpp dai sorgenti con CUDA abilitata per garantire prestazioni GPU ottimali.
Per prima cosa, clona il repository ufficiale nello workspace.
!git clone https://github.com/ggml-org/llama.cpp /workspace/llama.cppPoi configura la build con supporto CUDA abilitato e librerie condivise disabilitate.
%%capture
!cmake /workspace/llama.cpp -B /workspace/llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
Quindi compila i binari necessari in modalità release.
%%capture
!cmake --build /workspace/llama.cpp/build --config Release -j --clean-first --target llama-cli llama-server
Al termine della build, copia i binari nella directory principale e verifica l’output.
%%capture
!cp /workspace/llama.cpp/build/bin/llama-* /workspace/llama.cpp/
!ls -la /workspace/llama.cpp | sed -n '1,60p'
A questo punto, llama.cpp è pronto con pieno supporto CUDA e può essere usato per eseguire GLM-4.7 via CLI o server.
In questo passaggio, installiamo le librerie Hugging Face con supporto Xet e HF Transfer per velocizzare sensibilmente il download di modelli grandi. Xet offre prestazioni molto più veloci di Git LFS, essenziale per scaricare GLM-4.7 in modo efficiente.
Per prima cosa, installa le dipendenze Hugging Face necessarie e abilita HF Transfer.
!pip -q install -U "huggingface_hub[hf_xet]" hf-xet
!pip -q install -U hf_transfer
Abilita HF Transfer impostando la variabile d’ambiente.
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
Dopo aver installato questi pacchetti, riavvia il kernel di Jupyter per assicurarti che le nuove impostazioni abbiano effetto.
Quindi scarica il modello GLM-4.7 GGUF da Hugging Face usando snapshot_download. Limitiamo il download alla quantizzazione dinamica a 2 bit consigliata per ridurre lo spazio e l’uso di memoria.
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="unsloth/GLM-4.7-GGUF",
    local_dir=MODEL_DIR,
    allow_patterns=["*UD-Q2_K_XL*"],  # recommended dynamic 2-bit
)
print("Downloaded into:", MODEL_DIR)
Con Xet e HF Transfer abilitati, le velocità di download possono raggiungere 726 MB al secondo e poi salire fino a 1,2 GB al secondo. Senza questa configurazione, le velocità tipiche sono intorno a 50 MB al secondo, con tempi di download che possono arrivare a quasi un giorno per un modello di queste dimensioni.
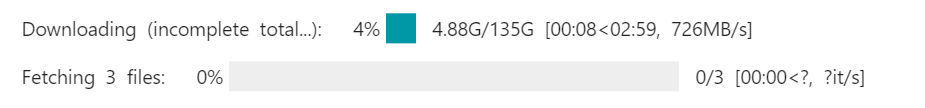
Una volta terminato il download, il modello GLM-4.7 sarà disponibile in locale nella directory dei modelli dello workspace, pronto per l’inferenza con llama.cpp.
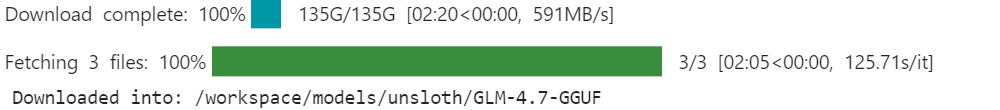
Ora eseguiremo GLM-4.7 in modalità interattiva usando la CLI di llama.cpp.
Apri un terminale dentro JupyterLab. Clicca sul pulsante Plus (+) in JupyterLab, scorri in basso e seleziona Terminal. Si aprirà una nuova sessione shell nell’ambiente RunPod.
Nel terminale, esegui il seguente comando per avviare la CLI interattiva.
 /workspace/llama.cpp/llama-cli \
  --model "/workspace/models/unsloth/GLM-4.7-GGUF/UD-Q2_K_XL/GLM-4.7-UD-Q2_K_XL-00001-of-00003.gguf" \
  --jinja \
  --threads -1 \
  --ctx-size 16384 \
  --temp 1.0 \
  --top-p 0.95 \
  --seed 3407 \
  --fit on
Questo comando carica il modello dinamico a 2 bit di GLM-4.7 e avvia una sessione di chat interattiva. Il flag --fit on permette a llama.cpp di offloadare automaticamente il maggior numero possibile di layer e blocchi di cache KV sulla GPU, riversando in sicurezza i componenti rimanenti sulla RAM di sistema. Questo elimina la necessità di un tuning manuale dei layer e aiuta a evitare errori di memoria insufficiente.
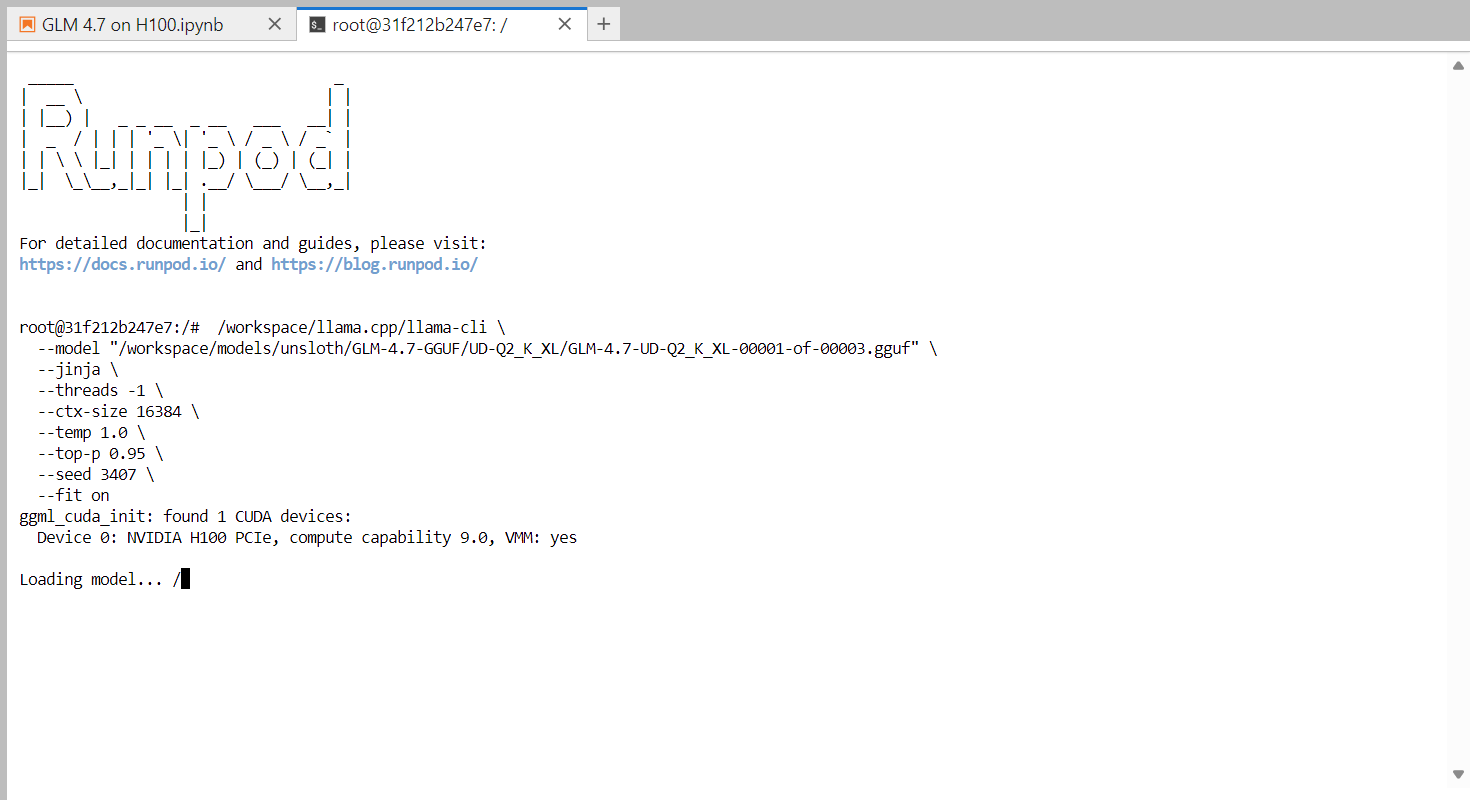
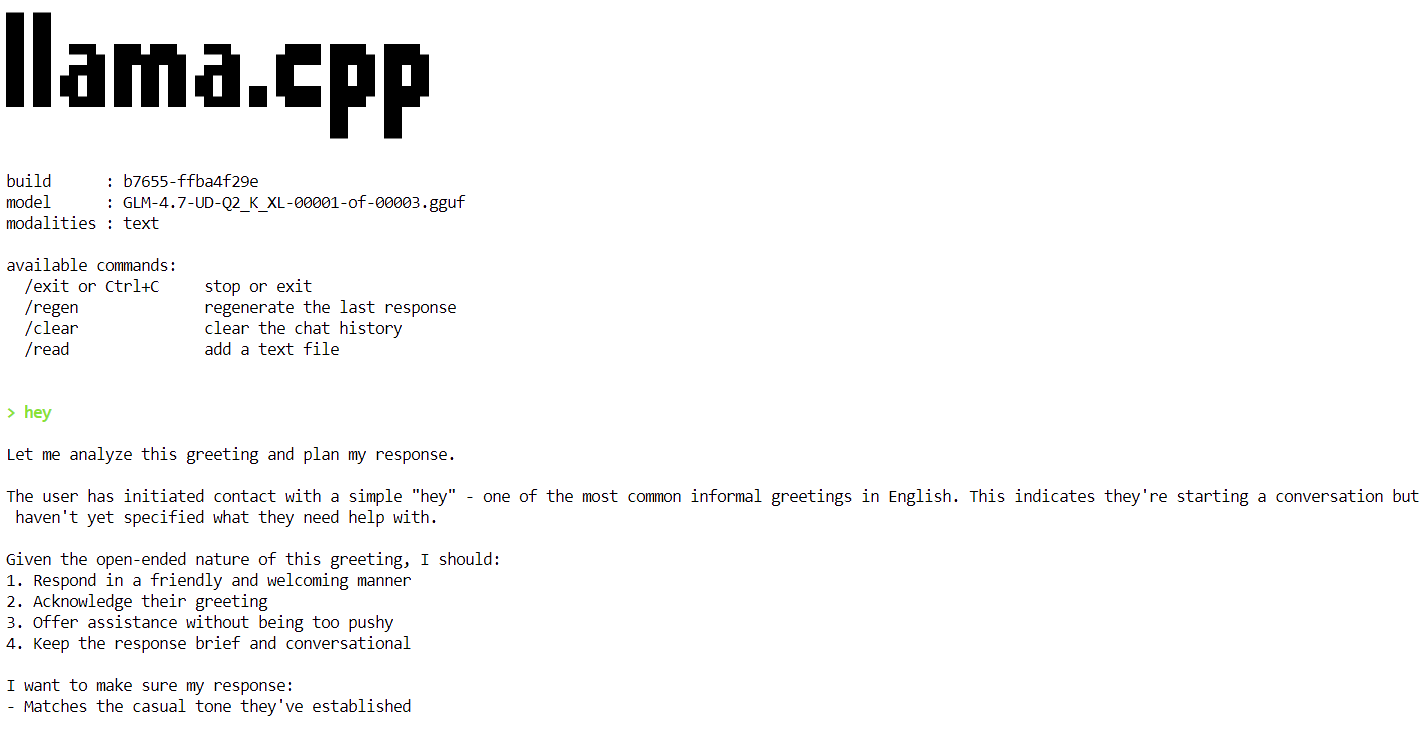
Al termine del caricamento del modello, vedrai il banner di llama.cpp seguito da un prompt interattivo. Ora puoi digitare un messaggio, ad esempio un semplice saluto, e il modello inizierà a generare risposte.
Alla fine di ogni risposta, llama.cpp stampa statistiche sulle prestazioni, inclusa la velocità di generazione dei token. In questa fase, il modello gira a circa 2,2 token al secondo, confermando che il modello funziona correttamente su una singola GPU H100.
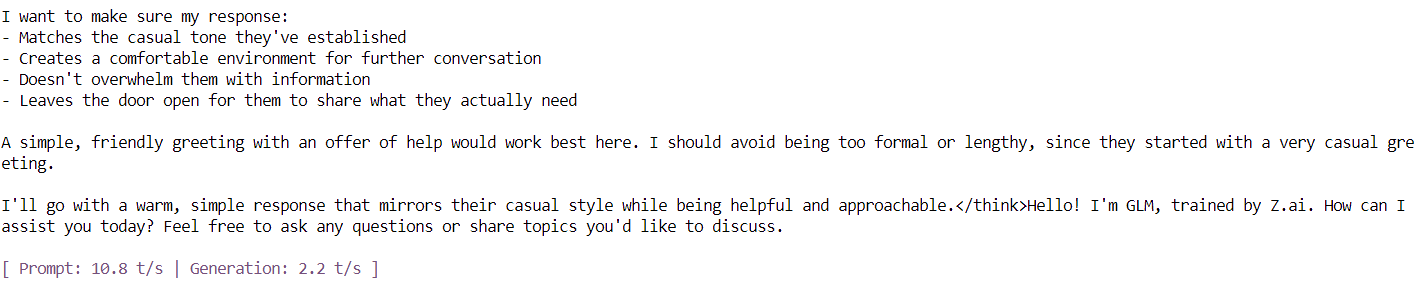
Nei prossimi passaggi applicheremo ulteriori ottimizzazioni per aumentare il throughput e avvicinarci all’obiettivo di 20 token al secondo.
In questo passaggio eseguiamo GLM-4.7 come server di inferenza persistente usando llama.cpp, ottimizzato per una singola GPU H100 PCIe. Queste impostazioni sono regolate per migliorare throughput, stabilità ed efficienza della memoria durante il serving delle richieste.
Per ottenere prestazioni stabili ed efficienti, usiamo le seguenti ottimizzazioni:
--fit on): Offloada automaticamente quanto più possibile del modello e della cache KV sulla memoria GPU, riversando in sicurezza il resto sulla RAM di sistema. Evita il tuning manuale dei layer e previene errori di memoria insufficiente.--flash-attn auto): Abilita kernel di attenzione ottimizzati su GPU supportate come la H100, migliorando sensibilmente la velocità di generazione dei token e riducendo l’overhead di memoria.--ctx-size 8192): Finestre di contesto ampie rallentano il decoding nel tempo. Ridurre la dimensione del contesto da 16k a 8k fornisce un throughput dei token più costante per la maggior parte dei carichi.--batch-size, --ubatch-size): Migliora l’utilizzo della GPU e il throughput complessivo elaborando i token in batch più grandi ed efficienti.--threads 32): Previene l’oversubscription della CPU e riduce l’overhead di scheduling in ambienti cloud come RunPod.Esegui il seguente comando nel terminale per avviare il server di inferenza GLM-4.7.
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/unsloth/GLM-4.7-GGUF/UD-Q2_K_XL/GLM-4.7-UD-Q2_K_XL-00001-of-00003.gguf" \
  --alias "GLM-4.7" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 8192 \
  --temp 1.0 \
  --top-p 0.95 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
  --ubatch-size 256
Una volta terminato il caricamento del modello, il server inizia ad ascoltare sulla porta 8080 ed è pronto a ricevere richieste di inferenza. A questo punto, GLM-4.7 è in esecuzione come servizio di inferenza ad alte prestazioni su una singola GPU H100.
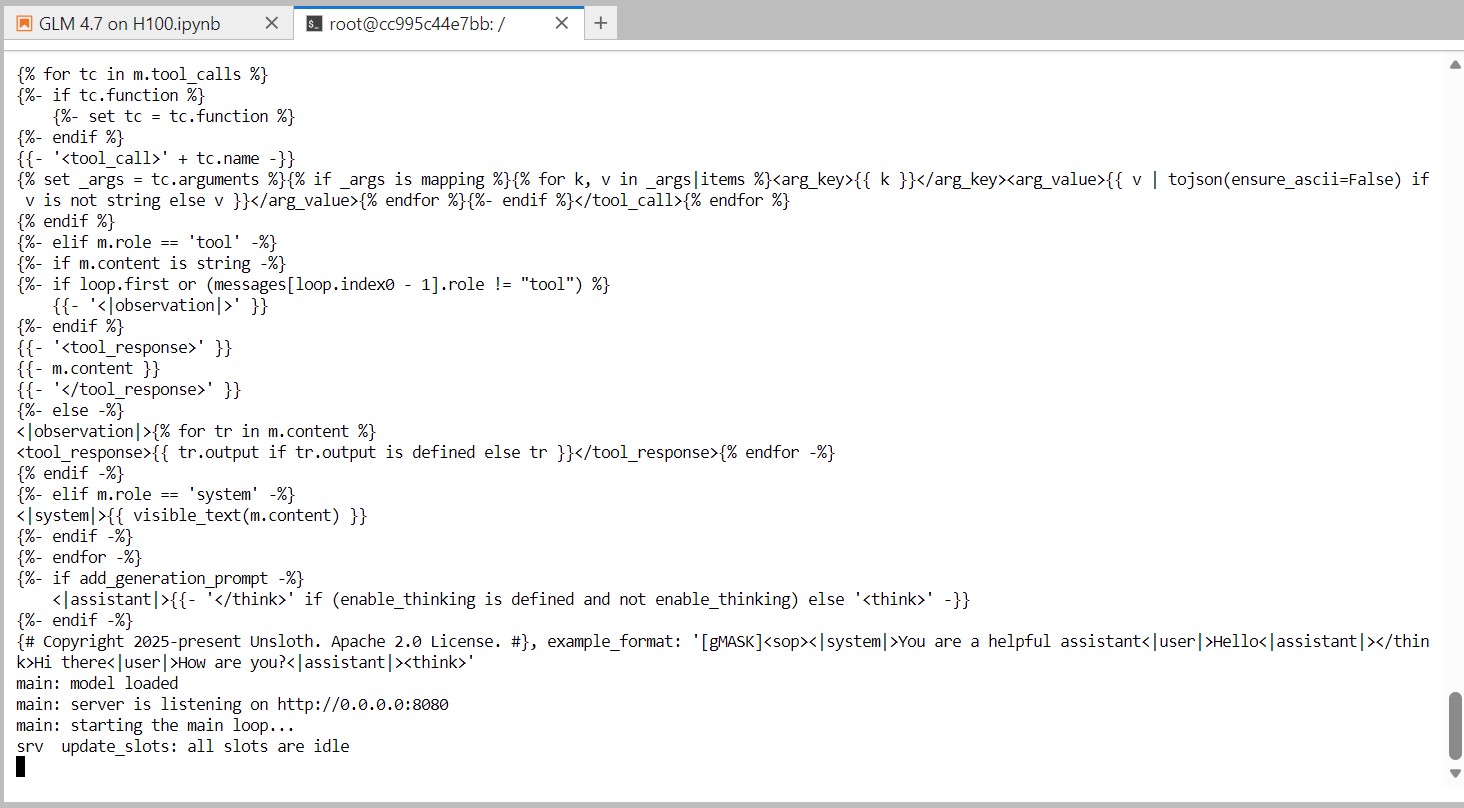
Nel prossimo passaggio testeremo il server usando la web UI integrata fornita con il server di llama.cpp.
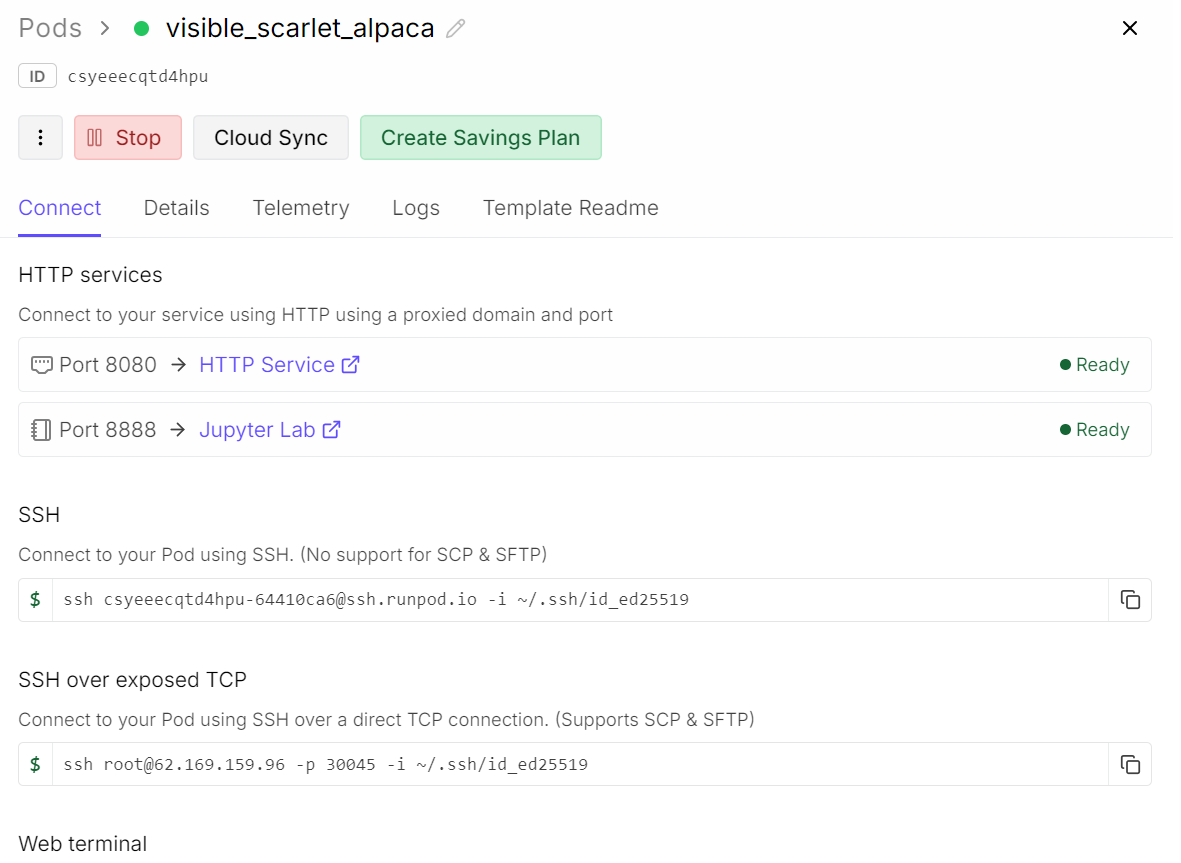
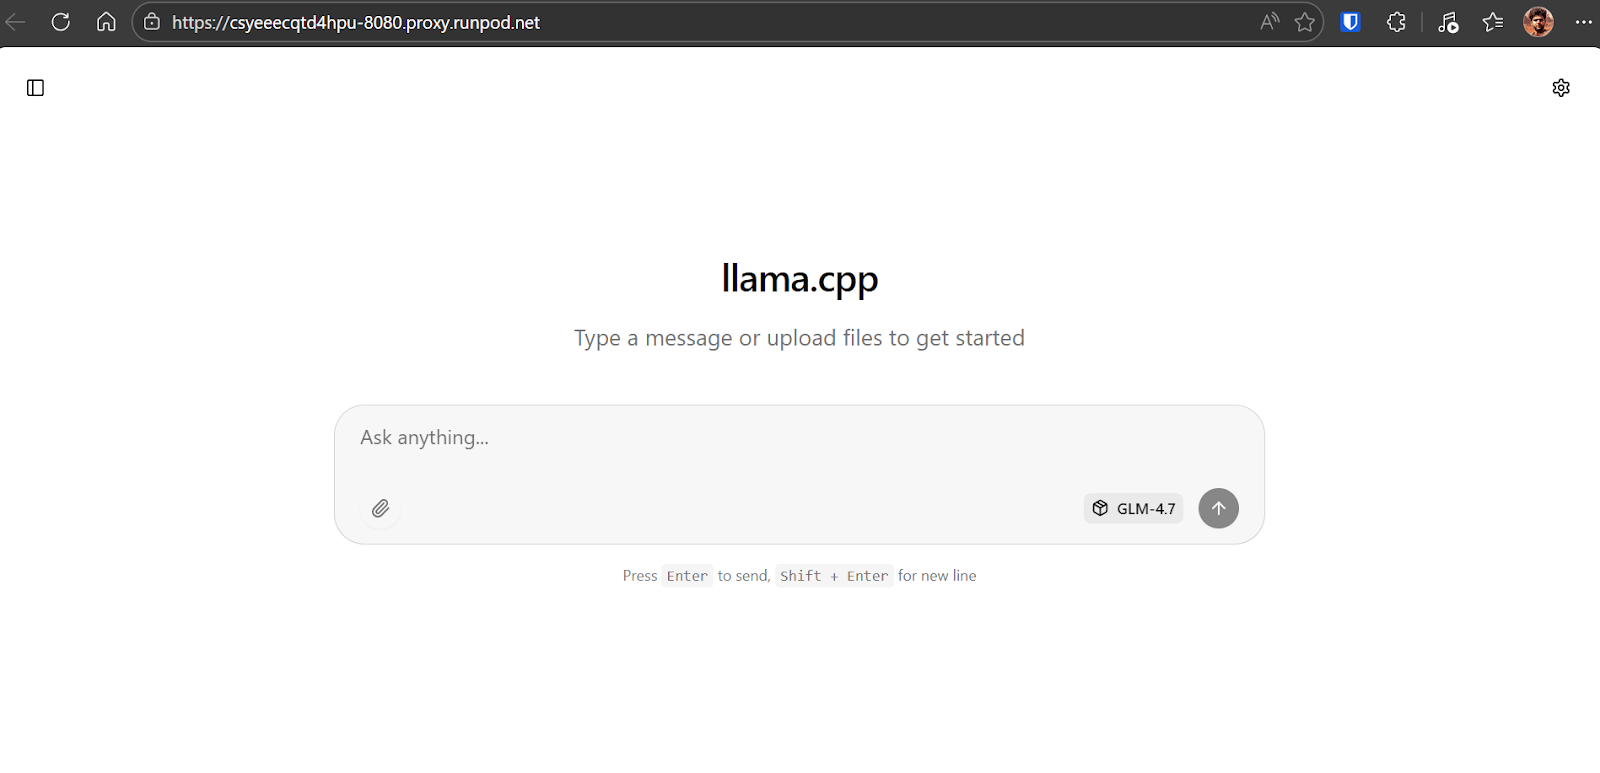
Per testare il server di inferenza in esecuzione, apri la tua dashboard RunPod e individua il servizio HTTP esposto sulla porta 8080. Clicca sul link e si avvierà la web UI di llama.cpp nel browser.
La web UI di llama.cpp è simile a ChatGPT. Ti permette di inserire prompt, allegare file, regolare le impostazioni e selezionare i modelli disponibili dall’interfaccia.
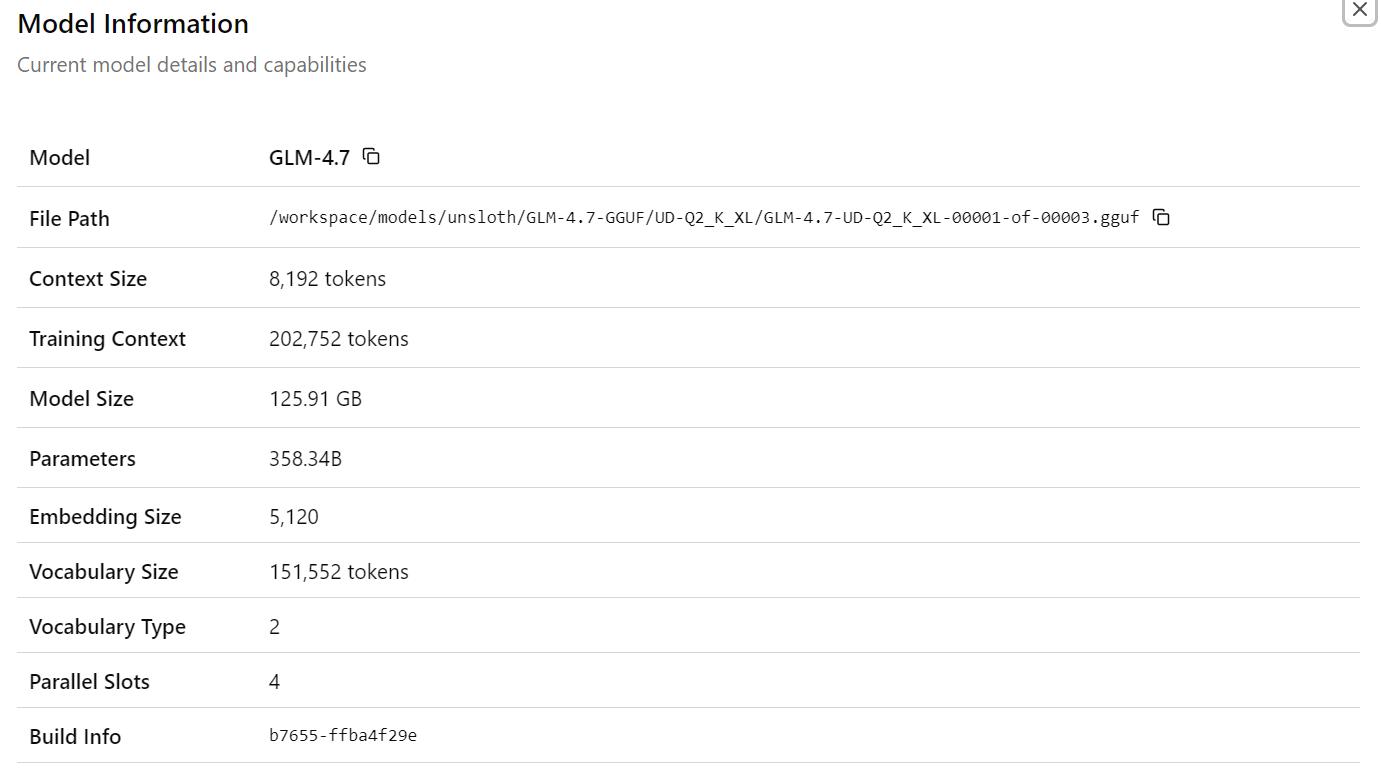
Dopo aver selezionato il modello GLM-4.7, vedrai informazioni dettagliate sul modello caricato, inclusi percorsi dei file, dimensione del contesto, dimensione del modello, numero di parametri, dimensioni degli embedding e altri dettagli runtime. Questo conferma che il modello e la configurazione corretti sono attivi.
Ora inserisci il tuo primo prompt. Entro un secondo, il modello inizierà a generare una risposta direttamente nella web UI.
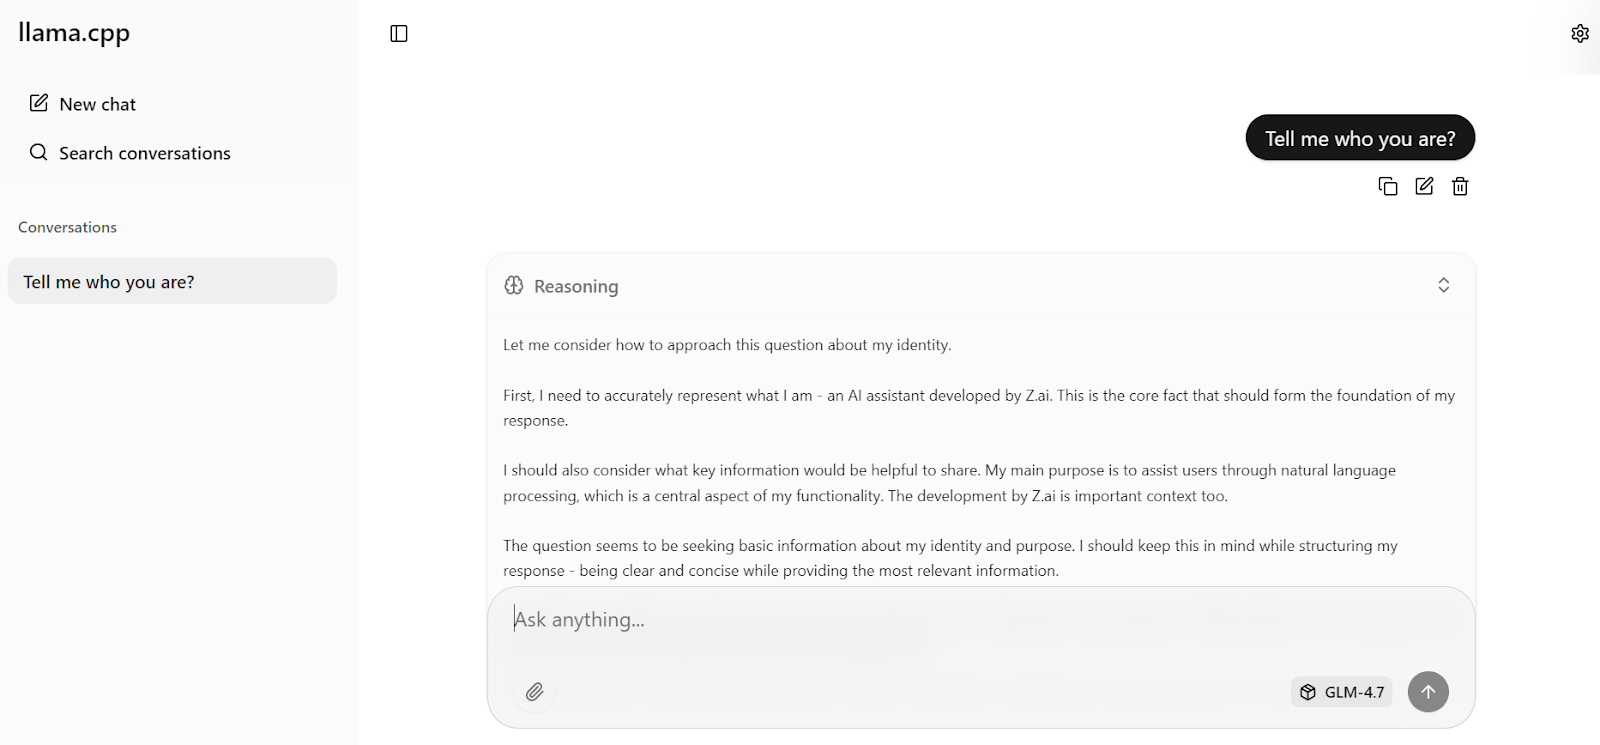
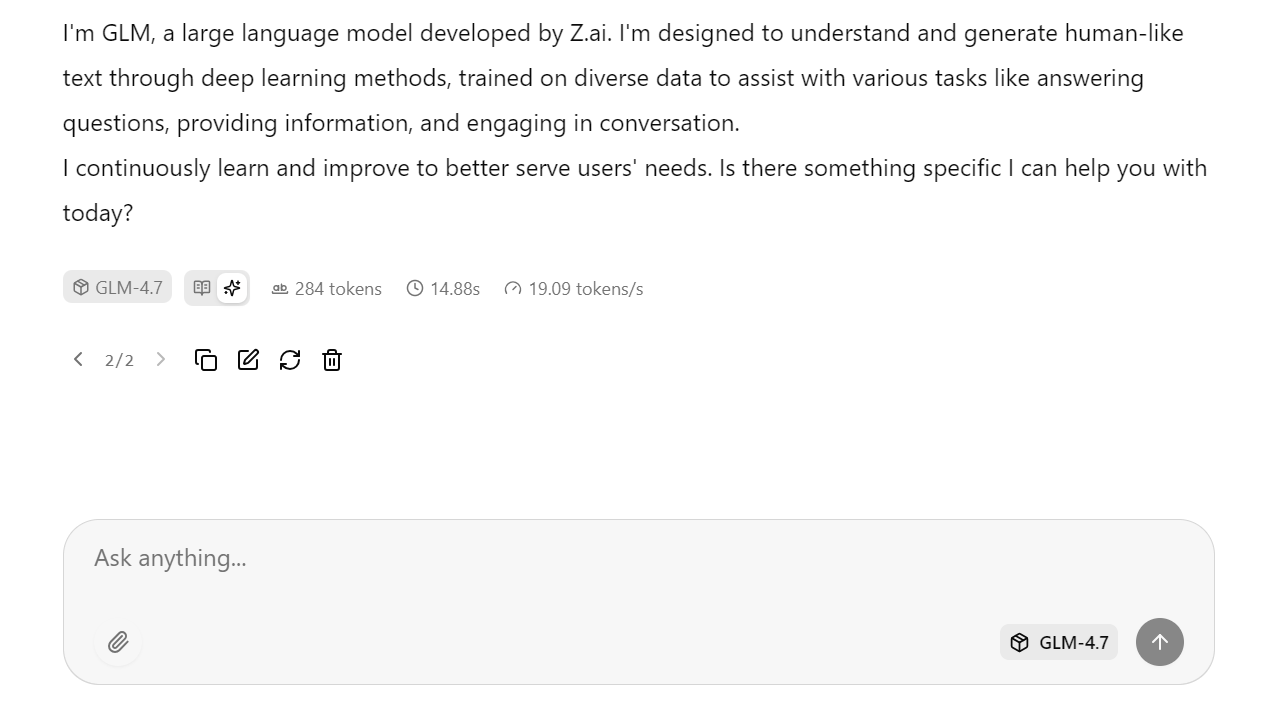
Con le impostazioni del server ottimizzate applicate in precedenza, il modello raggiunge circa 19 token al secondo, confermando che la pipeline di inferenza funziona in modo efficiente. Le risposte sono accurate e coerenti.
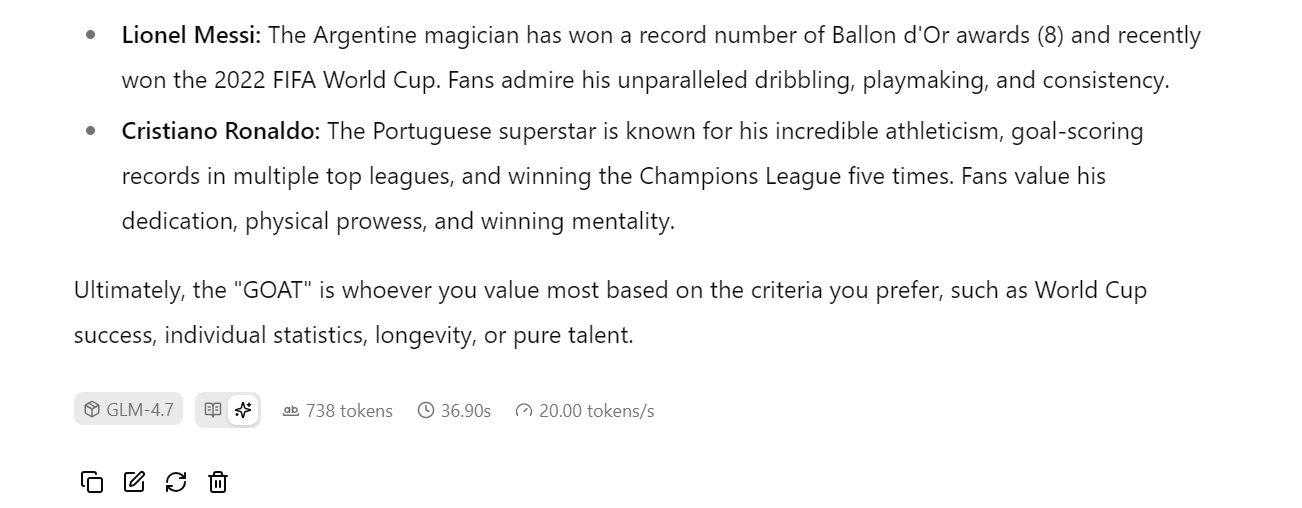
Puoi quindi porre una domanda di follow-up, ad esempio una query di conoscenza generale. Nei test, GLM-4.7 raggiunge costantemente circa 20 token al secondo, includendo sia il ragionamento sia i token di risposta, dimostrando prestazioni elevate e stabili su una singola GPU H100.
In questa sezione testeremo il server di inferenza llama.cpp in esecuzione usando l’SDK Python compatibile con OpenAI . Questo conferma che il server funziona correttamente per l’accesso programmatico e può essere integrato in applicazioni reali.
Per prima cosa, torna al Jupyter Notebook. Assicurati che il processo llama-server sia ancora in esecuzione nel terminale e non interromperlo o riavviarlo.
Per verificare che il server sia attivo e in ascolto sulla porta 8080, esegui il seguente comando:
!ss -lntp | grep 8080 || trueDovresti vedere un output simile a questo, a conferma che llama-server è in ascolto:
LISTEN 0 512 0.0.0.0:8080 0.0.0.0:* users:(("llama-server",pid=1108,fd=15))Ora installa l’SDK OpenAI per Python, che useremo per inviare richieste al server locale.
!pip -q install openaiCrea ora un client OpenAI che punti al server locale di llama.cpp. Il valore della chiave API non è richiesto, ma deve essere fornito per compatibilità.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required",
)
Invia una semplice richiesta di chat completion per testare le capacità multilingue.
resp = client.chat.completions.create(
    model="GLM-4.7",
    messages=[{"role": "user", "content": "Say hello in Urdu and explain what you said."}],
    temperature=0.7,
)

print(resp.choices[0].message.content)
Il modello risponde in urdu e fornisce una spiegazione chiara di ogni parola, dimostrando sia comprensione multilingue sia capacità di ragionamento.
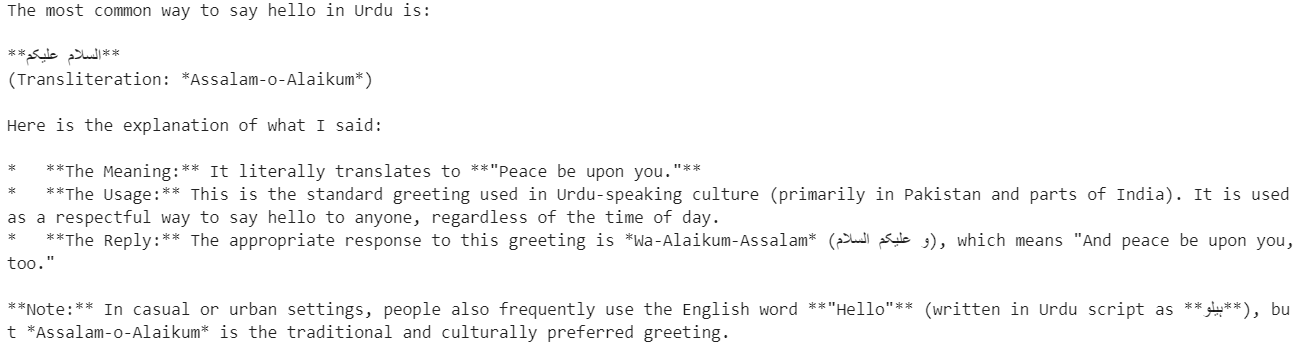
Successivamente, testa l’inferenza in streaming, fondamentale per applicazioni in tempo reale come le interfacce chat.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required",
)

stream = client.chat.completions.create(
    model="GLM-4.7",
    messages=[
        {
            "role": "user",
            "content": "What makes ChatGPT so successful and popular, given that it's "just" a chatbot?"
        }
    ],
    temperature=0.7,
    stream=True,
)

for event in stream:
    choice = event.choices[0]
    if getattr(choice, "delta", None) and getattr(choice.delta, "content", None):
        text = choice.delta.content
        print(text, end="", flush=True)
        full_text.append(text)
La risposta scorre fluida, token dopo token, confermando che lo streaming di llama.cpp funziona in modo affidabile con GLM-4.7. La risposta generata è coerente, ben strutturata e accurata, rendendo questa configurazione adatta a carichi di lavoro in stile produzione.
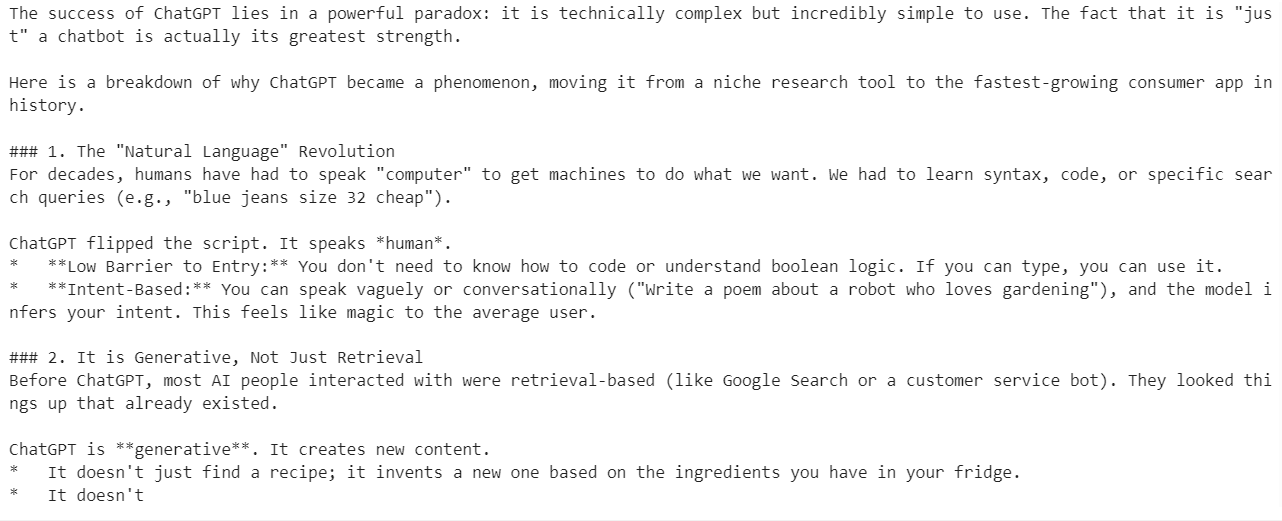
A questo punto, GLM-4.7 è pienamente operativo sia tramite la web UI sia tramite l’API compatibile con OpenAI, funzionando in modo efficiente su una singola GPU H100 con impostazioni ottimizzate.
Negli ultimi mesi, llama.cpp è maturato rapidamente, fino al punto da poter sostituire completamente strumenti come Ollama e altre app di chat locali per l’esecuzione di grandi modelli linguistici.
Offre un motore di inferenza altamente configurabile e veloce, una CLI da terminale per l’uso interattivo e una web UI integrata che ricorda da vicino l’esperienza di ChatGPT.
Ottieni anche un controllo granulare sul comportamento del modello tramite flag runtime e impostazioni della UI, così da regolare prestazioni e qualità in base al tuo hardware.
Un punto importante è che non ti servono hardware enterprise per eseguire GLM-4.7. Con sufficiente RAM di sistema e una GPU come una RTX 3090, il modello GLM-4.7 a 2 bit può girare in locale usando --fit on e applicando le giuste ottimizzazioni di llama.cpp.
L’ecosistema di llama.cpp ha una community ampia e attiva, che rende facile trovare configurazioni ottimizzate e supporto quando si fa tuning per GPU o carichi specifici.
In questo tutorial abbiamo configurato l’ambiente RunPod, compilato llama.cpp con supporto CUDA, scaricato il modello GLM-4.7 con trasferimenti Hugging Face ad alta velocità ed eseguito il modello in modalità interattiva. Abbiamo poi avviato un server di inferenza ottimizzato, lo abbiamo testato tramite la web UI e lo abbiamo convalidato programmaticamente usando l’API compatibile con OpenAI.
Il risultato è un deploy GLM-4.7 completamente locale e ad alte prestazioni che offre ottima accuratezza e inferenza quasi in tempo reale su una singola GPU. Questa configurazione è adatta a sperimentazione, ricerca e persino carichi di lavoro in stile produzione, dove contano controllo, prestazioni e trasparenza.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



