
Kursus
Membangun Sistem Agenik yang Dapat Diskalakan
1 jam 30 menit
21.8K
GLM 4.7 Flash adalah model bahasa besar open-weight yang baru dirilis dan mendapat banyak perhatian karena dapat dijalankan secara lokal namun tetap memberikan performa kuat untuk coding, penalaran, dan alur kerja bergaya agen.
Berbeda dengan banyak model modern yang bergantung pada API berbayar atau infrastruktur cloud, GLM 4.7 Flash dapat dijalankan sepenuhnya pada perangkat keras lokal menggunakan kerangka inferensi ringan. Ini menjadikannya opsi menarik bagi pengembang yang menginginkan kendali penuh atas model, penggunaan offline, biaya yang dapat diprediksi, dan iterasi cepat selama pengembangan.
Dengan penyiapan dan kuantisasi yang tepat, model ini dapat mencapai kecepatan generasi token yang tinggi pada GPU konsumen sambil mempertahankan kualitas penalaran yang berguna.
Dalam tutorial ini, saya akan memandu Anda menyiapkan lingkungan sistem yang diperlukan untuk menjalankan GLM 4.7 Flash secara lokal menggunakan llama.cpp. Fokusnya adalah menjaga penyiapan tetap sederhana, bersih, dan dapat direproduksi. Kita akan mengunduh model, membangun dan mengonfigurasi llama.cpp, lalu menguji model menggunakan aplikasi web dan server inferensi berbasis API.
Di bagian akhir tutorial, kita akan mengintegrasikan server llama.cpp lokal dengan agen coding AI, sehingga memungkinkan alur kerja pembuatan, eksekusi, dan pengujian kode secara otomatis. Anda juga dapat melihat panduan kami tentang cara menjalankan GLM-4.7 secara lokal.
Sebelum menjalankan GLM 4.7 Flash secara lokal, pastikan sistem Anda memenuhi persyaratan berikut.
Untuk presisi penuh atau kuantisasi bit lebih tinggi:
Untuk model terkuantisasi 4-bit
Kuantisasi Q4_K_XL secara signifikan mengurangi penggunaan memori sambil mempertahankan performa penalaran dan coding yang kuat, sehingga cocok untuk GPU seperti RTX 3090, RTX 4080, dan RTX 4090. Varian ini ideal bagi pengguna yang menginginkan throughput token tinggi tanpa menjalankan bobot presisi penuh.
Sebelum membangun llama.cpp dan menjalankan GLM 4.7 Flash, pertama pastikan GPU NVIDIA dan driver Anda terpasang dengan benar. Ini memastikan CUDA tersedia dan sistem dapat menjalankan inferensi yang dipercepat GPU.
nvidia-smiOutput menampilkan RTX 3090 dengan versi CUDA 12.8 dan memori GPU 24GB tersedia, yang cukup untuk menjalankan GLM 4.7 Flash dan variannya yang terkuantisasi.
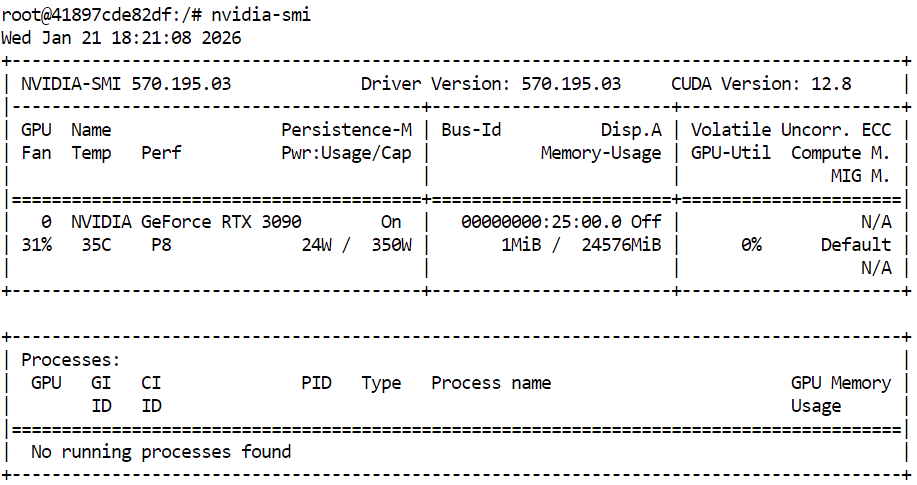
Selanjutnya, buka terminal dan tentukan ruang kerja serta struktur direktori yang bersih. Ini menjaga kode sumber, file model, dan data cache tetap terorganisasi, membantu menghindari masalah izin, dan memudahkan replikasi penyiapan.
export WORKDIR="/workspace"
export LLAMA_DIR="$WORKDIR/llama.cpp"
export MODEL_DIR="$WORKDIR/models/unsloth/GLM-4.7-Flash-GGUF"
Buat direktori tempat file model akan disimpan, dan konfigurasikan lokasi cache Hugging Face di dalam workspace alih-alih direktori home. Ini meningkatkan performa unduhan dan menghindari peringatan yang tidak perlu.
mkdir -p "$MODEL_DIR"
export HF_HOME="$WORKDIR/.cache/huggingface"
export HUGGINGFACE_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
export HF_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
Atur variabel lingkungan tambahan untuk menekan peringatan symlink dan mengaktifkan unduhan berperforma tinggi.
export HF_HUB_DISABLE_SYMLINKS_WARNING=1
export HF_XET_HIGH_PERFORMANCE=1
Terakhir, instal dependensi sistem yang diperlukan untuk membangun llama.cpp dan mengelola unduhan.
sudo apt-get update
sudo apt-get install -y \
  build-essential cmake git curl libcurl4-openssl-dev
Pada tahap ini, lingkungan sistem sudah siap. Bagian berikutnya akan berfokus pada mengklon dan membangun llama.cpp dengan dukungan CUDA diaktifkan.
Dengan lingkungan yang sudah disiapkan, langkah berikutnya adalah memasang llama.cpp dan membangunnya dengan dukungan CUDA diaktifkan. Ini memungkinkan GLM 4.7 Flash berjalan efisien di GPU.
Di terminal, arahkan ke workspace Anda. Lalu jalankan perintah berikut untuk mengklon repositori resmi llama.cpp.
git clone https://github.com/ggml-org/llama.cpp "$LLAMA_DIR"Setelah repositori diklon, file sumber akan diunduh ke direktori workspace.
Cloning into '/workspace/llama.cpp'...
remote: Enumerating objects: 76714, done.
remote: Counting objects: 100% (238/238), done.
remote: Compressing objects: 100% (157/157), done.
remote: Total 76714 (delta 172), reused 81 (delta 81), pack-reused 76476 (from 3)
Receiving objects: 100% (76714/76714), 282.23 MiB | 13.11 MiB/s, done.
Resolving deltas: 100% (55422/55422), done.
Updating files: 100% (2145/2145), done.
Selanjutnya, konfigurasikan build menggunakan CMake dan secara eksplisit aktifkan dukungan CUDA. Langkah ini menyiapkan sistem build untuk mengompilasi biner yang dipercepat GPU.
cmake "$LLAMA_DIR" -B "$LLAMA_DIR/build" \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON
Setelah konfigurasi selesai, bangun biner llama.cpp yang diperlukan. Perintah ini mengompilasi alat inferensi inti, termasuk antarmuka baris perintah dan server inferensi.
cmake --build "$LLAMA_DIR/build" --config Release -j --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
Setelah build selesai, salin biner yang telah dikompilasi ke direktori utama llama.cpp agar lebih mudah diakses.
cp "$LLAMA_DIR/build/bin/llama-"* "$LLAMA_DIR/"Terakhir, verifikasi bahwa llama.cpp berhasil dibangun dan CUDA terdeteksi dengan menjalankan perintah bantuan server inferensi.
"$LLAMA_DIR/llama-server" --help >/dev/null && echo "✔ llama.cpp built"Jika dukungan CUDA diaktifkan dengan benar, output akan mengonfirmasi bahwa perangkat CUDA terdeteksi, termasuk model GPU dan compute capability.
ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA GeForce RTX 3090, compute capability 8.6, VMM: yes
✔ llama.cpp builtDengan llama.cpp yang sudah dibangun dan dukungan CUDA terverifikasi, langkah selanjutnya adalah mengunduh model GLM 4.7 Flash. Dalam tutorial ini, kita menggunakan Hugging Face Hub dengan dukungan Xet untuk memungkinkan unduhan file model berukuran besar secara cepat dan andal.
Di terminal yang sama, ketik perintah berikut untuk memasang paket Python yang diperlukan untuk unduhan model berperforma tinggi.
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
Selanjutnya, jalankan skrip Python berikut di terminal untuk mengunduh varian model terkuantisasi 4-bit. Skrip ini menggunakan path workspace yang didefinisikan sebelumnya dan hanya mengunduh file GGUF yang diperlukan.
python - <<'PY'
import os
from huggingface_hub import snapshot_download

model_dir = os.environ["MODEL_DIR"]

snapshot_download(
    repo_id="unsloth/GLM-4.7-Flash-GGUF",
    local_dir=model_dir,
    allow_patterns=["*UD-Q4_K_XL*"],
)

print("✔ Download complete:", model_dir)
PY
Setelah unduhan selesai, Anda akan melihat output yang mengonfirmasi bahwa file model berhasil diambil, dengan total ukuran sekitar 17,5 GB.
Fetching 1 files: 100%|███████████████████████████████████████████████████████████████████████████████████| 1/1 [00:52<00:00, 52.80s/it]
Download complete: 100%|████████████████████████████████████████████████████████████████████████████| 17.5G/17.5G [00:52<00:00, 480MB/s]✔ Download complete: /workspace/models/unsloth/GLM-4.7-Flash-GGUF
Terakhir, verifikasi bahwa file model ada di direktori target.
ls -lh "$MODEL_DIR"Anda akan melihat file GLM-4.7-Flash-UD-Q4_K_XL.gguf terdaftar, mengonfirmasi bahwa model siap untuk inferensi.
total 17G
-rw-rw-rw- 1 root root 17G Jan 21 18:46 GLM-4.7-Flash-UD-Q4_K_XL.ggufDengan model yang telah diunduh dan llama.cpp dibangun dengan dukungan CUDA, langkah selanjutnya adalah meluncurkan server inferensi. Ini akan mengekspos GLM 4.7 Flash sebagai API lokal yang dapat digunakan oleh antarmuka pengguna, skrip, dan agen coding AI.
Harap gunakan sesi terminal dan workspace yang sama seperti yang Anda konfigurasi di bagian sebelumnya.
Pertama, temukan file model GGUF yang diunduh dan simpan path-nya dalam variabel lingkungan.
export MODEL_FILE="$(ls "$MODEL_DIR"/*.gguf | grep -i UD-Q4_K_XL | head -n 1)"Selanjutnya, mulai server inferensi llama.cpp menggunakan perintah berikut. Konfigurasi ini dioptimalkan untuk RTX 3090 dan menyeimbangkan throughput, latensi, dan panjang konteks.
$LLAMA_DIR/llama-server \
  --model "$MODEL_FILE" \
  --alias "GLM-4.7-Flash" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 16384 \
  --temp 0.7 \
  --top-p 1 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
--ubatch-size 256--model memuat file model GGUF GLM 4.7 Flash yang dipilih untuk inferensi.--alias menetapkan nama model yang mudah dibaca yang muncul di respons API dan log.--threads menggunakan 32 thread CPU untuk mendukung tokenisasi, penjadwalan, dan penanganan permintaan pada sistem dengan banyak inti.--host mengikat server ke semua antarmuka jaringan sehingga dapat diakses secara lokal atau dari mesin lain di jaringan.--ctx-size menetapkan jendela konteks besar yang menyeimbangkan dukungan prompt panjang dengan penggunaan memori GPU.--temp menerapkan tingkat kebetulan sedang untuk meningkatkan kualitas respons tanpa mengorbankan stabilitas penalaran.--top-p menonaktifkan penyaringan nucleus agar seluruh distribusi token dipertimbangkan saat generasi.--port 8080 mengekspos server inferensi pada port pengembangan lokal standar.--fit mengaktifkan penyesuaian memori otomatis untuk memaksimalkan pemanfaatan GPU tanpa melebihi batas VRAM.--prio menetapkan tingkat prioritas seimbang untuk beban kerja inferensi di bawah permintaan bersamaan.--jinja mengaktifkan dukungan templating Jinja untuk prompt terstruktur dan alur kerja bergaya agen.--flash-attn secara otomatis mengaktifkan Flash Attention saat didukung oleh GPU untuk meningkatkan throughput.--batch-size memungkinkan pemrosesan batch besar untuk meningkatkan throughput token pada RTX 3090.--ubatch-size membagi batch besar menjadi micro-batch yang lebih kecil untuk mengendalikan tekanan memori dan latensi.Setelah server berjalan, ia akan memuat model ke memori GPU dan mulai mendengarkan permintaan pada port 8080. Pada titik ini, GLM 4.7 Flash berjalan secara lokal dan dapat diakses melalui endpoint HTTP untuk chat, completion, dan alur kerja berbasis agen.
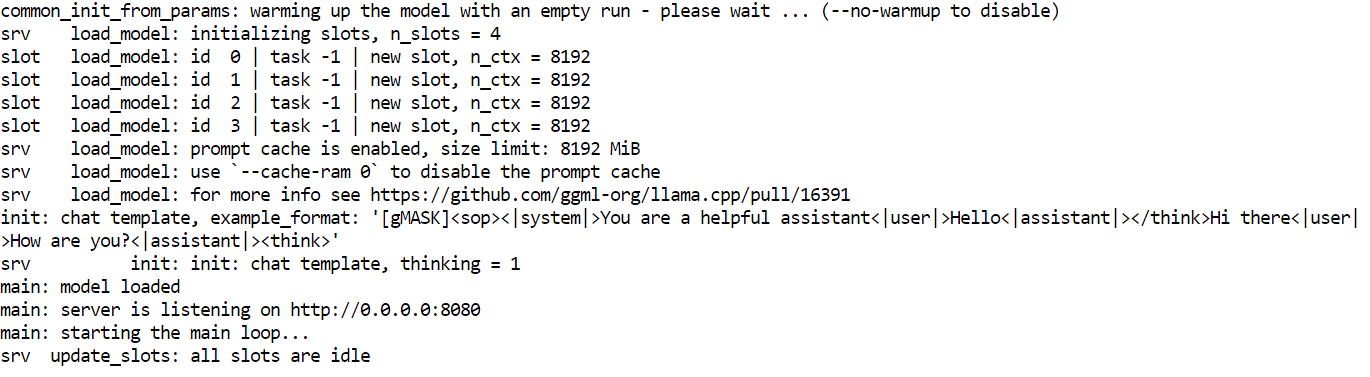
Dengan server inferensi berjalan, kini Anda dapat menguji GLM 4.7 Flash menggunakan berbagai antarmuka, termasuk web UI bawaan, permintaan HTTP langsung, dan OpenAI-compatible Python SDK.
Antarmuka web llama.cpp tersedia di: http://0.0.0.0:8080
Salin URL ini dan buka di peramban web Anda untuk mengakses antarmuka chat sederhana yang mirip ChatGPT.
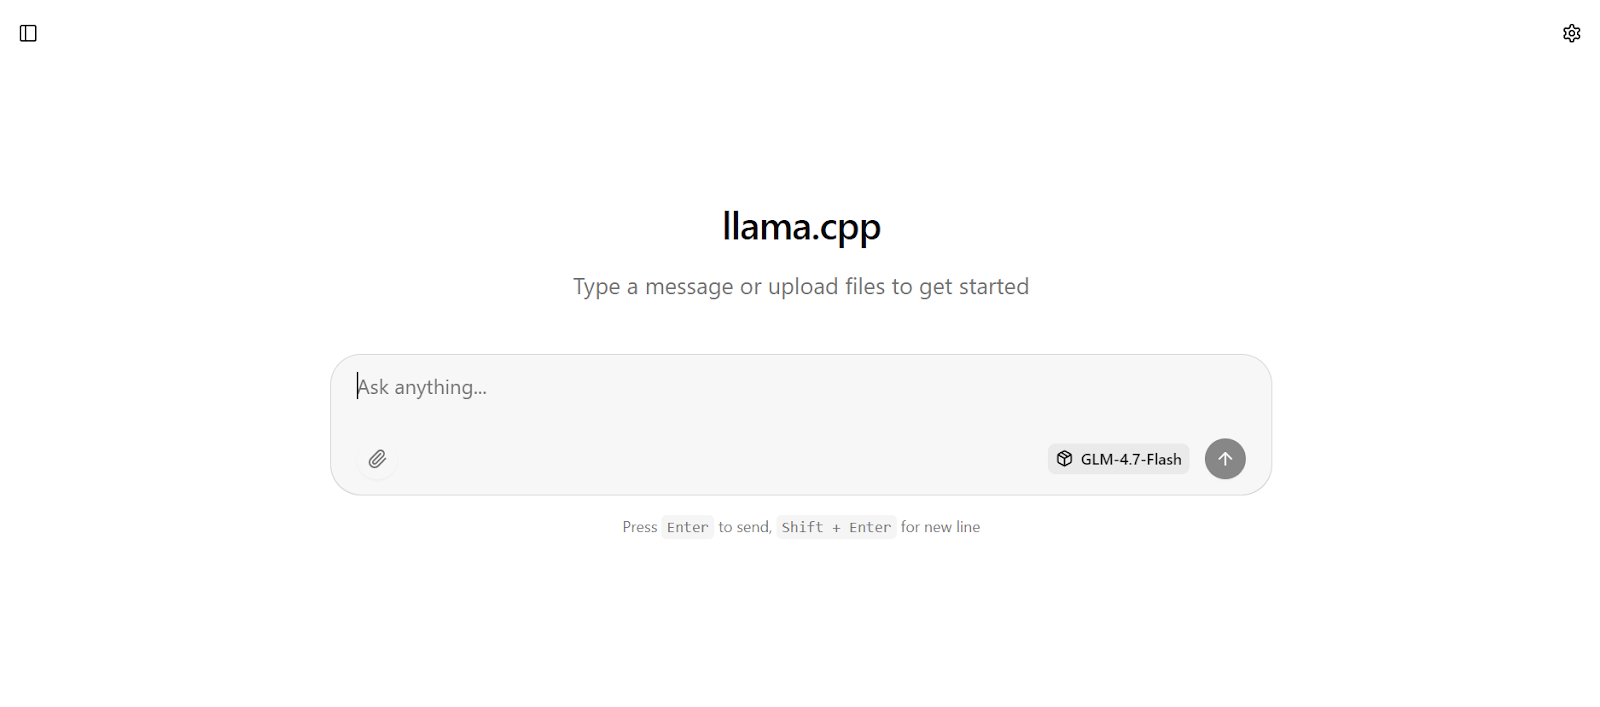
Masukkan prompt, dan model akan segera mulai menghasilkan respons.
Penyiapan ini dioptimalkan untuk kecepatan dengan menjalankan model pada RTX 3090 dengan CUDA diaktifkan, menggunakan Flash Attention bila tersedia, dan pengaturan batching yang disetel untuk throughput tinggi.
Dalam praktiknya, konfigurasi ini dapat mencapai sekitar 100 token per detik untuk respons pendek hingga menengah.
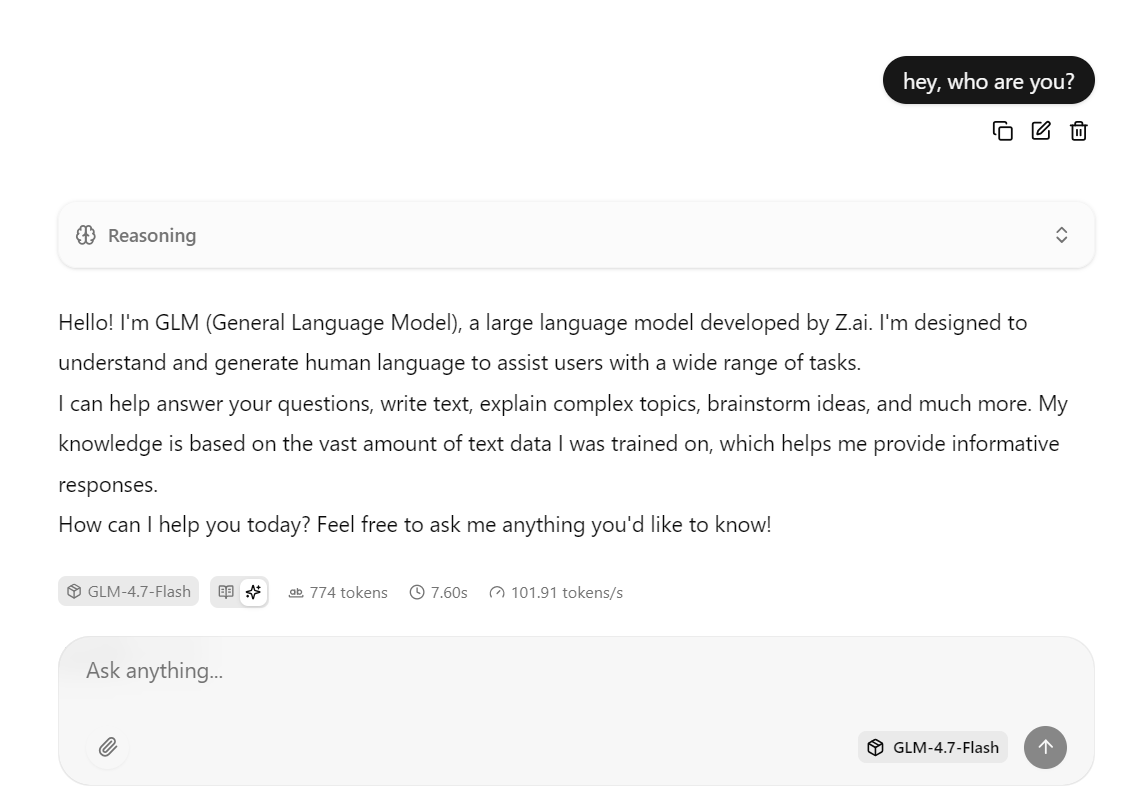
Anda juga dapat berinteraksi dengan server yang sama menggunakan perintah curl. Buka jendela terminal baru dan jalankan permintaan berikut untuk mengirim prompt chat completion.
curl -N http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer local" \
  -d '{
    "model": "GLM-4.7-Flash",
    "messages": [
      { "role": "user", "content": "Write a short bash script that prints numbers 1 to 5." }
    ]
  }'
Anda juga dapat menguji model menggunakan Python dengan memasang OpenAI Python SDK.
pip -q install openaiDalam contoh Python ini, klien OpenAI dikonfigurasi untuk mengirim permintaan ke server inferensi llama.cpp yang berjalan secara lokal.
Parameter base_url menunjuk ke endpoint API lokal, dan kolom API key wajib oleh SDK namun dapat diisi nilai placeholder apa pun karena autentikasi ditangani secara lokal.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local"
)
Klien kemudian mengirim permintaan chat completion ke GLM 4.7 Flash menggunakan alias model yang ditetapkan saat server inferensi diluncurkan. Prompt disediakan dalam format chat standar, dan respons dikembalikan sebagai objek terstruktur.
r = client.chat.completions.create(
    model="GLM-4.7-Flash",
    messages=[{"role": "user", "content": "Build me a Simple API server using FastAPI"}]
)

print(r.choices[0].message.content)
Dalam beberapa detik, model akan mengembalikan respons lengkap, termasuk contoh kode dan penjelasan.
OpenCode adalah agen coding AI sumber terbuka yang dirancang untuk berjalan secara lokal sambil mendukung alur kerja agentic seperti pembuatan kode, pengeditan file, eksekusi perintah, dan pemecahan masalah iteratif.
Berbeda dengan asisten coding berbasis cloud, OpenCode dapat dihubungkan ke server inferensi yang di-host sendiri, sehingga Anda dapat membangun setelan coding AI yang sepenuhnya lokal dan gratis.
Dalam tutorial ini, OpenCode dikonfigurasi untuk menggunakan server llama.cpp lokal yang menjalankan GLM 4.7 Flash melalui API yang kompatibel dengan OpenAI.
Untuk memulai, gunakan sesi terminal yang sama dan pasang OpenCode menggunakan skrip instalasi resmi.
curl -fsSL https://opencode.ai/install | bash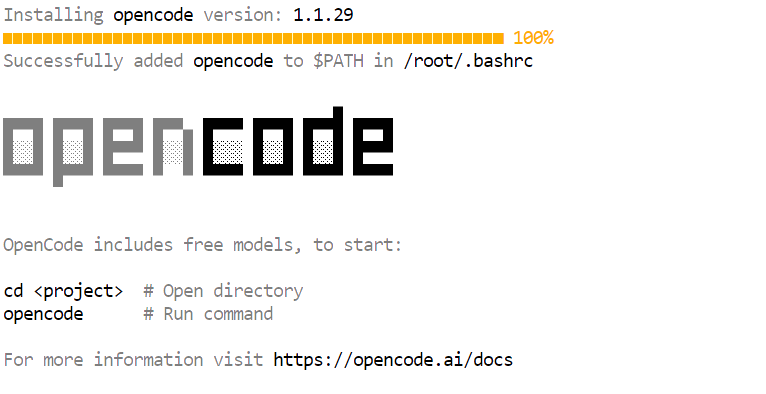 Setelah instalasi, perbarui PATH Anda agar perintah opencode tersedia di terminal.
export PATH="$HOME/.local/bin:$PATH"Buka jendela terminal baru dan verifikasi bahwa OpenCode terpasang dengan benar.
opencode --versionAnda akan melihat nomor versi yang serupa dengan berikut ini.
1.1.29Berikutnya, buat direktori konfigurasi OpenCode. Lalu, buat file konfigurasi OpenCode dan tetapkan llama.cpp sebagai penyedia. Konfigurasi ini memberi tahu OpenCode untuk mengirim semua permintaan ke server inferensi yang berjalan secara lokal dan menggunakan model GLM 4.7 Flash.
mkdir -p ~/.config/opencode


cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama.cpp (local)",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1"
      },
      "models": {
        "GLM-4.7-Flash": {
          "name": "GLM-4.7-Flash (UD-Q4_K_XL)"
        }
      }
    }
  },
  "model": "GLM-4.7-Flash"
}
EOF
Terakhir, autentikasi OpenCode. Langkah ini diwajibkan oleh alat tersebut, namun karena server inferensi bersifat lokal, API key dapat berupa nilai placeholder apa pun.
opencode auth loginSaat diminta, gunakan nilai berikut.
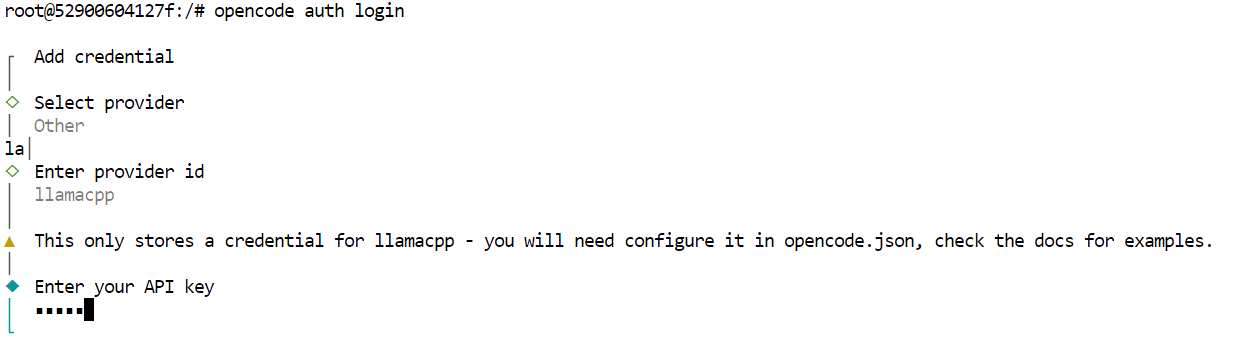
Pada titik ini, OpenCode sepenuhnya dikonfigurasi untuk menggunakan GLM 4.7 Flash melalui server llama.cpp lokal.
Dengan OpenCode terkonfigurasi dan terhubung ke server llama.cpp lokal, kini Anda dapat menggunakan GLM 4.7 Flash sebagai agen coding AI yang sepenuhnya otomatis.
Mulailah dengan membuat direktori proyek baru dan masuk ke dalamnya.
mkdir -p /workspace/project
cd /workspace/project
Selanjutnya, jalankan OpenCode dari terminal yang sama.
opencodeSetelah OpenCode mulai, tekan tombol Tab untuk beralih ke Mode Plan. Pada mode ini, jelaskan apa yang ingin Anda bangun.
Sebagai contoh, masukkan prompt yang meminta OpenCode membuat API sederhana bertenaga machine learning menggunakan FastAPI. OpenCode akan secara otomatis merencanakan proyek, menghasilkan kode, menjalankan server API, dan menguji implementasinya.
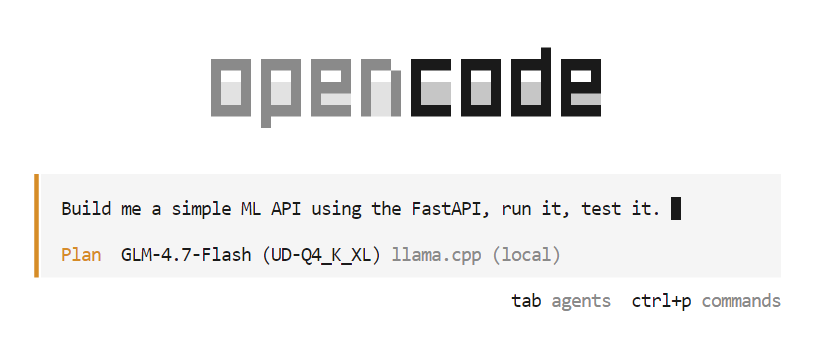
Selama fase perencanaan, OpenCode mungkin menanyakan pertanyaan lanjutan untuk memperjelas kebutuhan seperti pilihan kerangka kerja, endpoint, atau struktur proyek. Pilih opsi yang Anda inginkan dan konfirmasikan untuk melanjutkan.
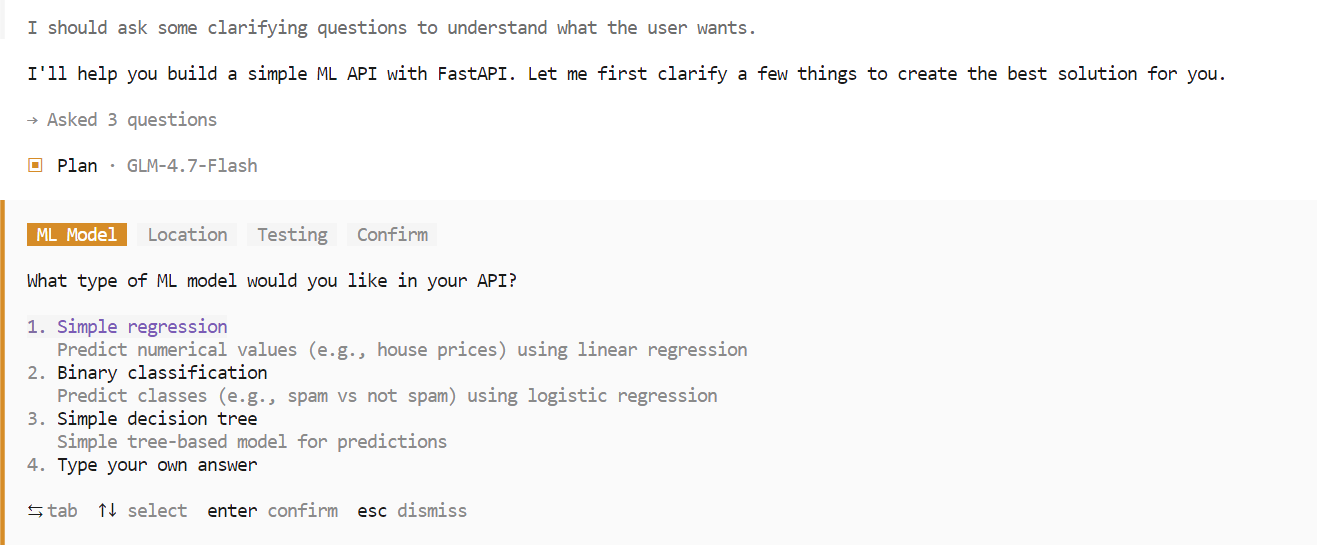
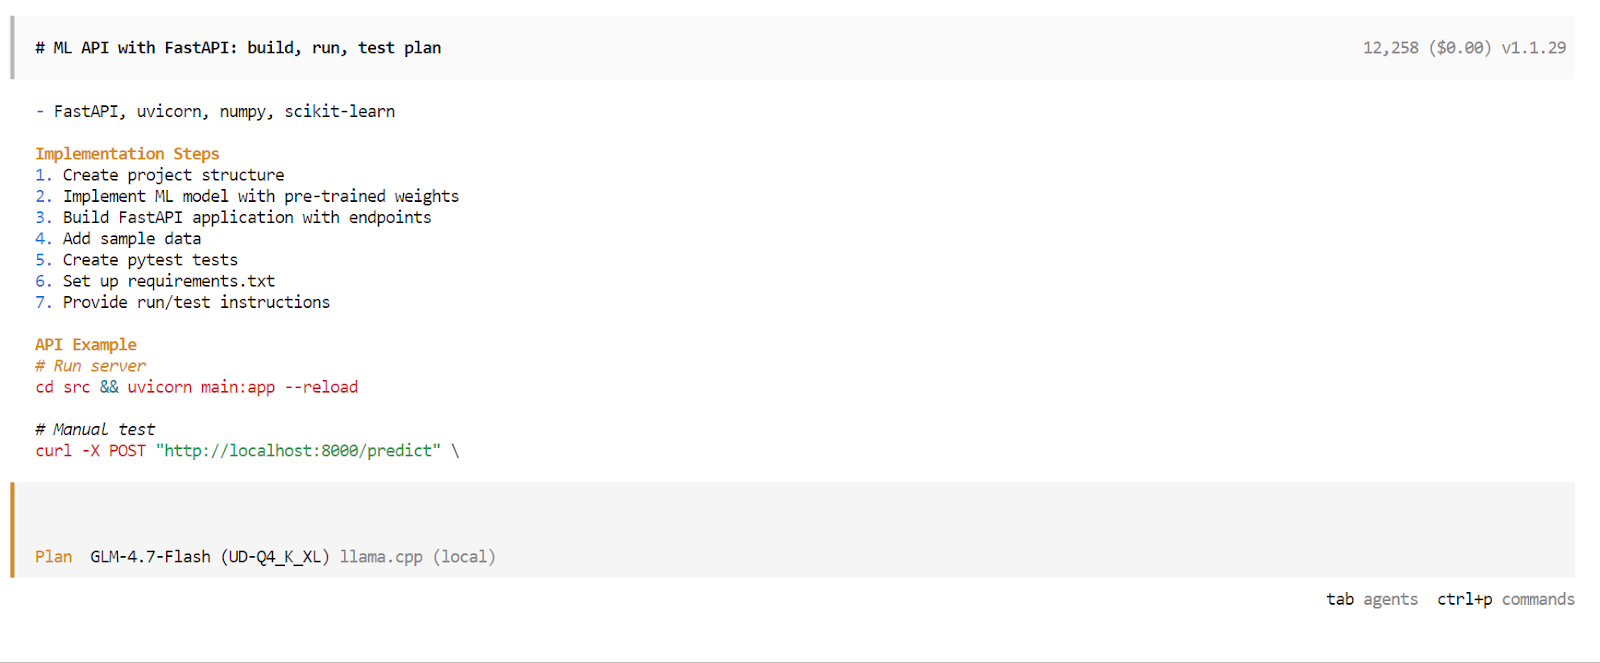
Setelah fase perencanaan selesai, OpenCode akan menyajikan rencana eksekusi terperinci. Tinjau rencana tersebut dan setujui jika sesuai dengan ekspektasi Anda. Lalu tekan Tab lagi untuk beralih dari Mode Plan ke Mode Build.
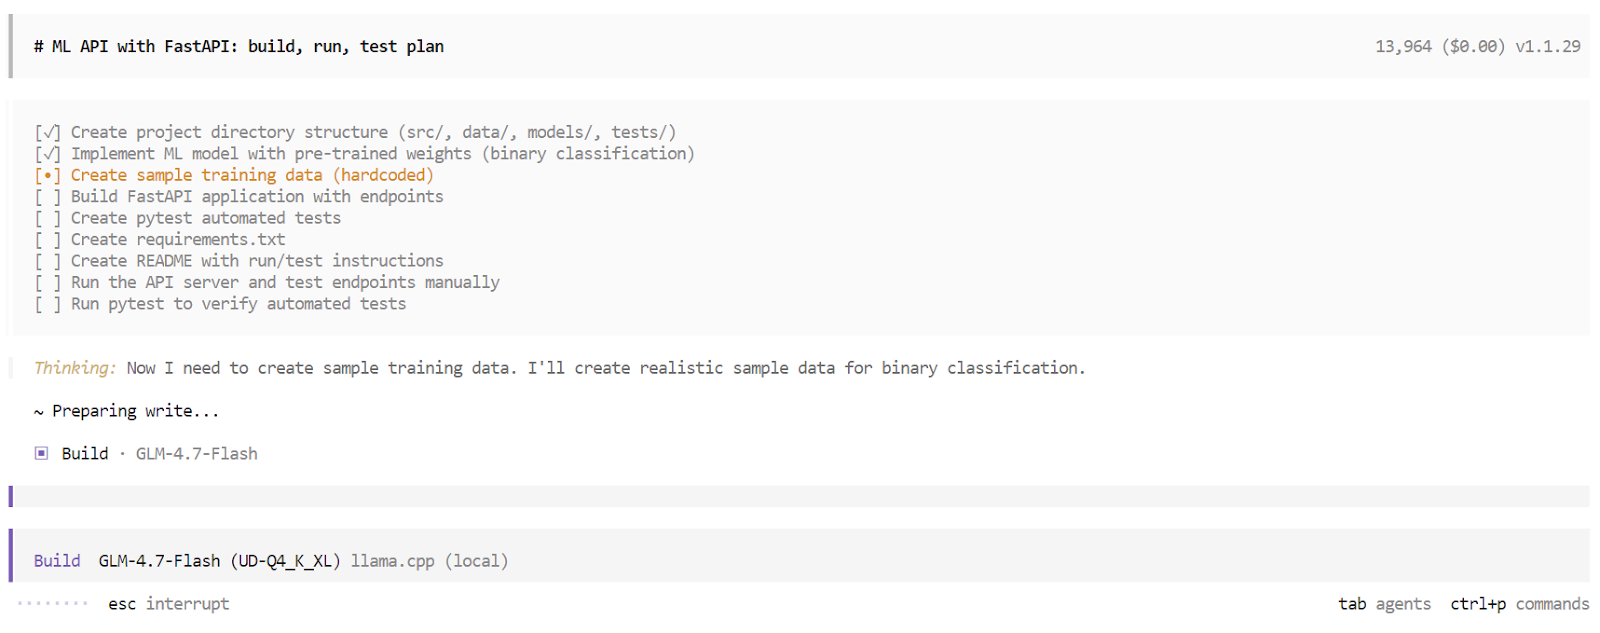
Di Mode Build, OpenCode membuat daftar tugas terstruktur dan mengeksekusi setiap langkah secara berurutan. Ini mencakup pembuatan file, penulisan kode, pemasangan dependensi, menjalankan server, dan menjalankan pengujian. Anda dapat mengamati setiap tugas diselesaikan secara waktu nyata.
Setelah proses build selesai, OpenCode menyediakan ikhtisar lengkap aplikasi. Ini mencakup petunjuk penggunaan, contoh permintaan, dan hasil pengujian otomatis. Pada titik ini, Anda memiliki aplikasi yang sepenuhnya berfungsi yang dibangun dan divalidasi oleh agen coding AI lokal yang berjalan sepenuhnya di mesin Anda.
GLM 4.7 Flash merepresentasikan langkah kuat menuju agen coding AI yang sepenuhnya lokal. Kemampuan menjalankan model penalaran yang cepat dan mumpuni sepenuhnya pada perangkat keras lokal serta mengintegrasikannya dengan alat seperti OpenCode merupakan pergeseran berarti dari alur kerja yang bergantung pada cloud.
Meski demikian, GLM 4.7 Flash masih memiliki keterbatasan. Walau berkinerja baik untuk tugas kecil hingga menengah, model ini dapat kesulitan dengan alur kerja coding yang lebih kompleks dan bertahap. Konteks dapat cepat penuh, eksekusi alat sesekali dapat gagal, dan dalam beberapa kasus, agen dapat berhenti di tengah proses, sehingga memerlukan sesi baru untuk melanjutkan.
Masalah-masalah ini wajar untuk model MoE ringan yang dioptimalkan untuk kecepatan alih-alih kedalaman penalaran maksimum.
Dari segi kapabilitas mentah, GLM 4.7 Flash tidak setara dengan model GLM 4.7 penuh, yang performanya lebih mendekati model seperti Claude 4.5 Sonnet. Trade-off-nya jelas: GLM 4.7 Flash memprioritaskan kecepatan, efisiensi, dan kegunaan lokal dibandingkan kekuatan penalaran puncak.
Menyelesaikan tutorial ini dan menyetel server inferensi merupakan pengalaman yang berharga. Menjalankan varian presisi lebih tinggi dan meningkatkan jendela konteks dapat meningkatkan keandalan coding, namun mencapai hasil terbaik memerlukan eksperimen cermat dengan parameter seperti temperature, top p, ukuran batch, dan panjang konteks. Mencapai setelan optimal adalah proses iteratif.
Secara keseluruhan, GLM 4.7 Flash adalah opsi yang praktis dan menarik bagi pengembang yang menginginkan agen coding AI yang cepat, lokal, dan gratis saat ini, dengan ruang peningkatan yang jelas seiring alat dan model terus berkembang.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




