Kursus
Banyak perusahaan modern mengandalkan semantic layer untuk menjembatani kesenjangan antara data mentah yang disimpan di data warehouse seperti Snowflake dan wawasan di dasbor atau laporan.
Semantic layer adalah sebuah abstraksi yang mendefinisikan metrik, pengukuran, dan dimensi yang konsisten untuk analitik dan pelaporan.
Dalam tutorial ini, kita akan mempelajari cara menerapkan semantic layer menggunakan dbt (data build tool), kerangka kerja transformasi dan pemodelan data yang populer. Panduan ini mencakup contoh praktis dan wawasan untuk membantu Anda menguasai konsep ini.
Apa itu Semantic Layer, dan Mengapa Penting?
Sebuah semantic layer menerjemahkan data mentah menjadi metrik dan dimensi yang konsisten serta dapat digunakan kembali, sehingga menyederhanakan analisis data. Ini adalah alat untuk menjaga keseragaman lintas tim dan alat.
Manfaat semantic layer
- Definisi data yang konsisten: Memastikan metrik bisnis seperti pendapatan, churn rate, pertumbuhan YoY, nilai pesanan rata-rata, dll., didefinisikan secara seragam. Ini menghilangkan kebingungan akibat tim yang menggunakan definisi tidak konsisten dan membantu menjaga kepercayaan pada data di seluruh organisasi.
- Kolaborasi yang lebih baik: Memfasilitasi komunikasi dan penyelarasan yang lebih baik antara tim teknis dan nonteknis. Dengan menyediakan lapisan data terpadu, tim teknis dapat berfokus pada akurasi data sementara tim bisnis memanfaatkan metrik yang jelas dan mudah diakses untuk keputusan strategis.
- Waktu menuju insight lebih cepat: Mengurangi ambiguitas, sehingga memungkinkan pengambilan keputusan yang lebih cepat. Dengan semantic layer, para pemangku kepentingan dapat dengan cepat mengakses dan menganalisis metrik yang andal, meminimalkan waktu untuk merekonsiliasi data atau menyelesaikan ketidaksesuaian.
Mengapa dbt Ideal untuk Membangun Semantic Layer
Mari kita lihat apa yang membuat dbt menjadi alat yang sempurna bagi data dan analytics engineer untuk membangun semantic layer.
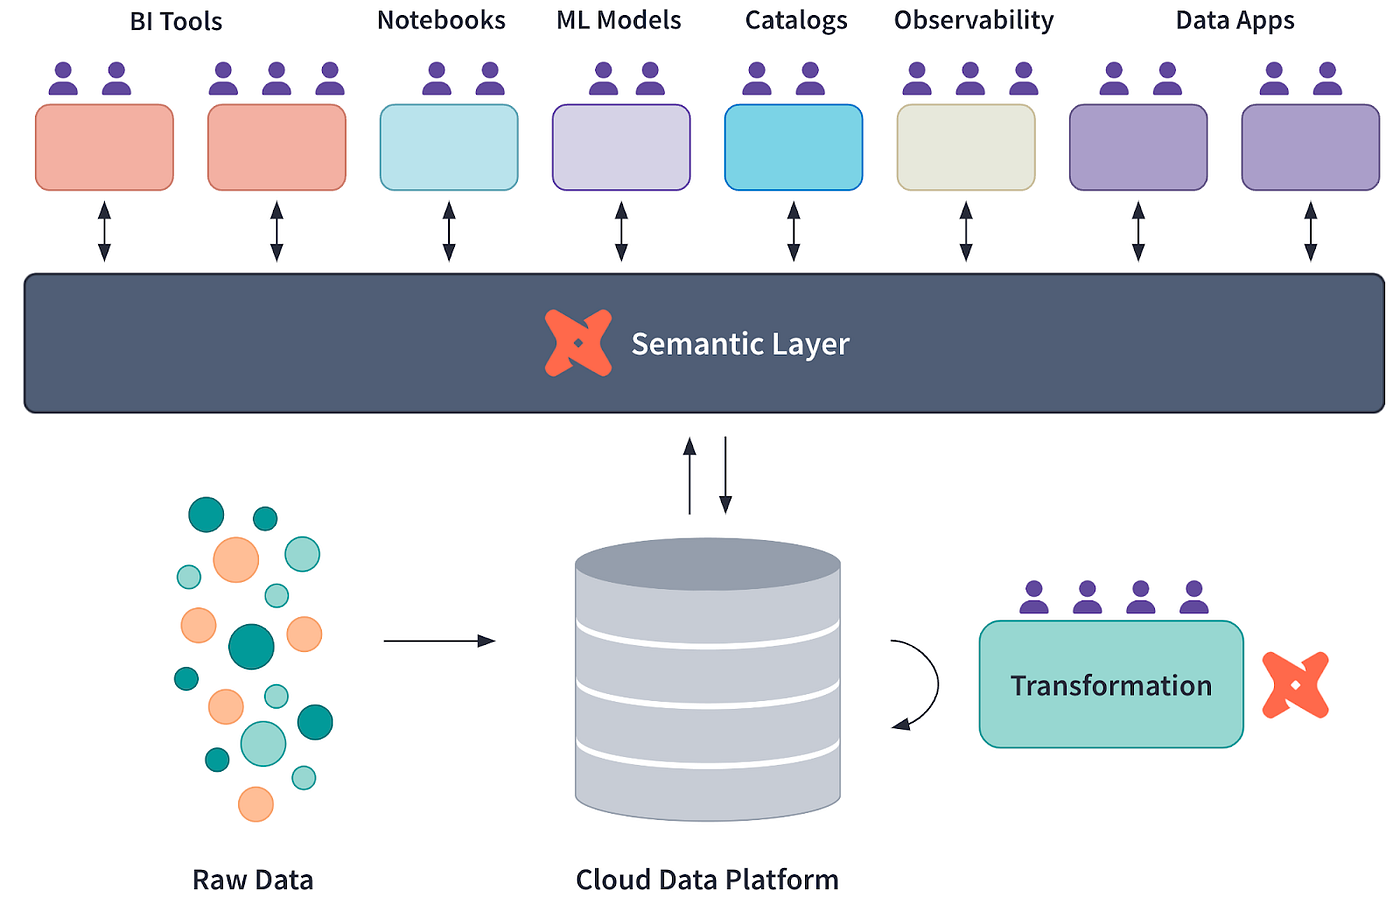
Diagram konseptual dbt Semantic Layer, dipersembahkan oleh dbt Labs
Pemodelan data modular
dbt memungkinkan Anda memecah transformasi data yang kompleks menjadi model-model modular yang dapat digunakan kembali. Model-model ini dapat disusun berlapis secara hierarkis, di mana model data dasar memasok ke model analitis tingkat lebih tinggi.
Pendekatan ini membuat pipeline mudah dipelihara dan memungkinkan tim berkolaborasi lebih efektif dengan mengisolasi perubahan pada model tertentu tanpa memengaruhi seluruh sistem.
Untuk mempelajari lebih lanjut tentang konsep dasar dbt dan praktik terbaik untuk pemodelan data, lihat Tutorial dbt: 7 Konsep Wajib untuk Data Engineer. Materi ini menawarkan wawasan yang melengkapi strategi yang diuraikan di sini.
Definisi metrik terpusat
Dengan dbt, logika bisnis dan metrik didefinisikan di satu tempat, memastikan konsistensi di berbagai alat analitik. Dengan menggunakan fitur metrics dbt, Anda dapat mendefinisikan KPI seperti pendapatan, tingkat konversi, atau churn satu kali dan menggunakannya di berbagai dasbor, laporan, dan analisis tanpa perlu didefinisikan ulang. Ini mengurangi ketidaksesuaian dan memastikan integritas data.
Version control dan dokumentasi
Integrasi dbt dengan Git memfasilitasi version control yang andal, memungkinkan Anda melacak dan mengaudit perubahan dari waktu ke waktu. Dikombinasikan dengan dokumentasi yang dihasilkan otomatis, dbt menciptakan referensi hidup yang mudah diakses untuk semua transformasi dan metrik data. Hasilnya adalah transparansi dan memungkinkan anggota tim baru onboarding lebih cepat dengan mengeksplorasi pipeline data yang terdokumentasi.
Integrasi dengan alat BI
dbt bekerja dengan platform BI seperti Looker, Tableau, dan Mode, memungkinkan integrasi semantic layer ke alat visualisasi. Dengan menggunakan exposures dbt, Anda dapat menautkan model dbt langsung ke dasbor BI, memastikan pembaruan apa pun pada model data tercermin dalam analitik tanpa intervensi manual.
Menyiapkan Proyek dbt Anda
Biasanya, dbt berada di atas cloud data warehouse seperti Snowflake atau Google BigQuery. Namun, demi kesederhanaan tutorial ini, kita akan terhubung ke database DuckDB secara lokal.
1. Prasyarat
- Instal Python pada komputer Anda jika belum terpasang.
2. Menginstal alat yang diperlukan
Gunakan pip untuk memasang dbt CLI:
pip install dbt-core
Instal DuckDB melalui pip:
pip install duckdb
Instal adapter DuckDB melalui pip:
pip install dbt-duckdb
3. Inisialisasi proyek dbt
Buat proyek dbt baru:
dbt init project_name
Perintah ini akan membuat proyek di direktori saat ini, dengan struktur seperti berikut:
project_name/
├── analyses/
├── logs/
├── macros/
├── models/
├── seeds/
├── snapshots/
├── tests/
├── .gitignore
├── dbt_project.yml
4. Menyiapkan koneksi DuckDB
Edit file profiles.yml, biasanya berada di folder ~/.dbt/. Jika belum ada, buatlah:
project_name: # This matches the name in dbt_project.yml file
target: dev
outputs:
dev:
type: duckdb
path: path/to/demo_database.duckdb
threads: 1
File profiles.yml berisi pointer ke lokasi file database .duckdb, yang harus Anda tentukan pada path.
Anda dapat membuat database baru atau mengunduh contoh kecil dari sini. Pada bagian berikutnya, saya akan menggunakan file duckdb-demo.duckdb dari sumber yang sama.
Untuk membuat file database duckDB baru, cukup jalankan berikut ini:
import duckdb
duckdb.connect('/path/to/your/duckdb/database.duckdb')
5. Menguji koneksi
Sekarang, kita dapat menguji dengan menjalankan dbt debug untuk memeriksa apakah semuanya berfungsi. Pastikan Anda berada di folder proyek sebelum menjalankan perintah:
cd /path/to/your/project/
dbt debug
Jika semuanya sudah disiapkan dengan benar, Anda akan mendapatkan output seperti ini (semua path disamarkan untuk alasan privasi):
15:20:00 Running with dbt=1.9.1
15:20:00 dbt version: 1.9.1
15:20:00 python version: 3.11.5
15:20:00 python path: ...
15:20:00 os info: Windows-10-10.0.22631-SP0
15:20:00 Using profiles dir at ....
15:20:00 Using profiles.yml file at ...
15:20:00 Using dbt_project.yml file at ...
15:20:00 adapter type: duckdb
15:20:00 adapter version: 1.9.1
15:20:00 Configuration:
15:20:00 profiles.yml file [OK found and valid]
15:20:00 dbt_project.yml file [OK found and valid]
15:20:00 Required dependencies:
15:20:00 - git [OK found]
15:20:00 Connection:
15:20:00 database: demo_database
15:20:00 schema: main
15:20:00 path: ...
15:20:00 config_options: None
15:20:00 extensions: None
15:20:00 settings: {}
15:20:00 external_root: .
15:20:00 use_credential_provider: None
15:20:00 attach: None
15:20:00 filesystems: None
15:20:00 remote: None
15:20:00 plugins: None
15:20:00 disable_transactions: False
15:20:00 Registered adapter: duckdb=1.9.1
15:20:01 Connection test: [OK connection ok]
Membuat Semantic Layer dengan dbt
Selamat telah sampai sejauh ini! Anda telah berhasil menyiapkan proyek dbt pertama Anda.
Sekarang, mari kita lihat cara membuat semantic layer di atas sebuah database. Untuk itu, Anda dapat mengimpor data Anda sendiri dari CSV ke DuckDB atau mengunduh file database contoh kecil (5MB) dari sini.
Lalu, kita dapat menulis skrip Python sederhana untuk mengeksplorasi isi file database ini:
import duckdb
# Connect to the database
conn = duckdb.connect("duckdb-demo.duckdb")
# Get list of tables
tables = conn.execute(
"SELECT table_name FROM information_schema.tables WHERE table_schema='main'"
).fetchall()
print(f"\nNumber of tables in database: {len(tables)}")
print("Table names:")
for t in tables:
print(f"- {t[0]}")
print("\nTables in database:")
for table in tables:
print(f"- {table[0]}")
# Get schema for each table
schema = conn.execute(f"DESCRIBE {table[0]}").fetchall()
print("\nSchema:")
for col in schema:
print(f" {col[0]}: {col[1]}")
# Preview data
data = conn.execute(f"SELECT * FROM {table[0]} LIMIT 5").fetchall()
print("\nFirst 5 rows:")
for row in data:
print(f" {row}")
print("\n---")
# Close connection
conn.close()
Output (dipangkas demi kejelasan):
Number of tables in database: 17
Table names:
- bank_failures
- boxplot
- calendar
- ...
Tables in database:
- bank_failures
Schema:
c1: BIGINT
Bank: VARCHAR
City: VARCHAR
State: VARCHAR
Date: DATE
Acquired by: VARCHAR
Assets ($mil.): DOUBLE
First 5 rows:
(1, 'Douglass National Bank', 'Kansas City', 'Missouri', datetime.date(2008, 1, 25), 'Liberty Bank and Trust', 58.5)
(2, 'Hume Bank', 'Hume', 'Missouri', datetime.date(2008, 3, 7), 'Security Bank', 18.7)
...
…
Database ini memiliki 17 tabel. Namun, kita hanya akan menggunakan tabel bank_failures untuk tutorial ini. Tabel ini berisi detail keuangan historis dari bank-bank yang gagal di AS.
1. Mendefinisikan model SQL
Model SQL adalah fondasi dari setiap proyek dbt. Model merepresentasikan transformasi terstruktur dari data mentah menjadi format yang lebih analitis.
Untuk tutorial ini, kita akan mendefinisikan dua file SQL di bawah folder models/.
Buat file baru di folder models pada proyek Anda bernama base_bank_failures.sql:
SELECT *
FROM bank_failures
File ini secara langsung mengambil data mentah dari tabel bank_failures. Ini berfungsi sebagai model dasar yang dapat direferensikan oleh model berikutnya.
Setelah itu, buat file lain bernama clean_bank_failures.sql:
SELECT
State,
COUNT(*) AS total_failures,
SUM("Assets ($mil.)" ) AS total_assets
FROM
{{ ref('base_bank_failures') }}
GROUP BY
State
File ini dibangun di atas model base_bank_failures (menggunakan fungsi ref()) untuk mengagregasi dan membersihkan data, menyiapkannya untuk analisis. File ini merangkum total kegagalan dan aset berdasarkan negara bagian.
2. Membuat file metrics.yml
File metrics.yml mendefinisikan metrik terpusat yang dapat digunakan kembali untuk memastikan konsistensi di seluruh analisis dan dasbor.
Dalam kasus kita, file ini akan mendeskripsikan metrik seperti total_assets dan avg_assets_per_failure, sehingga tersedia untuk digunakan di alat BI dan kueri lainnya:
version: 2
models:
- name: clean_bank_failures
description: "Aggregated data about bank failures."
columns:
- name: State
tests:
- unique
- name: "Assets ($mil.)"
metrics:
- name: total_assets
label: Total Assets
type: sum
expression: "Assets ($mil.)"
description: "Total assets of failed banks, aggregated by state."
- name: avg_assets_per_failure
label: Average Assets per Failure
type: average
expression: "Assets ($mil.)"
description: "Average assets for each bank failure."
3. Membuat file exposures.yml
File exposures.yml menautkan model dbt Anda ke alat eksternal seperti Tableau atau Looker. File ini mendokumentasikan koneksi tersebut, memastikan ketertelusuran dan konsistensi.
File ini menentukan bahwa model clean_bank_failures digunakan dalam dasbor Tableau, dengan detail tentang pemilik dan dependensi:
exposures:
- name: tableau_dashboard
type: dashboard
url: https://tableau.yourcompany.com/workbook
owner:
name: Data Team
email: datateam@yourcompany.com
depends_on:
- ref('clean_bank_failures')
Membangun dan Menguji Semantic Layer
Agar berhasil memvalidasi dan membangun proyek dbt Anda, berikut beberapa perintah berguna yang dapat Anda gunakan:
1. Build model: Jalankan perintah dbt build untuk mematerialkan semua model, menerapkan pengujian, serta mengeksekusi seeds dan snapshot. Perintah ini menggabungkan fungsionalitas dbt run dan dbt test:
dbt build
2. Uji model: Jika Anda hanya ingin memvalidasi data dengan pengujian setelah build, gunakan perintah dbt test. Ini memastikan semua uji kualitas data (misalnya, keunikan dan cek not-null) diterapkan pada model Anda.
dbt test
3. Jalankan model atau pengujian tertentu: Untuk menjalankan hanya model atau pengujian tertentu, berikan namanya sebagai argumen. Misalnya, untuk menjalankan satu model:
dbt run --select clean_bank_failures
Untuk menguji kolom tertentu:
dbt test --select clean_bank_failures.State
Mengintegrasikan Semantic Layer dengan Alat BI
Untuk menghubungkan dbt ke alat BI seperti Looker atau Tableau, ikuti langkah-langkah ini untuk mengekspos semantic layer secara efektif dan memastikan alat BI dapat merujuk langsung ke model dan metrik dbt:
1. Mengaktifkan exposures di dbt
Di proyek dbt Anda, buat file exposures.yml di bawah folder models, dengan isi seperti ini:
exposures:
- name: tableau_dashboard
type: dashboard
url: https://tableau.yourcompany.com/workbook
owner:
name: Your Name
email: email@yourcompany.com
depends_on:
- ref('clean_bank_failures')
2. Menyiapkan koneksi database Anda
- Pastikan model data yang telah ditransformasi tersedia di database Anda (misalnya, Snowflake, BigQuery, DuckDB).
- Jalankan
dbt builduntuk mematerialkan model dbt ke dalam database.
3. Menghubungkan Tableau ke model dbt
- Buka Tableau Desktop dan buat koneksi baru ke database Anda.
- Pilih skema tempat model dbt disimpan.
- Seret dan jatuhkan model dbt (misalnya,
clean_bank_failures) ke ruang kerja Tableau.
4. Mendefinisikan metrik di Tableau
- Di Tableau, gunakan metrik yang didefinisikan dbt seperti
total_assetsatauavg_assets_per_failurelangsung dalam visualisasi Anda untuk memastikan konsistensi. - Buat calculated fields jika diperlukan untuk meningkatkan visualisasi.
5. Menghubungkan Looker ke model dbt
- Di Looker, buka panel admin dan atur koneksi ke database Anda.
- Buat LookML view untuk setiap model dbt dengan mengimpor skema dan field.
- Gunakan metrik
total_assetsatauavg_assets_per_failureyang didefinisikan di dbt untuk membangun Looker Explore dan dasbor yang konsisten.
Praktik Terbaik untuk Menerapkan Semantic Layer dengan dbt
Sekarang Anda memiliki gambaran langkah-langkah membangun semantic layer dengan dbt, mari tinjau beberapa praktik terbaik.
Pusatkan logika bisnis
Definisikan semua aturan bisnis di dbt untuk memastikan konsistensi dan kemudahan pemeliharaan. Dengan memusatkan logika bisnis, Anda menghilangkan definisi berulang di berbagai alat, menciptakan single source of truth yang mudah diperbarui dan dipahami semua pemangku kepentingan.
Modularisasi model
Bagi transformasi ke dalam komponen yang logis dan dapat digunakan kembali. Misalnya, buat model dasar untuk data mentah, model perantara untuk data yang dibersihkan dan ditransformasi, serta model akhir untuk data siap analitik.
Struktur modular ini menyederhanakan pemecahan masalah, mendorong penggunaan ulang kode, dan memungkinkan kolaborasi di antara anggota tim yang dapat mengerjakan komponen individual tanpa mengganggu seluruh pipeline.
Dokumentasikan semuanya
Manfaatkan dokumentasi otomatis dbt untuk menjaga semantic layer tetap terorganisasi dan transparan.
Gunakan deskripsi di file YAML untuk memberikan penjelasan yang jelas bagi model, metrik, dan kolom.
Perbarui dokumentasi secara berkala agar mencerminkan perubahan dan gunakan grafik lineage otomatis dbt untuk memvisualisasikan hubungan antarmodel. Ini memastikan semantic layer tetap dapat diakses dan mudah dinavigasi oleh semua pengguna.
Alat seperti paket dbt-utils dapat secara signifikan merampingkan workflow dbt Anda, menyediakan macro dan utilitas siap pakai yang menyederhanakan pengembangan model dan memastikan dokumentasi yang menyeluruh.
Kesimpulan
Menerapkan semantic layer dengan dbt adalah pendekatan yang kuat untuk menjembatani kesenjangan antara data mentah dan insight yang dapat ditindaklanjuti. Pemodelan data modular dbt, definisi metrik terpusat, version control yang andal, dan integrasi dengan alat BI dapat membantu Anda memastikan data yang konsisten, andal, dan mudah diakses untuk analitik dan pelaporan.
Tutorial ini telah memandu Anda menyiapkan proyek dbt, membuat model SQL, mendefinisikan metrik yang dapat digunakan kembali, dan mengintegrasikan semantic layer dengan alat visualisasi seperti Tableau dan Looker.
Untuk mempelajari lebih lanjut tentang dbt, lihat kursus Introduction to dbt yang sangat baik!

