Ga naar hoofdinhoud

Een semantische laag implementeren met dbt: een praktische gids

Leer hoe je met dbt een semantische laag bouwt en ruwe data omzet in consistente metrics voor analytics en BI-tools!
Bijgewerkt 2 okt 2026  · 8 min lezen

Verken met AI

ChatGPTClaudePerplexity

Veel moderne bedrijven vertrouwen op semantische lagen om de kloof te overbruggen tussen ruwe data in datawarehouses zoals Snowflake en inzichten in dashboards of rapporten. 

Een semantische laag is een abstractie die consistente metrics, kengetallen en dimensies definieert voor analytics en rapportage.

In deze tutorial verkennen we hoe je een semantische laag implementeert met dbt (data build tool), een populair framework voor datatransformatie en -modellering. Deze gids bevat praktische voorbeelden en inzichten om je te helpen het concept onder de knie te krijgen.

Wat is een semantische laag en waarom is die belangrijk?

Een semantische laag vertaalt ruwe data naar consistente, herbruikbare metrics en dimensies, wat data-analyse eenvoudiger maakt. Het is een hulpmiddel om uniformiteit te waarborgen tussen teams en tools.

Voordelen van een semantische laag

  • Consistente datadefinities: Zorgt ervoor dat businessmetrics zoals omzet, churn rate, YoY-groei, gemiddelde bestelwaarde, enz. uniform gedefinieerd zijn. Dit voorkomt verwarring door inconsistente definities tussen teams en helpt om vertrouwen in de data te behouden binnen de organisatie.
  • Betere samenwerking: Faciliteert betere communicatie en afstemming tussen technische en niet-technische teams. Door een uniforme datalaag te bieden, kunnen technische teams focussen op datanauwkeurigheid terwijl businessteams heldere, toegankelijke metrics gebruiken voor strategische beslissingen.
  • Snellere time-to-insight: Vermindert ambiguïteit, waardoor sneller beslissingen genomen kunnen worden. Met een semantische laag hebben stakeholders snel toegang tot betrouwbare metrics, zodat minder tijd verloren gaat aan het afstemmen van data of het oplossen van discrepanties.

Waarom dbt ideaal is voor het bouwen van een semantische laag

Laten we bekijken waarom dbt het perfecte hulpmiddel is voor data- en analytics engineers om een semantische laag te bouwen.
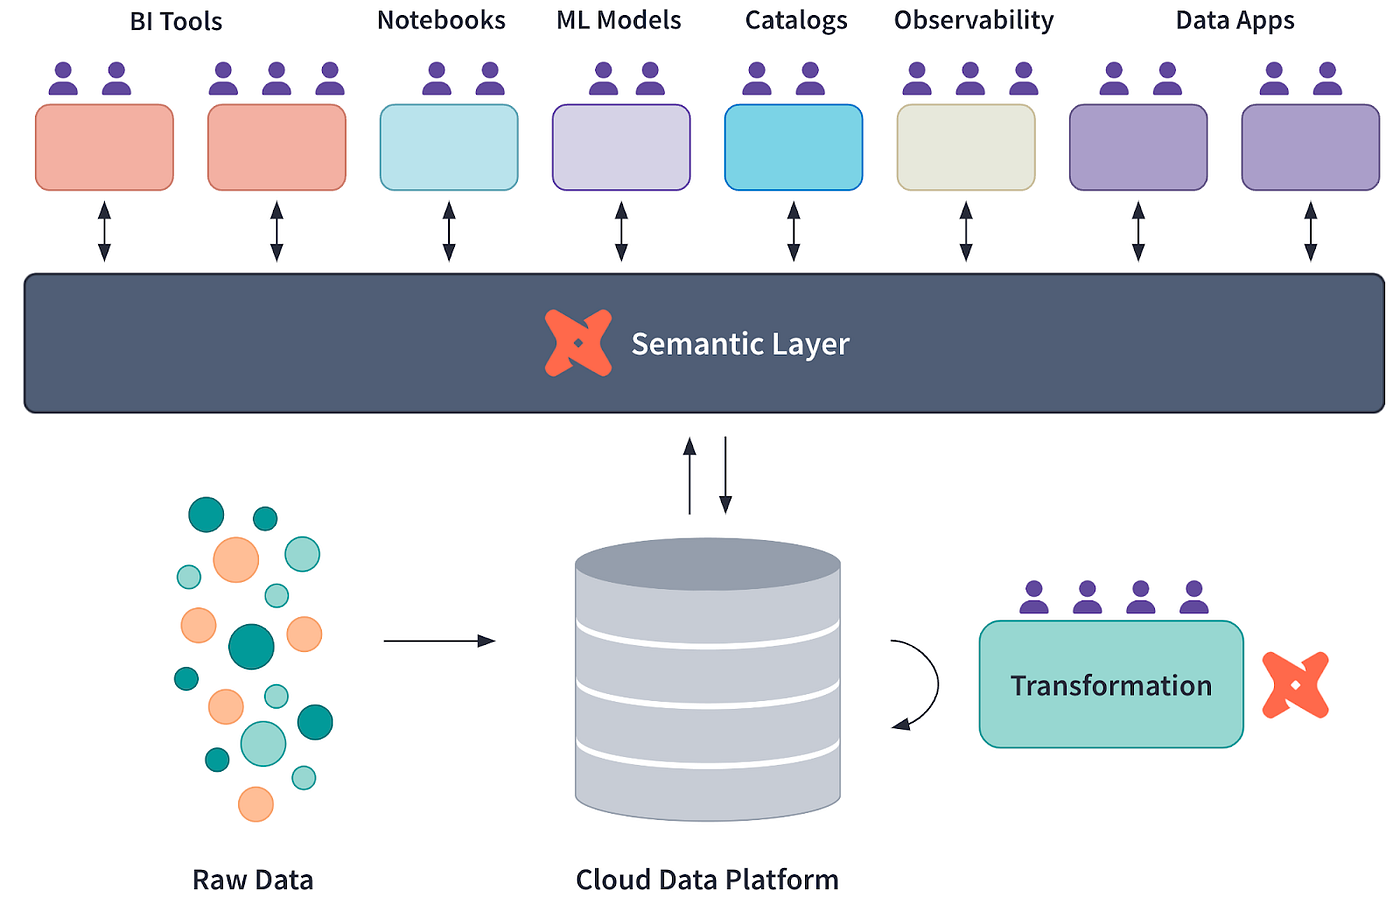
Een screenshot met de architectuur van modelleren met dbt

Conceptueel diagram van de dbt Semantic Layer, met dank aan dbt Labs

Modulair datamodelleren

Met dbt kun je complexe datatransformaties opsplitsen in herbruikbare, modulaire modellen. Deze modellen kun je hiërarchisch stapelen, waarbij fundamentele datamodellen input leveren aan analytische modellen op hoger niveau. 

Deze aanpak houdt de pipeline beheersbaar en stelt teams in staat effectiever samen te werken door wijzigingen te isoleren tot specifieke modellen zonder het hele systeem te beïnvloeden.

Wil je meer leren over de basisconcepten van dbt en best practices voor datamodellering? Bekijk dan de dbt-tutorial: 7 onmisbare concepten voor data engineers. Die sluit goed aan op de strategieën in deze gids.

Gecentraliseerde metricdefinities

Met dbt definieer je businesslogica en metrics op één plek, wat consistentie garandeert in verschillende analytische tools. Met de metrics-functie van dbt kun je KPI’s zoals omzet, conversieratio of churn één keer definiëren en die vervolgens gebruiken in dashboards, rapporten en analyses zonder herdefinitie. Dit vermindert discrepanties en waarborgt dataintegriteit.

Versiebeheer en documentatie

De integratie van dbt met Git faciliteert robuust versiebeheer, zodat je wijzigingen in de tijd kunt volgen en auditen. In combinatie met automatisch gegenereerde documentatie creëert dbt een levend, toegankelijk naslagwerk voor alle datatransformaties en metrics. Dit zorgt voor transparantie en helpt nieuwe teamleden snel onboarden door de gedocumenteerde datapipeline te verkennen.

Integratie met BI-tools

dbt werkt met BI-platforms zoals Looker, Tableau en Mode, waardoor je de semantische laag kunt integreren in visualisatietools. Met dbt exposures kun je dbt-modellen direct koppelen aan BI-dashboards, zodat updates in datamodellen automatisch doorwerken in de analytics zonder handmatig ingrijpen.

Je dbt-project opzetten

Meestal draait dbt bovenop cloud-datawarehouses zoals Snowflake of Google BigQuery. Voor deze tutorial houden we het echter simpel en verbinden we lokaal met een DuckDB-database.

1. Vereisten

  • Installeer Python op je machine als dat nog niet is gebeurd.

2. De benodigde tools installeren

Gebruik pip om de dbt CLI te installeren:

pip install dbt-core

Installeer DuckDB via pip:

pip install duckdb

Installeer de DuckDB-adapter via pip:

pip install dbt-duckdb

3. Het dbt-project initialiseren

Maak een nieuw dbt-project:

dbt init project_name

Deze opdracht maakt een project in je huidige map, met ongeveer deze structuur:

project_name/
├── analyses/
├── logs/
├── macros/
├── models/
├── seeds/
├── snapshots/
├── tests/
├── .gitignore
├── dbt_project.yml

4. De DuckDB-verbinding instellen

Bewerk het bestand profiles.yml, meestal in de map ~/.dbt/. Als het niet bestaat, maak het dan aan:

project_name:  # This matches the name in dbt_project.yml file
  target: dev
  outputs:
    dev:
      type: duckdb
      path: path/to/demo_database.duckdb  
      threads: 1

De profiles.yml bevat de verwijzing naar de locatie van het .duckdb-databasebestand, dat je moet aangeven in het path. 

Je kunt ofwel een nieuwe database maken of een kleine voorbeelddatabase downloaden van hier. In de volgende sectie gebruik ik het bestand duckdb-demo.duckdb van dezelfde bron. 

Om een nieuw DuckDB-databasebestand te maken, voer je simpelweg het volgende uit:

import duckdb
duckdb.connect('/path/to/your/duckdb/database.duckdb')

5. De verbinding testen

Nu kunnen we testen met dbt debug om te controleren of alles werkt. Zorg dat je je in de projectmap bevindt voordat je de opdracht uitvoert:

cd /path/to/your/project/
dbt debug

Als alles correct is ingesteld, krijg je ongeveer dit terug (alle paden zijn weggelaten om privacyredenen):

15:20:00  Running with dbt=1.9.1
15:20:00  dbt version: 1.9.1
15:20:00  python version: 3.11.5
15:20:00  python path: ...
15:20:00  os info: Windows-10-10.0.22631-SP0
15:20:00  Using profiles dir at ....
15:20:00  Using profiles.yml file at ...
15:20:00  Using dbt_project.yml file at ...
15:20:00  adapter type: duckdb
15:20:00  adapter version: 1.9.1
15:20:00  Configuration:
15:20:00    profiles.yml file [OK found and valid]
15:20:00    dbt_project.yml file [OK found and valid]
15:20:00  Required dependencies:
15:20:00   - git [OK found]

15:20:00  Connection:
15:20:00    database: demo_database
15:20:00    schema: main
15:20:00    path: ...
15:20:00    config_options: None
15:20:00    extensions: None
15:20:00    settings: {}
15:20:00    external_root: .
15:20:00    use_credential_provider: None
15:20:00    attach: None
15:20:00    filesystems: None
15:20:00    remote: None
15:20:00    plugins: None
15:20:00    disable_transactions: False
15:20:00  Registered adapter: duckdb=1.9.1
15:20:01    Connection test: [OK connection ok]

Een semantische laag maken met dbt

Gefeliciteerd dat je zo ver bent gekomen! Je hebt je eerste dbt-project succesvol opgezet.

Laten we nu bekijken hoe je een semantische laag boven op een database maakt. Daarvoor kun je ofwel je eigen data uit CSV in DuckDB importeren of een kleine (5 MB) voorbeelddatabase downloaden van hier.

Vervolgens kunnen we een eenvoudig Python-script schrijven om te verkennen wat dit databasebestand bevat:

import duckdb

# Connect to the database
conn = duckdb.connect("duckdb-demo.duckdb")

# Get list of tables
tables = conn.execute(
    "SELECT table_name FROM information_schema.tables WHERE table_schema='main'"
).fetchall()

print(f"\nNumber of tables in database: {len(tables)}")

print("Table names:")
for t in tables:
    print(f"- {t[0]}")

print("\nTables in database:")
for table in tables:
    print(f"- {table[0]}")

    # Get schema for each table
    schema = conn.execute(f"DESCRIBE {table[0]}").fetchall()
    print("\nSchema:")
    for col in schema:
        print(f"  {col[0]}: {col[1]}")

    # Preview data
    data = conn.execute(f"SELECT * FROM {table[0]} LIMIT 5").fetchall()
    print("\nFirst 5 rows:")
    for row in data:
        print(f"  {row}")
    print("\n---")

# Close connection
conn.close()

Output (ingekort):

Number of tables in database: 17
Table names:
- bank_failures
- boxplot
- calendar
- ...

Tables in database:
- bank_failures

Schema:
  c1: BIGINT
  Bank: VARCHAR
  City: VARCHAR
  State: VARCHAR
  Date: DATE
  Acquired by: VARCHAR
  Assets ($mil.): DOUBLE

First 5 rows:
  (1, 'Douglass National Bank', 'Kansas City', 'Missouri', datetime.date(2008, 1, 25), 'Liberty Bank and Trust', 58.5)
  (2, 'Hume Bank', 'Hume', 'Missouri', datetime.date(2008, 3, 7), 'Security Bank', 18.7)
...
…

Deze database heeft 17 tabellen. Voor deze tutorial gebruiken we echter alleen de tabel bank_failures. Deze tabel bevat historische financiële gegevens van gefaalde banken in de VS.

1. De SQL-modellen definiëren

SQL-modellen vormen de basis van elk dbt-project. Ze vertegenwoordigen de gestructureerde transformaties van ruwe data naar een analytisch formaat. 

Voor deze tutorial definiëren we twee SQL-bestanden in de map models/. 

Maak een nieuw bestand in de map models van je project met de naam base_bank_failures.sql:

SELECT *
FROM bank_failures

Dit bestand haalt rechtstreeks ruwe data op uit de tabel bank_failures. Het fungeert als basismodel waar latere modellen naar kunnen verwijzen.

Maak daarna een tweede bestand met de naam clean_bank_failures.sql:

SELECT
    State,
    COUNT(*) AS total_failures,
    SUM("Assets ($mil.)" ) AS total_assets
FROM
    {{ ref('base_bank_failures') }}
GROUP BY
    State

Dit bestand bouwt voort op het model base_bank_failures (met de functie ref()) om de data te aggregeren en op te schonen, klaar voor analyse. Het vat het totaal aan faillissementen en assets per staat samen.

2. Een metrics.yml-bestand maken

Het bestand metrics.yml definieert gecentraliseerde, herbruikbare metrics die consistentie garanderen in analyses en dashboards.

In ons geval beschrijft het metrics zoals total_assets en avg_assets_per_failure, zodat ze beschikbaar zijn in BI-tools en andere queries:

version: 2
models:
  - name: clean_bank_failures
    description: "Aggregated data about bank failures."
    columns:
      - name: State
        tests:
          - unique
      - name: "Assets ($mil.)"
    metrics:
      - name: total_assets
        label: Total Assets
        type: sum
        expression: "Assets ($mil.)"
        description: "Total assets of failed banks, aggregated by state."

      - name: avg_assets_per_failure
        label: Average Assets per Failure
        type: average
        expression: "Assets ($mil.)"
        description: "Average assets for each bank failure."

3. Een exposures.yml-bestand maken

Het bestand exposures.yml koppelt je dbt-modellen aan externe tools zoals Tableau of Looker. Het documenteert deze verbindingen voor traceerbaarheid en consistentie.

Dit bestand specificeert dat het model clean_bank_failures wordt gebruikt in een Tableau-dashboard, met details over de eigenaar en de afhankelijkheid:

exposures:
  - name: tableau_dashboard
    type: dashboard
    url: https://tableau.yourcompany.com/workbook
    owner:
      name: Data Team
      email: datateam@yourcompany.com
    depends_on:
      - ref('clean_bank_failures')

De semantische laag bouwen en testen

Om je dbt-project te valideren en te bouwen, zijn dit handige opdrachten die je kunt gebruiken:

1. Bouw de modellen: Voer de opdracht dbt build uit om alle modellen te materialiseren, tests toe te passen en seeds en snapshots te draaien. Deze opdracht combineert de functionaliteit van dbt run en dbt test:

dbt build

2. Test de modellen: Als je na het bouwen alleen je data wilt valideren met tests, gebruik dan de opdracht dbt test. Zo worden alle datakwaliteitstests (bijv. uniekheid en not-null-controles) op je modellen toegepast.

dbt test

3. Specifieke modellen of tests draaien: Om alleen specifieke modellen of tests te draaien, geef je hun namen mee als argument. Bijvoorbeeld, om één model te draaien:

dbt run --select clean_bank_failures

Een specifieke kolom testen:

dbt test --select clean_bank_failures.State

De semantische laag integreren met BI-tools

Volg deze stappen om dbt te koppelen aan BI-tools zoals Looker of Tableau, zodat de semantische laag effectief wordt blootgesteld en BI-tools dbt-modellen en -metrics direct kunnen gebruiken:

1. Exposures inschakelen in dbt

Maak in je dbt-project een bestand exposures.yml in de map models, dat er zo uitziet:

exposures:
  - name: tableau_dashboard
    type: dashboard
    url: https://tableau.yourcompany.com/workbook
    owner:
      name: Your Name
      email: email@yourcompany.com
    depends_on:
      - ref('clean_bank_failures')

2. Je databaseverbinding voorbereiden

  • Zorg dat de getransformeerde datamodellen beschikbaar zijn in je database (bijv. Snowflake, BigQuery, DuckDB).
  • Voer dbt build uit om de dbt-modellen te materialiseren in de database.

3. Tableau verbinden met dbt-modellen

  • Open Tableau Desktop en maak een nieuwe verbinding met je database.
  • Selecteer het schema waarin de dbt-modellen zijn opgeslagen.
  • Sleep de dbt-modellen (bijv. clean_bank_failures) naar de Tableau-werkruimte.

4. Metrics definiëren in Tableau

  • Gebruik in Tableau de door dbt gedefinieerde metrics zoals total_assets of avg_assets_per_failure direct in je visualisaties voor consistentie.
  • Maak indien nodig berekende velden om visualisaties te verrijken.

5. Looker verbinden met dbt-modellen

  • Ga in Looker naar het beheerpaneel en stel een verbinding in met je database.
  • Maak een LookML-view voor elk dbt-model door het schema en de velden te importeren.
  • Gebruik de in dbt gedefinieerde metrics total_assets of avg_assets_per_failure om consistente Looker Explores en dashboards te bouwen.

Best practices voor het implementeren van een semantische laag met dbt

Nu je een overzicht hebt van de stappen om een semantische laag met dbt te bouwen, volgt hier een aantal best practices. 

Centraliseer businesslogica

Definieer alle businessregels in dbt voor consistentie en onderhoudbaarheid. Door businesslogica te centraliseren voorkom je dubbele definities in tools en creëer je één bron van waarheid die alle stakeholders eenvoudig kunnen bijwerken en begrijpen. 

Modulariseer modellen

Verdeel transformaties in logische, herbruikbare componenten. Maak bijvoorbeeld basismodellen voor ruwe data, intermediaire modellen voor opgeschoonde en getransformeerde data, en eindmodellen die klaar zijn voor analytics. 

Deze modulaire structuur vereenvoudigt troubleshooting, bevordert hergebruik van code en maakt samenwerking mogelijk doordat teamleden aan afzonderlijke onderdelen kunnen werken zonder de hele pipeline te verstoren.

Documenteer alles

Maak gebruik van de geautomatiseerde documentatie van dbt om je semantische laag goed georganiseerd en transparant te houden. 

Gebruik beschrijvingen in YAML-bestanden om duidelijke toelichtingen te geven bij modellen, metrics en kolommen. 

Werk documentatie regelmatig bij en gebruik de automatisch gegenereerde lineage-grafieken van dbt om relaties tussen modellen te visualiseren. Zo blijft de semantische laag toegankelijk en makkelijk te navigeren voor alle gebruikers.

Tools zoals het dbt-utils-pakket kunnen je dbt-workflows aanzienlijk stroomlijnen met kant-en-klare macro’s en utilities die modelontwikkeling vereenvoudigen en grondige documentatie bevorderen.

Conclusie

Een semantische laag implementeren met dbt is een krachtige manier om de kloof te dichten tussen ruwe data en actiegerichte inzichten. De modulaire datamodellering van dbt, gecentraliseerde metricdefinities, robuust versiebeheer en integratie met BI-tools helpen je om consistente, betrouwbare en toegankelijke data te garanderen voor analytics en rapportage.

Deze tutorial heeft je meegenomen langs het opzetten van een dbt-project, het maken van SQL-modellen, het definiëren van herbruikbare metrics en het integreren van de semantische laag met visualisatietools zoals Tableau en Looker.

Wil je meer leren over dbt? Bekijk dan de uitstekende Introduction to dbt-cursus!


Moez Ali's photo
Author
Moez Ali
LinkedIn
Twitter

Data scientist, oprichter en maker van PyCaret

Onderwerpen
Data-engineering
dbt

Leer meer over data engineering met deze cursussen!

Cursus

Introductie tot Data Engineering

4 uur
130.1K
Leer meer over de wereld van data engineering in deze korte cursus, waarin tools en onderwerpen zoals ETL en cloud computing aan bod komen.
Bekijk detailsRight Arrow
Start Cursus
Meer bekijkenRight Arrow
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer BekijkenMeer Bekijken

