Ana içeriğe atla

dbt ile Anlamsal Katman Uygulaması: Uygulamalı Rehber

dbt ile bir anlamsal katman oluşturarak ham veriyi analitik ve BI araçları için tutarlı metriklere dönüştürmeyi öğrenin!
Güncel 3 Eki 2026  · 8 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

Günümüzün birçok modern şirketi, veri ambarları (ör. Snowflake) gibi ortamlarda tutulan ham veri ile panolardaki veya raporlardaki içgörüler arasındaki boşluğu kapatmak için anlamsal katmanlara güvenir. 

Anlamsal katman, analitik ve raporlama için tutarlı metrikler, ölçüler ve boyutlar tanımlayan bir soyutlama katmanıdır.

Bu eğitimde, popüler bir veri dönüştürme ve modelleme çerçevesi olan dbt (data build tool) kullanarak bir anlamsal katmanın nasıl uygulanacağını inceleyeceğiz. Rehber, kavramı hızlıca kavramanıza yardımcı olacak pratik örnekler ve içgörüler içerir.

Anlamsal Katman Nedir ve Neden Önemlidir?

Bir anlamsal katman, ham veriyi tutarlı ve yeniden kullanılabilir metriklere ve boyutlara dönüştürerek veri analizini basitleştirir. Ekipler ve araçlar arasında birlik sağlayan bir araçtır.

Anlamsal katmanın faydaları

  • Tutarlı veri tanımları: Gelir, müşteri kayıp oranı (churn), yıllık bazda büyüme (YoY), ortalama sipariş değeri vb. gibi iş metriklerinin tek tip tanımlanmasını sağlar. Bu, farklı ekiplerin tutarsız tanımlar kullanmasından kaynaklanan karışıklığı ortadan kaldırır ve kuruluş genelinde veriye duyulan güveni korumaya yardımcı olur.
  • Gelişmiş iş birliği: Teknik ve teknik olmayan ekipler arasında daha iyi iletişim ve hizalanma sağlar. Birleştirilmiş bir veri katmanı sunarak teknik ekiplerin veri doğruluğuna odaklanmasını, iş ekiplerinin ise stratejik kararlar için net ve erişilebilir metriklerden yararlanmasını mümkün kılar.
  • Daha hızlı içgörü üretimi: Belirsizliği azaltarak daha hızlı karar vermeyi mümkün kılar. Anlamsal katman sayesinde paydaşlar, verileri uzlaştırmaya veya tutarsızlıkları gidermeye harcanan süreyi en aza indirerek güvenilir metriklere hızla erişip analiz edebilir.

Neden dbt Anlamsal Katman Oluşturmak İçin İdealdir

dbt’yi, veri ve analitik mühendislerinin bir anlamsal katman inşa etmesini mükemmel kılan özellikleriyle inceleyelim.
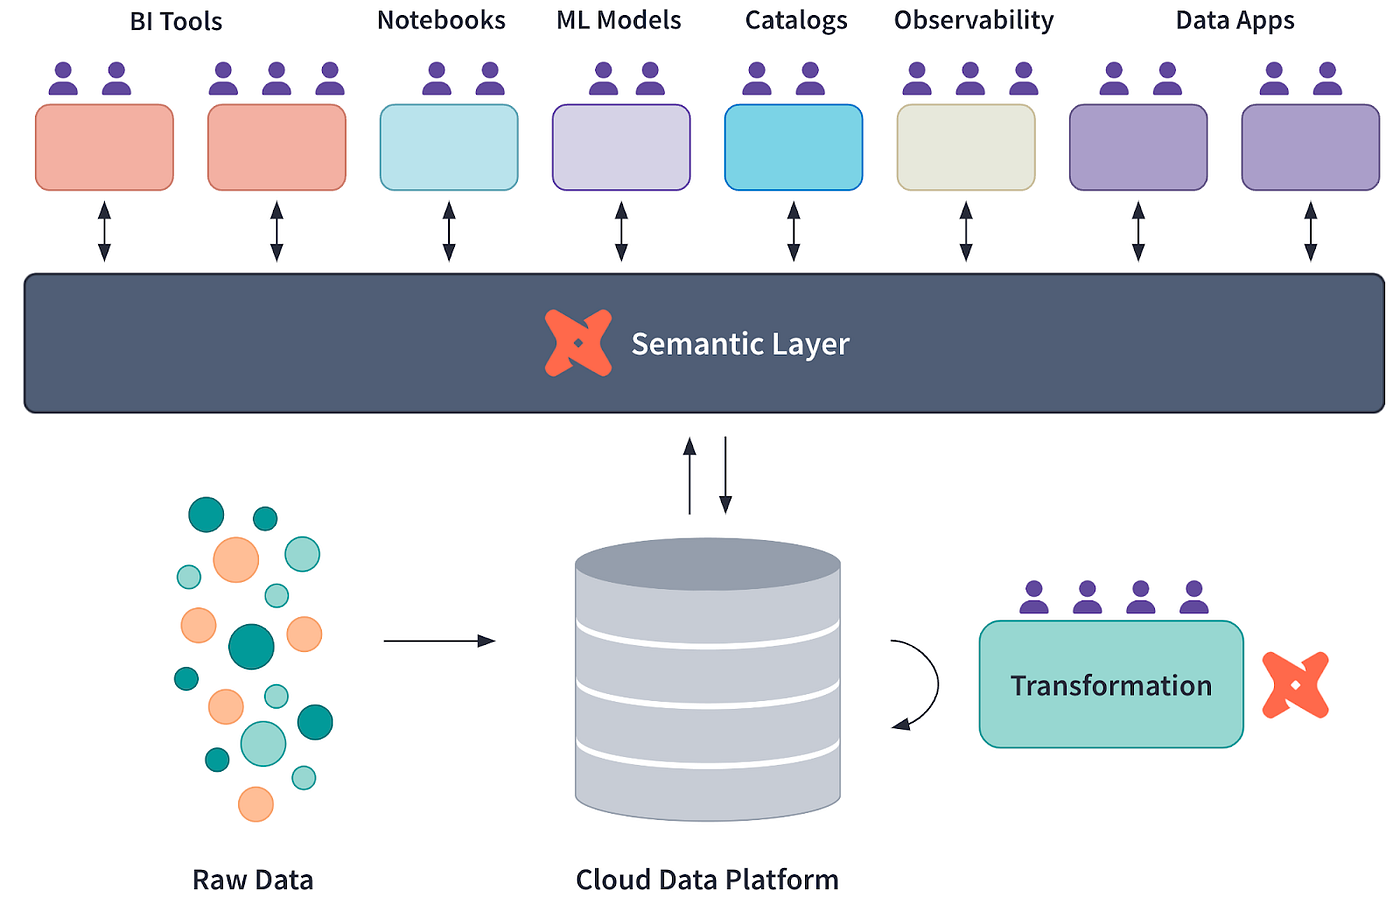
dbt ile modelleme mimarisini gösteren bir ekran görüntüsü

dbt Anlamsal Katman kavramsal diyagramı, dbt Labs izniyle

Modüler veri modelleme

dbt, karmaşık veri dönüşümlerini yeniden kullanılabilir, modüler modellere ayırmanıza olanak tanır. Bu modeller hiyerarşik olarak katmanlanabilir; temel veri modelleri daha üst düzey analitik modellere veri sağlar. 

Bu yaklaşım hattın bakımını kolaylaştırır ve belirli modellere yapılan değişiklikleri tüm sistemi etkilemeden izole ederek ekiplerin daha etkili iş birliği yapmasını sağlar.

dbt’nin temel kavramları ve veri modelleme için en iyi uygulamaları hakkında daha fazla bilgi edinmek için dbt Eğitimi: Veri Mühendislerinin Mutlaka Bilmesi Gereken 7 Kavram yazısına göz atın. Buradaki stratejileri tamamlayan içgörüler sunar.

Merkezi metrik tanımları

dbt ile iş mantığı ve metrikler tek bir yerde tanımlanır; bu da çeşitli analitik araçlar arasında tutarlılık sağlar. dbt’nin metrics özelliğini kullanarak gelir, dönüşüm oranı veya churn gibi KPI’ları bir kez tanımlayıp panolarda, raporlarda ve analizlerde yeniden tanımlamadan kullanabilirsiniz. Bu, tutarsızlıkları azaltır ve veri bütünlüğünü güvence altına alır.

Sürüm kontrolü ve dokümantasyon

dbt’nin Git ile entegrasyonu güçlü bir sürüm kontrolü sağlar; zaman içindeki değişiklikleri izlemenize ve denetlemenize imkân tanır. Otomatik oluşturulan dokümantasyonuyla birlikte dbt, tüm veri dönüşümlerinin ve metriklerin yaşayan, erişilebilir bir referansını oluşturur. Bu da şeffaflık sağlar ve yeni ekip üyelerinin belgelenmiş veri hattını keşfederek hızlıca uyum sağlamasına yardımcı olur.

BI araçlarıyla entegrasyon

dbt, Looker, Tableau ve Mode gibi BI platformlarıyla çalışır; böylece anlamsal katman görselleştirme araçlarına entegre edilebilir. dbt exposures kullanarak dbt modellerini doğrudan BI panolarına bağlayabilir, veri modellerindeki güncellemelerin manuel müdahale olmaksızın analitiğe yansımasını sağlayabilirsiniz.

dbt Projenizi Kurma

Genellikle dbt, Snowflake veya Google BigQuery gibi bulut veri ambarlarının üzerinde çalışır. Ancak bu eğitimde işleri basit tutmak için yerelde bir DuckDB veritabanına bağlanacağız.

1. Önkoşullar

  • Makinenize henüz yüklü değilse Python yükleyin.

2. Gerekli araçların kurulumu

dbt CLI’ı pip ile kurun:

pip install dbt-core

DuckDB’yi pip ile kurun:

pip install duckdb

DuckDB adaptörünü pip ile kurun:

pip install dbt-duckdb

3. dbt projesini başlatma

Yeni bir dbt projesi oluşturun:

dbt init project_name

Bu komut, mevcut dizininizde aşağıdaki gibi bir proje oluşturur:

project_name/
├── analyses/
├── logs/
├── macros/
├── models/
├── seeds/
├── snapshots/
├── tests/
├── .gitignore
├── dbt_project.yml

4. DuckDB bağlantısını ayarlama

profiles.yml dosyasını düzenleyin; genellikle ~/.dbt/ klasöründe bulunur. Yoksa bir tane oluşturun:

project_name:  # This matches the name in dbt_project.yml file
  target: dev
  outputs:
    dev:
      type: duckdb
      path: path/to/demo_database.duckdb  
      threads: 1

profiles.yml, path içinde belirtmeniz gereken .duckdb veritabanı dosyasının konumuna işaret eder. 

Yeni bir veritabanı oluşturabilir veya küçük bir örnek veritabanını buradan indirebilirsiniz. Bir sonraki bölümde aynı kaynaktaki duckdb-demo.duckdb dosyasını kullanacağım. 

Yeni bir duckDB veritabanı dosyası oluşturmak için aşağıdakini çalıştırmanız yeterlidir:

import duckdb
duckdb.connect('/path/to/your/duckdb/database.duckdb')

5. Bağlantıyı test etme

Şimdi, her şeyin çalışıp çalışmadığını kontrol etmek için dbt debug komutunu çalıştırarak test edebiliriz. Komutu çalıştırmadan önce proje klasöründe olduğunuzdan emin olun:

cd /path/to/your/project/
dbt debug

Her şey doğru kurulduysa, aşağıdakine benzer bir çıktı alırsınız (tüm yollar gizlilik nedeniyle maskelenmiştir):

15:20:00  Running with dbt=1.9.1
15:20:00  dbt version: 1.9.1
15:20:00  python version: 3.11.5
15:20:00  python path: ...
15:20:00  os info: Windows-10-10.0.22631-SP0
15:20:00  Using profiles dir at ....
15:20:00  Using profiles.yml file at ...
15:20:00  Using dbt_project.yml file at ...
15:20:00  adapter type: duckdb
15:20:00  adapter version: 1.9.1
15:20:00  Configuration:
15:20:00    profiles.yml file [OK found and valid]
15:20:00    dbt_project.yml file [OK found and valid]
15:20:00  Required dependencies:
15:20:00   - git [OK found]

15:20:00  Connection:
15:20:00    database: demo_database
15:20:00    schema: main
15:20:00    path: ...
15:20:00    config_options: None
15:20:00    extensions: None
15:20:00    settings: {}
15:20:00    external_root: .
15:20:00    use_credential_provider: None
15:20:00    attach: None
15:20:00    filesystems: None
15:20:00    remote: None
15:20:00    plugins: None
15:20:00    disable_transactions: False
15:20:00  Registered adapter: duckdb=1.9.1
15:20:01    Connection test: [OK connection ok]

dbt ile Anlamsal Katman Oluşturma

Buraya kadar geldiğiniz için tebrikler! İlk dbt projenizi başarıyla kurdunuz.

Şimdi bir veritabanının üzerine nasıl anlamsal katman oluşturacağımıza bakalım. Bunu yapmak için ya CSV’den DuckDB’ye kendi verinizi içe aktarabilir ya da küçük (5MB) bir örnek veritabanı dosyasını buradan indirebilirsiniz.

Ardından, bu veritabanı dosyasının neler içerdiğini keşfetmek için basit bir Python betiği yazabiliriz:

import duckdb

# Connect to the database
conn = duckdb.connect("duckdb-demo.duckdb")

# Get list of tables
tables = conn.execute(
    "SELECT table_name FROM information_schema.tables WHERE table_schema='main'"
).fetchall()

print(f"\nNumber of tables in database: {len(tables)}")

print("Table names:")
for t in tables:
    print(f"- {t[0]}")

print("\nTables in database:")
for table in tables:
    print(f"- {table[0]}")

    # Get schema for each table
    schema = conn.execute(f"DESCRIBE {table[0]}").fetchall()
    print("\nSchema:")
    for col in schema:
        print(f"  {col[0]}: {col[1]}")

    # Preview data
    data = conn.execute(f"SELECT * FROM {table[0]} LIMIT 5").fetchall()
    print("\nFirst 5 rows:")
    for row in data:
        print(f"  {row}")
    print("\n---")

# Close connection
conn.close()

Çıktı (kısaltılmıştır):

Number of tables in database: 17
Table names:
- bank_failures
- boxplot
- calendar
- ...

Tables in database:
- bank_failures

Schema:
  c1: BIGINT
  Bank: VARCHAR
  City: VARCHAR
  State: VARCHAR
  Date: DATE
  Acquired by: VARCHAR
  Assets ($mil.): DOUBLE

First 5 rows:
  (1, 'Douglass National Bank', 'Kansas City', 'Missouri', datetime.date(2008, 1, 25), 'Liberty Bank and Trust', 58.5)
  (2, 'Hume Bank', 'Hume', 'Missouri', datetime.date(2008, 3, 7), 'Security Bank', 18.7)
...
…

Bu veritabanında 17 tablo var. Ancak bu eğitimde yalnızca bank_failures tablosunu kullanacağız. Bu tablo, ABD’de iflas eden bankaların tarihsel finansal ayrıntılarını içerir.

1. SQL modellerini tanımlama

SQL modelleri, herhangi bir dbt projesinin temelidir. Ham verinin daha analitik bir formata dönüştürülmüş, yapılandırılmış hâlini temsil ederler. 

Bu eğitimde, models/ klasörü altında iki SQL dosyası tanımlayacağız. 

Projenizin models klasörü altında base_bank_failures.sql adlı yeni bir dosya oluşturun:

SELECT *
FROM bank_failures

Bu dosya, ham veriyi doğrudan bank_failures tablosundan çeker. Sonraki modellerin başvuracağı temel model olarak görev yapar.

Ardından, clean_bank_failures.sql adlı başka bir dosya oluşturun:

SELECT
    State,
    COUNT(*) AS total_failures,
    SUM("Assets ($mil.)" ) AS total_assets
FROM
    {{ ref('base_bank_failures') }}
GROUP BY
    State

Bu dosya, veriyi toplamak ve temizlemek için base_bank_failures modelini (ref() fonksiyonunu kullanarak) temel alır ve analize hazırlar. Eyalete göre toplam iflas ve varlıkları özetler.

2. metrics.yml dosyası oluşturma

metrics.yml dosyası, analizler ve panolar arasında tutarlılık sağlayan merkezi ve yeniden kullanılabilir metrikleri tanımlar.

Bizim durumumuzda, total_assets ve avg_assets_per_failure gibi metrikleri tanımlayarak, bunların BI araçlarında ve diğer sorgularda kullanılabilir olmasını sağlayacağız:

version: 2
models:
  - name: clean_bank_failures
    description: "Aggregated data about bank failures."
    columns:
      - name: State
        tests:
          - unique
      - name: "Assets ($mil.)"
    metrics:
      - name: total_assets
        label: Total Assets
        type: sum
        expression: "Assets ($mil.)"
        description: "Total assets of failed banks, aggregated by state."

      - name: avg_assets_per_failure
        label: Average Assets per Failure
        type: average
        expression: "Assets ($mil.)"
        description: "Average assets for each bank failure."

3. exposures.yml dosyası oluşturma

exposures.yml dosyası, dbt modellerinizi Tableau veya Looker gibi harici araçlara bağlar. Bu bağlantıları belgelendirerek izlenebilirlik ve tutarlılık sağlar.

Bu dosya, clean_bank_failures modelinin bir Tableau panosunda kullanıldığını belirterek sahip ve bağımlılık hakkında ayrıntılar sunar:

exposures:
  - name: tableau_dashboard
    type: dashboard
    url: https://tableau.yourcompany.com/workbook
    owner:
      name: Data Team
      email: datateam@yourcompany.com
    depends_on:
      - ref('clean_bank_failures')

Anlamsal Katmanı Oluşturma ve Test Etme

dbt projenizi başarıyla doğrulayıp derlemek için kullanabileceğiniz bazı yararlı komutlar şunlardır:

1. Modelleri derleyin: Tüm modelleri materyalize etmek, testleri uygulamak ve seed ile snapshot’ları çalıştırmak için dbt build komutunu çalıştırın. Bu komut, dbt run ve dbt test işlevlerini birleştirir:

dbt build

2. Modelleri test edin: Yalnızca derlemeden sonra verinizi testlerle doğrulamak istiyorsanız dbt test komutunu kullanın. Bu, tüm veri kalitesi testlerinin (ör. benzersizlik ve boş olamaz kontrolleri) modellerinize uygulanmasını sağlar.

dbt test

3. Belirli modelleri veya testleri çalıştırın: Yalnızca belirli modelleri veya testleri çalıştırmak için adlarını argüman olarak verin. Örneğin, tek bir modeli çalıştırmak için:

dbt run --select clean_bank_failures

Belirli bir sütunu test etmek için:

dbt test --select clean_bank_failures.State

Anlamsal Katmanı BI Araçlarıyla Entegre Etme

dbt’yi Looker veya Tableau gibi BI araçlarına bağlamak için aşağıdaki adımları izleyerek anlamsal katmanı etkili bir şekilde açığa çıkarın ve BI araçlarının dbt modelleri ile metriklerine doğrudan başvurmasını sağlayın:

1. dbt’de exposures etkinleştirme

dbt projenizde, models klasörü altında şu şekilde görünen bir exposures.yml dosyası oluşturun:

exposures:
  - name: tableau_dashboard
    type: dashboard
    url: https://tableau.yourcompany.com/workbook
    owner:
      name: Your Name
      email: email@yourcompany.com
    depends_on:
      - ref('clean_bank_failures')

2. Veritabanı bağlantınızı hazırlama

  • Dönüştürülmüş veri modellerinin veritabanınızda (ör. Snowflake, BigQuery, DuckDB) hazır olduğundan emin olun.
  • dbt build çalıştırarak dbt modellerini veritabanında materyalize edin.

3. Tableau’yu dbt modellerine bağlama

  • Tableau Desktop’ı açın ve veritabanınıza yeni bir bağlantı oluşturun.
  • dbt modellerinin bulunduğu şemayı seçin.
  • dbt modellerini (ör. clean_bank_failures) Tableau çalışma alanına sürükleyip bırakın.

4. Tableau’da metrikleri tanımlama

  • Tableau’da, tutarlılığı sağlamak için total_assets veya avg_assets_per_failure gibi dbt ile tanımlanmış metrikleri doğrudan görselleştirmelerde kullanın.
  • Görselleştirmeleri zenginleştirmek için gerekirse hesaplanmış alanlar oluşturun.

5. Looker’ı dbt modellerine bağlama

  • Looker’da yönetim paneline gidin ve veritabanınıza bir bağlantı ayarlayın.
  • Şema ve alanları içe aktararak her dbt modeli için bir LookML görünümü oluşturun.
  • Tutarlı Looker Explore’ları ve panoları oluşturmak için dbt’de tanımlanan total_assets veya avg_assets_per_failure metriklerini kullanın.

dbt ile Anlamsal Katman Uygulamak İçin En İyi Uygulamalar

Artık dbt ile bir anlamsal katman oluşturmaya yönelik adımlara genel bir bakışa sahip olduğunuza göre, bazı en iyi uygulamaları gözden geçirelim. 

İş mantığını merkezileştirin

Tutarlılık ve sürdürülebilirliği sağlamak için tüm iş kurallarını dbt’de tanımlayın. İş mantığını merkezileştirerek araçlar arası yinelenen tanımları ortadan kaldırır, tüm paydaşların kolayca güncelleyebileceği ve anlayabileceği tek bir doğru kaynak (single source of truth) oluşturursunuz. 

Modelleri modülerleştirin

Dönüşümleri mantıksal ve yeniden kullanılabilir bileşenlere ayırın. Örneğin, ham veri için temel modeller, temizlenmiş ve dönüştürülmüş veri için ara modeller ve analize hazır veri için son modeller oluşturun. 

Bu modüler yapı, sorun gidermeyi basitleştirir, kodun yeniden kullanımını teşvik eder ve tüm hattı aksatmadan bireysel bileşenler üzerinde çalışabilen ekip üyeleri arasında iş birliğini kolaylaştırır.

Her şeyi belgeleyin

Anlamsal katmanınızı düzenli ve şeffaf tutmak için dbt’nin otomatik dokümantasyonundan yararlanın. 

YAML dosyalarındaki açıklamaları, modeller, metrikler ve sütunlar için net açıklamalar sağlamak amacıyla kullanın. 

Değişiklikleri yansıtmak için belgeleri düzenli olarak güncelleyin ve modeller arasındaki ilişkileri görselleştirmek için dbt’nin otomatik oluşturulan soy ağaçlarını kullanın. Bu, anlamsal katmanın tüm kullanıcılar için erişilebilir ve kolay gezilebilir kalmasını sağlar.

dbt-utils paketi gibi araçlar, model geliştirmeyi basitleştiren ve kapsamlı dokümantasyonu güvence altına alan hazır makrolar ve yardımcılarla dbt iş akışlarınızı önemli ölçüde hızlandırabilir.

Sonuç

dbt ile anlamsal katman uygulamak, ham veri ile eyleme dönük içgörüler arasındaki boşluğu kapatmak için güçlü bir yaklaşımdır. dbt’nin modüler veri modellemesi, merkezi metrik tanımları, sağlam sürüm kontrolü ve BI araçlarıyla entegrasyonu; analitik ve raporlama için tutarlı, güvenilir ve erişilebilir veriler sağlamanıza yardımcı olabilir.

Bu eğitimde bir dbt projesinin kurulumu, SQL modellerinin oluşturulması, yeniden kullanılabilir metriklerin tanımlanması ve anlamsal katmanın Tableau ve Looker gibi görselleştirme araçlarıyla entegrasyonu ele alındı.

Daha fazla dbt öğrenmek için, harika Introduction to dbt kursuna göz atın!


Moez Ali's photo
Author
Moez Ali
LinkedIn
Twitter

Veri Bilimci, PyCaret'in Kurucusu ve Yaratıcısı

Konular
Veri Mühendisliği
dbt

Bu kurslarla veri mühendisliği hakkında daha fazla bilgi edinin!

Kurs

Data Engineering'e Giriş

4 sa
130.1K
ETL ve bulut bilişim gibi araçları ve konuları kapsayan bu kısa kursta veri mühendisliği dünyası hakkında bilgi edinin.
Ayrıntıları GörüntüleRight Arrow
Kursa Başla
Devamını GörRight Arrow
İlgili

blog

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

blog

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

Eğitim

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Eğitim

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

Devamını GörDevamını Gör

