
Last chance! 50% off DataCamp Premium
Sale ends in
Salah satu konsep prasyarat yang perlu Anda ketahui adalah data warehouse. Warehouse adalah tempat Anda menyimpan semua data yang dimiliki suatu perusahaan.
Perusahaan membangun warehouse karena memungkinkan analitik dan semua hal lain yang dapat Anda lakukan dengan data (ehm, data terstruktur). Warehouse menyimpan data historis yang diatur ke dalam tabel, dan terstruktur untuk kueri dan analisis yang cepat.
Ada banyak alat yang mengimplementasikan data warehouse:
dan seterusnya.
dbt tidak membantu Anda mengumpulkan atau memuat data ke alat-alat di atas, tetapi mentransformasi data di dalamnya. Dengan kata lain, dbt melakukan huruf T dalam proses ETL/ELT (extraction, transformation, load) yang menjadi inti semua warehouse.
dbt ditawarkan melalui dua antarmuka: dbt Core dan dbt Cloud.
dbt Core adalah pustaka open source yang mengimplementasikan sebagian besar fungsionalitas dbt. Ia memiliki antarmuka baris perintah (perintah dbt yang akan Anda sukai) yang dapat Anda gunakan untuk mengelola transformasi data dalam proyek Anda.
dbt Cloud adalah solusi enterprise untuk tim. Di atas CLI, dbt Cloud juga menyediakan IDE berbasis web yang lebih ramah pengguna. Dengannya, Anda tidak perlu terlalu khawatir tentang koneksi basis data dan pengeditan file YAML (sebagaimana akan Anda lihat di bagian berikut).
dbt Cloud juga menawarkan fitur tambahan seperti penjadwalan job, integrasi lanjutan, dan dukungan prioritas tinggi.
Berikut tabel yang merangkum perbedaan antara dbt Core dan dbt Cloud:
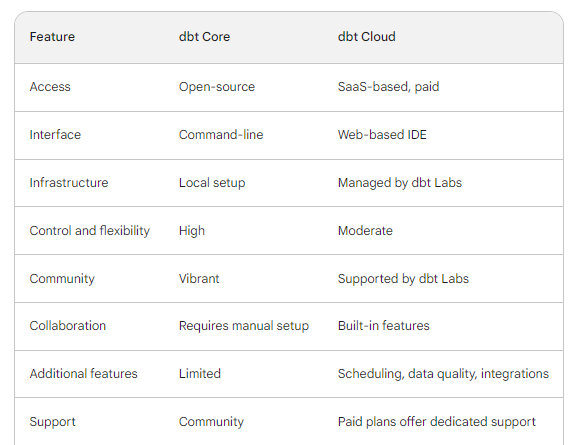
Terlepas dari fitur tambahan tersebut, kita akan membahas dbt Core karena paling cocok untuk proyek lokal, pengujian, dan pembelajaran. Anda dapat menginstalnya dengan pip di OS mana pun (tentu di dalam lingkungan virtual).
Saya akan menggunakan lingkungan Conda:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Anda harus mengganti adapter_name dengan basis data yang ingin Anda gunakan. dbt Labs (perusahaan di balik dbt) telah mengintegrasikan banyak adapter untuk berbagai platform data.
Dalam artikel ini, kita akan menggunakan adapter dbt-duckdb untuk terhubung ke basis data DuckDB. Namun Anda dapat menggunakan salah satu adapter yang tercantum di halaman ini pada dokumentasi dbt.
$ pip install dbt-duckdb
Itu saja untuk penyiapan awal!
Secara garis besar, proyek dbt adalah direktori di mesin Anda yang berisi semua yang diperlukan untuk melakukan transformasi pada data Anda. Isinya banyak file .sql (disebut model) dan file YAML (untuk konfigurasi).
Untuk membuat proyek dbt, Anda dapat menggunakan perintah dbt init <project_name> di CLI:
$ dbt init dbt_learnTerminal akan meminta Anda memasukkan kode yang sesuai dengan adapter platform data yang tersedia. Karena Anda hanya memiliki DuckDB, Anda dapat menekan 1.
$ cd dbt_learn
Di dalam dbt_learn, Anda memiliki struktur berikut:
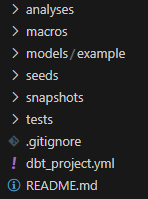
Di sinilah data engineer menjadi software engineer karena proyek dbt memungkinkan Anda untuk:
Singkatnya, proyek dbt menawarkan cara yang kuat untuk mengelola dan mengorkestrasi transformasi data. Proyek ini menghadirkan manfaat rekayasa perangkat lunak yang telah lama dinantikan ke dunia data.
Kita telah menginisialisasi proyek dbt dan sekarang, kita perlu terhubung ke basis data yang ada (atau membuatnya dari nol). Untuk melakukannya, kita membutuhkan cara yang aman untuk memberikan kredensial basis data kepada dbt agar dapat membangun koneksi. Di sinilah kita akan menggunakan profil proyek.
Profil proyek adalah file YAML yang berisi detail koneksi untuk platform data pilihan Anda. File ini dibuat di direktori .dbt di $HOME dan diberi nama profiles.yml. Berikut tampilannya saat ini:
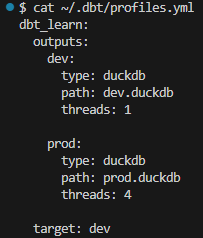
File tersebut mencantumkan satu profil bernama dbt_learn untuk proyek kita. Profil ini menentukan dua output: dev dan prod.
Output adalah konfigurasi individual yang menentukan koneksi berbeda ke data warehouse atau basis data. Melalui output, Anda dapat mengelola koneksi ke berbagai lingkungan:
Dalam profil kita, output default adalah dev, yang tercantum pada kolom target. Anda dapat mengubahnya ke output lain sesuai kebutuhan. Untuk saat ini, kita biarkan apa adanya.
Catatan: Anda dapat mengubah nama profil dan output selama keduanya direferensikan dengan benar di sisa file dbt.
Kolom path menentukan lokasi basis data yang sudah ada bernama dev.duckdb. Jika belum ada, basis data akan dibuat oleh adapter dbt DuckDB di direktori kerja kita (di dalam proyek dbt_learn; kolom path menentukan path relatif terhadap direktori proyek). Karena kita belum memiliki basis data bernama dev.duckdb, kita akan membiarkan dbt membuatnya dengan menjalankan dbt debug.
$ dbt debug
Sub-perintah debug digunakan untuk menguji banyak aspek proyek seperti:
profiles.ymlprofiles.ymldbt_project.yml dan lain-lain.Jika Anda menerima pesan hijau “All tests passed” dan basis data dev.duckdb baru muncul, maka Anda siap melanjutkan.
Model adalah inti dari dbt karena merepresentasikan transformasi nyata yang membuat dbt terkenal.
Model data adalah gagasan konseptual yang mewakili struktur dan relasi dalam sekumpulan data. Model data di dbt lebih sederhana dan spesifik. Model memiliki atribut berikut:
.sql (Python diperbolehkan di versi dbt yang lebih baru)Proyek dbt_learn kita sudah terisi dua model dummy di dalam models/example:
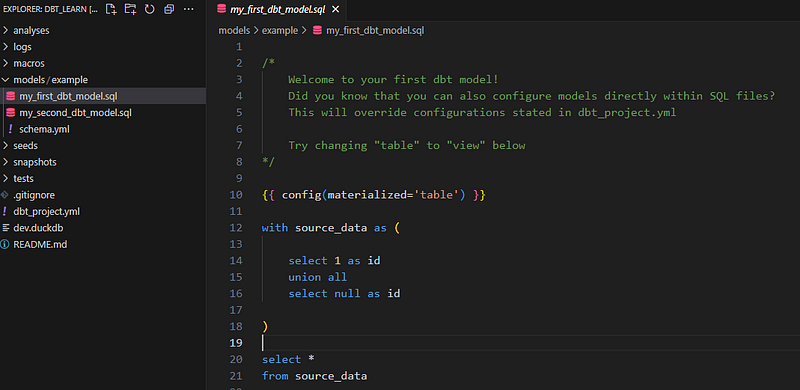
Kita akan menghapusnya dan membuat milik kita sendiri:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
Pada baris terakhir cuplikan kode di atas, kita membuat model bernama average_diamond_price_per_group di dalam direktori stats. Penting untuk deskriptif dalam menamai model.
Di dalam model (file .sql), tempelkan kueri SQL uji dummy ini:
SELECT 1 AS Id
dan jalankan model dengan dbt run:
$ dbt run
Anda seharusnya menerima pesan hijau “Completed successfully”.
Setelah semuanya siap, kita dapat memuat beberapa data ke dalam basis data dev.duckdb kita. Kita akan menggunakan file parquet untuk melakukannya, karena DuckDB mendukungnya secara native.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
Kueri tersebut seharusnya mengembalikan pesan sukses yang sama.
Untuk tutorial ini, saya sudah menyiapkan dataset diamonds sebagai file parquet. Di GitHub gist ini, Anda dapat menemukan cuplikan untuk mengunduhnya ke workspace Anda.
Kita baru saja melihat cara membuat model dbt pertama kita dengan menggunakan pernyataan SELECT yang mengembalikan beberapa statistik ringkasan tentang sebuah dataset. Dalam praktiknya, model Anda akan bergantung pada kebutuhan bisnis dan bagaimana para karyawan bekerja dengan basis data Anda. Oleh karena itu, kita tidak akan berfokus pada logika aktual model dbt, melainkan pada cara mengimplementasikannya dengan benar.
Dalam proyek dunia nyata, model Anda kemungkinan besar saling bergantung, membentuk semacam hierarki. Dalam dunia data, hierarki ini disebut Direct Acyclic Graph (DAG) atau grafik garis keturunan (lineage).
Satu DAG dapat menggantikan dokumentasi seribu kata. Lihat contoh ini dari halaman DAG dbt:
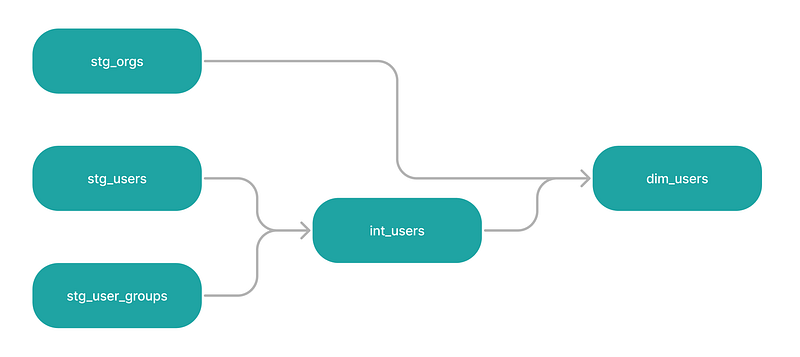
Ada empat model dalam grafik ini, semuanya terhubung linier ke model downstream. stg_users dan stg_user_groups adalah model induk dari int_users, yang pada gilirannya menjadi model induk dari dim_users bersama dengan model stg_orgs di hulu.
Catatan: kata upstream dan downstream sering digunakan untuk merujuk posisi relatif setiap model dalam DAG.
Satu aspek kunci dari DAG adalah tidak ada loop tertutup. Artinya model downstream, yang merupakan hasil dari model sebelumnya, tidak dapat digabungkan dengan model upstream. Di situlah kata acyclic berasal.
Selain kekayaan visual DAG, tujuannya adalah memungkinkan dbt membangun/memperbarui model sesuai dependensinya. Jika kita tidak mendefinisikan DAG untuk empat model di atas, dbt akan membangunnya dalam urutan alfabet. Ini akan menghasilkan segala macam pesan merah dan kesalahan.
Untuk mendefinisikan DAG di dbt, kita akan menggunakan templating Jinja.
Pada DAG di atas, model int_users merupakan hasil dari stg_users dan stg_user_groups. Kita perlu menentukan hubungan ini dalam proyek kita, jika tidak dbt run akan mengeksekusi semua model secara alfabet, yang berarti int_users berjalan lebih dulu. Ini akan menyebabkan error karena dependensinya belum termaterialisasi.
Saat ini, model int_users mungkin terlihat seperti ini:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Sekarang, kita akan menautkan ketiga model tersebut dengan mengubahnya menjadi node DAG menggunakan Jinja:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Alih-alih menulis nama model secara langsung, kita menaruhnya di dalam fungsi Jinja bernama ref. Sintaksnya adalah {{ ref("column_name") }} (perhatikan spasi dan tanda kutipnya). Saat kueri kita dikompilasi, fungsi Jinja akan digantikan dengan nama model sebenarnya.
Perhatikan bahwa stg_users dan stg_user_groups harus ada sebagai file .sql di proyek dbt Anda.
Sekarang, saat kita mengeksekusi dbt run, dbt akan mencari dependensi setiap model, menghubungkannya, dan mengeksekusinya sesuai urutan.
Fungsi ref di Jinja bukan satu-satunya yang dapat kita gunakan di dbt. Faktanya, dengan menggunakan fungsi dan fitur Jinja lainnya, Anda dapat memperluas fungsionalitas pernyataan SQL Anda secara signifikan. Berikut beberapa contohnya:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
Jika kita memiliki file models/model_properties.yml dan berisi field berikut:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Kita dapat mengakses field-nya di dalam file .sql mana pun menggunakan Jinja:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Kondisional:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Loop:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Berikut macro-nya:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Dan berikut cara menggunakannya di model:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Jika Anda ingin mempelajari lebih lanjut tentang penggunaan Jinja di dbt dengan SQL, lihat halaman ini dari dokumentasi dbt.
Seorang pengembang perangkat lunak yang baik tahu bahwa mereka perlu terus menguji kodenya untuk mencari bug dan error. Karena dbt menjadikan data engineer bak pengembang perangkat lunak, dbt menawarkan alur kerja langsung untuk menggunakan pengujian, baik bawaan maupun kustom.
Saat ini, dbt menawarkan empat pengujian bawaan berikut:
unique - memverifikasi semua nilai uniknot_null - memeriksa nilai hilangaccepted_values - memverifikasi semua nilai berada dalam daftar yang ditentukan, memiliki argumen valuesrelationships - memverifikasi koneksi ke tabel atau kolom tertentu, memiliki argumen to dan fieldUntuk menentukan pengujian mana yang digunakan pada kolom mana, kita menggunakan file YAML bernama model_properties.yml di dalam direktori models.
Catatan: model_properties.yml bukan persyaratan agar model berjalan dan dapat diberi nama apa saja. Namun, jika Anda ingin membuat pengujian untuk memvalidasi data yang memasok model Anda melalui pengujian, file ini wajib ada.
Mari lihat cara menggunakan pengujian not_null untuk memeriksa nilai hilang di kolom cut pada tabel diamonds. Pertama, buat file model_properties.yml di dalam models:
$ touch models/model_properties.yml
Di dalamnya, tempelkan konten berikut:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
Pada field - name di bawah models, kita menentukan model mana yang kita definisikan propertinya. Lalu, kita tentukan kolom dan namanya. Terakhir, kita tulis field tests, di bawahnya kita cantumkan pengujian not_null.
Sekarang, Anda dapat menggunakan pengujian ini untuk melakukan validasi data sebelum menjalankan dbt run. Perintahnya adalah dbt test:
$ dbt test
Jika Anda menerima pesan error, artinya pengujian gagal dan Anda perlu memeriksa masalah pada tabel dan memperbaikinya jika perlu.
Untuk menggunakan dbt dengan sukses dalam proyek Anda, Anda dapat mengikuti alur kerja yang direkomendasikan ini:
1. Inisialisasi proyek
dbt dan buat proyek baru dengan dbt init2. Konfigurasi
profiles.yml di direktori home Anda.dbt_project.yml untuk pengaturan tingkat proyek (misalnya, versi, dependensi).3. Pengembangan
.sql di direktori models untuk definisi model..yml di direktori tests untuk definisi pengujian.dbt test untuk sering menjalankan pengujian selama pengembangan.dbt debug untuk pemecahan masalah.4. Validasi Lokal (topik yang tidak kita bahas)
Praktik terbaik tambahan:
dbt docs generate untuk merender dokumentasi model di server web (ya, ini mungkin) nantinya.Kita telah membahas banyak fundamental dalam tutorial ini, namun seperti yang saya sebutkan di awal, dbt adalah alat yang masif dengan banyak fitur. Butuh waktu untuk menguasainya hingga Anda nyaman menggunakannya di lingkungan produksi. Mengapa tidak menggunakan sumber-sumber ini untuk membantu Anda mencapai tujuan itu lebih cepat?
Mulai Perjalanan dbt Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt




