
Kursus
Bekerja dengan OpenAI API
3 jam
180.1K
Lanskap data yang terus berubah, dipadukan dengan kemajuan pesat dalam AI Generatif selama dua tahun terakhir, telah membentuk ulang arah pencarian semantik dan semakin mendorong popularitas aplikasi pencarian semantik.
Pencarian dan pengambilan adalah proses menemukan dan memperoleh informasi atau data tertentu dari basis data atau koleksi yang lebih besar berdasarkan kriteria kueri. Kemajuan AI telah meningkatkan kebutuhan akan metodologi pencarian yang lebih akurat, peka konteks, dan efisien, sehingga memunculkan aplikasi pencarian semantik di mana-mana.
Pencarian semantik melampaui keterbatasan pencarian berbasis kata kunci tradisional dengan memahami niat dan makna kontekstual dari kueri, sehingga menghasilkan hasil yang lebih relevan dan presisi.
Untuk membangun aplikasi pencarian semantik ujung-ke-ujung, Anda harus memahami beberapa konsep kunci seperti Embedding, Basis Data Vektor, Metrik Jarak, dan sebagainya, serta mempelajari cara menggunakan produk/layanan seperti Pinecone dan GPT dari OpenAI untuk membangun dan menerapkan aplikasi pencarian semantik ujung-ke-ujung.
Di akhir blog ini, pembaca akan memperoleh pemahaman menyeluruh tentang prinsip-prinsip pencarian semantik, embedding, dan peran basis data vektor, serta akhirnya mempelajari cara mengimplementasikan pencarian semantik di Python menggunakan:
Jika Anda penasaran untuk belajar lebih jauh dengan latihan langsung, lihat kursus kami, Vector Databases for Embeddings with Pinecone.
Embedding adalah konsep inti dalam machine learning. Ini menjembatani kesenjangan antara dunia bahasa dan pemahaman manusia yang kompleks dan bernuansa dengan representasi matematis yang presisi dari dunia manusia ke dalam angka.
Data tidak terstruktur, seperti teks, gambar, audio, dan file video, tidak mengikuti format yang spesifik dan terorganisasi, sehingga menimbulkan tantangan untuk penyimpanan dan pemrosesan dalam basis data konvensional. Analisisnya untuk aplikasi machine learning dan AI sering kali memerlukan transformasi menjadi representasi numerik multi-dimensi melalui vektor embedding. Proses mengonversi data tidak terstruktur menjadi vektor numerik multi-dimensi disebut Embedding.
Embedding adalah representasi numerik multi-dimensi dari teks, gambar, atau jenis data tidak terstruktur apa pun, yang memungkinkan mesin mempelajari kompleksitas komunikasi manusia, hubungan antar konsep, atau pola dalam data dengan cara yang efisien secara komputasi dan kaya konteks.
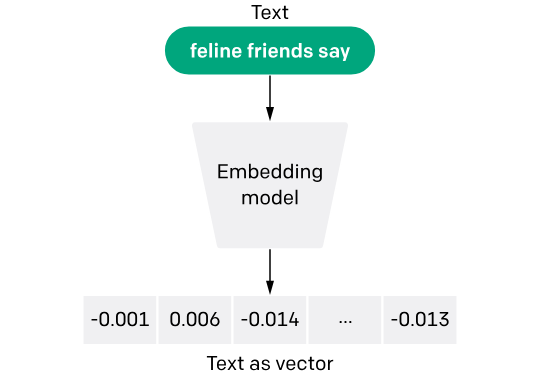
Model embedding teks dan kode OpenAI (Sumber Gambar)
Gagasan inti di balik model embedding adalah bahwa item serupa dapat direpresentasikan oleh titik-titik yang berdekatan satu sama lain dalam ruang berdimensi tinggi. Konsep ini memungkinkan penangkapan hubungan yang rumit dalam data, seperti sinonim, analogi, atau bahkan koneksi yang lebih abstrak, dengan mereduksi kompleksitas besar dari bahasa manusia atau tipe data lain ke dalam bentuk yang dapat diolah mesin.
Misalnya, dalam data teks, kata-kata diubah menjadi vektor (angka), yang pada dasarnya adalah larik angka. Vektor-vektor ini merangkum esensi makna, penggunaan, dan konteks kata-kata dalam jalinan pemahaman model bahasa.
Panjang vektor, sebagaimana dikembalikan oleh model embedding, bergantung pada model yang Anda gunakan. Sebagai contoh, jika Anda menggunakan model embedding OpenAI, panjang vektornya akan selalu `1536`.
Di balik layar, model embedding hanyalah sebuah Model Jaringan Saraf raksasa yang dilatih pada korpus data yang sangat besar. Model ini belajar menetapkan vektor ke data masukan sedemikian rupa sehingga hubungan geometris antar vektor mencerminkan hubungan semantik atau konseptual antar instance data.
Sebagai contoh, dalam model embedding yang terlatih dengan baik, vektor yang merepresentasikan kata "king" dikurangi vektor untuk "man" lalu ditambah vektor untuk "woman" mungkin menghasilkan vektor yang sangat dekat dengan vektor yang merepresentasikan "queen." Kemampuan melakukan operasi aritmetika dengan makna ini menunjukkan secara kuat bagaimana embedding menangkap semantik dasar bahasa.
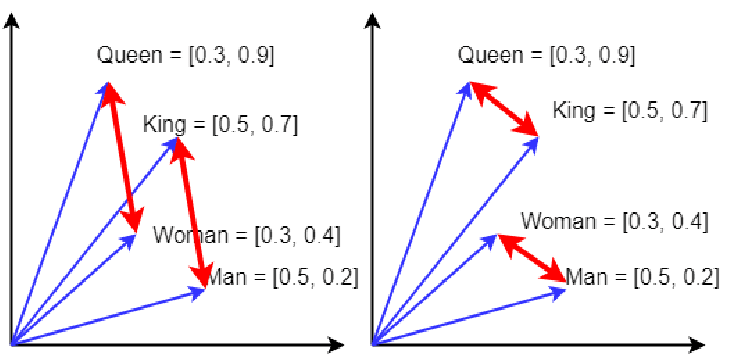
Contoh klasik king + woman − man ≈ queen pada embedding kata berbasis saraf (Sumber Gambar)
Jika Anda mau, Anda bisa melatih model embedding sendiri, tetapi itu mungkin memerlukan pengumpulan data dalam jumlah sangat besar dan sumber daya untuk melatih model jaringan saraf raksasa yang biayanya bisa jutaan dolar dan membutuhkan waktu beberapa bulan untuk dilatih.
Alternatif lain yang lebih praktis adalah menggunakan semacam model embedding pra-latih. Ada banyak model embedding open-source yang tersedia di Hugging Face yang dapat Anda unduh dan gunakan secara lokal, atau Anda dapat menggunakan model proprietari yang disediakan oleh perusahaan seperti OpenAI, Anthropic, Cohere, dan lain-lain.
Dalam blog ini, kita akan menggunakan model OpenAI `text-embedding-ada-002`, yang harganya cukup terjangkau ($0,00010 per 1K token). Ini berarti buku 1000 halaman akan menelan biaya kira-kira kurang dari $1 saja.
Embedding sangat penting untuk beragam aplikasi di berbagai domain. Dalam pencarian semantik, embedding memungkinkan sistem melampaui pencocokan kata kunci sederhana, sehingga dapat mengambil hasil yang terkait secara kontekstual dengan kueri, meskipun kata-kata persisnya tidak digunakan dalam konten. Kemampuan ini secara drastis meningkatkan relevansi dan akurasi hasil pencarian, membuat penemuan informasi menjadi lebih intuitif dan efisien.
Embedding tidak terbatas pada teks. Embedding gambar, misalnya, memungkinkan kemajuan serupa dalam visi komputer, memungkinkan mesin mengenali objek, adegan, dan aktivitas dalam gambar dan video dengan memahaminya dalam ruang vektor berdimensi tinggi. Pemahaman ini bukan sekadar mengidentifikasi piksel, tetapi menangkap esensi dari apa yang diwakili piksel tersebut.
Model embedding bukan hanya transformatif tetapi juga sangat berguna karena mengonversi kompleksitas data dunia nyata ke dalam bahasa (vektor numerik) yang dapat dipahami dan dijalankan oleh mesin, sehingga memungkinkan berbagai aplikasi yang bergantung pada pemahaman semantik mendalam dan pemrosesan data yang cerdas.
Untuk mempelajari lebih lanjut tentang Embedding, lihat Introduction to Text Embeddings with the OpenAI API.
Basis data vektor merepresentasikan kategori penyimpanan data non-relasional yang relatif baru, yang semakin populer karena kemajuan terbaru dalam AI generatif dan model bahasa besar.
Berbeda dengan basis data relasional tradisional yang mengorganisasi data dalam baris dan kolom atau jenis penyimpanan data non-relasional lain seperti Document Database yang mengorganisasi data sebagai objek json atau xml, basis data vektor dirancang untuk menyimpan dan menangani data vektor multi-dimensi secara efisien.
Basis data vektor adalah basis data khusus yang dioptimalkan untuk menyimpan dan mengkueri vektor. Vektor pada dasarnya adalah larik angka yang merepresentasikan titik data dalam ruang multi-dimensi.
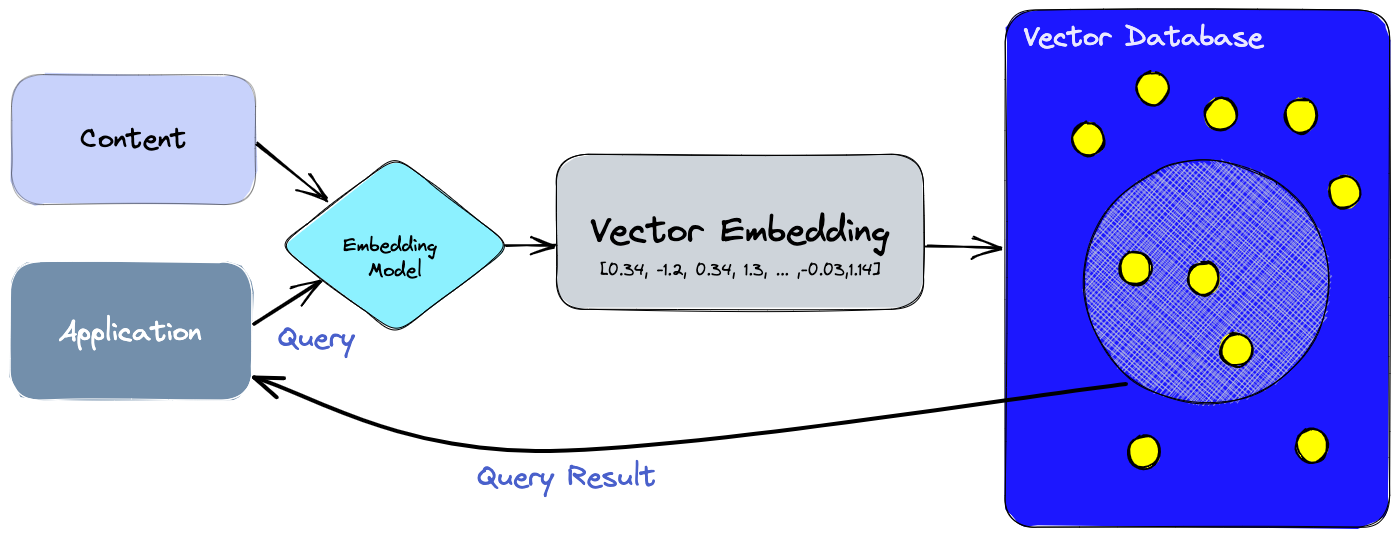
Keunggulan utama basis data vektor adalah kemampuannya melakukan pencarian kemiripan secara efisien. Artinya, basis data dapat dengan cepat menemukan item yang "paling dekat" dengan item kueri tertentu, menurut ukuran jarak atau kemiripan tertentu.
Kemampuan ini krusial untuk aplikasi seperti sistem rekomendasi, di mana Anda mungkin ingin menemukan produk yang mirip dengan yang disukai pengguna, atau dalam aplikasi pencarian semantik, di mana tujuannya adalah menemukan dokumen yang secara semantik terkait dengan frasa kueri.
Basis data vektor menggunakan berbagai algoritma untuk pengindeksan dan pencarian vektor, yang sering mengandalkan teknik Approximate Nearest Neighbor (ANN).
Pencarian semantik merepresentasikan lompatan signifikan dalam meningkatkan cara mesin pencari memahami dan memproses kueri pengguna. Berbeda dari metode pencarian tradisional yang berfokus pada kecocokan literal antara teks kueri dan konten dokumen, pencarian semantik menyelami niat dan makna kontekstual di balik sebuah kueri.
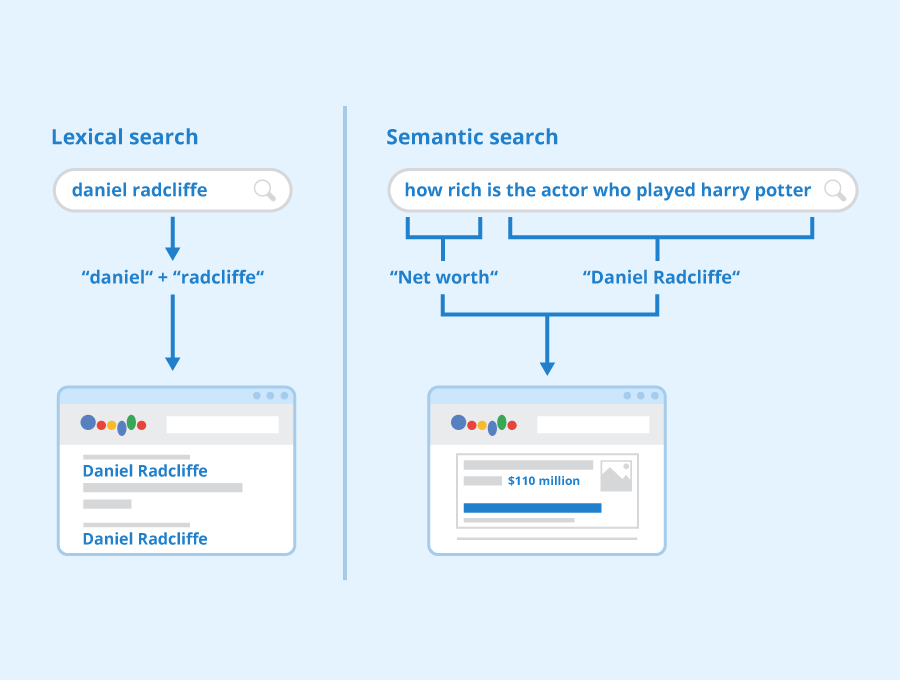
Pencarian Leksikal vs. Pencarian Semantik (Sumber Gambar)
Evolusi teknologi pencarian menuju pencarian semantik dalam satu dekade terakhir didorong oleh beberapa faktor. Pencarian suara, yang didukung oleh asisten virtual seperti Siri, Alexa, dan Google Assistant, sangat bergantung pada pemrosesan bahasa alami untuk memahami dan mengeksekusi perintah pengguna.
Sifat percakapan pada pencarian suara menuntut pemahaman konteks, sehingga mesin pencari harus menangkap makna di balik kalimat utuh atau frasa yang lebih panjang.
Kompleksitas bahasa manusia merupakan hambatan besar bagi aplikasi pencarian berbasis leksikal tradisional, yang tengah diatasi dengan cepat oleh pencarian semantik. Ada ribuan kata dalam bahasa Inggris yang memiliki banyak makna dan makna sebenarnya bergantung pada konteks penggunaan kata tersebut. Kata-kata ini dikenal sebagai kata polisemi.
Sebagai contoh, kata seperti "table" bisa merujuk pada furnitur atau susunan data, bergantung pada konteksnya.
Bangkitnya model bahasa besar (LLM) multimodal adalah pendorong utama di balik ledakan popularitas aplikasi pencarian semantik. Pencarian semantik, yang bertujuan memahami niat pencari dan makna kontekstual istilah sebagaimana muncul dalam ruang data yang dapat dicari, sangat ditingkatkan oleh kapabilitas LLM multimodal.
Seiring evolusi model-model ini, mereka tidak hanya memahami dan menghasilkan teks, tetapi juga menafsirkan dan menciptakan konten lintas berbagai format, termasuk gambar, audio, dan video. Kemajuan ini berarti pencarian kini dapat melampaui sekadar pencocokan kata kunci untuk memahami nuansa bahasa, subtilitas berbagai media, dan hubungan kompleks antar konsep.
Misalnya, sebuah kueri pencarian dapat dibuat menggunakan bahasa alami, dan sistem dapat mengembalikan hasil yang tidak hanya berbasis teks tetapi juga mencakup gambar, klip video, atau potongan audio yang relevan, semuanya dipahami dan dikurasi oleh AI untuk sesuai dengan niat kueri.
Pencarian semantik memiliki berbagai aplikasi di beragam domain, menawarkan manfaat besar dalam meningkatkan relevansi dan ketepatan hasil pencarian:
Tertarik mempelajari lebih lanjut tentang Basis Data Vektor? Lihat panduan komprehensif ke basis data vektor terbaik ini.
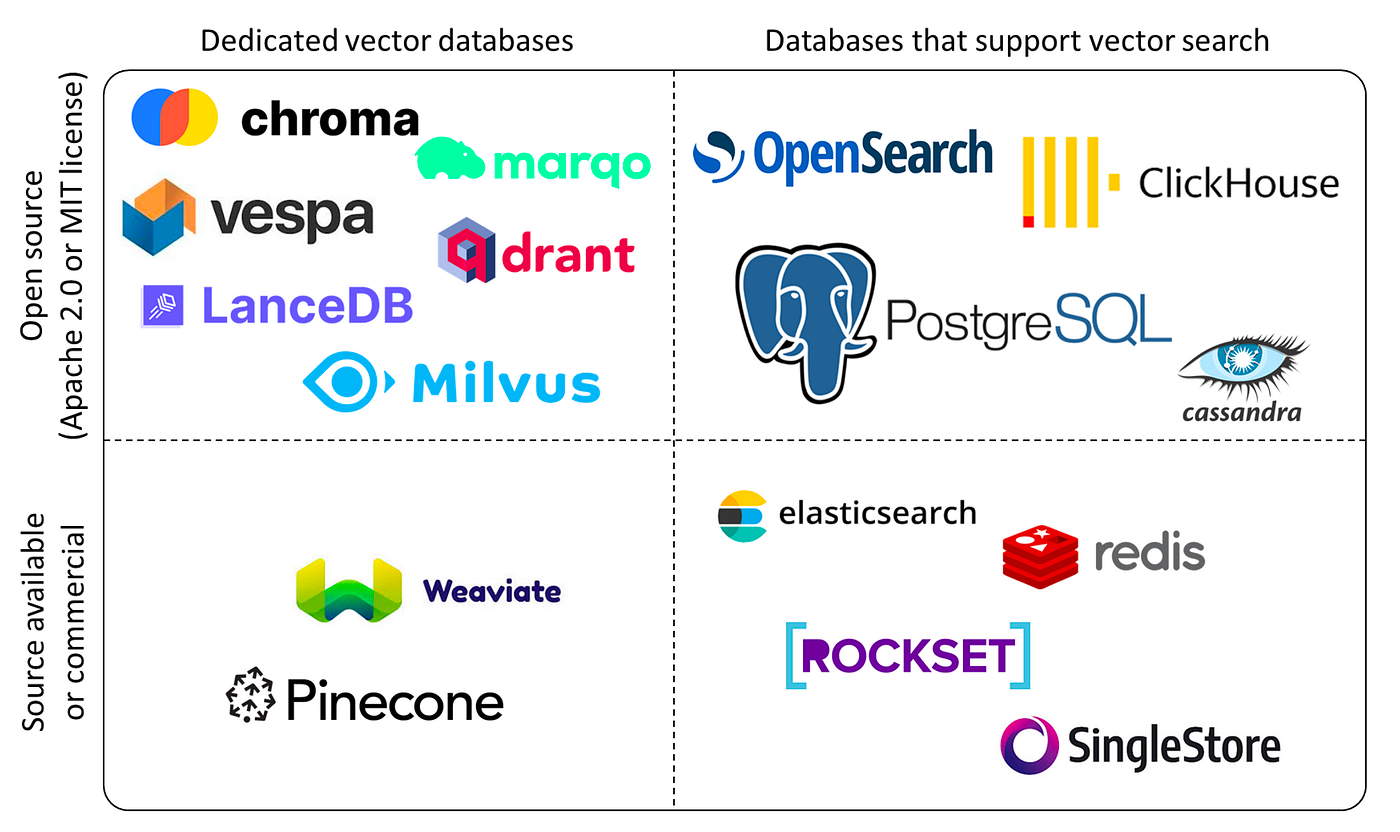
Lanskap basis data vektor (Sumber Gambar)
Pinecone adalah basis data vektor khusus yang dirancang untuk menangani data kompleks berdimensi tinggi. Pinecone menawarkan kemampuan pencarian dan pengindeksan tingkat lanjut, memungkinkan engineer dan ilmuwan data membangun dan menjalankan proyek machine learning berskala besar secara efisien.
Jika Anda ingin mendalami Pinecone, lihat Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide di Datacamp.
OpenAI menyediakan akses ke semua model melalui platform API-nya. Ini mencakup model GPT, DALL-E, dan Whisper yang populer, selain tiga model embedding.
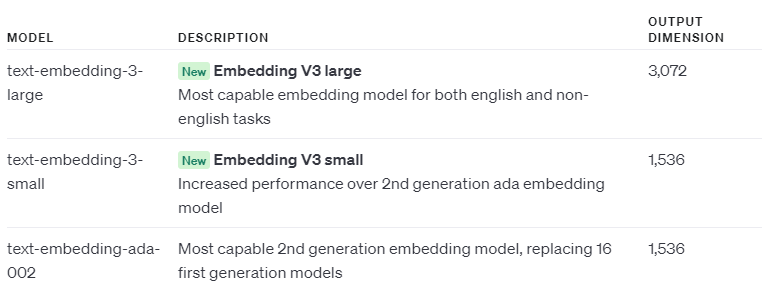
API ini dapat diakses melalui permintaan HTTP, sehingga kompatibel dengan bahasa pemrograman apa pun yang mampu berkomunikasi melalui HTTP.
Pengguna Python juga dapat menggunakan pustaka openai untuk berinteraksi dengan API ini, yang membuatnya semakin sederhana dan mudah digunakan. Pustaka ini dapat dipasang menggunakan pip install openai.
Memanfaatkan OpenAI API di Python dengan pustaka openai hanya memerlukan sedikit kode.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)Keluaran: (dipangkas)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
Temukan bagaimana ChatGPT dan model bahasa besar merevolusi lanskap digital! Selami cheat sheet Datacamp untuk menguasai hal-hal penting dalam memanfaatkan salah satu API AI paling kuat yang tersedia - OpenAI API.
Setelah Anda mendaftar akun OpenAI, langsung menuju ke https://platform.openai.com/api-keys
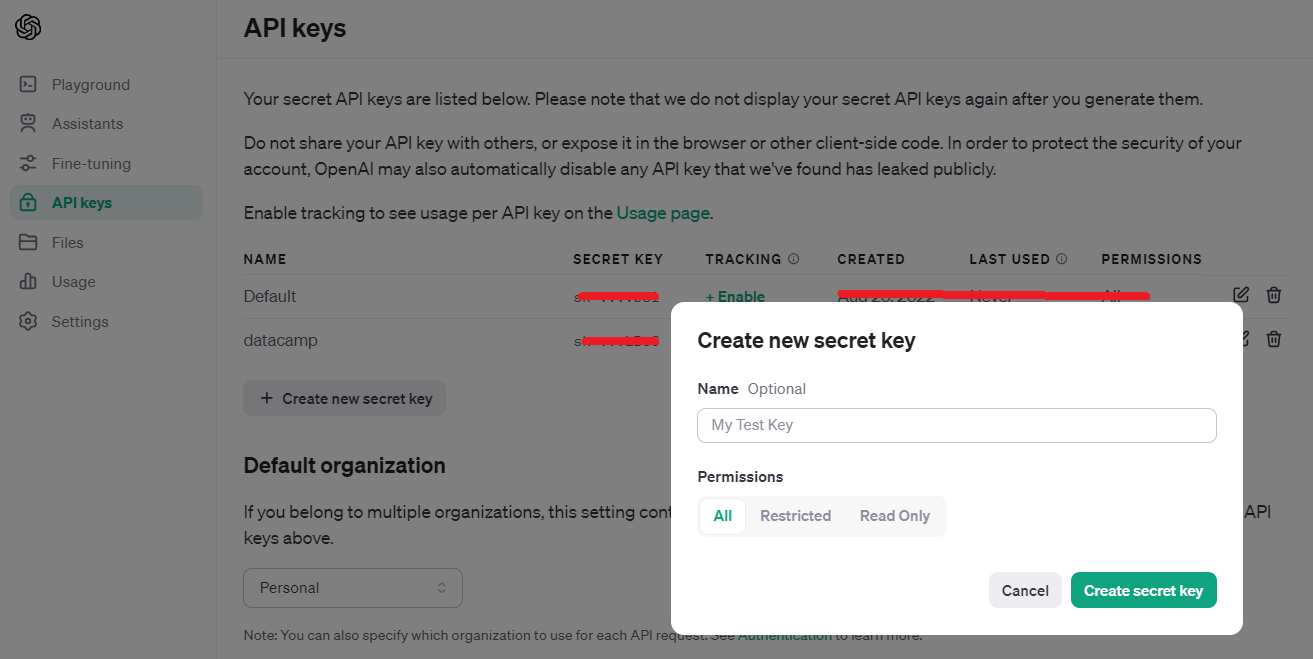
API Keys platform.openai.com
Untuk Pinecone, masuk ke akun Anda dan klik API Keys. Anda dapat mengeklik tombol `Click API Key` di sudut kanan.
Berbeda dengan OpenAI, di Pinecone, Anda tidak harus menyalin kunci API saat membuatnya karena ada ikon salin di bawah kolom Actions yang dapat Anda gunakan kapan saja.
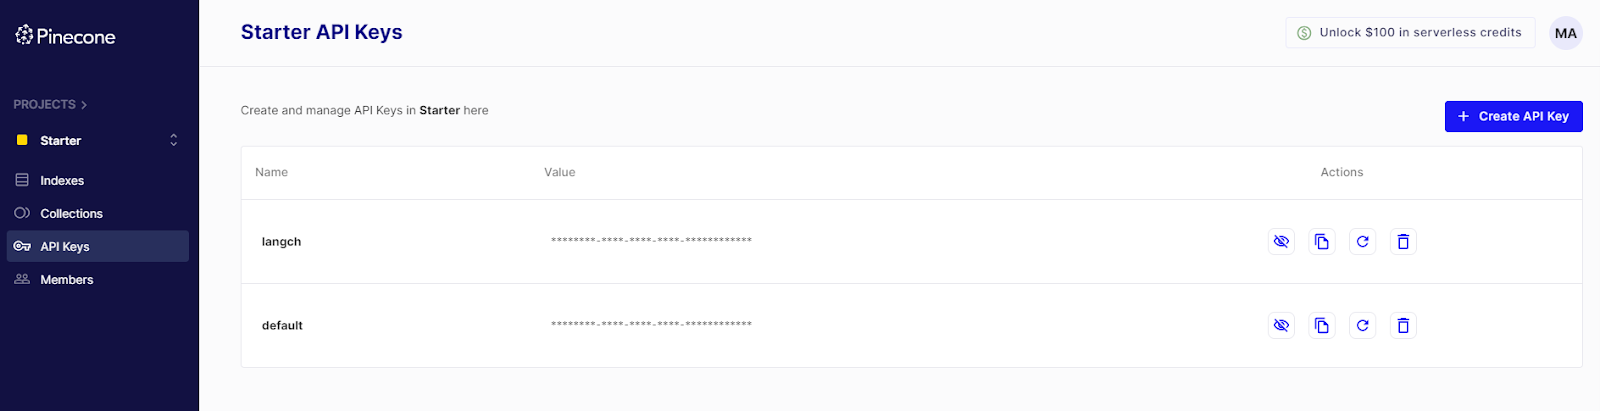
API Keys - Pinecone
Setelah mendapatkan kunci API OpenAI dan Pinecone, tetapkan ke variabel di Notebook atau setel sebagai variabel lingkungan menggunakan modul os di Python.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Untuk mengimplementasikan tutorial ini, Anda perlu memasang pustaka berikut menggunakan pip. Anda harus menggunakan versi yang persis sama, jika tidak, kode di bawah ini tidak akan berfungsi.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28Pustaka pinecone-datasets menyertakan beberapa dataset yang sudah di-embed dengan model embedding-ada-002 dari OpenAI.
Untuk contoh ini, kita akan menggunakan dataset `wikipedia-simple-text-embedding-ada-002-100K`, dengan mengambil sampel 5.000 dari 100.000 dokumen dan embedding-nya.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
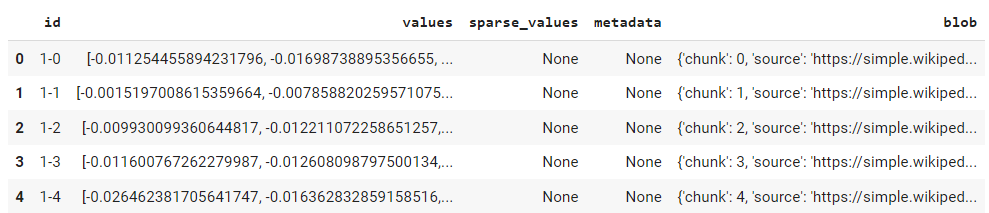
Dataset Contoh
Di Pinecone, indeks merepresentasikan unit organisasi tertinggi untuk data vektor. Indeks menangani penyimpanan vektor, memproses kueri untuk vektor yang disimpan, dan melakukan berbagai operasi pada data vektor yang dimilikinya.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
Kode di atas menginisialisasi instance Pinecone, membuat indeks bernama semantic-search-demo. Pada titik ini, Anda juga akan dapat melihat indeks ini di UI.
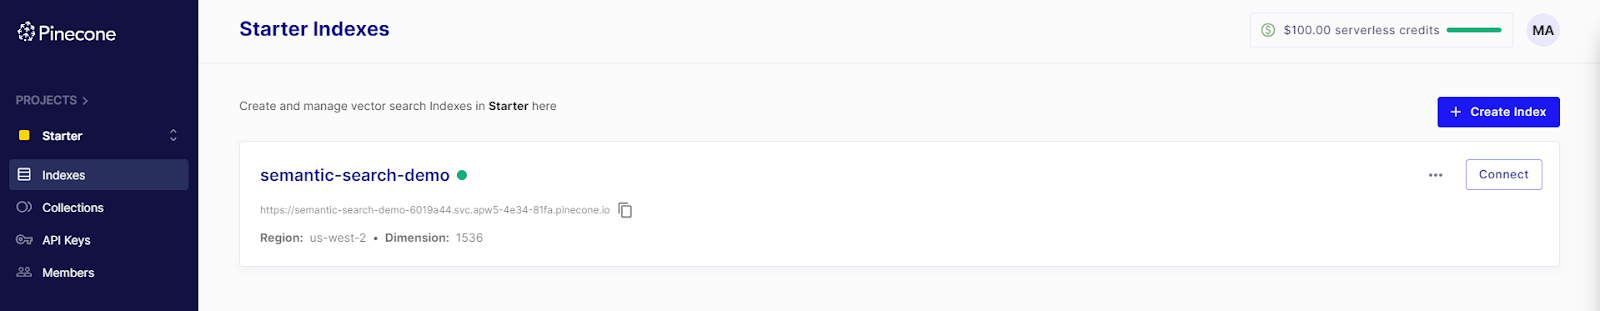
Karena data kita sudah menyertakan representasi embedding, kita dapat melewati proses embedding dan langsung melanjutkan untuk menyisipkan data ke dalam indeks yang baru dibuat.
Untuk dataset yang tidak memiliki representasi embedding, pertama-tama lakukan embedding data mentah menggunakan OpenAI API (lihat langkah 5 di bawah untuk petunjuk).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Setelah kode berjalan dengan sukses, Anda juga dapat melihat datanya di antarmuka pengguna.
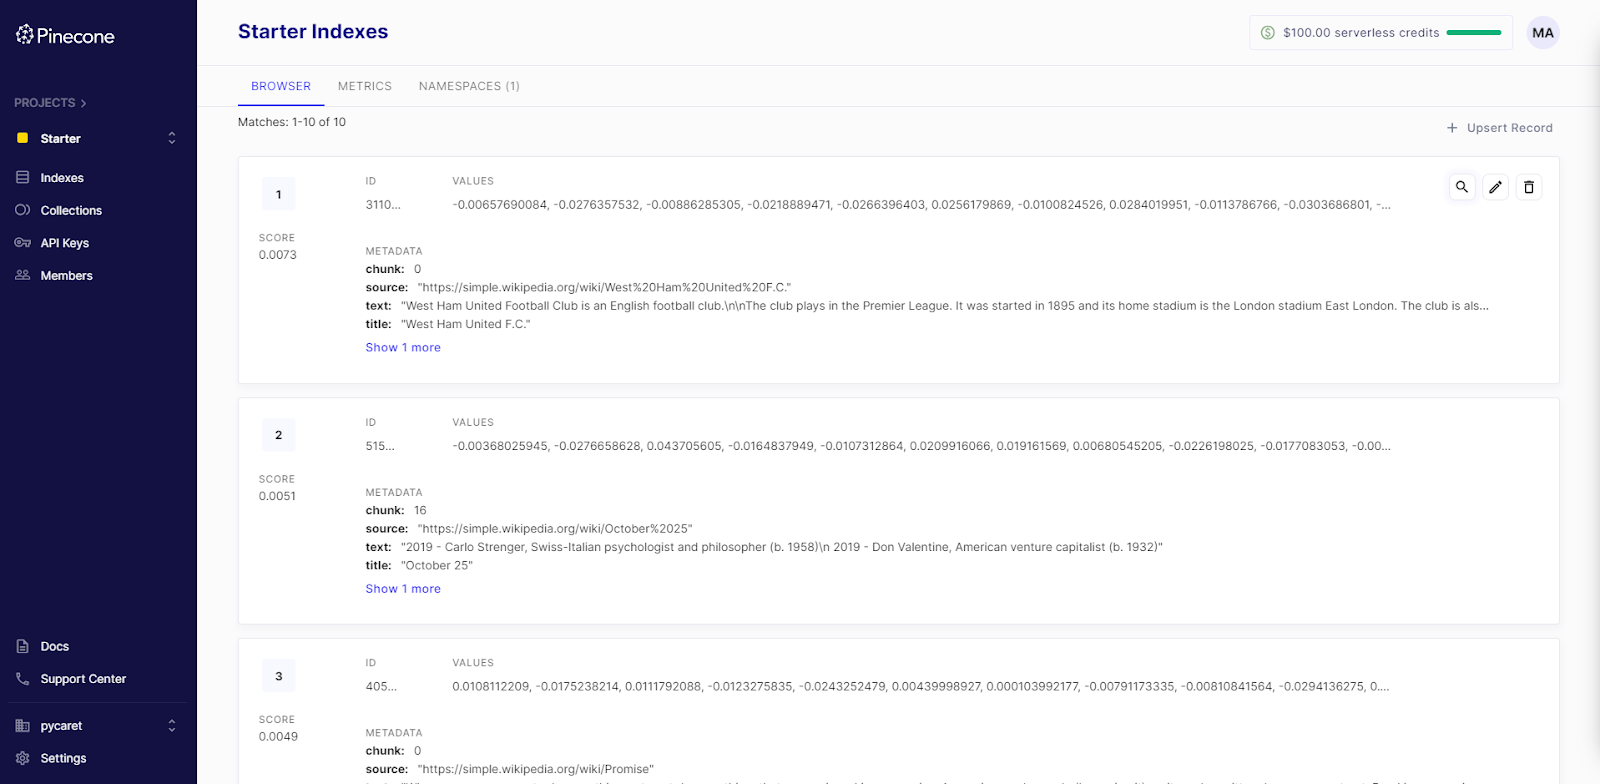
Data atau kueri baru perlu di-embed dengan model yang sama untuk memastikan dimensi vektor cocok. Karena dataset kita menggunakan text-embedding-ada-002, kita akan membuat fungsi yang memanfaatkan OpenAI API untuk melakukan embedding kueri baru menggunakan model yang sama.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Keluaran:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
Panjang result adalah 1536, selaras dengan dimension yang ditentukan saat pembuatan indeks.
Mengirim kueri pencarian sangatlah mudah:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)Keluaran:
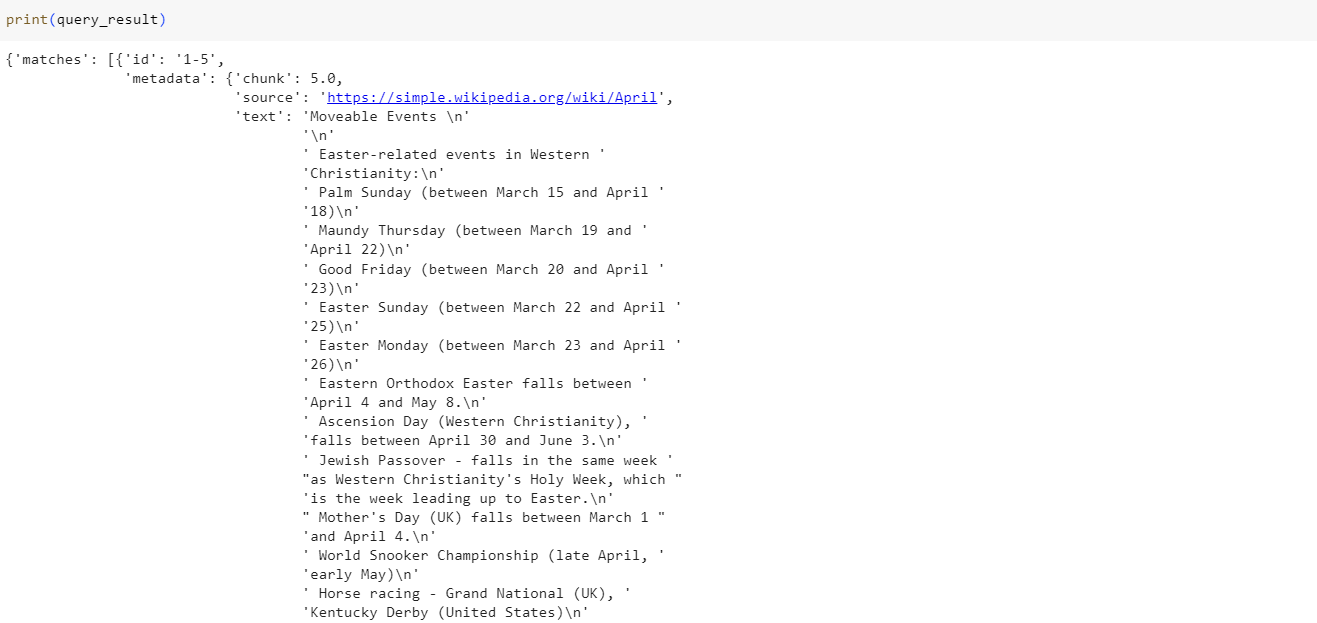
query_result menghasilkan kamus dengan daftar 3 kecocokan teratas yang sesuai dengan kueri pengguna. Kecocokan Top N ini sekarang dapat dimanfaatkan untuk tugas hilir, seperti memberikan konteks untuk prompt dalam skenario Retrieval Augmented Generation (RAG) atau membangun Chatbot.
Dalam tutorial ini, kami telah memperkenalkan beberapa konsep dasar penting, seperti embedding dan basis data vektor, untuk memahami mekanisme lengkap aplikasi pencarian semantik.
Dengan hadirnya AI Generatif dan evolusi berkelanjutan LLM Multimodal, kekuatan pencarian semantik telah meluas, menawarkan presisi yang belum pernah ada dan pemahaman terhadap kompleksitas serta nuansa data tidak terstruktur.
Dengan memanfaatkan kapabilitas Pinecone, basis data vektor mutakhir, dan model embedding canggih dari OpenAI, para pengembang dan ilmuwan data kini memiliki alat di ujung jari mereka untuk membuat aplikasi pencarian semantik yang melampaui metodologi pencarian berbasis kata kunci tradisional.
Melalui panduan ini, kami juga mengeksplorasi signifikansi embedding dalam menjembatani kesenjangan antara kompleksitas bahasa manusia dan representasi numerik yang dibutuhkan untuk machine learning, mengungkap bagaimana representasi ini memungkinkan mesin memahami seluk-beluk konteks dan niat.
Jelas bahwa masa depan pencarian terletak pada pemahaman bahasa dan bentuk data tidak terstruktur lain yang didukung oleh AI. Baik untuk e-niaga, penemuan konten, dukungan pelanggan, atau manajemen pengetahuan, prinsip dan praktik yang diuraikan dalam blog ini menawarkan cetak biru dasar untuk memanfaatkan kekuatan pencarian semantik guna menciptakan pengalaman pencarian yang lebih cerdas, responsif, dan berpusat pada pengguna.
Jika Anda ingin mempelajari lebih lanjut tentang membangun aplikasi Pencarian Semantik menggunakan Pinecone, lihat Semantic Search with Pinecone code-along, atau jika Anda tertarik mempelajari lebih lanjut tentang fungsionalitas yang mendasari aplikasi AI populer seperti ChatGPT, lihat kursus Working with the OpenAI API. Selain itu, jangan lupa untuk melihat kursus kami, Vector Databases for Embeddings with Pinecone.
Pelajari Lebih Lanjut tentang Bekerja dengan OpenAI!
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



