Curso
Trabalhar com a API da OpenAI
3 h
172.6K
O cenário de dados muda o tempo todo e, somado ao avanço acelerado da IA generativa nos últimos dois anos, redefiniu os rumos da busca semântica, impulsionando cada vez mais a popularidade de aplicações desse tipo.
Busca e recuperação é o processo de localizar e obter informações específicas em um banco de dados ou coleção maior com base em critérios de consulta. O avanço da IA elevou a demanda por métodos de busca mais precisos, conscientes de contexto e eficientes, o que levou ao surgimento de aplicações de busca semântica em todo lugar.
A busca semântica vai além das limitações das buscas tradicionais por palavra-chave ao compreender a intenção e o significado contextual das consultas, entregando resultados mais relevantes e precisos.
Para criar uma aplicação de busca semântica ponta a ponta, é essencial entender conceitos como embeddings, bancos de dados vetoriais, métricas de distância etc., além de aprender a usar produtos/serviços como Pinecone e o GPT da OpenAI para construir e implantar essas aplicações.
Ao final deste blog, você terá uma compreensão completa dos princípios de busca semântica, embeddings e do papel dos bancos de dados vetoriais, e por fim aprenderá a implementar busca semântica em Python usando:
Se você quer aprender ainda mais com exercícios práticos, confira nosso curso Vector Databases for Embeddings with Pinecone.
Embedding é um conceito central em aprendizado de máquina. Ele faz a ponte entre o mundo complexo e sutil da linguagem e compreensão humanas e a representação matemática precisa desse mundo em números.
Dados não estruturados, como textos, imagens, áudios e vídeos, não seguem um formato organizado específico, o que traz desafios de armazenamento e processamento em bancos de dados convencionais. Para análise em aplicações de machine learning e IA, muitas vezes é preciso transformá-los em representações numéricas multidimensionais por meio de vetores de embedding. O processo de converter dados não estruturados em vetores numéricos multidimensionais é chamado de embedding.
Embeddings são representações numéricas multidimensionais de textos, imagens ou qualquer tipo de dado não estruturado, permitindo que máquinas aprendam a complexidade da comunicação humana, os relacionamentos entre conceitos e padrões nos dados de forma computacionalmente eficiente e rica em contexto.
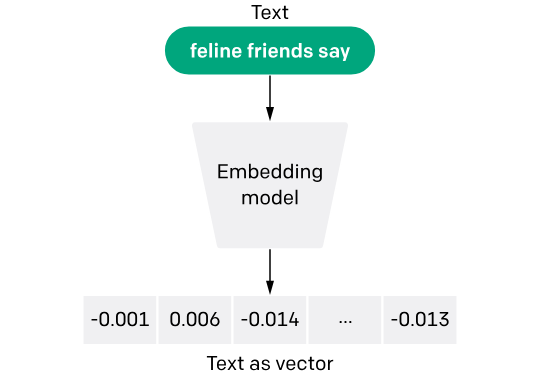
Modelo de embedding de texto e código da OpenAI (fonte da imagem)
A ideia central por trás dos modelos de embedding é que itens semelhantes podem ser representados por pontos próximos entre si em um espaço de alta dimensionalidade. Esse conceito permite capturar relações complexas nos dados, como sinônimos, analogias ou conexões mais abstratas, ao reduzir a enorme complexidade da linguagem humana (ou de outros tipos de dados) a uma forma com a qual as máquinas conseguem trabalhar.
Por exemplo, em dados de texto, palavras são transformadas em vetores (números), que são essencialmente arranjos de números. Esses vetores encapsulam a essência do significado, do uso e do contexto das palavras dentro da compreensão de um modelo de linguagem.
O tamanho do vetor retornado pelo modelo de embedding depende do modelo usado. Por exemplo, se você utiliza o modelo de embedding da OpenAI, o tamanho do vetor será sempre `1536`.
Por baixo dos panos, o modelo de embedding é apenas uma grande rede neural treinada em um corpus extremamente grande de dados. O modelo aprende a atribuir vetores aos dados de entrada de modo que a relação geométrica entre esses vetores reflita as relações semânticas ou conceituais entre as instâncias dos dados.
Por exemplo, em um bom modelo de embedding, o vetor que representa a palavra "king" menos o vetor de "man" mais o vetor de "woman" pode resultar em um vetor muito próximo ao que representa "queen". Essa capacidade de fazer operações aritméticas com significados demonstra como os embeddings capturam a semântica subjacente da linguagem.
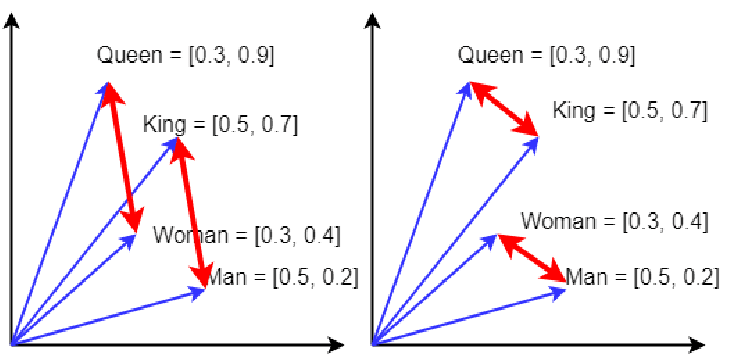
O exemplo clássico king + woman − man ≈ queen de embeddings de palavras (fonte da imagem)
Se quiser, você pode treinar seu próprio modelo de embedding, mas isso pode exigir coletar uma quantidade enorme de dados e recursos para treinar uma rede neural gigantesca, custando milhões de dólares e levando vários meses.
A alternativa mais prática é usar algum modelo de embedding pré-treinado. Existem muitos modelos open source no Hugging Face que você pode baixar e usar localmente, ou é possível usar modelos proprietários de empresas como OpenAI, Anthropic, Cohere etc.
Neste blog, vamos usar o modelo da OpenAI `text-embedding-ada-002`, com preço acessível (US$ 0,00010 por 1K tokens). Isso significa que um livro de 1000 páginas custaria algo em torno de menos de US$ 1.
Embeddings são fundamentais para inúmeras aplicações em diversos domínios. Em busca semântica, eles permitem ir além da simples correspondência por palavras-chave, recuperando resultados contextualmente relacionados à consulta, mesmo que as palavras exatas não estejam no conteúdo. Isso melhora drasticamente a relevância e a precisão dos resultados, tornando a descoberta de informações mais intuitiva e eficiente.
Embeddings não se limitam a texto. Embeddings de imagens, por exemplo, trazem avanços semelhantes em visão computacional, permitindo que máquinas reconheçam objetos, cenas e atividades em imagens e vídeos ao entendê-los em um espaço vetorial de alta dimensionalidade. Esse entendimento vai além de identificar pixels: é compreender a essência do que esses pixels representam.
Modelos de embedding não são apenas transformadores, mas extremamente úteis, pois convertem a complexidade dos dados do mundo real para uma linguagem (vetores numéricos) que as máquinas conseguem entender e usar, viabilizando uma ampla gama de aplicações que dependem de entendimento semântico profundo e processamento inteligente de dados.
Para saber mais sobre embeddings, confira o Introduction to Text Embeddings with the OpenAI API.
Bancos de dados vetoriais são uma categoria relativamente nova de armazenamento de dados não relacionais que vem ganhando popularidade graças aos avanços recentes em IA generativa e grandes modelos de linguagem.
Ao contrário de bancos relacionais tradicionais, que organizam dados em linhas e colunas, ou de outras formas não relacionais, como bancos de documentos, que organizam dados como objetos json ou xml, bancos vetoriais são projetados para armazenar e manipular dados vetoriais multidimensionais com eficiência.
Um banco de dados vetorial é um banco especializado e otimizado para armazenar e consultar vetores. Vetores são essencialmente arranjos de números que representam pontos de dados em um espaço multidimensional.
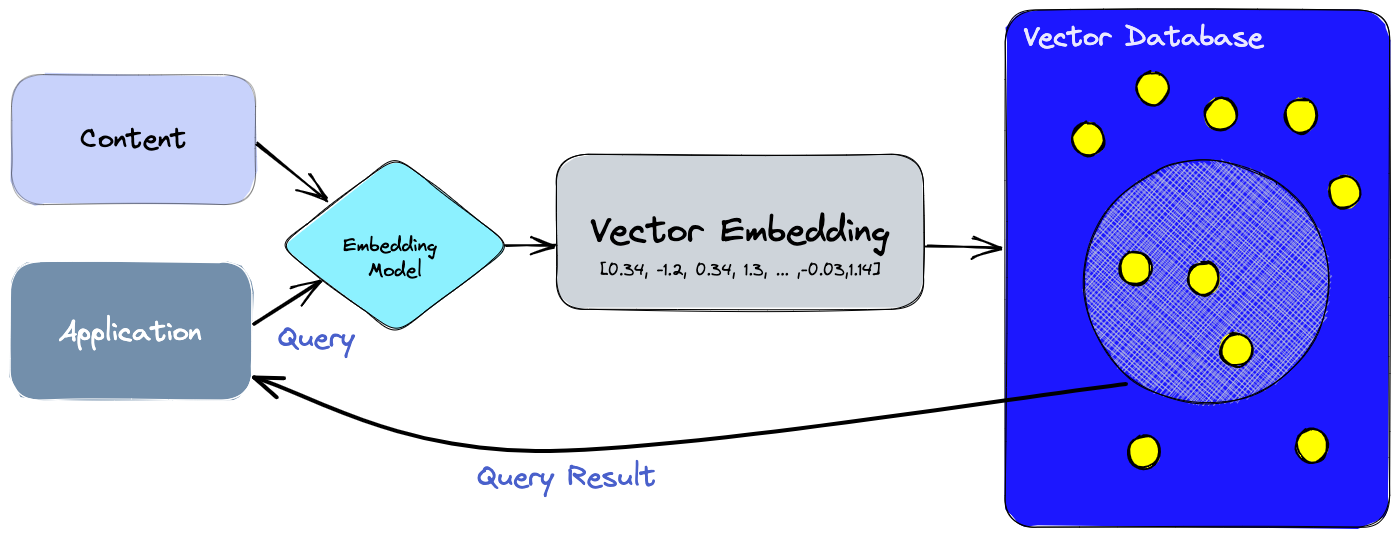
A grande vantagem de bancos vetoriais é a capacidade de executar buscas por similaridade de forma eficiente. Isso significa encontrar rapidamente, no banco, itens "mais próximos" de um item de consulta, segundo alguma medida de distância ou similaridade.
Essa capacidade é crucial em sistemas de recomendação, quando você quer encontrar produtos parecidos com os que o usuário gosta, ou em aplicações de busca semântica, nas quais o objetivo é localizar documentos semanticamente relacionados a uma frase de consulta.
Bancos vetoriais usam diversos algoritmos para indexar e buscar vetores, muitas vezes baseados em técnicas de busca de vizinhos mais próximos aproximados (ANN).
A busca semântica representa um salto importante na forma como mecanismos de busca entendem e processam consultas dos usuários. Diferente dos métodos tradicionais, focados em correspondências literais entre o texto da consulta e o conteúdo dos documentos, a busca semântica investiga a intenção e o significado contextual por trás da consulta.
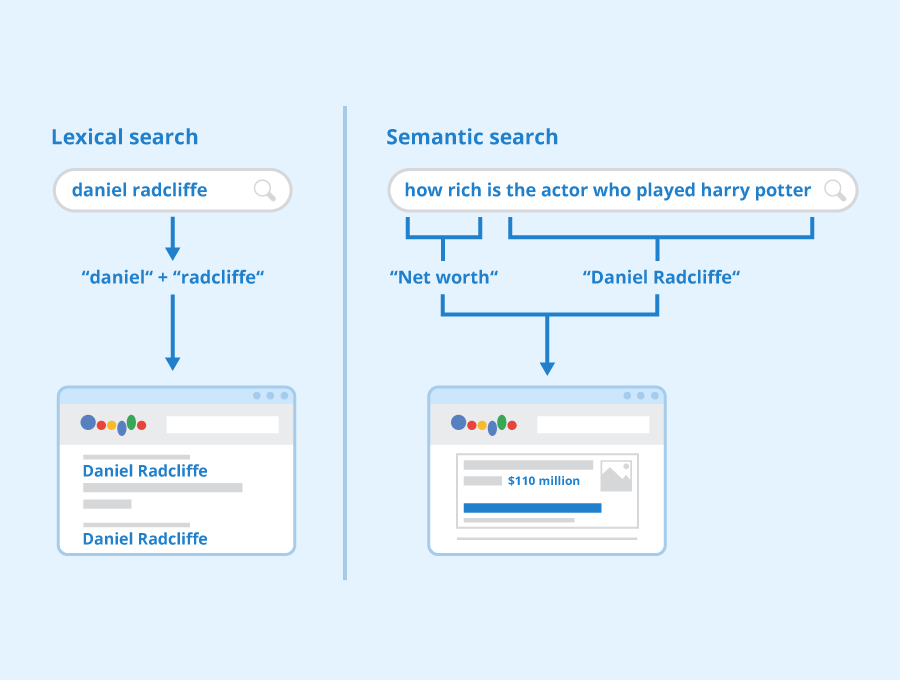
Busca lexical vs. busca semântica (fonte da imagem)
A evolução rumo à busca semântica na última década foi impulsionada por vários fatores. A busca por voz, com assistentes como Siri, Alexa e Google Assistant, depende fortemente de processamento de linguagem natural para entender e executar comandos.
A natureza conversacional das buscas por voz exige compreensão de contexto, pedindo que os mecanismos entendam o significado de frases inteiras ou expressões mais longas.
A complexidade da linguagem humana é uma grande barreira para buscas lexicais tradicionais, que a busca semântica vem superando rapidamente. Há milhares de palavras em inglês com múltiplos significados, cujo sentido depende do contexto em que foram usadas. Essas palavras são conhecidas como polissêmicas.
Por exemplo, a palavra "table" pode se referir a um móvel ou a uma estrutura de dados, dependendo do contexto.
A ascensão dos grandes modelos de linguagem multimodais (LLMs) é um dos principais motores da popularidade explosiva das aplicações de busca semântica. A busca semântica, que busca entender a intenção do usuário e o significado contextual dos termos no espaço pesquisável, está sendo amplificada pelas capacidades dos LLMs multimodais.
À medida que esses modelos evoluem, eles não apenas entendem e geram texto, mas também interpretam e criam conteúdo em vários formatos, incluindo imagens, áudios e vídeos. Esses avanços permitem que as buscas vão além da correspondência por palavras-chave para compreender nuances de linguagem, sutilezas de diferentes mídias e relações complexas entre conceitos.
Por exemplo, uma consulta pode ser feita em linguagem natural, e o sistema pode retornar resultados não só de texto, mas também imagens, trechos de vídeo ou áudio relevantes, todos entendidos e selecionados pela IA para corresponder à intenção da consulta.
A busca semântica tem uma ampla gama de aplicações em vários setores, trazendo ganhos significativos na relevância e precisão dos resultados:
Quer aprender mais sobre bancos de dados vetoriais? Confira este guia completo dos melhores vector databases.
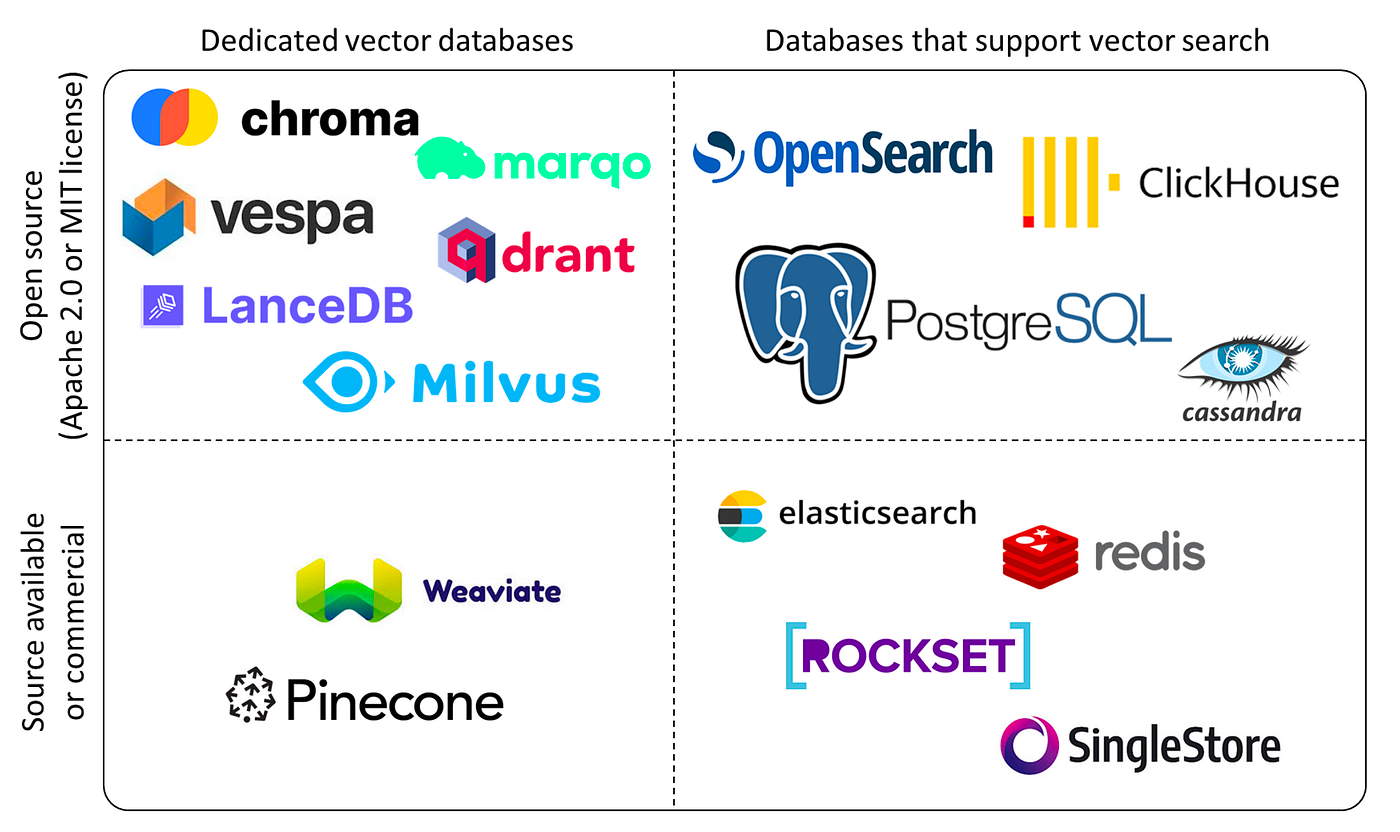
O panorama dos bancos de dados vetoriais (fonte da imagem)
Pinecone é um banco de dados vetorial especializado para lidar com dados complexos e de alta dimensionalidade. Ele oferece recursos avançados de busca e indexação, permitindo que engenheiros e cientistas de dados construam e operem projetos de machine learning em larga escala com eficiência.
Se quiser se aprofundar no Pinecone, confira o Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide no DataCamp.
A OpenAI oferece acesso a todos os modelos via sua API de plataforma. Isso inclui os populares GPT, DALL-E e Whisper, além de três modelos de embedding.
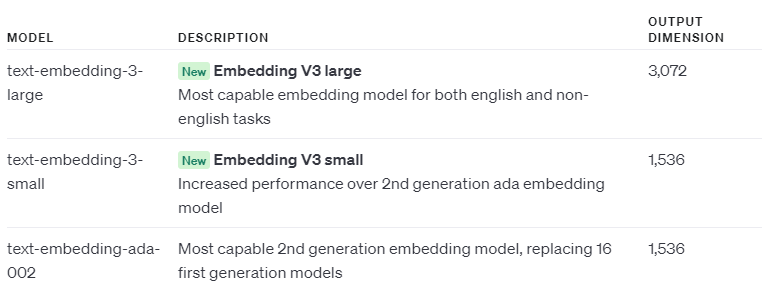
Essas APIs podem ser acessadas via requisições HTTP, garantindo compatibilidade com qualquer linguagem de programação que suporte comunicação HTTP.
Quem usa Python também pode utilizar a biblioteca openai para interagir com essas APIs, tornando o uso ainda mais simples. A instalação pode ser feita com pip install openai.
Utilizar a API da OpenAI em Python com a biblioteca openai requer pouquíssimas linhas de código.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)Saída: (truncada)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
Descubra como o ChatGPT e os grandes modelos de linguagem estão revolucionando o mundo digital! Mergulhe no cheat sheet do DataCamp para dominar o essencial de uma das APIs de IA mais poderosas: a OpenAI API.
Depois de criar sua conta na OpenAI, acesse https://platform.openai.com/api-keys
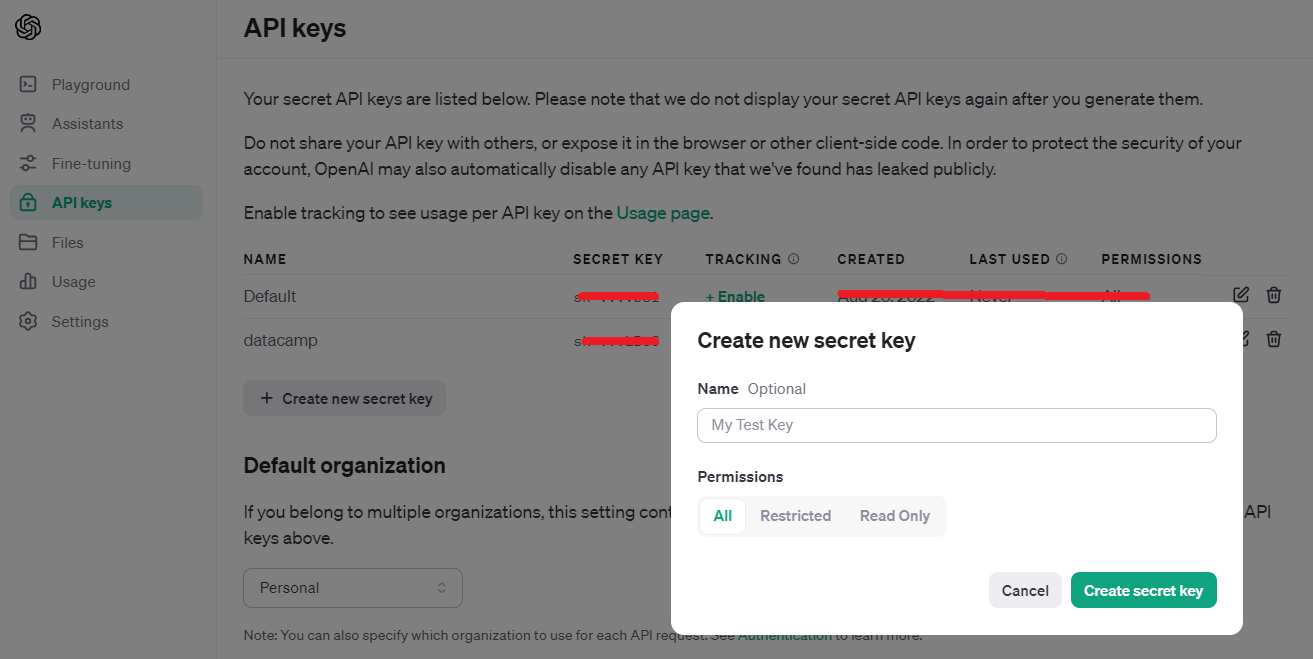
API Keys platform.openai.com
No Pinecone, faça login e clique em API Keys. Você pode clicar no botão `Click API Key` no canto direito.
Diferente da OpenAI, no Pinecone você não precisa necessariamente copiar a chave no momento da geração, pois há um ícone de cópia na coluna Actions que pode ser usado quando quiser.
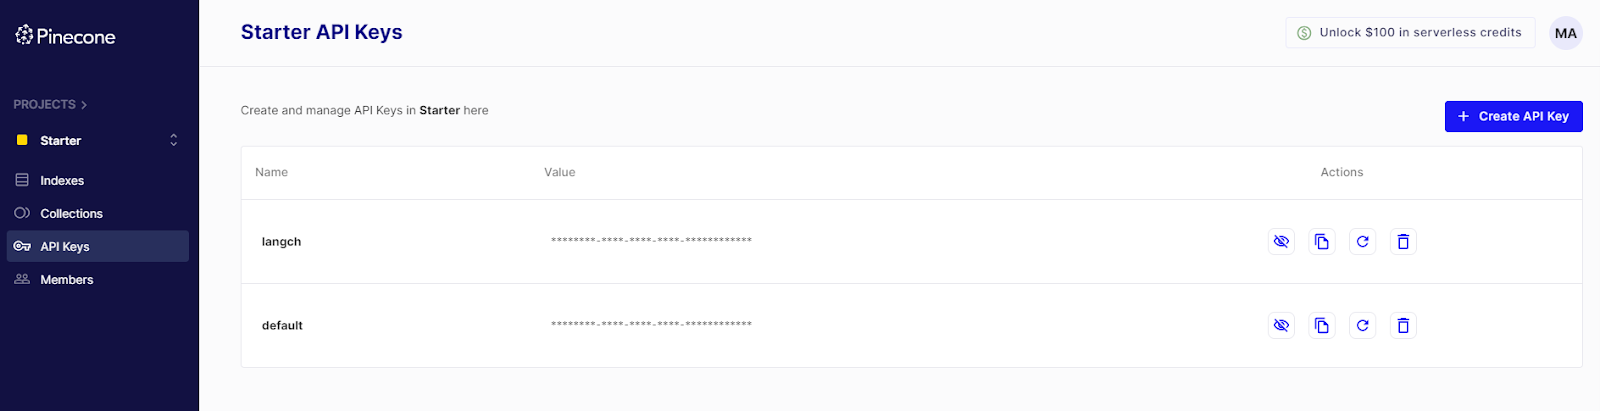
API Keys - Pinecone
Depois de obter as chaves de API da OpenAI e do Pinecone, atribua-as a variáveis no Notebook ou defina-as como variáveis de ambiente usando o módulo os do Python.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Para implementar este tutorial, instale as bibliotecas abaixo com pip. Use exatamente essas versões; caso contrário, o código não funcionará.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28A biblioteca pinecone-datasets inclui vários datasets já embedados com o modelo embedding-ada-002 da OpenAI.
Neste exemplo, vamos usar o dataset `wikipedia-simple-text-embedding-ada-002-100K`, amostrando apenas 5.000 de seus 100.000 documentos e seus embeddings.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
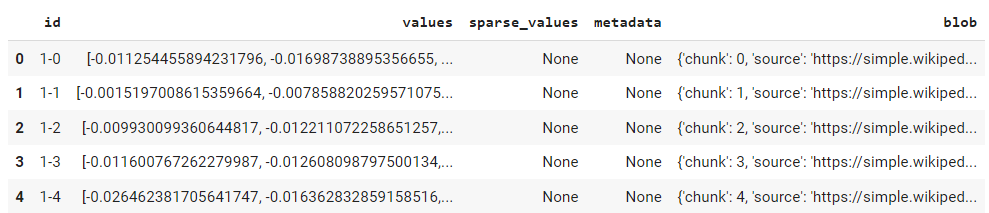
Conjunto de dados de exemplo
No Pinecone, um índice representa a unidade organizacional de mais alto nível para dados vetoriais. Ele armazena os vetores, processa consultas e executa diversas operações sobre os dados vetoriais.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
O código acima inicializa a instância Pinecone, criando um índice chamado semantic-search-demo. Nesse ponto, você também verá o índice na interface.
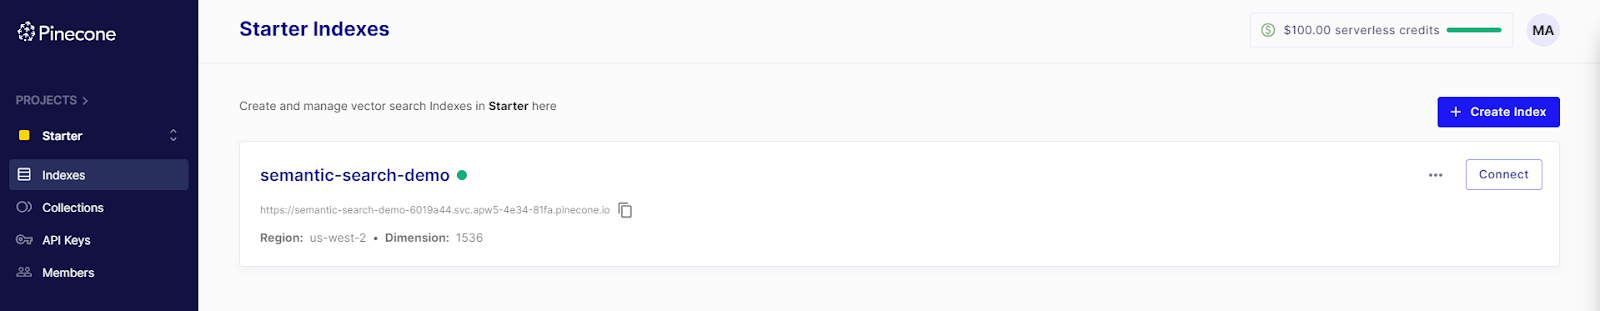
Como nossos dados já incluem representações embedadas, podemos pular o processo de embedding e ir direto à inserção no índice recém-criado.
Para datasets sem embeddings, primeiro gere embeddings dos dados brutos usando a API da OpenAI (veja o passo 5 abaixo).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Após a execução bem-sucedida, você também pode visualizar os dados na interface do usuário.
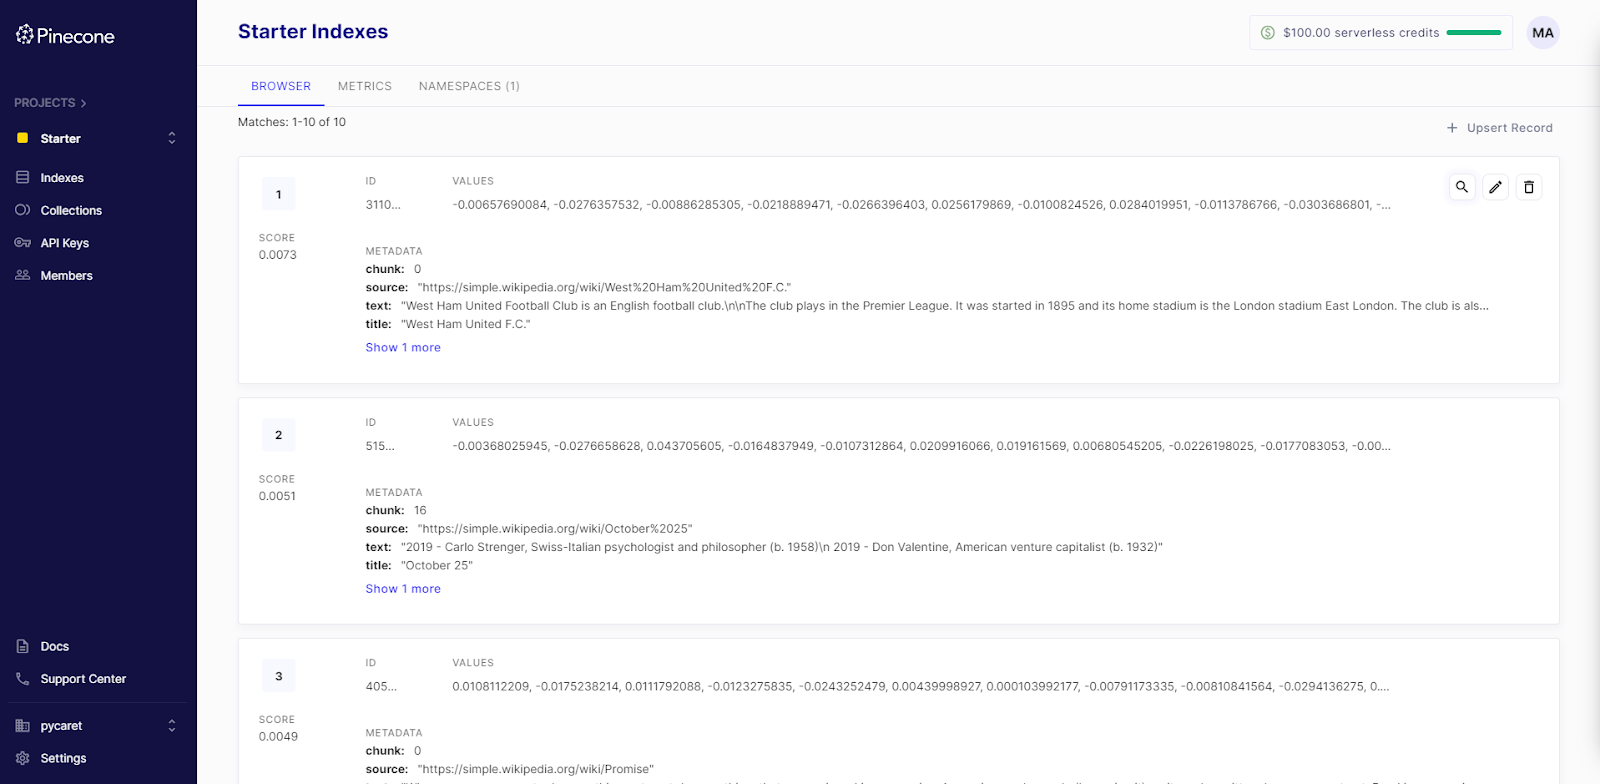
Novos dados ou consultas precisam ser embedados com o mesmo modelo para garantir a mesma dimensionalidade. Como nosso dataset usa o text-embedding-ada-002, vamos criar uma função que utiliza a API da OpenAI para embedar novas consultas com esse mesmo modelo.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Saída:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
O comprimento de result é 1536, em linha com a dimension especificada na criação do índice.
Enviar uma consulta de busca é bem direto:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)Saída:
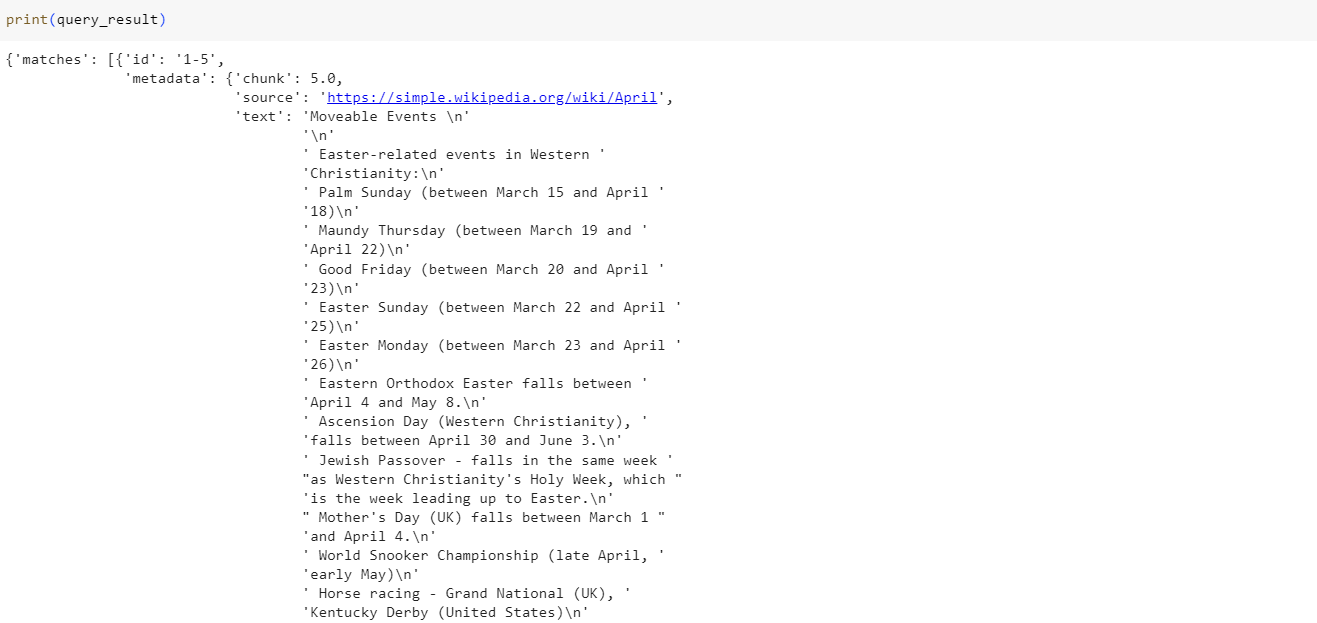
O query_result retorna um dicionário com a lista dos 3 melhores matches para a consulta do usuário. Esses Top N resultados podem ser usados em tarefas a jusante, como oferecer contexto para prompts em cenários de RAG (Retrieval Augmented Generation) ou para construir chatbots.
Neste tutorial, apresentamos conceitos fundamentais, como embeddings e bancos de dados vetoriais, para entender a mecânica completa das aplicações de busca semântica.
Com o avanço da IA generativa e a evolução contínua dos LLMs multimodais, o poder da busca semântica se expandiu, oferecendo uma precisão sem precedentes e compreensão das complexidades e nuances dos dados não estruturados.
Ao aproveitar as capacidades do Pinecone, um banco de dados vetorial de ponta, e os modelos de embedding sofisticados da OpenAI, desenvolvedores e cientistas de dados têm em mãos as ferramentas para criar aplicações de busca semântica que superam metodologias tradicionais baseadas em palavras-chave.
Ao longo deste guia, também exploramos a importância dos embeddings em fazer a ponte entre a complexidade da linguagem humana e as representações numéricas necessárias para machine learning, revelando como essas representações permitem que as máquinas compreendam sutilezas de contexto e intenção.
Fica claro que o futuro da busca está em entender a linguagem e outras formas de dados não estruturados impulsionadas por IA. Seja para e-commerce, descoberta de conteúdo, suporte ao cliente ou gestão do conhecimento, os princípios e práticas apresentados aqui oferecem um plano base para aproveitar o poder da busca semântica e criar experiências de busca mais inteligentes, responsivas e centradas no usuário.
Se quiser aprender mais sobre como construir aplicações de busca semântica com Pinecone, confira o Semantic Search with Pinecone code-along. Ou, se você quer entender melhor a funcionalidade por trás de aplicações populares de IA como o ChatGPT, confira o curso Working with the OpenAI API. E não esqueça de dar uma olhada no nosso curso Vector Databases for Embeddings with Pinecone.
Saiba mais sobre como trabalhar com a OpenAI!
Curso
Curso
Programa
Tutorial
Zoumana Keita
7 min
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
11 min
Tutorial
Moez Ali
12 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Abid Ali Awan
8 min