
Kurs
OpenAI API ile Çalışmak
3 sa
178.4K
Sürekli değişen veri dünyası ve son iki yılda Üretken Yapay Zekâdaki hızlı ilerleme, anlamsal aramanın yönünü yeniden şekillendirdi ve anlamsal arama uygulamalarının popülerliğini giderek artırdı.
Arama ve erişim, bir sorgu ölçütüne dayalı olarak daha büyük bir veritabanı veya koleksiyon içinden belirli bilgi ya da verileri bulma ve elde etme sürecidir. Yapay zekâdaki gelişmeler, daha doğru, bağlamı anlayan ve verimli arama yöntemlerine olan talebi artırdı ve her yerde anlamsal arama uygulamalarının ortaya çıkmasına yol açtı.
Anlamsal arama, sorguların niyetini ve bağlamsal anlamını kavrayarak, geleneksel anahtar kelime tabanlı aramaların sınırlarını aşar ve böylece daha alakalı ve isabetli sonuçlar sunar.
Uçtan uca bir anlamsal arama uygulaması oluşturmak için Gömlemeler (Embeddings), Vektör Veritabanları, Mesafe Ölçütleri gibi çeşitli temel kavramları anlamak ve ayrıca uçtan uca anlamsal arama uygulamaları oluşturup dağıtmak için Pinecone ve OpenAI’nin GPT’si gibi ürün/hizmetleri nasıl kullanacağınızı öğrenmek gerekir.
Bu blogun sonunda, okuyucular anlamsal aramanın ilkeleri, gömlemeler ve vektör veritabanlarının rolü hakkında kapsamlı bir anlayışa sahip olacak ve son olarak Python’da aşağıdakileri kullanarak anlamsal aramayı nasıl uygulayacaklarını öğrenecekler:
Ellerinizi kirleterek daha fazlasını öğrenmek isterseniz, kursumuza göz atın: Pinecone ile Gömlemeler için Vektör Veritabanları.
Gömleme, makine öğrenmesinde temel bir kavramdır. İnsan dilinin ve anlayışının karmaşık, nüanslı dünyası ile insan dünyasının sayılara dönüştürülen kesin, matematiksel temsili arasındaki boşluğu kapatır.
Metin, görsel, ses ve video dosyaları gibi yapılandırılmamış veriler, belirli ve düzenli bir formata uymaz; bu da geleneksel veritabanlarında depolama ve işlemeyi zorlaştırır. Makine öğrenmesi ve yapay zekâ uygulamaları için analizleri çoğu zaman vektör gömlemeleri yoluyla çok boyutlu sayısal temsillere dönüştürülmeyi gerektirir. Yapılandırılmamış verilerin çok boyutlu sayısal vektörlere dönüştürülmesi sürecine Gömleme denir.
Gömlemeler, metin, görsel ya da herhangi bir yapılandırılmamış verinin çok boyutlu sayısal temsilleridir; makinelerin insan iletişiminin karmaşıklığını, kavramlar arasındaki ilişkileri veya verideki örüntüleri hesaplamalı olarak verimli ve bağlamsal açıdan zengin bir şekilde öğrenmesini sağlar.
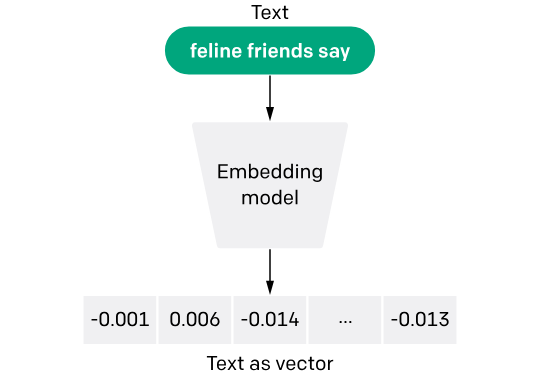
OpenAI’nin metin ve kod gömme modeli (Görsel Kaynağı)
Gömleme modellerinin arkasındaki temel fikir, benzer öğelerin yüksek boyutlu bir uzayda birbirine yakın noktalarla temsil edilebilmesidir. Bu kavram, eşanlamlılar, benzetmeler ya da daha soyut bağlantılar gibi verinin içindeki karmaşık ilişkilerin, insan dilinin ya da diğer veri türlerinin muazzam karmaşıklığını makinelerin çalışabileceği bir forma indirerek yakalanmasına olanak tanır.
Örneğin metin verilerinde, kelimeler vektörlere (sayılar) dönüştürülür; bunlar özünde sayı dizileridir. Bu vektörler, bir dil modelinin anlayışı içinde kelimelerin anlamını, kullanımını ve bağlamını özetler.
Gömleme modelinin döndürdüğü vektörün uzunluğu, kullandığınız modele bağlıdır. Örneğin OpenAI’nin gömme modelini kullanıyorsanız, vektörün uzunluğu her zaman `1536` olacaktır.
Arka planda, gömme modeli son derece büyük bir veri gövdesi üzerinde eğitilmiş dev bir Sinir Ağı Modelidir. Model, girdilere, bu vektörler arasındaki geometrik ilişkinin veri örnekleri arasındaki anlamsal veya kavramsal ilişkileri yansıtacağı şekilde vektörler atamayı öğrenir.
Örneğin, iyi eğitilmiş bir gömme modelinde, "king" kelimesini temsil eden vektörden "man" vektörü çıkarılıp "woman" vektörü eklendiğinde, sonucu "queen" vektörüne çok yakın bir vektör olabilir. Anlamlarla aritmetik işlemler yapabilme yeteneği, gömlemelerin dilin temel semantiğini nasıl yakaladığının güçlü bir göstergesidir.
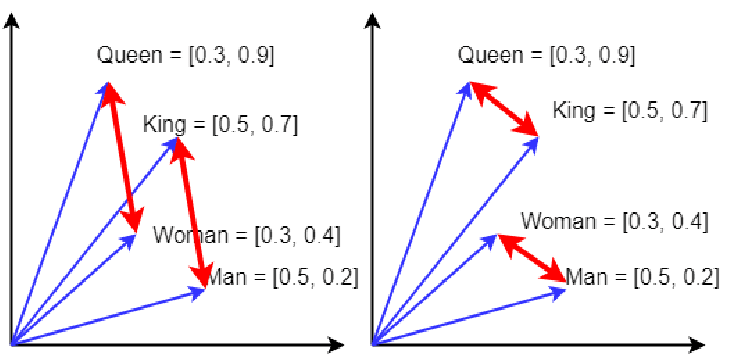
Sinirsel kelime gömlemelerindeki klasik king + woman − man ≈ queen örneği (Görsel Kaynağı)
İsterseniz kendi gömme modelinizi eğitebilirsiniz; ancak bu, milyonlarca dolara mal olabilecek ve eğitimi aylar sürebilecek dev bir sinir ağı modeli eğitmek için çok büyük miktarda veri ve kaynak toplamayı gerektirebilir.
Daha pratik olan diğer alternatif ise önceden eğitilmiş bir gömme modeli kullanmaktır. Hugging Face üzerinde yerel olarak indirip kullanabileceğiniz pek çok açık kaynak gömme modeli vardır ya da OpenAI, Anthropic, Cohere gibi şirketlerin sağladığı tescilli modelleri kullanabilirsiniz.
Bu blogda, OpenAI’nin `text-embedding-ada-002` modelini kullanacağız; bu modelin fiyatı makul düzeydedir (1K token başına $0,00010). Bu, 1000 sayfalık bir kitabın yaklaşık $1’dan az tutacağı anlamına gelir.
Gömlemeler, çeşitli alanlarda çok sayıda uygulama için kritik öneme sahiptir. Anlamsal aramada, sistemlerin basit anahtar kelime eşleştirmenin ötesine geçmesini sağlar; içerikte tam olarak aynı kelimeler kullanılmasa bile, sorguyla bağlamsal olarak ilişkili sonuçların getirilmesine olanak tanır. Bu yetenek, arama sonuçlarının alaka düzeyini ve doğruluğunu dramatik biçimde artırır; bilgi keşfini daha sezgisel ve verimli kılar.
Gömlemeler metinle sınırlı değildir. Örneğin görsel gömlemeleri, bilgisayarlı görüde benzer atılımlar sağlar; makinelerin nesneleri, sahneleri ve etkinlikleri yüksek boyutlu bir vektör uzayında anlamlandırarak görsellerde ve videolarda tanımasına olanak tanır. Bu anlayış, sadece pikselleri tanımlamak değil, o piksellerin neyi temsil ettiğinin özünü kavramaktır.
Gömleme modelleri yalnızca dönüştürücü değil, son derece kullanışlıdır; çünkü gerçek dünya verilerinin karmaşıklığını makinelerin anlayıp harekete geçebileceği bir dile (sayısal vektörler) çevirir; derin anlamsal anlayış ve akıllı veri işleme gerektiren geniş bir uygulama yelpazesini mümkün kılar.
Gömlemeler hakkında daha fazla bilgi edinmek için OpenAI API ile Metin Gömlemelerine Giriş bloguna göz atın.
Vektör veritabanları, üretken yapay zekâ ve büyük dil modellerindeki son gelişmeler sayesinde giderek popülerleşen, görece yeni bir ilişkisel olmayan veri depolama kategorisini temsil eder.
Verileri satır ve sütunlarda düzenleyen geleneksel ilişkisel veritabanlarının veya verileri json ya da xml nesnesi olarak düzenleyen Belge Veritabanı gibi ilişkisel olmayan diğer depoların aksine, vektör veritabanları çok boyutlu vektör verilerini verimli bir şekilde depolamak ve işlemek üzere tasarlanmıştır.
Vektör veritabanı, vektörleri depolama ve sorgulama için optimize edilmiş özel bir veritabanıdır. Vektörler, çok boyutlu bir uzayda veri noktalarını temsil eden sayı dizileridir.
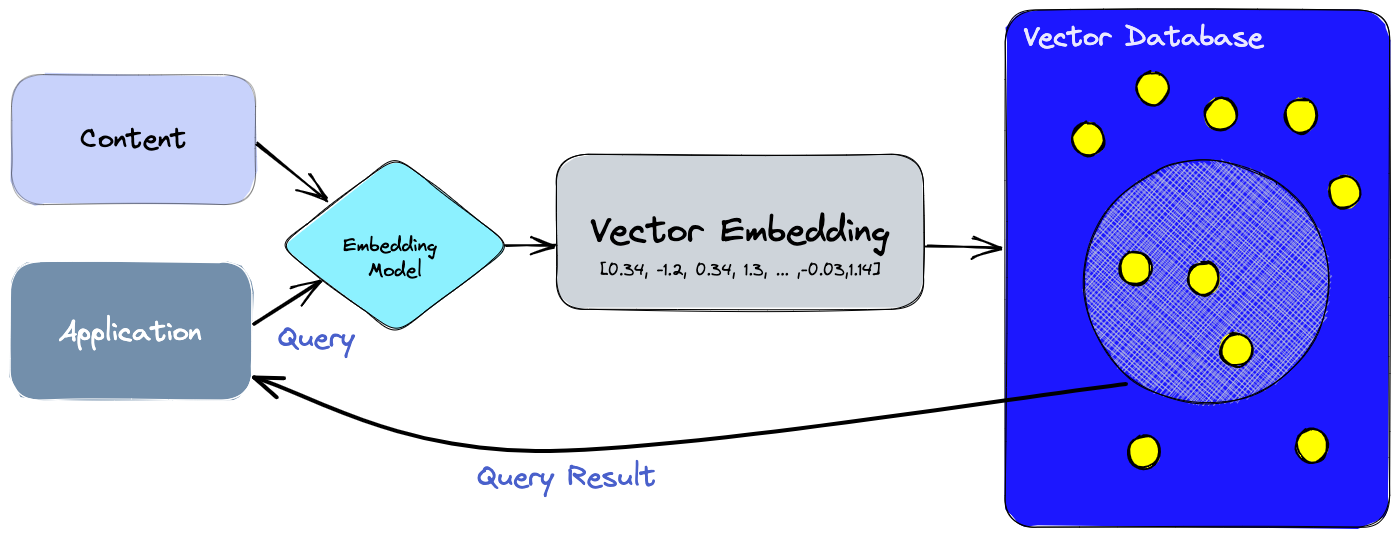
Vektör veritabanlarının temel avantajı, benzerlik aramalarını verimli bir şekilde gerçekleştirebilmeleridir. Bu, belirli bir sorgu öğesine göre, bir mesafe veya benzerlik ölçüsüne dayanarak veritabanında "en yakın" öğeleri hızla bulabilecekleri anlamına gelir.
Bu yetenek, bir kullanıcının beğendiğine benzer ürünlerin bulunmak istendiği öneri sistemleri gibi uygulamalar için ya da amaç, bir sorgu ifadesiyle anlamsal olarak ilişkili belgeleri bulmak olan anlamsal arama uygulamaları için kritik öneme sahiptir.
Vektör veritabanları, vektörleri indekslemek ve aramak için çeşitli algoritmalar kullanır; çoğunlukla Yaklaşık En Yakın Komşu (ANN) arama tekniklerine dayanır.
Anlamsal arama, arama motorlarının kullanıcı sorgularını anlama ve işleme biçiminde önemli bir sıçramayı temsil eder. Sorgu metni ile belgelerin içeriği arasındaki birebir eşleşmelere odaklanan geleneksel arama yöntemlerinin aksine, anlamsal arama bir sorgunun arkasındaki niyete ve bağlamsal anlama iner.
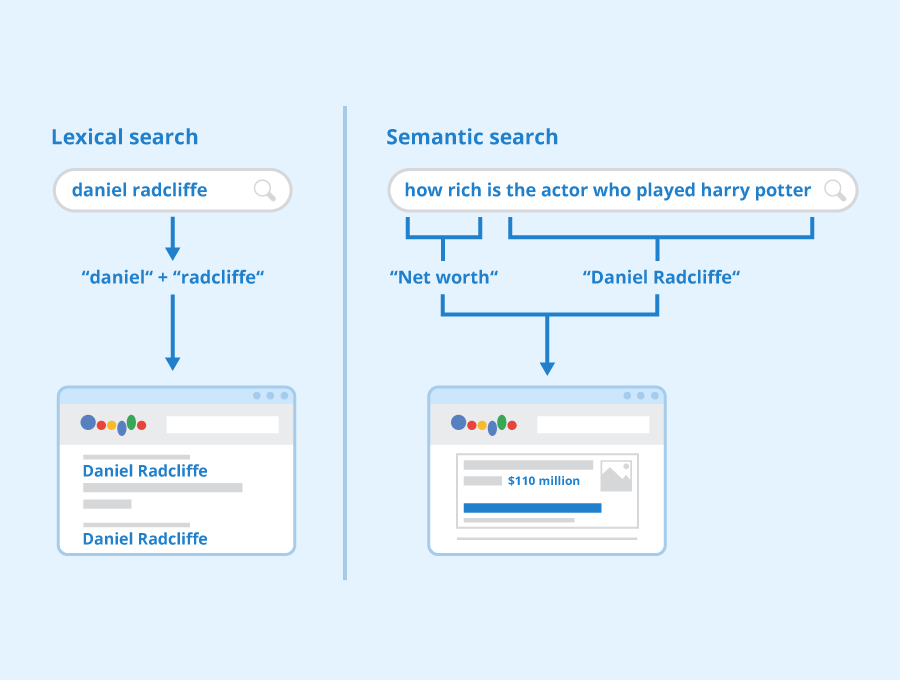
Sözcüksel Arama vs. Anlamsal Arama (Görsel Kaynağı)
Arama teknolojilerinin son on yılda anlamsal aramaya evrilmesi birkaç etken tarafından yönlendirildi. Siri, Alexa ve Google Assistant gibi sanal asistanların güç verdiği sesli arama, kullanıcı komutlarını anlamak ve yürütmek için büyük ölçüde doğal dil işlemeye dayanır.
Sesli aramaların konuşma dili doğası, bağlamın anlaşılmasını gerektirir; bu da arama motorlarının tüm cümlelerin veya daha uzun ifadelerin arkasındaki anlamı kavramasını zorunlu kılar.
İnsan dilinin karmaşıklığı, anlamsal aramanın hızla aştığı, geleneksel sözcüksel tabanlı arama uygulamaları için büyük bir engeldir. İngilizcede binlerce çok anlamlı sözcük vardır ve gerçek anlam, sözcüğün kullanıldığı bağlama bağlıdır. Bu sözcüklere çok anlamlı kelimeler (polysemous) denir.
Örneğin, "table" gibi bir kelime, bağlama göre bir mobilyayı ya da bir veri düzenini ifade edebilir.
Çok modlu büyük dil modellerinin (LLM) yükselişi, anlamsal arama uygulamalarının patlayıcı popülaritesinin başlıca itici gücüdür. Aranabilir veri uzayında terimlerin göründüğü şekliyle arayanın niyetini ve terimlerin bağlamsal anlamını kavramayı amaçlayan anlamsal arama, çok modlu LLM’lerin yetenekleriyle önemli ölçüde güçlenmektedir.
Bu modeller geliştikçe yalnızca metni anlamak ve üretmekle kalmayıp görseller, sesler ve videolar dahil çeşitli formatlarda içeriği yorumlayıp oluştururlar. Bu gelişmeler, aramaların artık yalnızca anahtar kelime eşleşmesinin ötesine geçerek dilin inceliklerini, farklı medyaların nüanslarını ve kavramlar arasındaki karmaşık ilişkileri kavrayabileceği anlamına gelir.
Örneğin, doğal dil kullanılarak bir arama sorgusu yapılabilir ve sistem, metin tabanlı sonuçların yanı sıra, sorgunun niyetine uygun şekilde yapay zekâ tarafından anlaşılıp seçilmiş ilgili görselleri, video klipleri veya ses parçalarını da döndürebilir.
Anlamsal arama, çeşitli alanlarda geniş bir uygulama yelpazesine sahiptir ve arama sonuçlarının alaka düzeyi ile hassasiyetini artırmada önemli faydalar sunar:
Vektör Veritabanları hakkında daha fazla bilgi edinmek ister misiniz? Şu En iyi vektör veritabanlarına kapsamlı rehber yazısına göz atın.
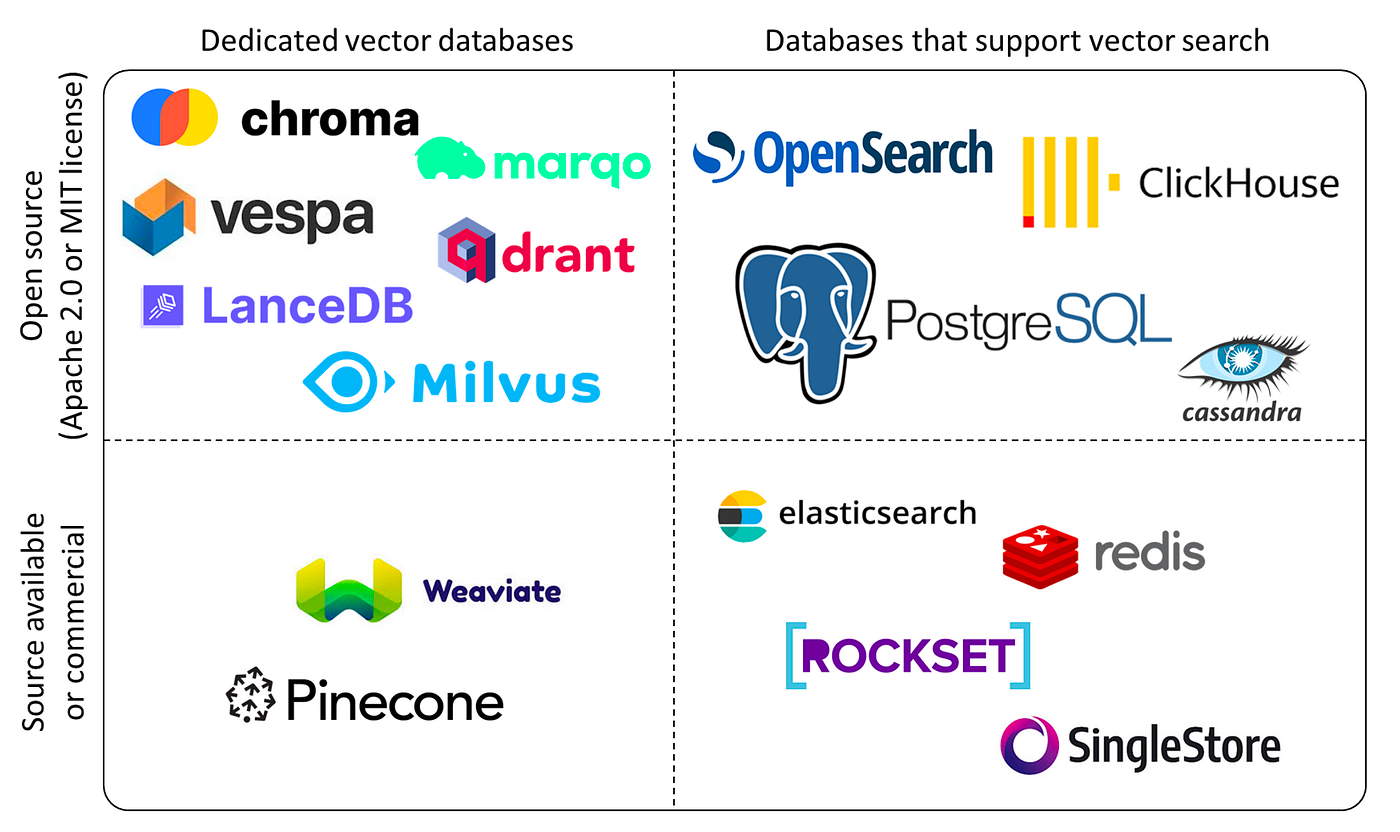
Vektör veritabanları manzarası (Görsel Kaynağı)
Pinecone, karmaşık ve yüksek boyutlu verileri işlemek üzere tasarlanmış özel bir vektör veritabanıdır. Gelişmiş arama ve indeksleme yetenekleri sunarak veri mühendisleri ve bilim insanlarının büyük ölçekli makine öğrenmesi projelerini verimli bir şekilde inşa edip çalıştırmasını sağlar.
Pinecone’a daha derinlemesine dalmak isterseniz, Datacamp’teki Pinecone ile Vektör Veritabanlarında Ustalaşma: Kapsamlı Bir Rehber yazısına göz atın.
OpenAI, platform API’si aracılığıyla tüm modellere erişim sunar. Buna popüler GPT, DALL-E ve Whisper modellerinin yanı sıra üç gömme modeli dahildir.
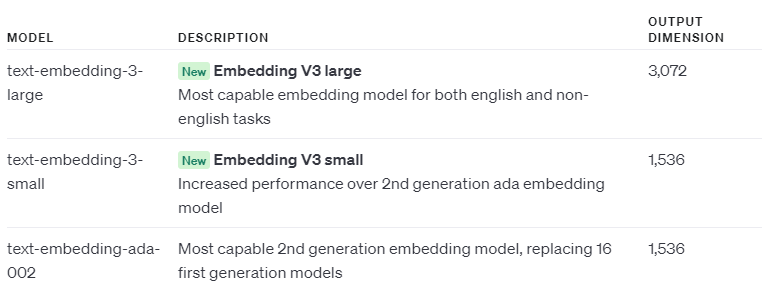
Bu API’lerle HTTP istekleri aracılığıyla etkileşime geçilebilir; bu da HTTP iletişimi yapabilen herhangi bir programlama diliyle uyumluluk sağlar.
Python kullanıcıları bu API’lerle etkileşim kurmak için openai kütüphanesini de kullanabilir; bu, kullanımı daha da basit ve kolay hale getirir. Bu kütüphane pip install openai kullanılarak kurulabilir.
openai kütüphanesiyle Python’da OpenAI API’sini kullanmak yalnızca az miktarda kod gerektirir.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)Çıktı: (kısaltılmış)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
ChatGPT ve büyük dil modellerinin dijital dünyayı nasıl dönüştürdüğünü keşfedin! En güçlü yapay zekâ API’lerinden biri olan OpenAI API’sinden yararlanmanın temellerini öğrenmek için Datacamp’in ipuçları sayfasına göz atın.
OpenAI hesabınızı oluşturduktan sonra doğrudan https://platform.openai.com/api-keys adresine gidin
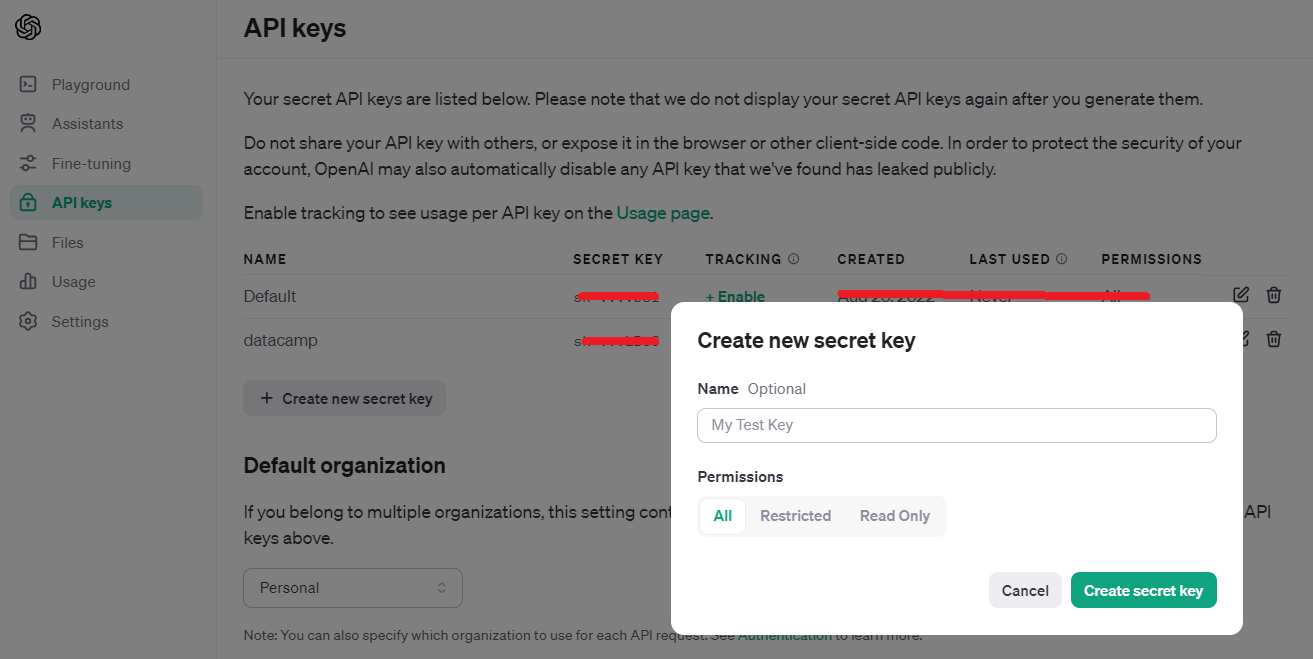
API Keys platform.openai.com
Pinecone için, hesabınıza giriş yapın ve API Keys’e tıklayın. Sağ köşedeki `Click API Key` düğmesine tıklayabilirsiniz.
OpenAI’den farklı olarak, Pinecone’da bir API anahtarı oluşturduğunuzda onu kopyalamanız şart değildir; İstediğiniz zaman kullanabileceğiniz, Actions sütununun altında bir kopyalama simgesi bulunur.
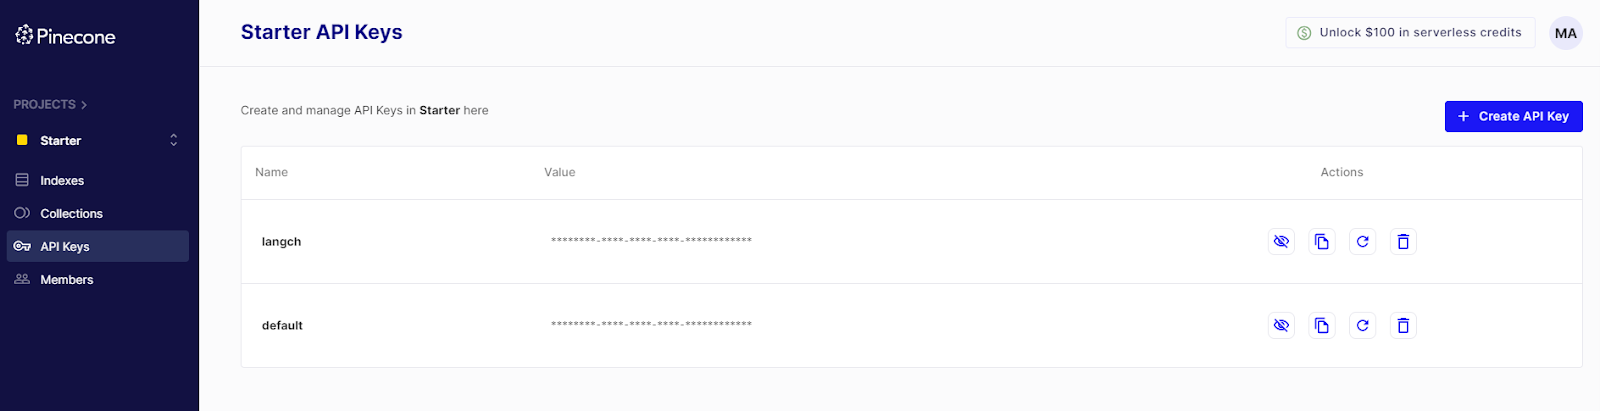
API Keys - Pinecone
OpenAI ve Pinecone API anahtarlarını aldıktan sonra, bunları Notebook içinde değişkenlere atayın veya Python’ın os modülünü kullanarak ortam değişkenleri olarak ayarlayın.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Bu eğitimi uygulamak için aşağıdaki kütüphanelerin pip ile kurulması gerekir. Aşağıdaki kodun çalışması için sürümleri aynen kullanmalısınız; aksi halde kod çalışmaz.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28pinecone-datasets kütüphanesi, OpenAI'nin embedding-ada-002 modeliyle önceden gömülmüş birkaç veri kümesi içerir.
Bu örnekte, `wikipedia-simple-text-embedding-ada-002-100K` veri kümesini kullanacağız; 100.000 belgenin yalnızca 5.000’ini ve bunların gömlemelerini örnekleyeceğiz.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
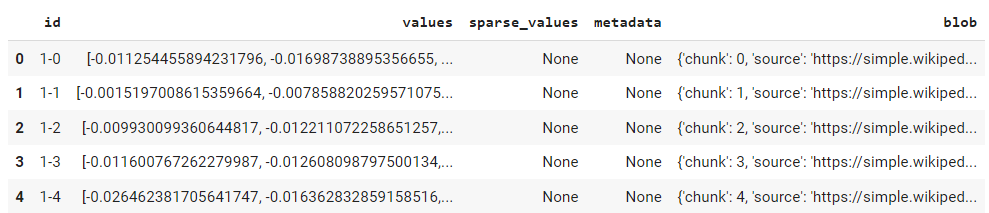
Örnek Veri Kümesi
Pinecone’da bir dizin, vektör verileri için en üst düzey örgütsel birimi temsil eder. Vektörlerin depolanmasını üstlenir, depoladığı vektörlere ilişkin sorguları işler ve elindeki vektör verileri üzerinde çeşitli işlemler gerçekleştirir.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
Yukarıdaki kod, Pinecone örneğini başlatır ve semantic-search-demo adlı bir dizin oluşturur. Bu noktada bu dizini kullanıcı arayüzünde de görebilirsiniz.
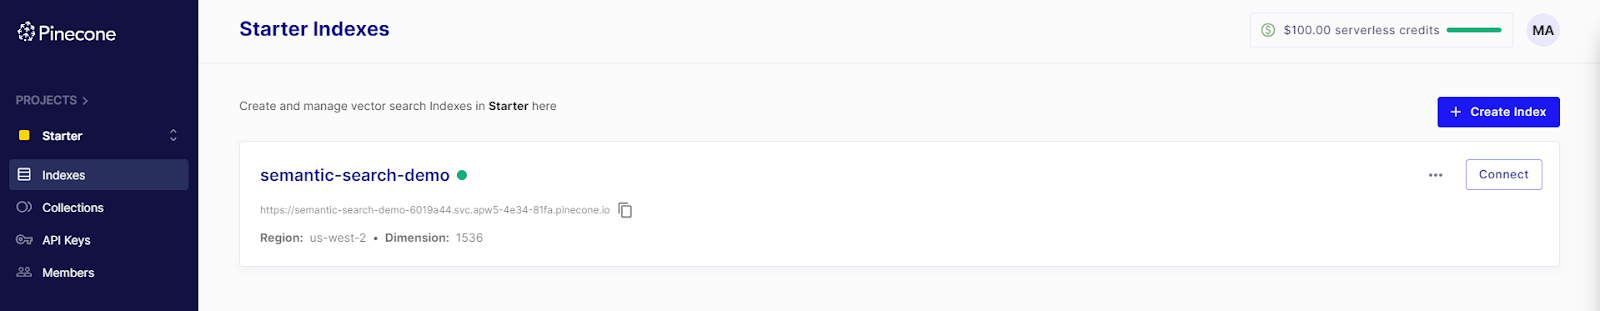
Verilerimiz halihazırda gömülü temsiller içerdiğinden, gömme işlemini atlayabilir ve doğrudan yeni oluşturulan dizine veri eklemeye geçebiliriz.
Gömülü temsiller içermeyen veri kümeleri için önce OpenAI API’sini kullanarak ham veriyi gömün (talimatlar için aşağıdaki 5. adıma bakın).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Kod başarıyla çalıştıktan sonra verileri kullanıcı arayüzünde de görüntüleyebilirsiniz.
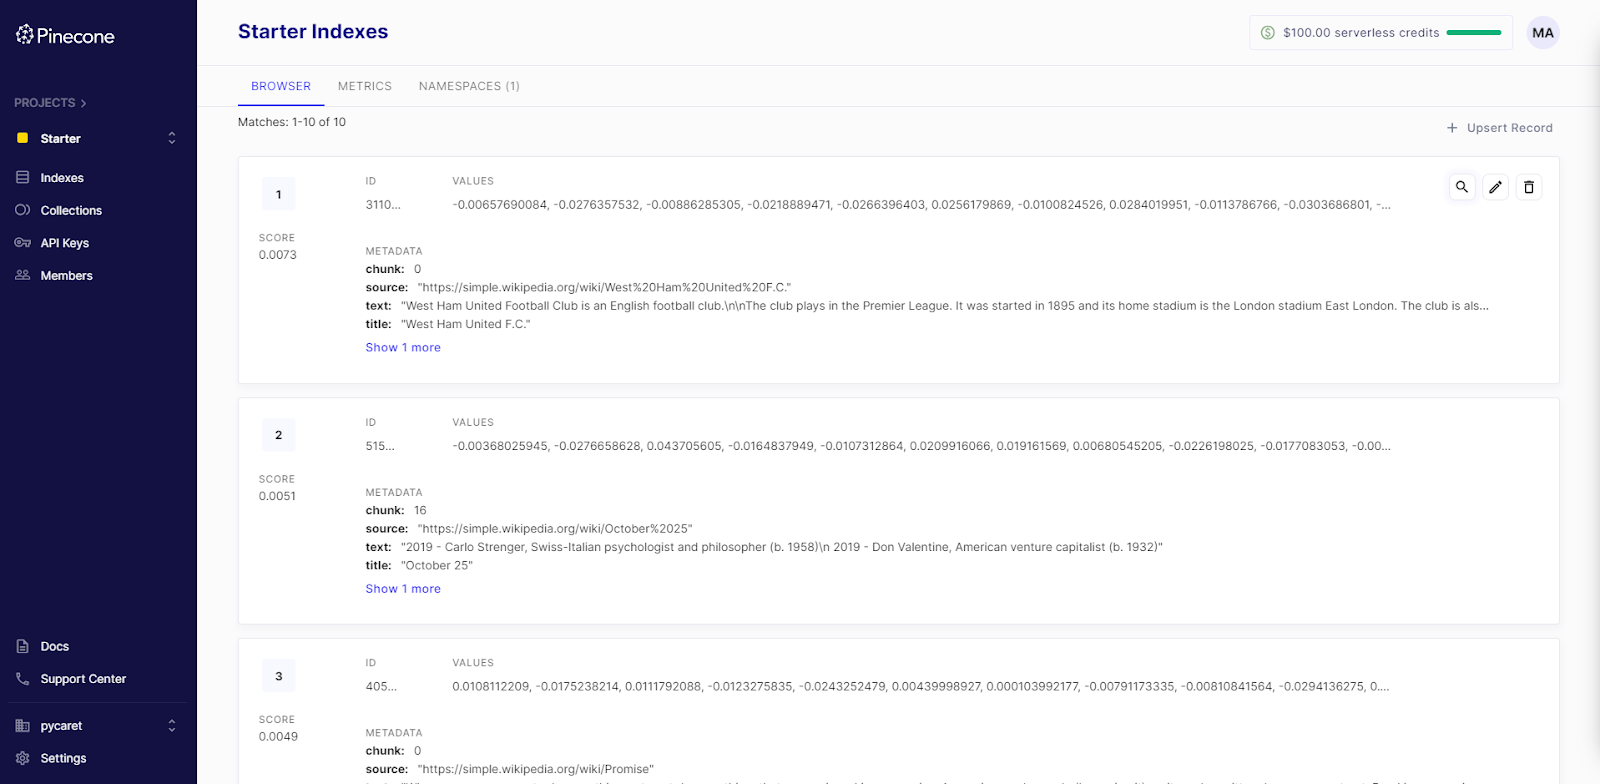
Yeni verilerin veya sorguların, vektör boyutlarının eşleşmesini sağlamak için aynı modelle gömülmesi gerekir. Veri kümemiz text-embedding-ada-002 kullandığından, yeni sorguları aynı modelle gömmek için OpenAI API’sinden yararlanan bir işlev oluşturacağız.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Çıktı:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
result uzunluğu 1536’dır ve dizin oluşturma sırasında belirtilen dimension ile uyumludur.
Bir arama sorgusu göndermek oldukça basittir:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)Çıktı:
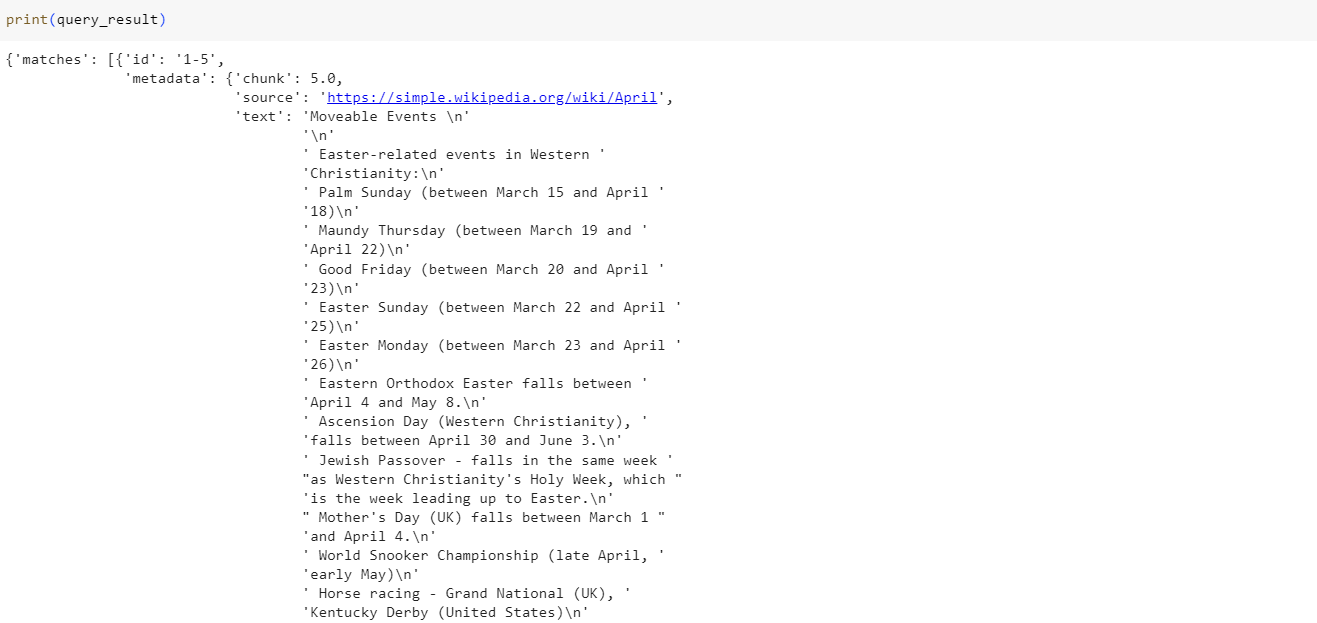
query_result, kullanıcının sorgusuna karşılık gelen en iyi 3 eşleşmenin yer aldığı bir sözlük üretir. Bu İlk N eşleşme artık aşağı akış görevleri için kullanılabilir; örneğin Erişimle Zenginleştirilmiş Üretim (RAG) senaryolarında istemlere bağlam sağlamak ya da Sohbet Botları oluşturmak gibi.
Bu eğitimde, anlamsal arama uygulamalarının tüm işleyişini anlamak için gömme ve vektör veritabanları gibi birkaç temel kavramı tanıttık.
Üretken Yapay Zekânın ortaya çıkışı ve Çok modlu LLM’lerin sürekli evrimiyle birlikte, anlamsal aramanın gücü genişlemiş; yapılandırılmamış verinin karmaşıklığı ve nüanslarını eşi görülmemiş bir hassasiyetle anlama imkânı sunmuştur.
Gelişmiş bir vektör veritabanı olan Pinecone’un yeteneklerinden ve OpenAI’nin sunduğu sofistike gömme modellerinden yararlanarak, geliştiriciler ve veri bilimciler artık geleneksel anahtar kelime tabanlı arama yöntemlerini aşan anlamsal arama uygulamaları oluşturmak için gerekli araçlara sahiptir.
Bu rehber aracılığıyla, gömlemelerin insan dilinin karmaşıklığı ile makine öğrenmesi için gereken sayısal temsiller arasındaki boşluğu nasıl kapattığını; bu temsillerin makinelerin bağlam ve niyetin inceliklerini kavramasını nasıl sağladığını da inceledik.
Aramanın geleceğinin, yapay zekâ destekli dil ve diğer yapılandırılmamış veri biçimlerini anlamakta yattığı açıktır. İster e-ticaret, ister içerik keşfi, müşteri desteği ya da bilgi yönetimi için olsun, bu blogda özetlenen ilke ve uygulamalar, daha akıllı, duyarlı ve kullanıcı odaklı arama deneyimleri oluşturmak üzere anlamsal aramanın gücünden yararlanmak için temel bir yol haritası sunar.
Pinecone kullanarak Anlamsal Arama uygulamaları oluşturma hakkında daha fazla bilgi edinmek isterseniz Pinecone ile Anlamsal Arama kod eşliğini inceleyin; ya da ChatGPT gibi popüler yapay zekâ uygulamalarının temelindeki işlevler hakkında daha fazla bilgiye ilgi duyuyorsanız OpenAI API ile Çalışma kursuna göz atın. Ayrıca kursumuzu da unutmayın: Pinecone ile Gömlemeler için Vektör Veritabanları.
OpenAI ile Çalışma Hakkında Daha Fazla Bilgi Edinin!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




